
OpenAI 公布的 BioBasicsBench 菌落平板案例中,GPT-6 Astra 分不開相鄰菌落、漏掉看得見的菌落,也在空白培養基上打點,這塊平板的計數比基準參考值高估約 12%。另一項 DNA 克隆任務裡,它分得出兩組菌落條帶,卻假設 PCR 產物較大就代表克隆成功,因此選了第 4、6、7、8 道;依控制組比對,參考答案是第 5、9、10 道。
這兩個例子和同一評測公布的 66.7% 平均得分放在一起看,才看得出 BioBasicsBench 想回答的問題:AI 代理能否讀懂原始實驗證據、辨認控制條件,並在資料不足時避免下結論?對科研團隊來說,這比單看模型能否回答生物學知識題更接近資料判讀工作,但仍不足以直接推導實驗室的成功率。
若想了解代理如何從資料庫找生物線索,可參考AI 代理搜尋生物資料後仍需實驗驗證的流程;BioBasicsBench 的重點再往下一步,檢查原始實驗資料本身能否被正確解讀。
BioBasicsBench 為什麼改用原始實驗資料測 AI 代理?
它用 100 項濕實驗室任務,測代理能否解讀原始資料、辨認錯誤,並判斷證據是否足以支持結論。資料包括凝膠影像、菌落平板、顯微鏡影像、儀器輸出與實驗紀錄。
OpenAI 與生技公司 Ligo 共同建立這套基準。100 項任務分布在蛋白質方法、影像與細胞分析、定量與分析方法、核酸方法、分子選殖五個領域。題目從讀取凝膠中 DNA 樣本大小,到分析較細緻的分析測定都有;一個任務也可能同時需要辨識影像、理解生物背景、檢查錯誤與掌握實驗流程。
設計差異在於輸入材料保留了實驗現場的雜訊與脈絡,而不是只挑整理好的論文圖表。資料可能是手寫紀錄照片、板讀儀匯出檔、定序檔案、顯微鏡 z-stack(不同焦深的連續影像),也可能同時附上質體圖譜或試劑資料表等參照資訊。專家為每題寫下評分規準,再由未參與出題的 Ligo 科學家、外部濕實驗室博士級研究者及內部審查者檢查題目與答案評分。
這種設計讓評測能檢查「答案為什麼對」:依任務規準,結論、數值、推理過程,或指出證據不足,都可能各自取得部分分數。它也提醒採購或研發團隊,不同基準的分數未必能直接排序:
| 基準 | 測量對象 | 任務形式 |
|---|---|---|
| BioBasicsBench | 日常濕實驗原始資料判讀 | 100 項任務,依評分規準給分 |
| LAB-Bench | 文獻檢索、圖表解讀、資料庫操作與序列處理 | 超過 2,400 道選擇題 |
| BenchBench-Protocol | 調整實驗操作流程 | 科學家在真實實驗中修改過的 149 份流程 |
「日常濕實驗工作包含失敗的實驗、模糊的影像與互相衝突的觀察。」(譯自 OpenAI 對 BioBasicsBench 的介紹)
這是 OpenAI 對基準設計動機的描述,不代表所有實驗室情境都已被涵蓋。任務來自研究者自己的實驗資料,對一般工作有參考價值,但仍是特定題目集合。團隊若原先關注的是另一類儀器、樣本或操作流程,應先確認評測資料是否與自己的工作相近。
GPT-6 Astra 的 66.7% 平均得分該怎麼讀?
不是。66.7% 是 GPT-6 Astra 在 BioBasicsBench 的 xhigh 推理設定中,對 100 項任務、每題五次作答所獲平均評分,占可得分數的比例。它不是實驗成功率或可獨立工作的比例。
OpenAI 公布的 xhigh 結果中,GPT-6 Astra 平均得分 66.7%,95% 信賴區間為 60.3% 至 73.1%;GPT-6.1 Sol 為 62.0%,GPT-5.6 Sol 為 43.8%。此設定是七個受測模型共同公布的最高推理投入設定。整體評測包含 37 種模型與推理設定,每種設定在 100 題各作答五次,共 18,500 份結果。評分以任務規準計算,信賴區間則透過以整題為單位重抽樣估計。
因此讀分數時要把分母和設定一併帶上。平均分數表示模型在這組任務中取得多少評分點數;每題有多個評分條件,部分符合也能得分。95% 信賴區間呈現這套估計的不確定範圍,不能解讀成模型在任一真實實驗裡有 95% 機率正確。比較模型時也要留意推理設定、輸出長度及任務組成,不宜只摘出最高數字。
基準分數和實際工作成功率不同,原因在於工作環境還包含樣本品質、設備差異、操作紀錄完整性、失敗後的補救流程與責任覆核。BioBasicsBench 評量的是指定材料與題目下的回答,不是跨實驗室執行整套研究的結果。前面表格中的 BenchBench-Protocol 補上流程修改能力的面向,也顯示科研代理能力需要多種互補測量,不能由單一分數概括。
哪些失誤揭示模型判讀的邊界?
錯誤可能發生在辨識影像、理解控制組或把觀察整合成結論的不同環節。中間步驟看對了,不保證最後推論也正確。
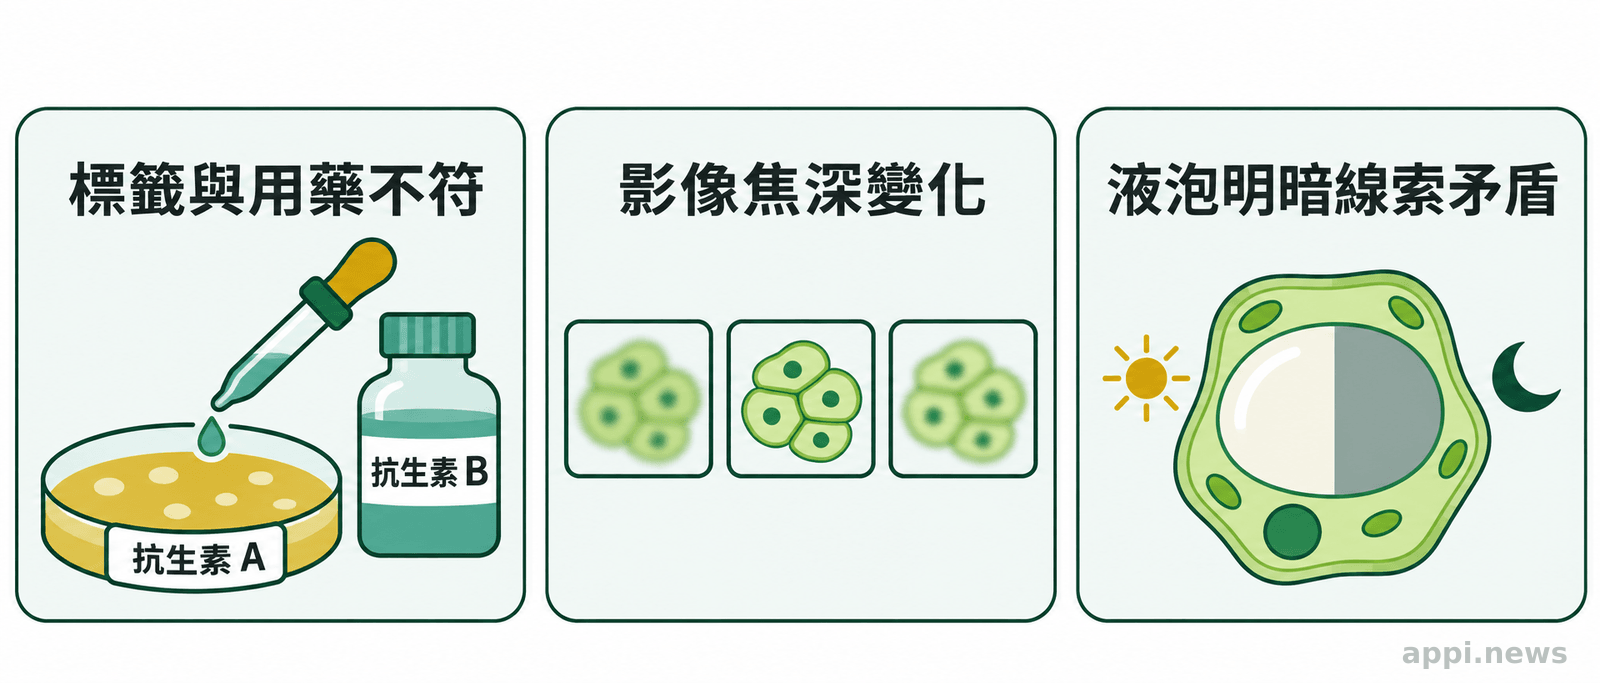
在 DNA 克隆任務中,GPT-5.6 Sol 看到陰性控制組沒有菌落,便依此解讀結果;GPT-6 Astra 則注意到培養皿標示的抗生素錯誤,並正確判定該平板不能當作可靠控制組。標籤寫的是 kanamycin,實驗使用的則是 ampicillin。這是 Astra 相較 GPT-5.6 Sol 的改進案例,也顯示控制條件會改變結果能否比較;團隊應保留原始標籤、實驗紀錄及對照設計,讓人能追溯判斷依據。
顯微鏡案例也呈現 Astra 的進步:GPT-5.6 Sol 把細胞在連續影像中出現、消失解釋為生物變化,GPT-6 Astra 則辨認出這是 z-stack,也就是沿不同焦深拍攝的影像序列。不過另一項液泡判讀任務顯示其限制:Astra 認為液泡通常比周圍細胞暗,卻沒有把同一視野中較亮的液泡納入最後結論。OpenAI 指出,不同焦深可能讓明暗對比反轉;Astra 雖觀察到差異,仍過度採信自己認為對焦較佳的區域。這些任務分別呈現脈絡判讀的改善,以及矛盾觀察未能改變結論的失誤。
「較高的基準分數,尚不代表模型已能在實驗室可靠判斷。」(譯自 OpenAI 對 BioBasicsBench 結果限制的說明)
這些案例呈現指定任務中的進步與失誤,不能證明所有模型、影像類型或實驗室都會出現相同結果。對科研團隊而言,重點是保留原始資料、控制條件與判讀紀錄,並明確安排由誰覆核模型結論;基準分數本身無法代替這些研究責任。
科研團隊可以怎麼用這項基準評估導入?
把公開分數當成初步線索,再以團隊自己的資料設計小型試點,逐類記錄錯誤與人工覆核成本。先確認任務相似度,再談是否適合接入流程。
基準的價值在於建立可討論的共同題目,不在於替組織直接做採購決定。第一步先盤點日常工作:輸入是凝膠影像、顯微鏡資料、板讀儀輸出,還是手寫紀錄?需要模型辨識、計數、比較控制組或指出資料不足?測試項目越貼近工作內容,分數才越能協助篩選候選工具。
- 對照任務:列出代理會處理的資料、輸出與常見問題,再比對基準涵蓋範圍。
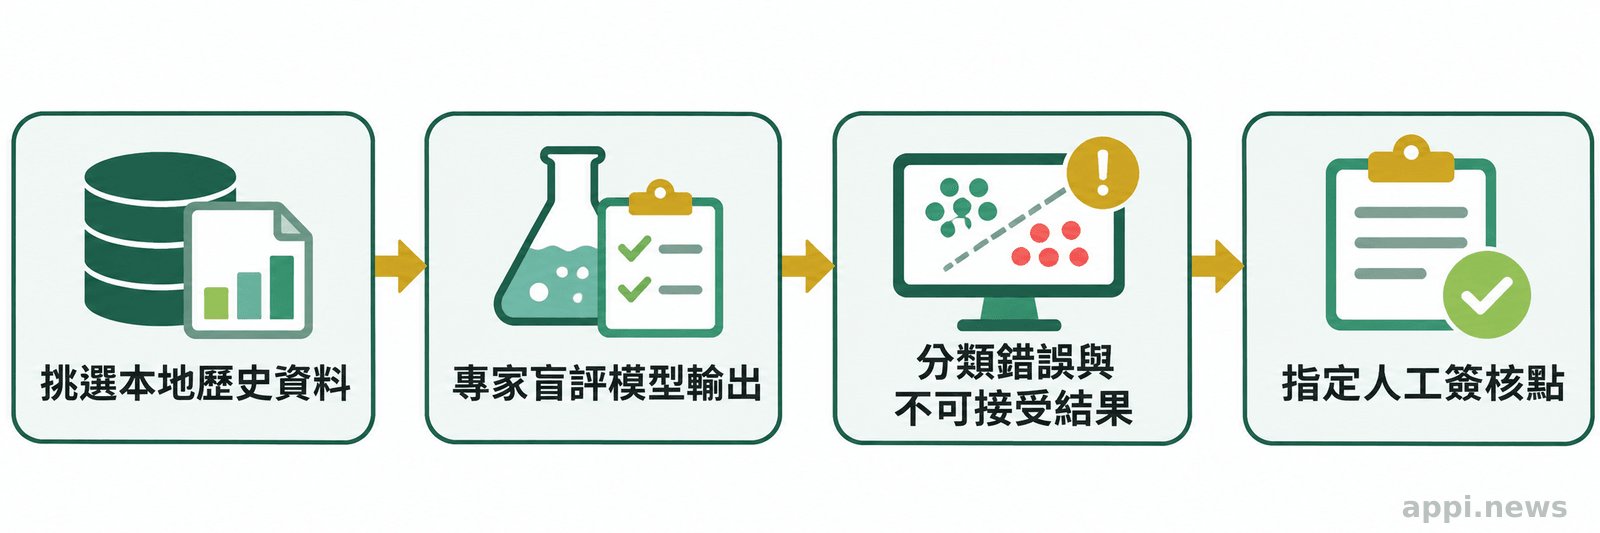
- 定義錯誤成本:分清標註疏漏與可能影響樣本選擇、純化或結論的錯誤,預先訂出不可接受項目。
- 建立本地試點:用實驗室歷史資料測試,由熟悉流程者盲評,記錄正確、部分正確、漏報及過度推論。
- 指定覆核點:訂明哪些輸出須確認、由誰簽核,以及資料不足時如何退回。
- 檢查運作條件:確認資料權限、隱私保存、系統整合方式,並估算維護與訓練成本。
這套做法也能避免把模型評測當成只比排行榜。若團隊正在比較代理工作流,可參考評估 AI 代理任務與流程適配的檢查方式;科研現場還要多看樣本、設備和控制條件。若試點出現漏看標籤、忽略反例或錯估菌落等情況,應先調整流程限制或人工覆核,再判斷整體分數是否適用。
BioBasicsBench 能補充「原始實驗資料判讀」這一塊的能力觀察,並提供可供比較的任務設計。能否導入,仍要看目標工作與基準是否相符、錯誤是否可被攔截、現場能否持續覆核。評估時先寫下三件事:代理會看哪些資料、哪一類錯誤不可接受、哪個角色對最後判斷負責。這三項若還沒有答案,66.7% 仍只是一個外部評測數字。
- BioBasicsBench 用 100 項任務測量原始濕實驗資料判讀能力,並非實驗室工作成功率。
- GPT-6 Astra 的 66.7% 是特定模型、推理設定與評分規準下的平均得分。
- 導入前應以本地資料檢查錯誤類型、覆核位置、資料治理與流程整合條件。
常見問題
Q1:BioBasicsBench 一共有多少項任務?
BioBasicsBench 有 100 項日常濕實驗室任務,涵蓋蛋白質方法、影像與細胞分析、定量與分析方法、核酸方法、分子選殖五個領域。
Q2:GPT-6 Astra 的 66.7% 代表它做對三分之二的實驗嗎?
不代表。這是該模型在 xhigh 設定下,依各任務評分規準取得的平均分數比例;測試沒有讓模型獨立完成一系列真實實驗。
Q3:BioBasicsBench 能證明 AI 代理已可獨立做實驗嗎?
不能。它評估的是指定資料與任務中的分析回答,沒有涵蓋不同實驗室的設備、樣本差異、完整操作流程及責任治理,也不能取代研究人員判斷。
Q4:科研團隊下一步該怎麼驗證?
先列出目標資料、任務及不可接受的錯誤,再以本地歷史資料建立小型試點,安排熟悉實驗的人員覆核,記錄錯誤和整合成本後再決定使用範圍。
參考來源
- OpenAI. (2026). Measuring how AI agents handle everyday wet-lab science (OpenAI)
- Laurent JM, et al. (2024). LAB-Bench: Measuring Capabilities of Language Models for Biology Research. arXiv:2407.10362
- Sivakumar A, et al. (2026). BenchBench-Protocol: Evaluating Real-World Wet-Lab Protocol Reasoning and Modification. arXiv:2608.23898


