中小企業要不要導入 AI 工具?先看這幾件事再決定
中小企業評估 AI 導入時,先盤點重複工作、資料位置、存取權限與錯誤追溯;本文提供從流程定義、資料治理到低風險試點的判斷順序,並列出高風險、不易驗證與沒有備援時應暫停的情境。
中小企業評估 AI 導入時,先盤點重複工作、資料位置、存取權限與錯誤追溯;本文提供從流程定義、資料治理到低風險試點的判斷順序,並列出高風險、不易驗證與沒有備援時應暫停的情境。
企業把生成式 AI 放進客服、開發、文件與決策流程後,機密資料外流、提示注入、影子 AI、第三方 API、權限失控與稽核缺口會怎麼發生?本文對照 NIST AI RMF、OWASP LLM Top 10、ISO/IEC 42001 與 NIST SP 800-53,整理可落地的盤點與控制方法。
漏洞公告出現後,企業要把 SBOM、資產清冊與漏洞資料接起來,才知道哪個產品受影響、誰要回覆、更新是否完成。本文拆解從告警到結案的修補工作流。
歐盟 AI Act 把醫療服務評估、急診分流與部分醫療器材軟體放進高風險框架;台灣人工智慧基本法則建立治理原則與風險分類方向。本文對照兩套制度,整理醫院與供應商要留下的用途、資料、效能、覆核和監測證據。
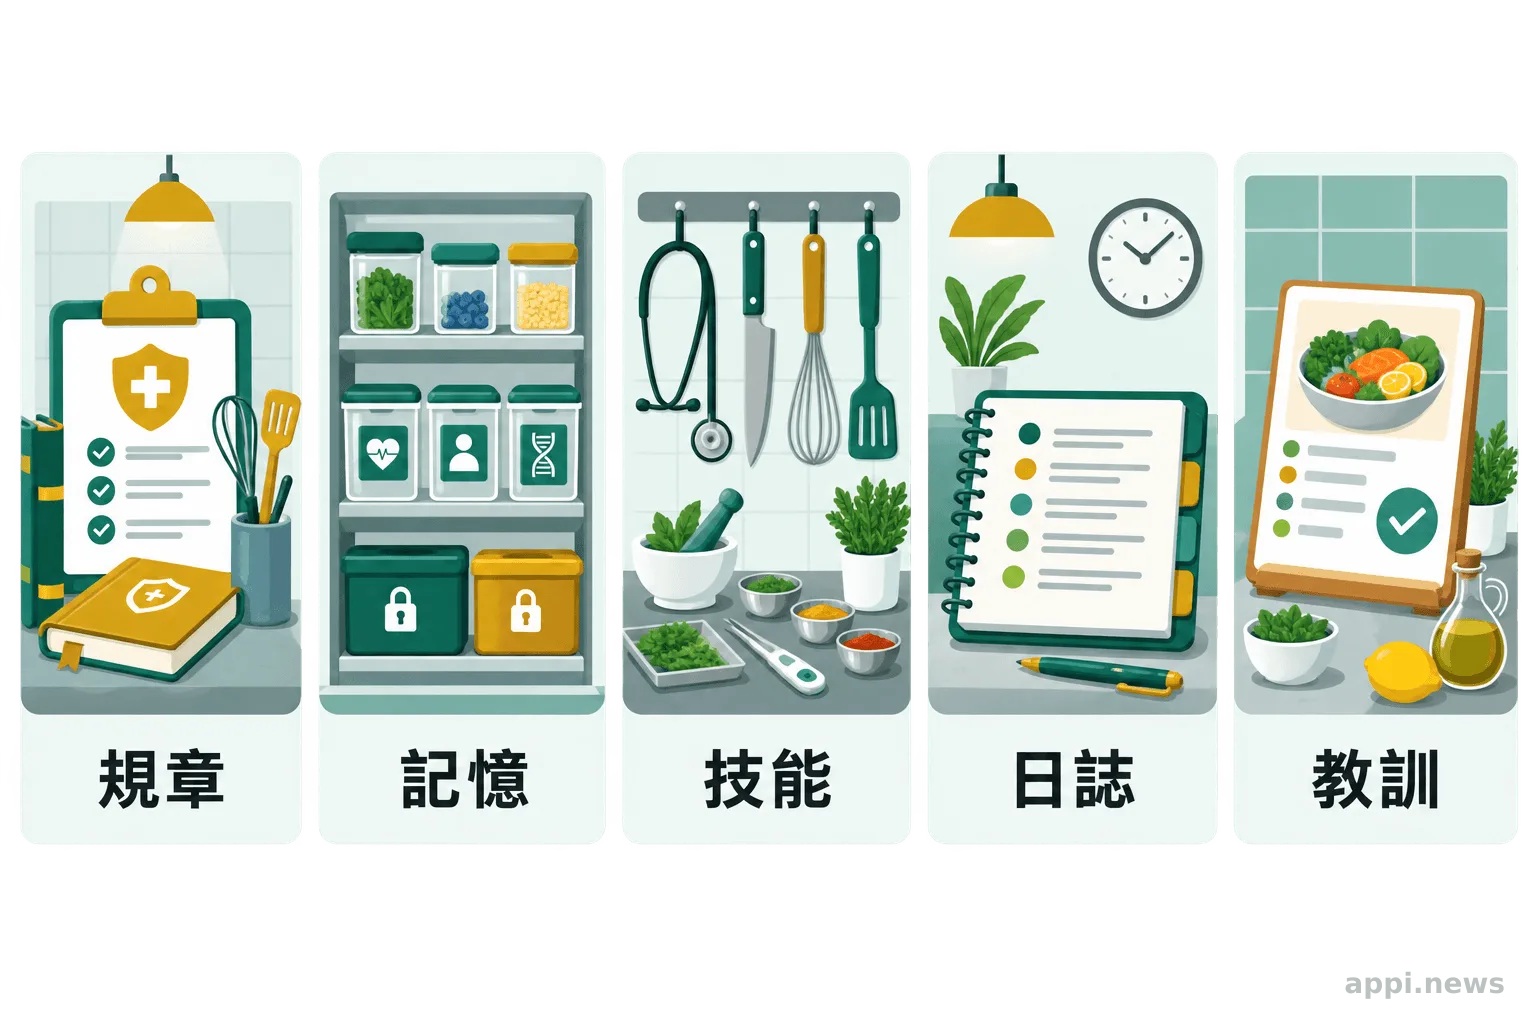
醫療 AI Agent 不只靠 Prompt。本文拆解規章、記憶、技能、日誌與教訓五層架構,說明 GCM 母體、MCP、病人資料隔離及自我優化的安全邊界。
國軍臺中總醫院表示,規劃以 PACS-AI-RIS 危急放射報告警示作為 ISQua 2026 交流主題。文章說明系統分工、通知流程與醫療 AI 治理條件。
AI代理第一次完成任務,不代表能穩定交付。從 Mean@k、Pass^k、泛化能力與人類監督,建立數位健康流程的可靠度評測方法。
Claude Code 2.1.271至2.1.273更新了什麼?整理遠端快速模式、代理標記、MCP、權限與可靠度修正,依個人、團隊與自託管環境提供升級判斷與測試清單。
電子病歷若偏重計費、申報與管理,可能增加醫護操作負擔。從台灣醫療現場、FHIR資料互通與醫療AI可解釋性,檢視如何回到臨床需求。
長篇假訊息會透過重複、誘導與假引用污染上下文。本文拆解GPT-6 Astra與Claude的證據差異,說明醫療衛教與台灣內容查證如何保留人工覆核。
混合推論不等於資料零外傳。從 Perplexity、純雲端助理與 Ollama 本機部署的資料流、隱私、能力、網路、成本及臺灣個資責任,整理實際選擇方法。
醫療 AI 能提供影像、風險與文字整理結果,但真正影響安全與成效的,是資料品質、流程位置、角色責任與持續治理。
美國人口普查局提案把人口計算資格限縮到公民、永久居民等對象,並取消十年一次普查中的種族與族裔問題;規則目前仍在徵詢意見,尚未生效。
AI 工作流導入要先畫清楚資料流、使用權限、人工覆核與異常退回路徑。本文以台灣醫療現場為例,對照衛福部指引、個資法與 FHIR,整理從試辦到上線的流程設計。
臨床決策支援系統的價值在於把對的資訊送到對的照護節點。AI 要進醫院,先處理病歷資料、FHIR 介接、權限、人工覆核與可追溯紀錄。
GPT-Live-1 以全雙工語音處理即時聽說與打斷,本文比較它和傳統 STT-LLM-TTS 架構的延遲、開發、成本與台灣應用條件。
DeepSeek V4.1 Flash 以低成本與高速度吸引開發者,但仍在內測;本文比較它與 GPT-6 Astra 的推理、多模態、價格、台灣可用性與本地部署門檻。
AI代理比較 MyAgent、Meta Muse 與 Gemini 的工作範圍、資料權限、台灣可用性與健康支付風險,整理企業、生活與桌面工作者的選擇方法。
ChatGPT Images 2.5 強化草圖、參考圖與多輪編修;Google Earth AI 生圖曾因爭議場景回撤。從生成能力、內容安全到台灣創作者工作流,整理公開發布前的判斷方法。
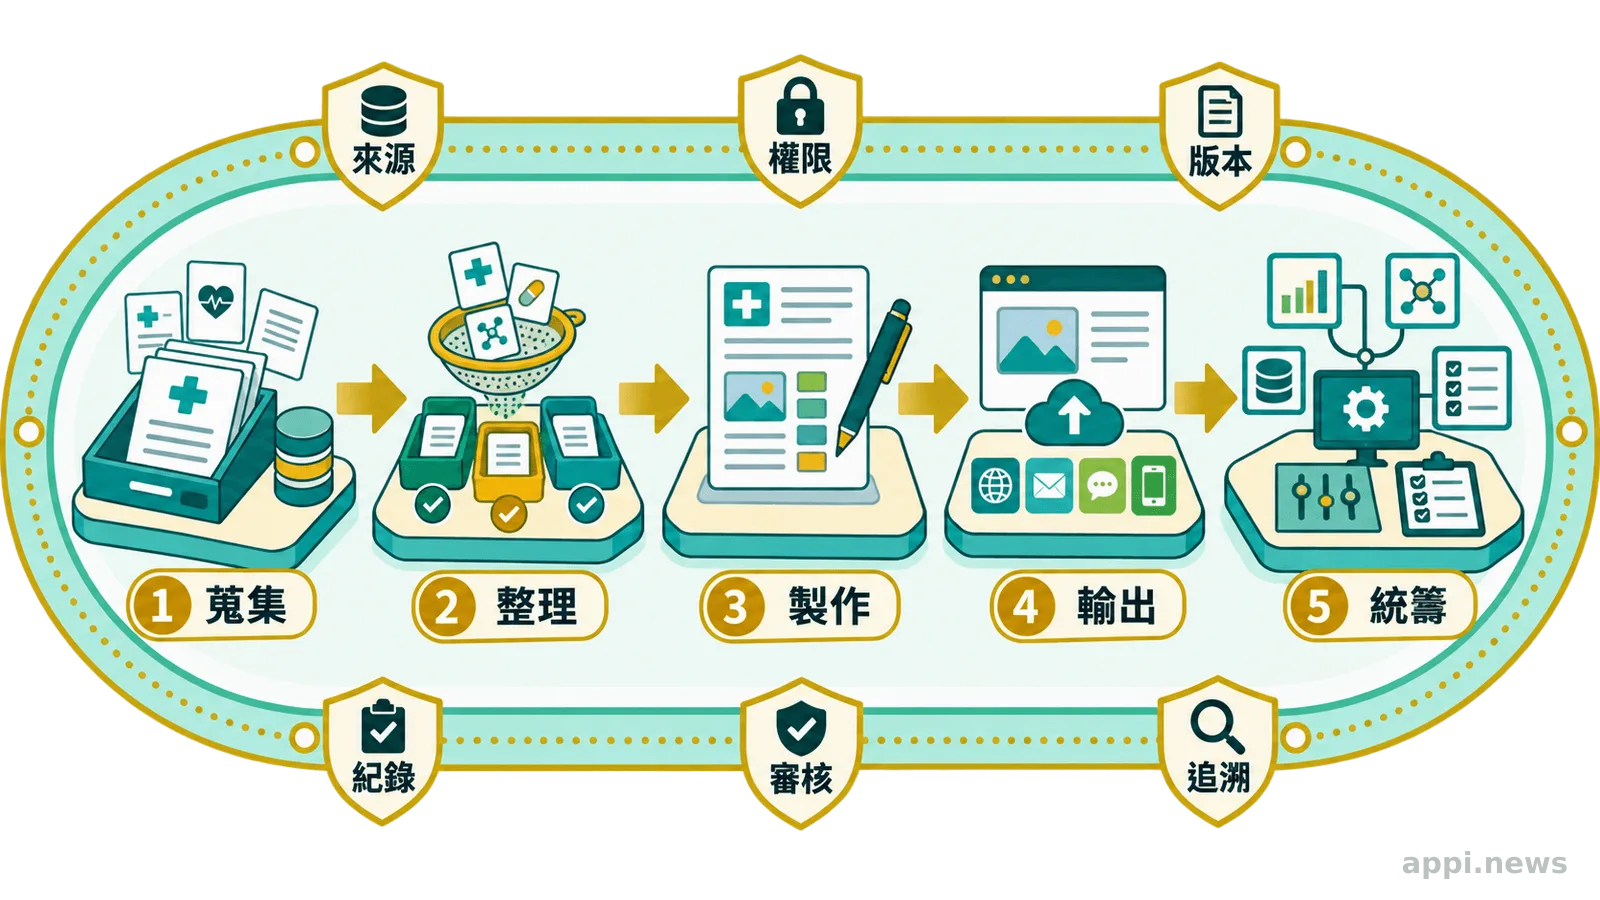
醫療 AI Agent 不宜只靠一個模型與長提示詞。本文拆解蒐集、整理、製作、輸出、統籌五個引擎,以及來源、權限、版本、紀錄、審核與追溯護欄。
病歷可以交給 AI 處理,但要先分清楚用途、資料範圍、模型位置、授權與人工覆核。本文對照台灣個資法、衛福部生成式 AI 指引、FHIR 與 SMART on FHIR,整理病人、醫院與供應商在送入模型前的 5 個實務關卡。
從台灣長者量六力、老藥新用到醫療AI可解釋性,拆解資料治理、臨床驗證與專利授權如何影響高齡照護落地。
RAG 會先從授權資料找出相關內容,再交給大型語言模型整理回答。醫療場景還要加上病歷權限、資料品質、來源追溯與人工覆核,台灣已有 FHIR、TW Core 與健康存摺等資料交換基礎。
遠距醫療把照護延伸到偏鄉與離島,AI 可整理資料、提示風險與補齊工作流,最後診療仍由醫事人員負責。從台灣健保制度、FHIR 到臨床導入,說清楚這條鏈怎麼接。
Meta AI 推出 Muse Spark 1.3。本文從程式任務成功率、總成本、部署方式與醫療資料隱私,比較 GPT-5.6 Sol、Gemini 3.8 Flash,提供健康科技團隊選型方法。
兩項美國實驗顯示,約七分鐘 Gemini 對話在降低特定陰謀信念評分上優於靜態事實單張。本文拆解研究限制、錯誤與隱私風險,以及台灣衛教聊天助理的導入判準。
比較 GPT-6 Astra 與 Claude 的去 AI 味提示方法,從自然度、指令穩定性、事實準確度與繁體中文適用性,整理台灣健康內容團隊可執行的測試框架。
依官方文件比較 Grok Bot 與 OpenClaw 的權限、沙盒、敏感資料風險與適用情境;本文未含同環境產品實測。
比較 NVIDIA PAIR、Ollama、llama.cpp 與 Open WebUI 的角色、硬體門檻、部署難度、隱私及多人使用,協助需要處理健康紀錄的使用者規劃本機 AI。
微軟推出MAI-Image-2.6-Flash,主打更快、更省。從速度、品質、有效成本、工作流與健康內容治理,拆解團隊導入前該怎麼測。
比較雲端 EHR 連接器、RAG 知識庫與本機模型的準確性、資料隱私、維護成本及臺灣法規要求,提供醫療機構可執行的架構選擇方法。
比較 GPT-6 Astra、Claude Fable 5.1 與 Gemini 3.8 Flash 的醫療文件能力、長上下文、幻覺、價格及高風險限制,提供臺灣醫療團隊可執行的選型方法。
SBOM 是軟體的成分清單,讓企業在漏洞揭露後快速找出受影響的產品與版本。台灣目前以採購要求和實務指引推動,企業可先從版本盤點、更新責任與修補流程開始。
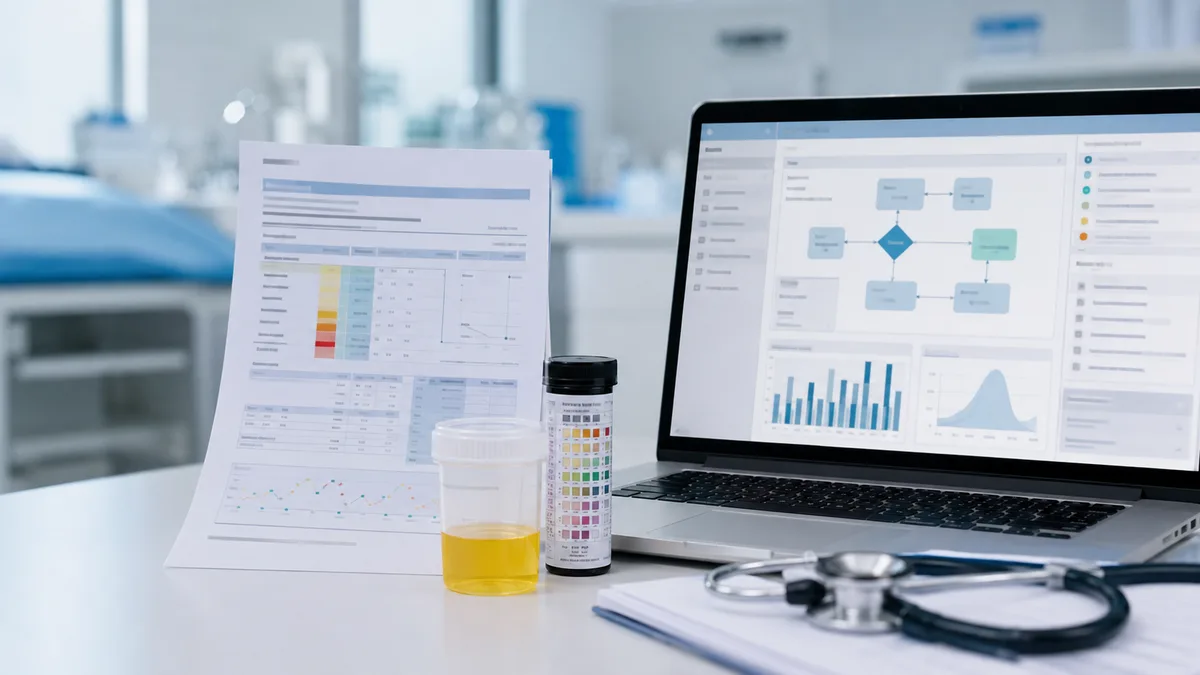
尿蛋白 +1、+2 是尿液試紙的半定量訊號,不能單獨等同腎病。本文整理約 30 與 100 mg/dL 的解讀、複驗與尿白蛋白/肌酸酐比值,並用 FHIR 與 AI 臨床覆核拆解醫院導入做法。
MCP 是讓 AI 應用程式用一致規則連接外部資料與工具的開放協定。本文拆解 prompts、resources、tools、client、server 的運作流程,並整理台灣醫療資料互通、授權與企業導入檢查項目。
AI 醫材拿到許可證只是起點。從輸入資料、輸出性能到人工覆核與停用回復,拆解 TFDA 2026 年 GMLP 原則如何落到醫院的上市後監測流程。
AI 模型量化能縮小模型、降低記憶體需求,部分硬體也能因此加快推論;代價是精度與相容性要重新驗證,INT8、INT4不能直接視為通用加速按鈕。
API 是讓不同軟體交換資料與功能的共同介面。本文用手機 App、AI 服務、健保健康存摺與政府開放資料拆解 API 的請求回應、授權、文件、版本與資安檢查。
醫療 AI agent 能感知環境、規畫多步任務並在授權範圍採取行動。本文拆解它和聊天機器人的差異、資料與工具如何串接,整理衛福部 2026 指引、FDA 監管討論與台灣醫院導入時該先驗收的權限、真人核准、監測與回復流程。
醫療數位孿生是一個和特定病人、器官或醫療流程連結的數位模型,會接收真實資料並模擬可能結果。台灣已有成大阿茲海默症與長庚質子治療研究,但公開進度仍在研究與驗證階段。
個資去識別化是降低資料與特定個人連結的加工流程。健康資料即使拿掉姓名,仍可能因日期、地點、罕見病史或外部資料被重新辨識。
AI醫療涵蓋影像判讀、風險預測、病歷整理與病人溝通,是否屬醫療器材要看預定用途。本文拆解資料、模型、人工覆核與上線監測四個環節,整理台灣衛福部指引、TFDA GMLP與三大智慧醫療中心現況。
EHR就是跨院使用的電子健康紀錄,但醫療AI要真正讀懂它,還得先解決資料語意、個資授權、臨床流程與責任認定四道關卡。本文用台灣衛福部與FHIR現況,逐一拆解每一關要驗收什麼。
天麻常被拿來回答頭痛、眩暈與保健問題,但人體證據多集中在天麻素或複方。AI 能幫忙把藥典、研究與產品標示排在一起,不能替你決定是否適合服用。
醫療 AI 偏誤不能只看全體準確率。本文用台灣 TFDA 2026 年 GMLP、跨院外部驗證與 FDA 透明度原則,整理族群分層、獨立測試、臨床工作流與上線後監測的驗收方法。
AI醫療器材不會因為用了模型就自動歸類,台灣會看產品功能、預期用途、使用方式與可能風險。本文拆解健康管理 App、單獨醫療軟體、CADe/CADx 的差異,整理第二、三等級查驗登記、資料要求與醫院導入前的查核清單。
醫療 AI 出錯時,不能把責任丟給一個抽象的 AI。從台灣衛福部指引與 TFDA 2026 年 GMLP 原則出發,拆解醫院、醫事人員、供應商與資料治理各自要留下的證據。
AI 陪伴機器人可以補上長照裡的互動與提醒,卻還接不起照顧判斷。從失智照護研究、台灣示範案到長照給付現況,拆解這項科技該放在哪個位置。
AI醫療的準確率只代表測試集表現。從預期用途、台灣病人資料、醫師工作流到模型漂移,整理醫院採購與臨床導入前真正該驗收的項目。
健保資料可以支援醫療 AI 訓練,但要先過目的外利用與退出權、資料品質、臨床驗證三道門檻。本文整理台灣受控資料流程、模型跨院驗證,以及 2026 年 8 月法規施行後的申請時效。
FHIR Box可望改善跨院病歷交換,但資料能傳,不等於AI能安全用。本文拆解FHIR標準、資料品質、隱私治理、跨院驗證與可解釋性。
AI 醫材可以更新,更新本身也要被當成臨床流程管理。從 TFDA PCCP 到醫院的版本、資料、介面與人工覆核,逐項拆解模型改版後誰要負責。
AI模型選型要先從任務與資料開始,再用真實案例比較回答品質、延遲、每次呼叫成本、資料處理方式與版本穩定性。本文整理模型家族怎麼分工、台灣人工智慧基本法與風險分類框架走到哪,以及一般人與企業導入前的檢查清單。
合成資料能補醫療 AI 的資料缺口,卻不能直接替臨床證據蓋章。驗證要一路追到資料代表性、獨立外部測試、病歷介接與上線後監測。
醫療 AI 能不能進醫院,決勝點不在展示會上的準確率。從資料代表性、FHIR 串接到醫師覆核和版本監測,每一關都要留下可追溯的證據。
髖關節疼痛看哪一科?AI 可以整理症狀、標示急迫程度與就醫入口,卻不能跳過理學檢查。從 TFDA 電腦輔助分流指引、FHIR 到臨床責任分配,拆解 AI 真正能落地的範圍。
醫院病歷受個資法保護、跨院共享困難,合成資料讓 AI 可以拿「統計特性像真的」但沒有真人紀錄的假資料練功。但假資料一路餵下去也有代價,叫模型崩潰。
FHIR(Fast Healthcare Interoperability Resources)是台灣推動醫療資料互通的核心標準,衛福部並啟動國家數位健康互通性與效能認證實驗室、推進FHIR Box。解析資料標準、三類認證、AI治理與不同層級醫院的導入落差。
源華智醫與瑞士Medvisis簽署AI藥物開發MOU後,合作能否落地,仍要查核工作計畫、資料品質、技術分工、獨立驗證、演算法透明、責任與法規。
多家醫院想合作訓練 AI,個資法卻不准把病歷送出院外。聯邦學習讓模型「巡迴受訓」,資料留在原地,只有學到的權重更新往中央跑。
澳洲政府提出刪除個資權,讓民眾可要求大型社群平台與搜尋引擎移除並銷毀個人資料,但目前仍是曝光草案。門檻、例外與何時上路都在諮詢,9月18日截止收件。
健檢報告解讀準不準,不是你該先問的問題。先問清楚:這套系統出錯了,你找得到誰負責嗎?ChatGPT Health 與健保健康存摺SDK,是兩種完全不同的資料主權設計。
Coldcard冷錢包41分鐘被轉出逾千枚比特幣,根因是建置旗標MICROPY_HW_ENABLE_RNG被誤判為啟用,讓亂數產生器悄悄降級成可預測版本,裝置本身並未遭入侵。拆解事件全貌與3個可執行檢查點,防止同樣的靜默降級發生在你的系統。
Coldcard冷錢包的亂數產生器根因,搬到醫療資訊系統會長什麼樣?從去識別化假名、SMART on FHIR 的 PKCE、亂數品質驗證三個檢查點,拆解一次做錯、長期無感、爆發時無法回溯的共通失效結構。
零信任不預設任何人事物可信任,每次存取都要重新驗證身分、設備與情境。台灣政府機關與金融業都已啟動導入,但走的是分階段路線,不是一步到位的強制令。
FHIR 把病歷拆成機器讀得懂的「資源」。AI 讀結構化 FHIR 資料的代碼準確率能拉到九成以上,遠高於直接讀病歷文字猜代碼。台灣的 FHIR Box 計畫正把這套語言鋪進全台醫學中心。
醫療 AI 上線前最容易被低估的六個坑:稽核怎麼存、去識別化怎麼隔離、embedding 模型怎麼選、如何壓低幻覺做到可溯源,到人機責任怎麼分工。以醫療 AI 合規守門引擎 goalkeeper 為範例,對照衛福部指引與《人工智慧基本法》逐條拆解。
健康存摺SDK現在就能授權下載門診、用藥、檢驗資料,但轉診不用重做檢查、訓練台灣本地醫療AI,靠的是新上線的台灣健康網路平台。文章拆解兩者差在哪、資料會用到哪裡,以及參與前該確認的退出與監理界線。
BrewDog共同創辦人華特提出買回要約,自稱獲4.3萬名投資人支持,卻因聯繫前股東的資料來源不明遭投訴,英國ICO證實正評估相關資訊;收購方Tilray否認外流資料。
Peregrine 募 2.5 億美元、估值 68 億,投資人賭的是把企業髒資料清乾淨、打通孤島的營運軟體。台灣企業導入 agent 前,資料前置工程該怎麼排序,這篇給一條判讀線。
Anthropic 6/17 開首爾辦公室,一口氣拿下 NAVER、三星 SDS、LG CNS、Nexon、Hanwha。拿下一個國家的企業市場靠的不是模型強,而是在地辦公室、資料主權、國家安全合作、in-region data 整套打包。台廠導入前沿 AI,in-region 資料控管會是談判與選型的關鍵籌碼。
Meta Business Agent 平台的賣點是拿海量顧客對話養出幫企業客服與銷售的 agent。技術不難,難的是這些對話的來源同意、二次利用與跨境邊界。台灣企業導入前,先把資料來源盡職調查清單跑過一遍。
微軟 Work IQ 把 email、會議、聊天與協作模式做成語意索引,讓 AI agent 讀懂組織怎麼運作。好處是 agent 更懂你公司,代價是『誰能查到誰的工作軌跡』成為新的隱私與權限治理對象。
Supabase 募 5 億美元、估值 105 億,熱錢從模型移到 AI 應用的基建層。估值翻倍反映 vibe coding 下的真實需求,但維運與資料治理的成本也被一起放大。
Databricks 6/16 發表 Genie One,把 agent 講成能跑重複工作流的「同事」,還給業務開了 vibe coding 環境。當全員自助生成應用,真正的門檻不在介面,在 agent 動得到哪些資料、用誰的權限。
CES 2026 把居家與陪伴機器人推上主角,但要不要交給它照顧長輩,真正的關卡不在機器人多炫,而在台灣剛上路的《人工智慧基本法》問責與資料治理框架下,照護責任、隱私與情感依賴怎麼落地。
從衛福部《醫療機構應用生成式人工智慧指引》到工程設計,拆解合規守門引擎的五道關卡、去識別化管線、Null Provider 可測性設計與守門服務的核心原則。