
DeepSeek 在官方部署問答中表示,支撐 DeepSeek V4.1 Flash 的一個叢集每日服務量達 155 兆 tokens,並公布離峰價格下每 GPU 小時營收 38 美元。這是 DeepSeek 對自家線上服務的說明,展示它要開源的推論系統來自什麼規模的運作環境;不能直接換算成第三方團隊部署後也能達到同樣吞吐或成本。
這套系統的推論框架 DeepInfer 已在 GitHub 以 Apache 2.0 授權公開。名稱容易讓人聯想到「拿來就能架設自有 AI API」,但目前公開內容偏向模型推論引擎與離線執行範例,距離完整線上服務仍有組件要自行補上。開發者評估時,得先回答三件事:手上的晶片是否支援、目標模型是否相符,以及團隊能否補齊服務層。
一、DeepSeek 的生產服務規模,不能直接當成開源部署成效
不代表。DeepSeek 部署問答把 155 兆 tokens 日服務量與每 GPU 小時 38 美元離峰營收,描述為其單一生產叢集的結果。這是官方對整體內部服務的自述,不能當成第三方部署的效能或收益保證。
同一份問答還列出兩項更能看出系統工程的實例。DeepSeek 將 prefill 放在一般 8-GPU 伺服器,decode 則配置在 64 至 128 GPU 超級節點,讓兩種運算階段依負載使用不同資源。官方說明指出,這種拆分可分別調配運算、通訊與排程,目標是兼顧吞吐和延遲。
另一個實例是 KV cache 保留超過 72 小時,讓重複上下文在命中時省下部分 prefill 計算。上述數字與做法都來自 DeepSeek 對自家服務的介紹,屬廠商公開案例,並非獨立實測。
二、DeepInfer 目前支援哪些模型與硬體?
官方 README 列出的模型是 DeepSeek-V4.1-Flash,支援 NVIDIA SM100 GPU 與華為昇騰 950 NPU。 Linux、GCC 13 以上、Python 3.12 以及 CUDA 13 或 CANN 9.2 也列為建置條件。
這份清單是第一道篩選。若團隊主要使用 H100、H200、RTX 顯示卡、AMD 加速卡或終端設備,不能因為 DeepInfer 有 NVIDIA 支援,就推定現有硬體可以執行。
採購、驅動和工具鏈版本都會影響實際可部署性,評估時也可參考DeepInfer 自建部署的晶片與服務缺口。
模型範圍同樣有限。官方公開版本列出 V4.1-Flash,要部署 Qwen、Llama 或其他 DeepSeek 型號,需先核對是否新增支援。
DeepSeek 在官方問答中提到,推論框架支援分散式推論、投機解碼、結構化輸出等功能。分散式推論是把模型運算拆到多張加速卡或多台機器;投機解碼則先生成候選 token,再驗證候選內容,以改善符合條件時的解碼速度。能否帶來收益,要看模型、硬體配置、輸入長度與請求負載。
「This open-source release provides offline inference with the core features needed for serving at scale.」DeepSeek 將公開版本描述為可離線推論、具備大規模服務所需核心功能的版本;這句話同時提醒讀者,核心推論能力和完整服務系統仍是兩個層次。
三、從原始碼建置到離線推論要做哪些事?
先準備符合條件的 Linux 主機與空白 Python 3.12 環境,再選定加速器、建置程式,最後載入預設或本機模型執行範例。這條路徑只驗證離線推論,不能代替 API 服務部署。
官方 README 列出的前置條件包括 GCC 13 以上;NVIDIA 平台需要 CUDA 13,昇騰平台需要 CANN 9.2。建置前建立並啟用空白 Python 環境,再依平台設定 DEEPINFER_ACCELERATOR=nvidia 或 DEEPINFER_ACCELERATOR=ascend,執行 ./build.sh。切換平台時也要確認驅動、工具鏈與硬體型號彼此相容。
首次執行 python examples/offline_inference.py 時,程式會下載預設檢查點 deepseek-ai/DeepSeek-V4.1-Flash-1017 至 Hugging Face 快取。
若模型檔已預先取得或部署環境無法連外,可設定 DEEPINFER_HF_MODEL_DIR=/path/to/DeepSeek-V4.1-Flash-1017 指向本機目錄。
這個流程也帶出授權核對的實務步驟:DeepInfer 程式碼採 Apache 2.0,但模型權重、tokenizer、容器映像與相依套件可能各有條款。部署前應逐項記錄來源、版本、授權與商用限制,不能以主程式的授權推定所有元件相同。
四、效能數字要怎麼對照自己的工作負載?
不能只看 tokens per second;要用相同模型、晶片、輸入長度、並發數與延遲目標重跑測試。DeepInfer README 的基準測試採用 4 張 SM100 GPU 執行 prefill、64 張執行 decode,且分別位於一個 scale-up domain 內,和單卡或邊緣設備的條件不同。
推論有兩個主要階段。Prefill 讀取整段輸入並建立上下文,對提示長度和批次大小敏感;Decode 逐步產生輸出,常以每秒生成 token 數衡量。DeepSeek 的部署問答指出,其大規模線上架構將 Vision Encoder、Prefill 和 Decode 分開配置,並按階段調整資源。
官方例子也呈現負載不同,設定就要改變:文件提供 --decode_num_requests 1 的單請求低延遲測試,也提供增大 prefill batch、調整 EP/DP 平行規模的測試路徑。EP(專家平行)把 MoE 模型的專家分散至多個裝置;DP(資料平行)則讓不同副本處理不同請求。單請求的數字不能代表多人同時使用時的總吞吐,只看滿載吞吐也可能掩蓋個別請求等待過久。
作為對照,vLLM 官方模型 recipe 已列出 DeepSeek-V4.1-Flash 的部署設定與多種硬體驗證狀態,涵蓋 H100、H200、B200、GB200、AMD MI300X 等平台。這不代表每個配置都能直接複製,也不等於所有硬體表現相同。
README 的基準條件以多卡 SM100 為主,未提供昇騰平台的同一組對照數字。採用昇騰 950 的團隊,應以自身 CANN、韌體、模型版本和請求組合重跑測試。
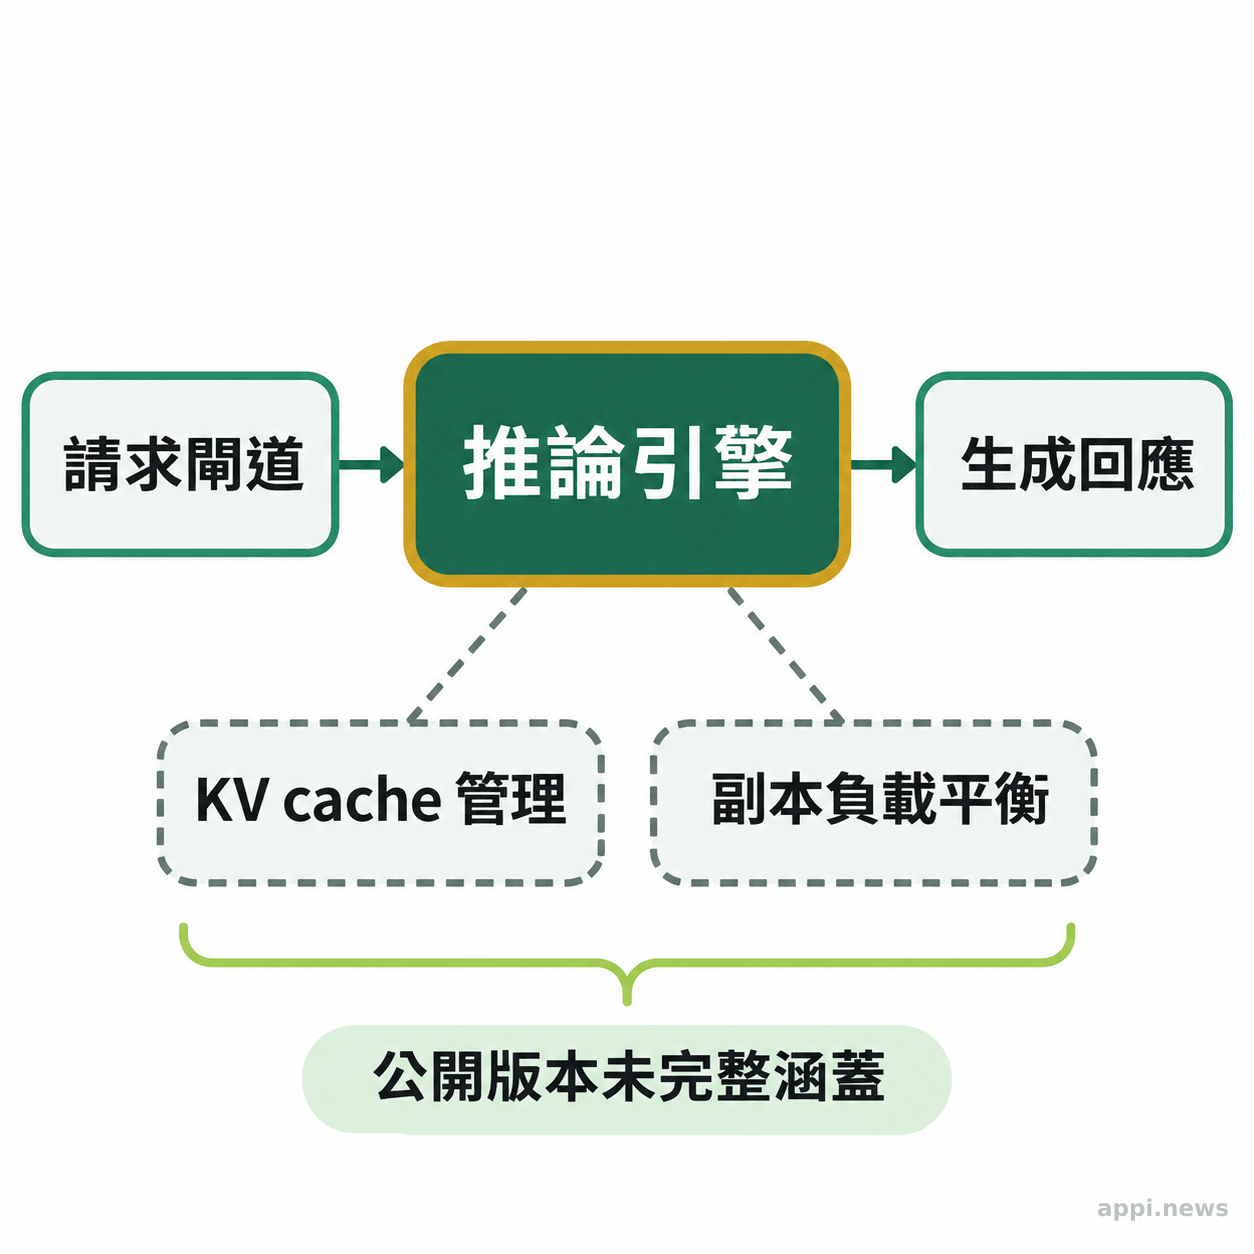
「The KV cache management and load balancing components … are tightly coupled to our internal infrastructure, so that code is not yet fully open-sourced.」DeepSeek 在部署問答中直接指出兩個服務組件尚未完整公開,這比「開源即可降低成本」更能說明自建服務需要評估的工程範圍。
五、完整線上服務還需要哪些組件?
現有官方範例主打離線推論,完整線上服務需要的 KV cache、Prefill/Decode 分離與副本負載平衡,README 明列尚未包含。團隊若需要供多位使用者持續呼叫的 API,仍要自行整合這些部分。
離線推論是把輸入交給模型、在本機或叢集完成生成,適合先驗證模型輸出與硬體路徑。線上服務還需要接收請求、管理並發、排隊、監控錯誤、分配流量和保護資源。
KV cache(鍵值快取)保存前序 token 計算出的 key/value 張量,後續生成可沿用這些資料,減少重複計算。若快取生命週期、容量和淘汰策略沒有設計好,長對話或高併發會增加記憶體壓力,也可能拖慢請求處理。
DeepSeek 部署問答說明,KV cache 管理與負載平衡和公司內部基礎設施緊密耦合,因此未完整開源。引擎程式碼公開,不等於服務控制面、快取儲存、API 閘道與故障處理也已備妥;沒有推論平台工程人力的團隊,這些部分可能比安裝模型更花時間。
六、DeepInfer 和 vLLM 怎麼選,如何判斷是否進 PoC?
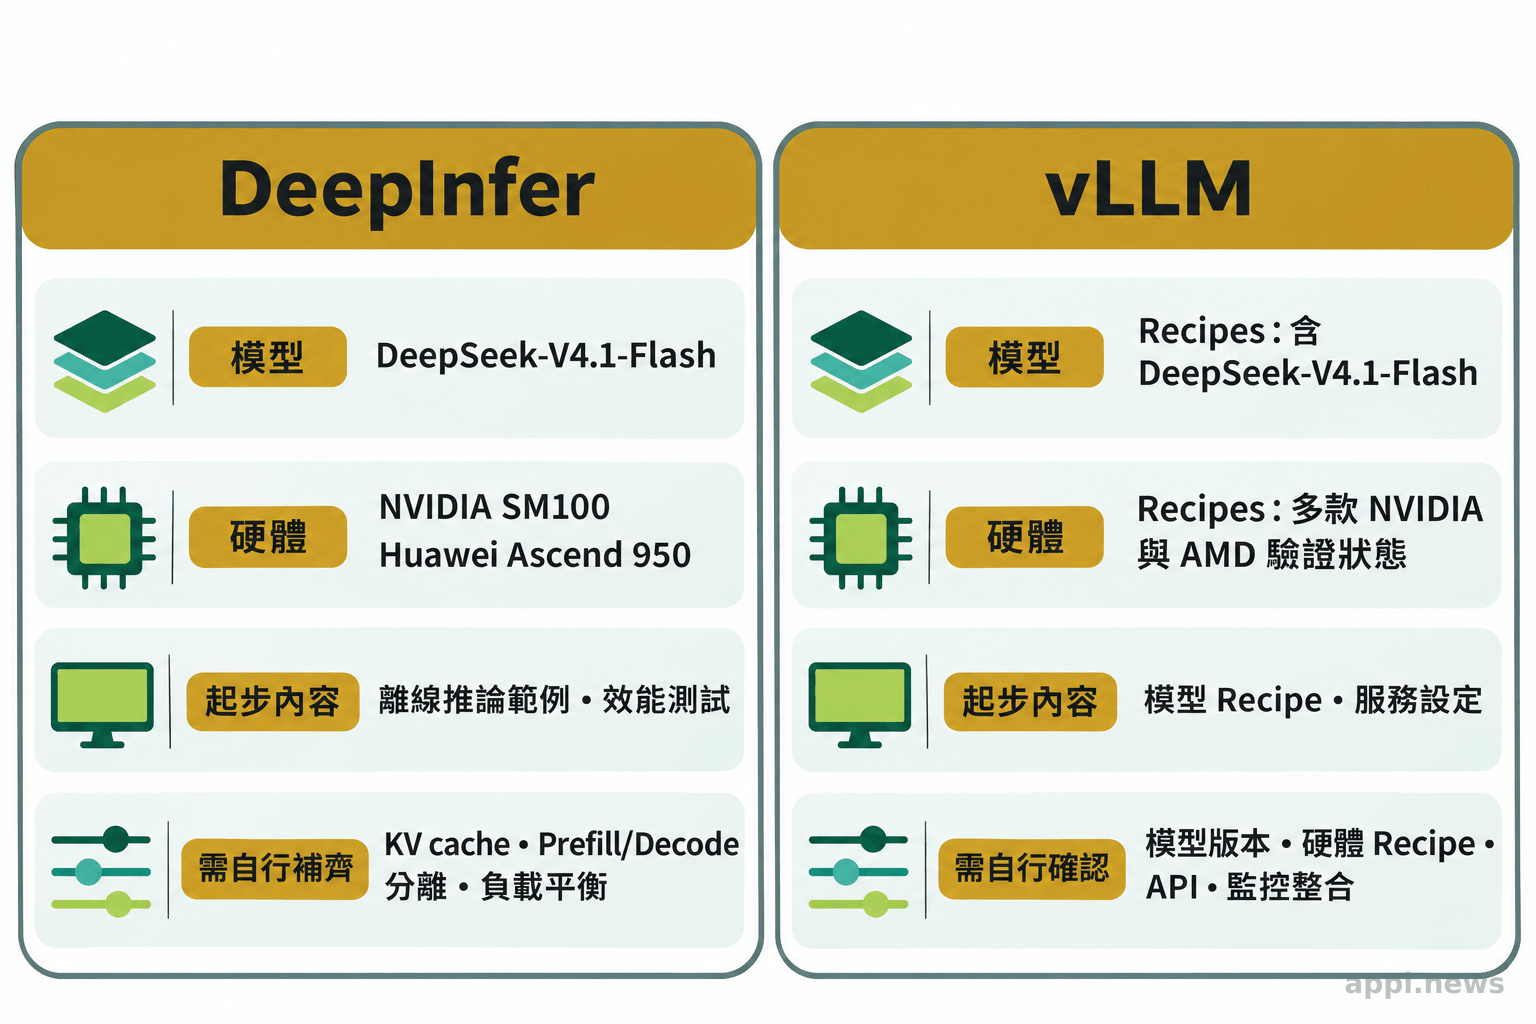
若目標是 DeepSeek-V4.1-Flash,且團隊具有列出的 NVIDIA SM100 或昇騰 950 硬體,DeepInfer 值得進入實測;若需求涵蓋多種模型、更多硬體,或希望沿用較完整的既有 serving 工作流,先評估 vLLM 等通用方案。選擇應以相容性與端到端服務需求為準。
| 評估面向 | DeepInfer | vLLM |
|---|---|---|
| 本篇引用材料所示定位 | DeepSeek 模型專用推論框架 | 以此模型 recipe 顯示的部署設定為例 |
| 官方材料列出的模型 | DeepSeek-V4.1-Flash | 官方 recipe 已含 V4.1-Flash 等模型設定 |
| README 所列硬體 | NVIDIA SM100、華為昇騰 950 | V4.1-Flash recipe 列有多種 NVIDIA 與 AMD 硬體驗證狀態 |
| 可直接起步的內容 | 離線推論範例、建置與 benchmark | 模型 recipe 與 serving 部署設定 |
| 部署前要補查 | KV cache、Prefill/Decode 分離、負載平衡 | 具體模型版本、硬體配方及所需 API/監控整合 |
DeepInfer 的價值在於把 DeepSeek 自家大量服務中累積的核心引擎與模型專屬優化公開,包含非同步排程、批次不變推論和結構化輸出等。對想研究 V4.1-Flash 推論路徑的團隊,這能減少從零摸索的工作。
vLLM 的模型 recipe 則提供另一種起點:直接查看對應模型的硬體與啟動參數,再依團隊現有的部署管線調整。若工作只需離線批次生成、模型和晶片吻合,DeepInfer 的專用優化值得基準測試;若需要不同模型共用一個平台,維護多種後端可能更重要。
導入前用四步檢查成本與可行性
- 對平台清單:確認 GPU 是否為 SM100,或 NPU 是否為昇騰 950,並核對 Linux、GCC、Python、CUDA/CANN 版本與驅動相容性。
- 對模型版本:確認權重、tokenizer 與程式版本相符。先用少量真實任務檢查輸出正確性、結構化格式和錯誤處理。
- 對流量型態:以自家提示長度、輸出長度、尖峰併發和延遲上限設計測試,同時記錄 prefill 延遲、decode 吞吐、GPU/NPU 記憶體與失敗率。
- 對服務缺口:列出 KV cache、請求佇列、負載平衡、API 協定、身分驗證、監控、擴縮容與故障復原由誰負責;另確認資料存取權限、日誌保存期間及刪除方式、模型檔案來源與完整性驗證、API 金鑰保護和流量限制。逐項指定維護人員並估算人力和硬體成本後,再決定是否上線。
如果團隊只想評估離線推論,第一輪可聚焦模型載入、結果一致性與單位請求成本。若目標是正式 API,測試還要涵蓋多請求併發、快取命中、節點故障及服務恢復。
採用昇騰等不同加速器的台灣團隊,還需確認硬體供應、維修支援和軟體版本維護節奏;也可對照DeepSeek 昇騰開源工具的部署條件,檢視自身環境與服務缺口。
PoC 的結束條件也應先寫明:例如支援的模型與硬體已驗證、代表性流量下達到團隊設定的延遲及錯誤率門檻、授權與資料處置完成盤點,且服務元件各有維護負責人。未達條件時,先記錄瓶頸屬於硬體、模型相容性還是服務整合,再決定縮小範圍或停止評估。
DeepSeek 將核心推論程式開源,提供開發者檢視和試跑其專用框架的機會。就目前公開版本而言,較精確的定位是「可離線執行、面向 DeepSeek-V4.1-Flash 的推論引擎」,而非開箱即用的終端 AI 服務。是否降低自建成本,取決於團隊是否已擁有相容加速器,以及補齊線上服務組件所需的工程能力。
- DeepInfer 官方列出 V4.1-Flash、NVIDIA SM100 與昇騰 950,平台範圍需逐項核對。
- 公開版本含離線推論能力,KV cache、Prefill/Decode 分離與負載平衡仍是完整服務的缺口。
- 效能測試要對齊模型、硬體、輸入長度、併發與延遲目標,不能直接套用官方多卡數字。
常見問題
Q1: DeepInfer 是邊緣 AI 推論框架嗎?
官方描述將 DeepInfer 定位為支援 DeepSeek 大規模服務的推論框架,公開範例以資料中心級加速器和離線推論為主。README 未列出手機、筆電或一般邊緣裝置支援,因此不宜直接稱為可部署於終端設備的框架。
Q2: DeepInfer 能直接服務其他開源模型嗎?
目前 README 列出的支援模型是 DeepSeek-V4.1-Flash。其他模型是否相容,需以官方後續版本和程式碼為準。
Q3: 使用 DeepInfer 就能取得 DeepSeek 官方 API 的服務品質嗎?
不能僅憑框架開源推定服務品質相同。官方問答表示處理邏輯與 DeepSeek API 對齊,但完整 KV cache 與負載平衡尚未全部開源;實際延遲、可用性和成本仍取決於部署者的硬體與服務設計。


