企業導入 AI 時,瓶頸常在於關鍵脈絡散落於文件、試算表、郵件、資料室與內部系統。同一家公司、客戶或條款可能使用不同名稱,聊天機器人即使找得到文件,也未必能把相關事實連起來。V7 展示以 GPT-5.6 系列模型建立 Context Graph 機構記憶;但公開案例仍來自特定產品、資料集與工作流程。
一、企業知識庫為什麼不能只靠一個聊天機器人
聊天機器人處理當下問答,企業知識庫還要管理資料關係、來源證據、權限與流程。 若資料只停留在可搜尋文件的層次,跨部門、跨版本問題仍可能要人工拼接。
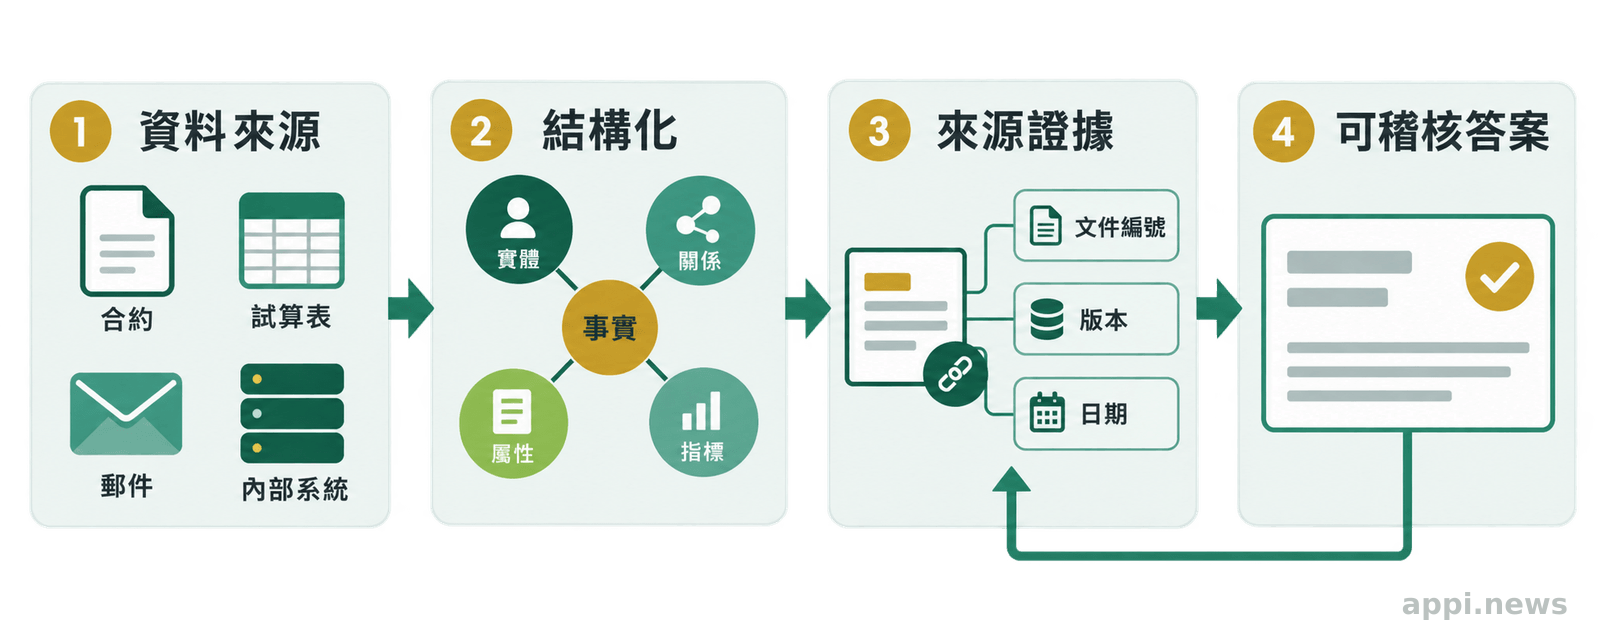
法務合約、財務試算表與郵件可能用不同名稱指向同一對象,系統還要判斷日期、版本與關係,再回到原始檔案核對。TechNews 引述劉建萍指出,企業導入 AI 需要一起處理資料、流程與治理。
「數位化」不等於「自動化」。— 劉建萍,叡揚資訊業務發展顧問部經理(TechNews 引述)
二、V7 如何把企業檔案整理成 Context Graph
依 OpenAI 官方案例描述,V7 Go 以 GPT-5.6 Luna 從大量檔案擷取實體、關係、事實、屬性與指標,再把事實連回原始證據,形成可供查詢的 Context Graph。 當圖譜資料不足時,該案例也描述可回到底層文件進行 RAG 搜尋;這些功能仍應視為產品方公開架構描述,不等同於跨產品獨立評測。
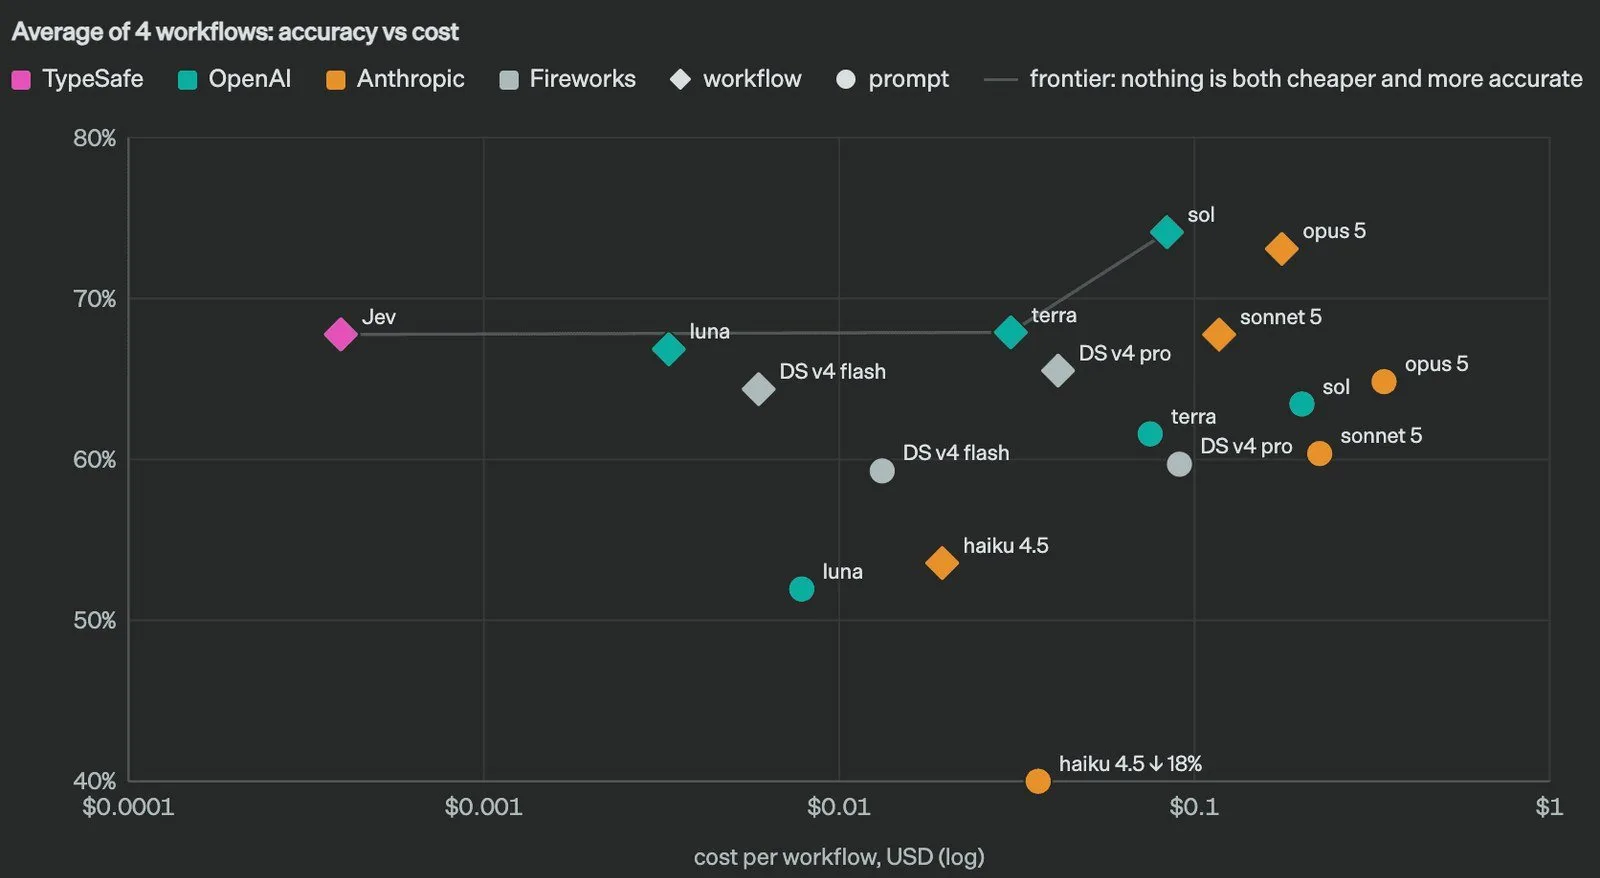
OpenAI 官方案例指出,V7 Go 可連接 SharePoint、Google Drive,將 Context Graph 提供給 MCP 搜尋與工作流程。GPT-5.6 Luna 負責結構化擷取,GPT-5.6 Terra 或 Sol 用於對話與工具使用,較困難查詢開始測試 GPT-6 Astra。HERB 測試與客戶案例數字只能用來理解產品方向,文件格式、中文比例、權限和評測題目都會改變結果。
三、V7、傳統 RAG 與長上下文差在哪裡
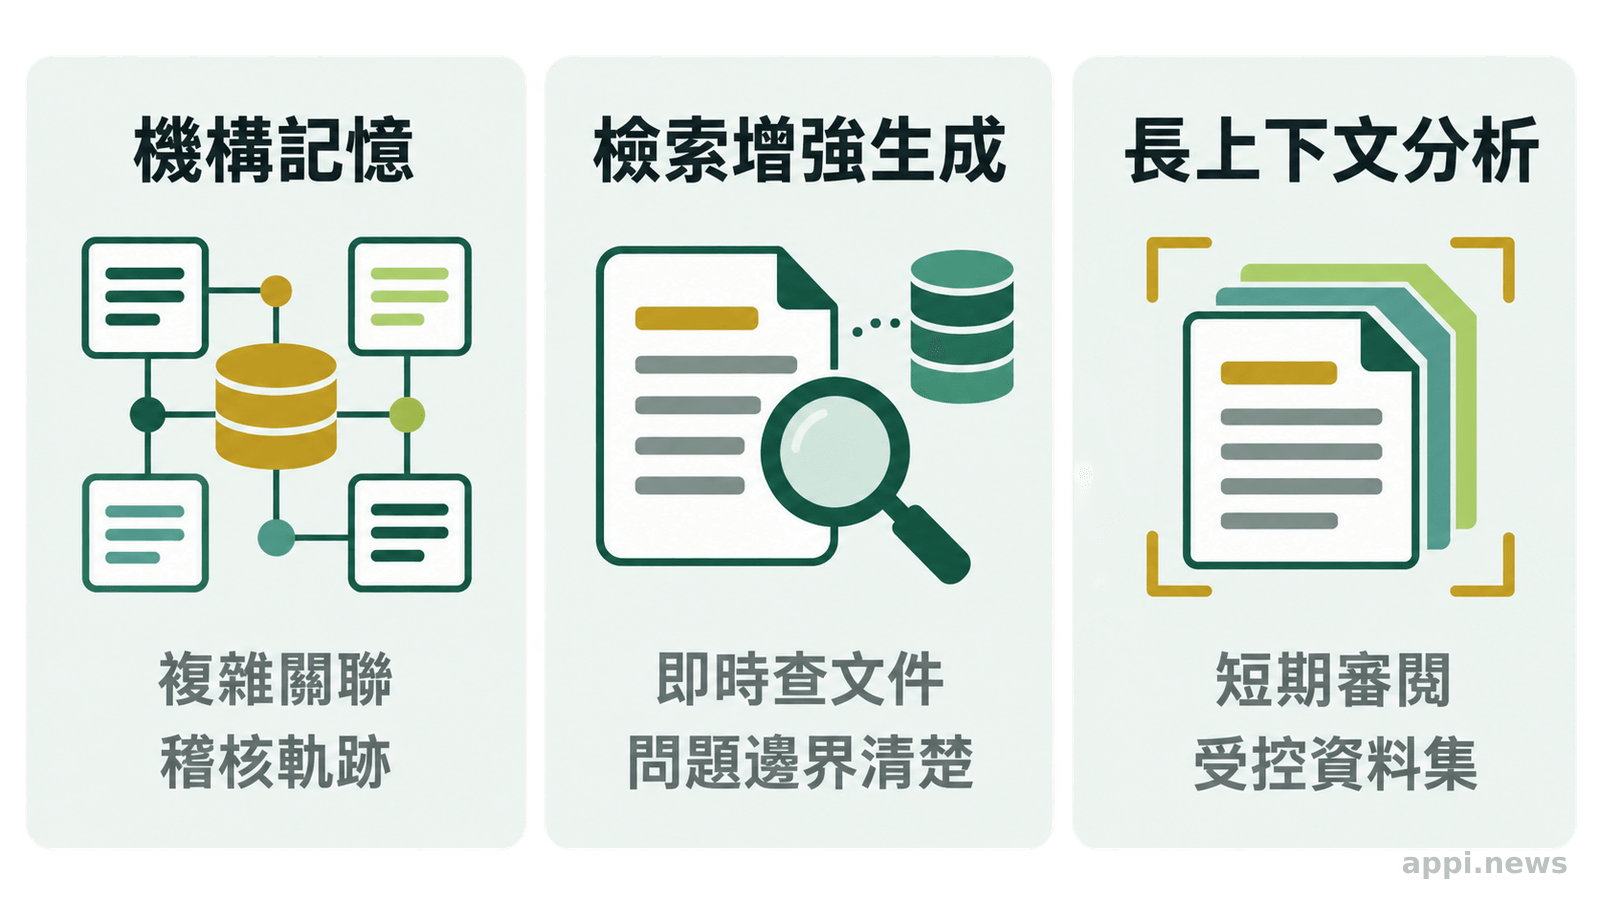
三種架構的差異,在於資料何時整理、回答依據如何取得,以及維護成本落在哪裡。 V7 式機構記憶先建資料結構,RAG 在提問時檢索片段,長上下文把大量資料放進模型。
| 比較面向 | V7 式機構記憶 | 傳統 RAG | 長上下文 |
|---|---|---|---|
| 資料處理 | 先擷取實體、關係、事實與來源 | 文件切分、嵌入、索引後檢索 | 工作階段直接提供大量文字 |
| 跨文件關聯 | 適合預先整理明確關係 | 取決於切分與召回品質 | 取決於編排與模型理解能力 |
| 引用追溯 | 事實可連回原始證據 | 多引用檢索到的片段 | 需另行設計引用與版本機制 |
| 更新維護 | 更新圖譜、本體與來源 | 更新索引、權限與片段 | 每次重新組裝上下文 |
| 適用情境 | 關係複雜、流程長、需稽核 | 即時查文件、問題邊界清楚 | 短期分析、資料集受控 |
跨文件問題若要辨認同一家公司在合約、財報與郵件中的不同稱呼,結構化關係可能減少重複搜尋;查最新內規段落,RAG 往往較直接;完整文件的短期審閱則可測試長上下文。三者都要處理版本、權限、引用和更新成本。
這些判斷只能作為試點的起始假設,不能脫離資料條件解讀。比較時應固定同一批文件、同一組問題、相同的權限設定與模型版本,分別記錄答案是否涵蓋關鍵事實、引用能否回到正確版本,以及從提問到完成覆核所需的時間。若只比較一次回答,容易把提示設計或單一文件品質誤認成架構差異。
跨文件關聯也有失效情境。實體解析可能把同名公司接錯,舊文件可能覆蓋新規則,使用者無權讀取原始檔時,圖譜又可能只剩不完整的關係。遇到來源衝突、關聯信心不足或權限截斷,系統應標示不確定性、停止延伸推論並要求人工確認;這些事件要納入評測,不宜只計算答對題數。
四、企業資料隱私與治理是架構選擇之外的關鍵
先定義資料分級、權限繼承、模型服務邊界與責任分工,再決定架構。 技術能讀取文件,和企業是否允許它讀取、保留、傳輸或產生後續行動,是不同問題。
權限要從原始系統一路追蹤到索引、圖譜、快取、日誌與輸出。某位員工能看見的資料,不代表他透過 AI agent 就能取得整個部門的內容;角色、群組、文件密等級別與有效期限都要同步。
金融、保險、法務與製造企業可將公開資料、營運資料、商業機密和個資分區。若涉及醫療或保險資料,孕婦、兒童、慢性病患者、長期服藥者的紀錄可能需要提高保護層級;用藥或藥物交互作用資訊也要分開技術擷取、專業覆核和決策責任。
跨境傳輸的適用判斷,須依資料類型、台灣個資法與產業規範、企業所在地及資料接收地規範確認;供應商契約可明定授權範圍、留存與刪除、次處理者及事件通報責任,必要時由法務確認。法務部《個人資料保護法規及參考資料彙編》可作為台灣個資法規與參考資料的查找入口,但不取代個案法律判斷。
NIST 將資料隱私、第三方與供應鏈列為持續管理面向。
“To solve hard enterprise use cases across finance and insurance, AI needs to learn how your business operates just as well as it learned from the Internet.” — Alberto Rizzoli, V7 共同創辦人暨執行長(OpenAI 官方案例引述)
五、哪些企業情境較適合 V7、RAG 或長上下文
文件量大且跨文件關係複雜的企業,可評估 V7 式機構記憶;資料更新頻繁、問題邊界清楚的場景常先從 RAG 開始;短期、受控資料集可先測試長上下文。 最後仍要用實際工作問題比較。
金融、保險案件審查、法務合約追蹤與製造設備履歷都重視跨文件關係、時間點與引用,可評估結構化記憶。查最新版本可先用 RAG;一次性合約初篩可測試長上下文。缺少權限清單和覆核流程時,維護成本可能超出預期。
六、企業知識庫架構選型先看哪些條件
先從真實問題、資料關係、風險邊界與維護能力建立基準,再用同一批問題測試回答品質、引用完整度、延遲、成本與人工覆核時間。 這樣才能判斷架構是否對準企業的根因。
- 盤點資料與權限:列出常查文件、來源系統、更新頻率、版本規則與可讀角色。
- 建立共同評測題目:用真實問題要求各架構提供答案、引用與版本說明。
- 測量全流程成本:記錄模型費用、索引或圖譜維護、權限同步、延遲與覆核時間。
- 設定失敗處理:測試來源不存在、權限不足或資料過期時,系統是否要求人工介入。
比較三種架構時,需交代資料集、模型版本、評測方法和成本口徑;公開測試結果不能改寫成普遍效能承諾。
試點資料不宜只挑容易回答的公開文件。可從法務合約、客服紀錄、製造維修單或內規中抽出一組已知答案的問題,涵蓋跨文件查找、日期版本、表格數字、來源衝突與權限限制。每題先由業務人員定義關鍵答案與可接受來源,再讓三種架構用相同資料和相同問題回答,最後由熟悉流程的人員盲評,區分檢索不到、引用錯誤、推論過度與格式不符。
評測結果要先轉成通過門檻,再討論採用哪種架構。例如,低風險查詢可要求關鍵事實都有來源且引用完整度達到事前設定值;涉及機密或個資的題目,未授權資料的暴露率應以零為通過條件。人工覆核時間若高於現行流程,或答案雖完整卻無法交代版本,也應列為未通過,而不能只看文字是否流暢。
權限同步要另外做失敗測試。當員工離職、職務變更、文件撤回或群組權限延遲更新時,分別檢查索引、圖譜、快取、日誌與引用連結是否同時收回。若其中一層仍保留舊權限,系統應拒絕回答並留下可稽核事件;不能以模型猜測使用者是否有權限,也不能用較寬的服務帳號繞過原始系統的限制。
成本計算也要涵蓋完整生命週期,包括文件清理與擷取、嵌入或圖譜建立、儲存、模型呼叫、權限同步、監控、人工覆核、供應商費用與故障處理。台灣企業常有中英混雜文件、掃描檔、舊系統與跨部門帳號,還要把 OCR、欄位對應、中文檢索品質、資料所在地和跨境審查納入估算。單看每次問答的模型費用,會低估真正的維護負擔。
試點結束後,決策紀錄應寫明哪些問題通過、哪些資料類型排除、由誰負責覆核,以及資料更新失敗時如何降級。若只有短期合約能通過,長期內規與權限同步仍失敗,就應縮小上線範圍或延後導入;若三種架構各自在不同題型勝出,也可採取分層方案,讓 RAG、長上下文與結構化記憶各自處理有明確邊界的工作。
結論:企業真正要選的是記憶治理方式
企業要選的,不只是 V7、RAG 或長上下文其中一個名稱,而是資料如何被整理、查詢、更新、授權、引用與覆核。 架構能否長期運作,取決於它是否嵌入流程,並讓錯誤、版本與責任都有可追蹤的位置。
V7 的 Context Graph 展示把散落檔案轉成機構記憶的路徑;RAG 適合即時文件查詢,長上下文有短期分析價值。企業可先盤點常查文件、權限與跨文件關聯,再用同一組問題比較。
- V7 式機構記憶預先整理實體、關係、事實與來源證據,供查詢與工作流程使用。
- RAG、長上下文與機構記憶各有適用情境,結果要連同資料集、模型與評測方式解讀。
- 導入前應處理權限、資料分級、個資、跨境、稽核與人工覆核,公開案例不能直接當成普遍效能保證。
常見問題
Q1:V7 是 RAG 的替代品嗎?
不一定。官方資料描述 V7 Go 以 Context Graph 整理企業脈絡,圖譜資料不足時仍可搜尋底層文件,因此兩者可能同時存在。
Q2:企業知識庫一定要先做 Context Graph 嗎?
不一定。即時查文件可先建立權限正確的 RAG;需追蹤實體、關係和歷史版本,再評估圖譜化成本。
Q3:AI 知識庫的答案可以直接採用嗎?
涉及機密、個資、合約、理賠與財務判斷的結果,應保留來源、版本和稽核紀錄,並安排人工覆核。引用存在不代表答案自然正確。
參考來源
- OpenAI (2026). How V7 gives AI agents institutional memory
- TechNews 科技新報 (2026). 企業導入 AI 常面臨「系統孤島」!叡揚揭「三大關鍵」助突破 AI 落地難題
- National Institute of Standards and Technology (2024). Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. *NIST AI 600-1
- 法務部 (2016). 個人資料保護法規及參考資料彙編