很多團隊看到 AI 代理基準分數提高,會先解讀成能力進步。但要先問:分數量到的是可帶往新任務的能力,還是代理對舊題更熟?Google 團隊提出 RRSI,探討自我改進代理如何降低有限評測任務造成的過度擬合。判讀時也要查任務是否參與改動與版本選擇。
一、AI 代理分數提高,先問它學會能力還是熟悉測試?
單一基準分數提高只能說明代理在該評測設定中表現改變,不能單獨證明能力已泛化。 團隊還要檢查任務是否參與了迭代、版本挑選,以及最終報告。
自我改進代理會根據任務結果修改模型周邊的提示、工具、流程或記憶,再用分數決定保留哪個版本。若反覆回饋同一批任務,候選系統可能逐漸適應任務描述、評分器偏好或特定工具介面。因此,分數提高不等於模型學會了可遷移的解題原理。
「記住測試」不必然是背下答案、資料污染或蓄意作弊。代理可能學到題目線索、檔案位置、評分流程或特定操作順序;換了任務、工具或驗證方式,效益可能縮小。
「反覆演化可能因記住訓練任務而過度擬合,讓同分布上的大幅提升在分布外基準中縮小,甚至消失。」這是 Xia 等人在 RRSI 論文摘要提出的研究問題,描述的是一種評測風險,不代表每個自我改進代理都已發生測試記憶。
二、固定任務為什麼會讓代理評測失真?
當團隊多輪依同一批任務提出改動、挑選版本並報告結果,這批任務就同時成了訓練訊號與評分尺。 評測回饋越常被用來決策,對未見任務的判斷就越需要獨立證據。
代理的 harness(模型周邊的提示、控制流程、工具、記憶與上下文管理)會影響模型如何讀取資訊、處理錯誤及整理輸出。即使模型權重凍結,改良 harness 仍會改變代理行為;RRSI 研究聚焦的正是這層系統。
適應性過度擬合,是候選方案隨每輪評測結果改變,最後利用了這批資料中的偶然規律。若代理每次都在相似的程式修復題失敗,改進器可能逐輪加入特定操作;再用同批題目挑版本,分數未必能預測它在不同程式庫或新型錯誤上的表現。
統計研究指出,反覆查看同一批資料再選擇假設,會影響推論可信度。Dwork 等人提出 reusable holdout(可重複使用的保留集),探討如何在反覆分析時維持驗證效力。代理評測也要盤點測試集揭露了多少資訊,以及這些資訊如何影響版本決策。
三、Google 的 RRSI 研究如何限制基準過度擬合?
RRSI 同時約束改動提案與版本選擇,並把任務專屬線索、評測雜訊和額外推論成本納入篩選。 它保留 harness 的改動空間,透過可檢查的假設與紀錄約束搜尋方式。
提案階段逐步縮小單一候選可打包的改動數量,並記錄元件與假設。系統參照歷史,避免重提已被否定的方向;進展停滯時則探索尚未觸及的元件。較少且可追溯的改動,讓團隊更容易辨認哪些變更帶來結果。
選擇階段先篩查候選是否含有基準專屬的任務名稱、答案或邏輯,再將表現變化與未修改版本的測試波動比較。改善未超過估計雜訊時,微小分數上升不足以讓改動通過;額外推論 token 也須有相應成效支撐,失去效益的元件則列入刪除考慮。
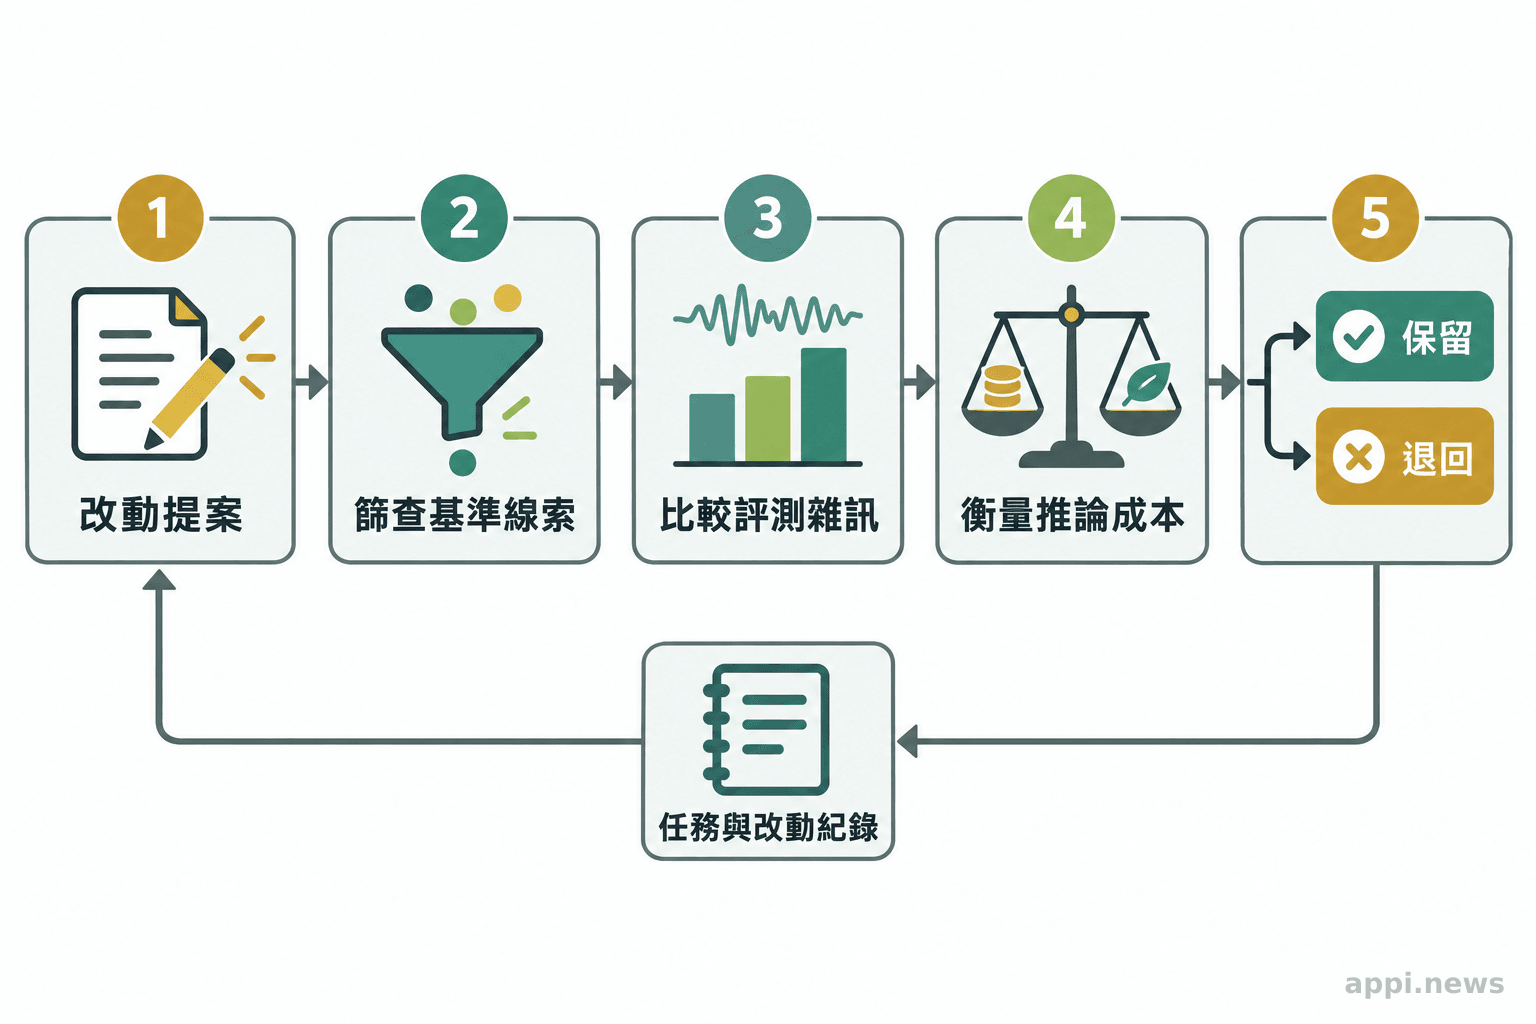
研究涵蓋程式、工作空間代理與工程設計。各領域先用一組任務演化,再將最終 harness 原樣放到保留基準。作者報告演化基準與六個保留切分都有改善,其中五個屬分布外基準;這只代表該實驗結果。
四、團隊如何檢查評測是否測到泛化能力?
先把任務按用途分開,再保留一組不參與改動與版本挑選的測試,並記錄每個版本實際接觸過什麼。 評測結論應同時交代分數、波動、成本與任務範圍。
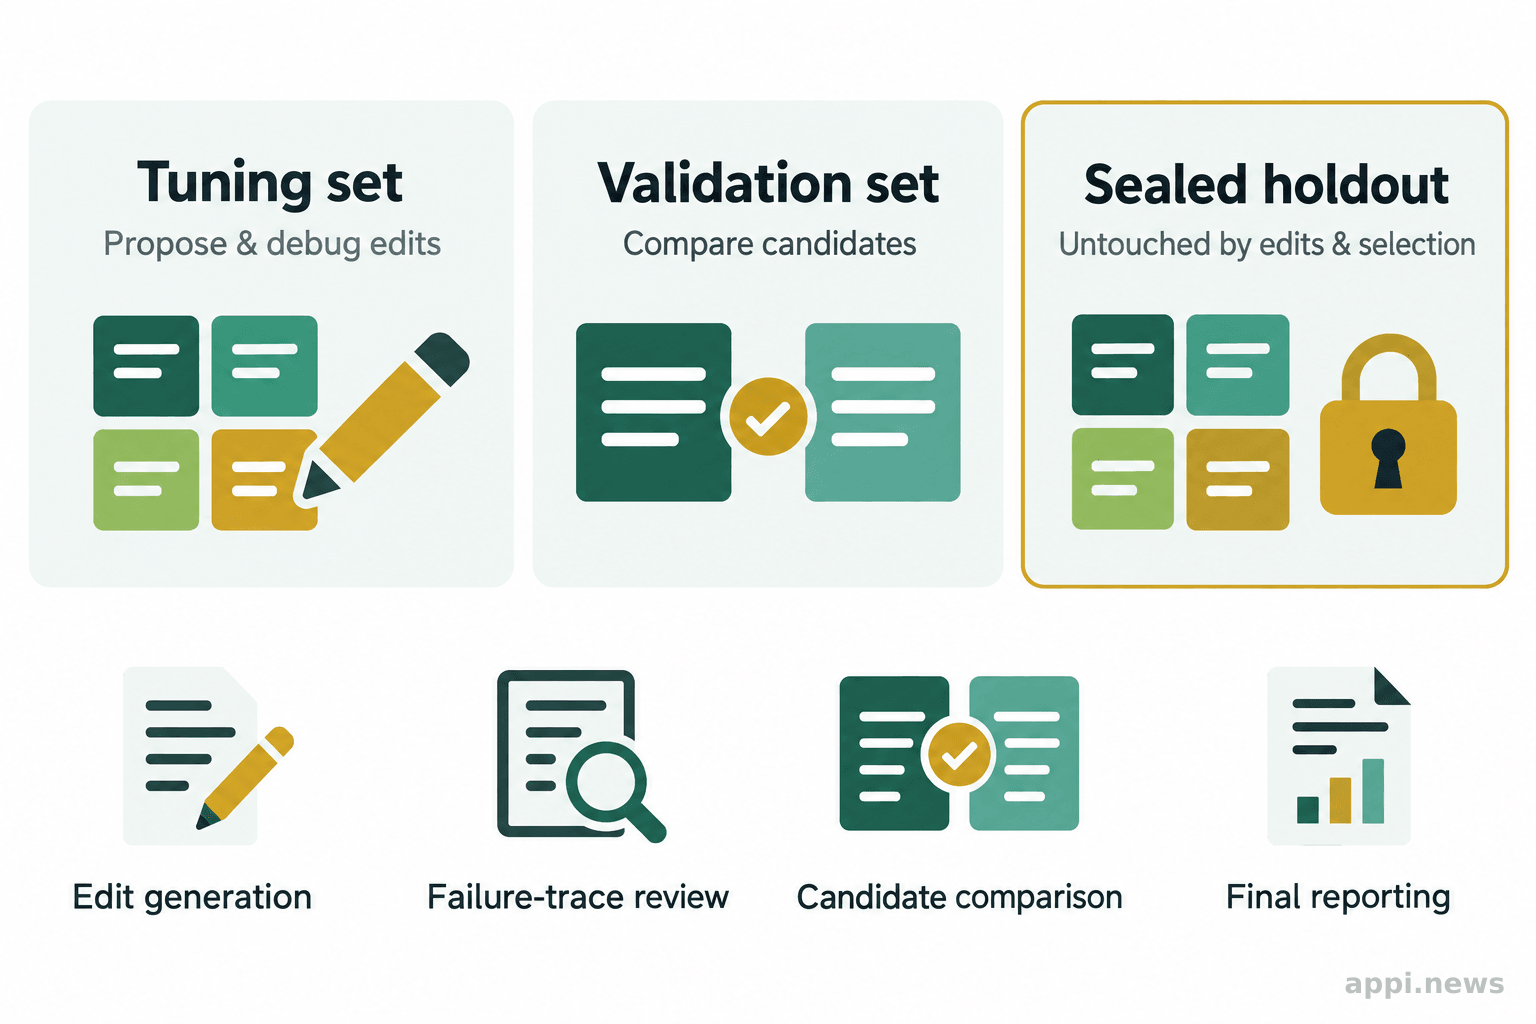
- 劃分任務用途。 調整集用於提案與除錯,驗證集用於比較候選,最終保留集不參與改動或版本挑選。若反覆依驗證結果改設計,它就不再是獨立檢查。
- 記錄接觸史。 標記任務是否用於生成改動、閱讀失敗軌跡、比較候選、調參或挑選發布版本;被改進流程利用的測試輸出與答案也要記錄。
- 跨任務重測。 加入任務描述、工具介面、資料來源或評分器不同的測試,檢查代理是否只適應原基準。這仍不能涵蓋所有真實情境。
- 重複執行並估算波動。 以相同條件重跑,報告分數變化和執行成本,避免把隨機性或環境差異造成的一次波動當成穩定進步。
- 保存版本與決策。 記錄基準版本、任務切分、提示與工具設定、每輪改動、結果及接受理由,方便追查分數變化來自何處。
同一模型若同時生成測試與程式,兩者可能共享假設。這種自我檢查不能視為獨立驗證,應搭配不同來源案例、規則檢查、人工審閱或另一套評分流程。測試通過只支持其涵蓋的情境與屬性。
若系統委派多代理工作或直接部署,測試還要涵蓋交接、權限邊界、失敗復原及人工核准點。高風險系統應依失效後果提高驗證要求。
「在適應性分析中,新的分析會根據資料探索與先前分析的結果而產生。」Dwork 等人在 reusable holdout 研究中說明了重複使用資料所帶來的推論挑戰;對代理團隊而言,版本挑選本身也應納入評測接觸紀錄。
五、RRSI 結果可以支持什麼,還有哪些限制?
不能。RRSI 提供的是一種在特定代理 harness 與基準設定中限制搜尋過度擬合的方法,實驗結果支持進一步驗證,不等於普遍部署成效。
研究結果來自有限任務切分、評分方式與代理配置。多個保留基準仍是有限樣本,不能代表所有未來任務;其他模型、工具或改進流程是否有相同效果,仍需獨立測試。
保留集也不是永久安全區。若團隊反覆查看結果並據此改代理或選版本,它就成了調整訊號。只換任務文字、沿用相同解題結構,也未必算獨立任務,因此仍要檢查切分方式與部署條件。
團隊可先挑一項反覆調整的代理任務,盤點它是否用於提案、比較候選、調參或報告,再確認有沒有未參與選擇的任務可作獨立檢查。若沒有,先隔離用途並記錄接觸史,再解讀分數;同時檢查評分穩定性與成本。
- 分數上升表示特定評測條件下的表現改變,不自動等於可泛化能力提升。
- 任務是否參與改動、版本挑選與報告,決定評測結果能否作為獨立證據。
- 透過任務隔離、跨基準重測、接觸紀錄、重複執行與成本比較,補足單一分數看不到的資訊。
- 高風險系統應依失效後果提高驗證、人工核准與回復要求。
常見問題
Q1:AI 代理記住測試任務,是否等於作弊?
不一定。可能是代理適應了固定任務的線索、工具介面或評分規則,也可能是評測流程讓特定策略反覆獲得優勢。判斷前應檢查資料來源、任務接觸史與改動方式,不能直接推定蓄意作弊。
Q2:保留測試集只要不拿來訓練就足夠嗎?
還不夠。若團隊依分數調整系統或挑版本,保留集已影響決策。應記錄結果的查閱與後續改動;必要時另備獨立任務。
Q3:跨基準測試能證明代理可以應付真實工作嗎?
它能補充代理在不同任務或工具上的表現證據,卻不能涵蓋所有部署條件。實際上線前仍需測試資料、權限、工作流程、失敗處理與人工核准等環節。
Q4:RRSI 是否適合所有 AI 代理團隊?
研究方法可作為參考,適用性取決於代理架構、任務分布、評測成本和失效後果。團隊可先試行任務隔離與接觸紀錄,再評估是否擴大機制。