
Living Context 公開的 Bellwood-QoE 任務,要求 AI 代理整理一家公司的盈餘品質資料簿:它得從總帳、銀行紀錄、薪資資料、合約往來與收購草案中找證據,再修訂既有工作簿,並把發現對應到 EBITDA、每月營運資金和淨負債。SemiAnalysis 表示,25 次嘗試沒有模型全數通過 11 項檢查,最佳單次通過 8 項。這是 GDPx 的公開金融案例,展示跨文件判斷與交付核對;SemiAnalysis 的 GDPx 案例說明也列出其中的失誤原因。
這個任務提出一個問題:AI 代理評測分數能說明多少真實知識工作能力?GDPx v1.0 排行榜上,Claude Opus 5.5 得分 12.0%、排名第一,Gemini 4 Carbon 為 10.9%,GPT-6 Astra 為 9.6%。分數不能直接換算成職務自動化比例,結果也受任務、評分方式與執行環境影響。
想讀懂這個結果,可以先掌握AI 代理評測是否能泛化的檢查方式;GDPx 提供另一個觀察角度,重點放在代理能否在模擬工作環境中完成多步任務。
一、GDPx 的 12% 是哪一種評測結果?
12.0% 是 Claude Opus 5.5 在 GDPx v1.0 公布設定下的總分,不是所有知識工作的成功率。 分數來自 11 個特定領域、混合評分規則與多次任務嘗試。
SemiAnalysis 在 2026 年 11 月推出 GDPx,英文 benchmark 指「基準測試」,agent 指「能使用工具逐步執行任務的 AI 代理」。官方頁面列有 11 個領域、14 個專業資料合作夥伴及 206 項任務,涵蓋晶片設計、資安、生物、金融、法律、量化交易、自我改進研究、硬體設計、材料科學、AI 對齊與軟體工程。
選題刻意集中在 SemiAnalysis 認為前沿模型可能帶來高價值的領域,沒有依各職業的就業人數或經濟占比抽樣。也就是說,這份基準的廣度來自跨領域專業任務,代表性則由設計者挑選的方向決定。
這個取樣方向會影響解讀。GDPx 想追蹤高難度代理能力,不是估算全經濟的職務替代率。它和較偏向工作產物生成的 GDPval 也不同;SemiAnalysis 主張,GDPx 任務讓代理進入模擬工作環境、尋找資料並使用專業工具。
同一模型在一項任務答得好,仍不足以說明它能處理相鄰職務或不同公司流程;評測設計可以參考前述代理基準泛化檢查。
SemiAnalysis 將 GDPx 描述為衡量前沿模型一般代理能力的基準,並說明其領域選擇著重於前沿智能可能產生高回報的工作領域。此定位來自基準設計者,反映的是設計目標,不等同於第三方對任務代表性的驗證。
二、任務測多深,分數怎麼算?
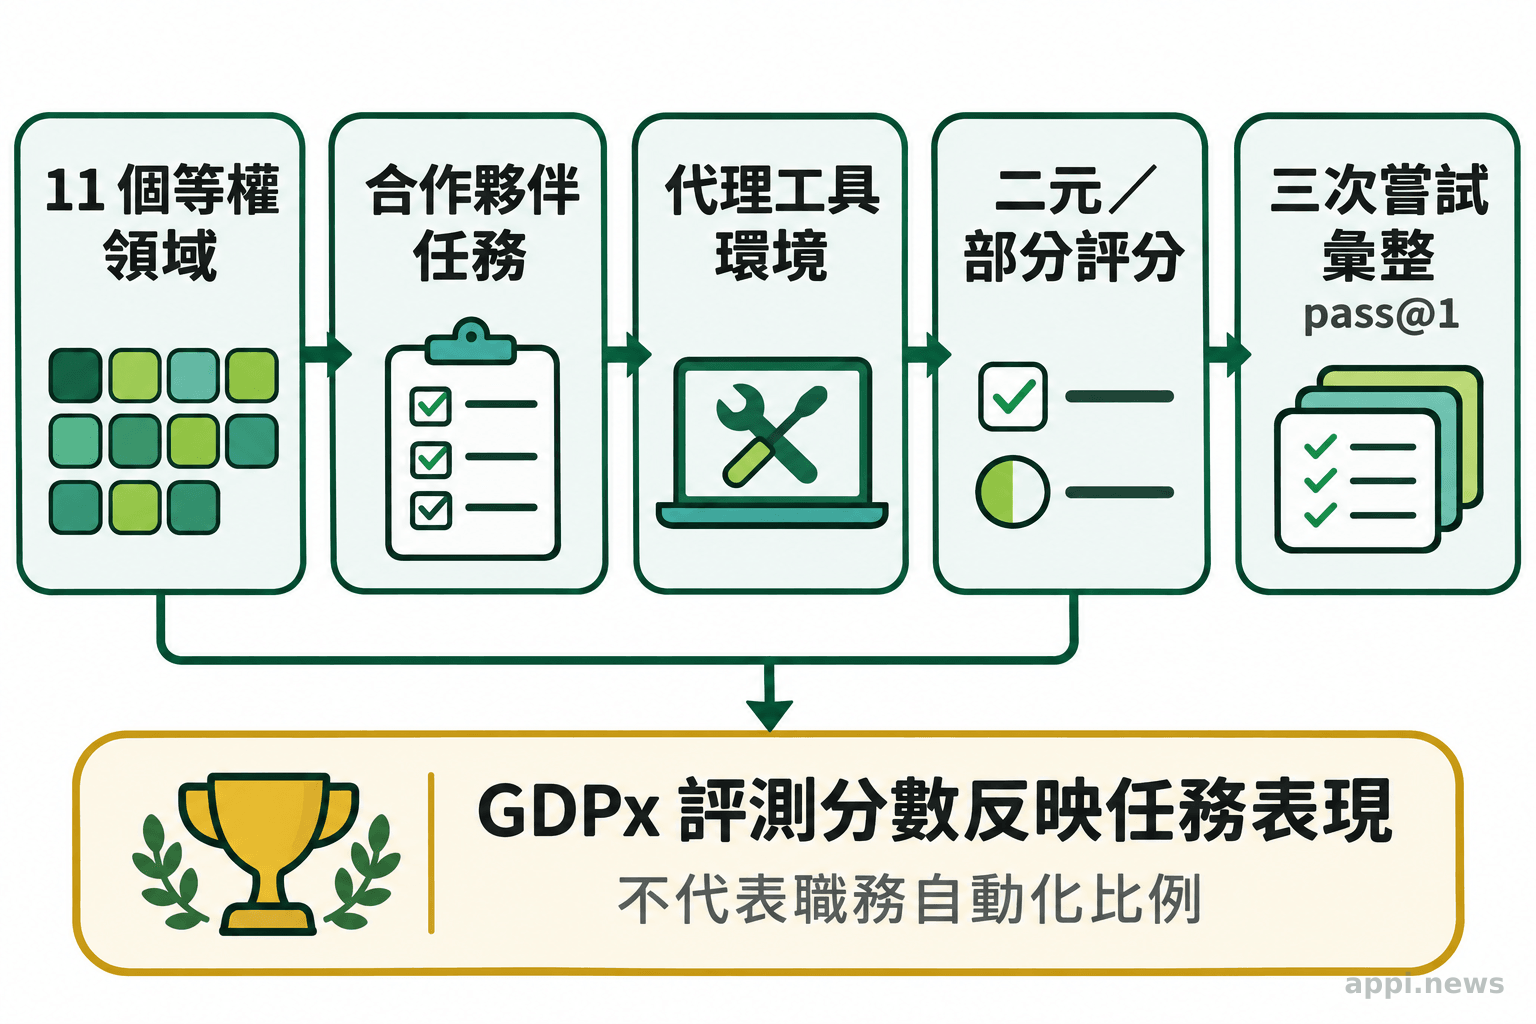
GDPx 讓代理在模擬環境中操作檔案、軟體或工具,並依領域採二元或部分給分。 總分將 11 個領域等權平均;不是把 206 題都用單一標準判對錯。
官方方法頁說明,任務預設最多可執行八小時,部分任務時間較短;模型使用原生代理工具環境,無原生環境時則採用 OpenCode。每個領域權重相同,同一領域若有多個合作夥伴,夥伴權重也相同。報告的 pass@1 意思是看單次嘗試的成功表現,官方以三次嘗試的結果計算;這和三次裡只要成功一次的 pass@3 不同。
計分方式也會改變讀數。二元評分只認定任務是否達成;部分評分則計算完成了多少要求。不同領域依任務設計採用預定方法,因此不能把總分簡化為「206 項中有幾項完全正確」。SemiAnalysis 也指出,金融與法律任務在二元評分下難度很高,故排行榜同時呈現部分分數。
公開任務能看出這些測量差異。金融領域由合作夥伴 Living Context 提供,24 項任務都放在同一筆私募基金收購零食製造商的模擬交易中:買方 Brannock Capital 以 8.8 億美元加或有付款,收購 Haverly Snack Company 約 62% 股權;賣方顧問和會計顧問則各有交易資料夾。這個交易情境共有約 4,000 個去識別化檔案,但各任務可見資料依角色與日期而異,並按時間重建,限定代理只能使用當時可取得的資訊。題目源自企業財務或會計主管實際交辦的工作,要求代理產出或修訂試算表、簡報、文件或 PDF,涵蓋收購融資、債務條款與盈餘品質。
公開的 Bellwood-QoE 任務要求代理修訂盈餘品質資料簿,並將發現連到 EBITDA 橋接表、營運資金與淨負債。25 次嘗試沒有模型通過全部檢查,最佳單次通過 11 項中的 8 項。錯誤包括把銀行成功費用列入淨負債、未排除無實際工時的家族成員薪酬,以及誤讀交易費用條款。案例顯示,文件判讀與買方實際承擔成本都會影響交付結果,僅描述這項任務。
量化交易案例由 Third Moment 提供,代理要在 IEX 的逐筆訂單簿資料上研究蘋果、AMD、Meta、Tesla 等股票,提出新策略或改進既有策略,再將策略快照放到未公開交易日測試。部分任務要求改善預測模型,另有一題要求調整被動造市策略;最高八小時的工作時間讓代理必須完成資料分析、建模與回測。SemiAnalysis 報告 111 次評分執行中有 70 次表現不如參考策略,且評分看保留日的每日損益差異,不讓單週的偶然獲利或加大風險取巧。這項結果能說明樣本外驗證的重要性,不能推論模型不能寫交易程式或量化研究在實務上必然失敗。
這項測試關注樣本外獲利表現,不是模型能否寫出程式或找到漂亮的回測數字。對企業驗收的啟示是,成果標準要落在工作真正要改善的指標,不能只看代理是否產出一份格式完整的檔案。
SemiAnalysis 說明,量化交易任務以未公開交易日的每日損益比較策略,避免只憑單次回測或中間指標判斷優劣。此方法描述的是 GDPx 這組任務的評分設計。
三、低分揭露哪些限制?
不能。 分數受任務選擇、領域權重、評分規則、代理工具和安全限制影響,只能描述 GDPx 所選任務與執行條件下的表現。
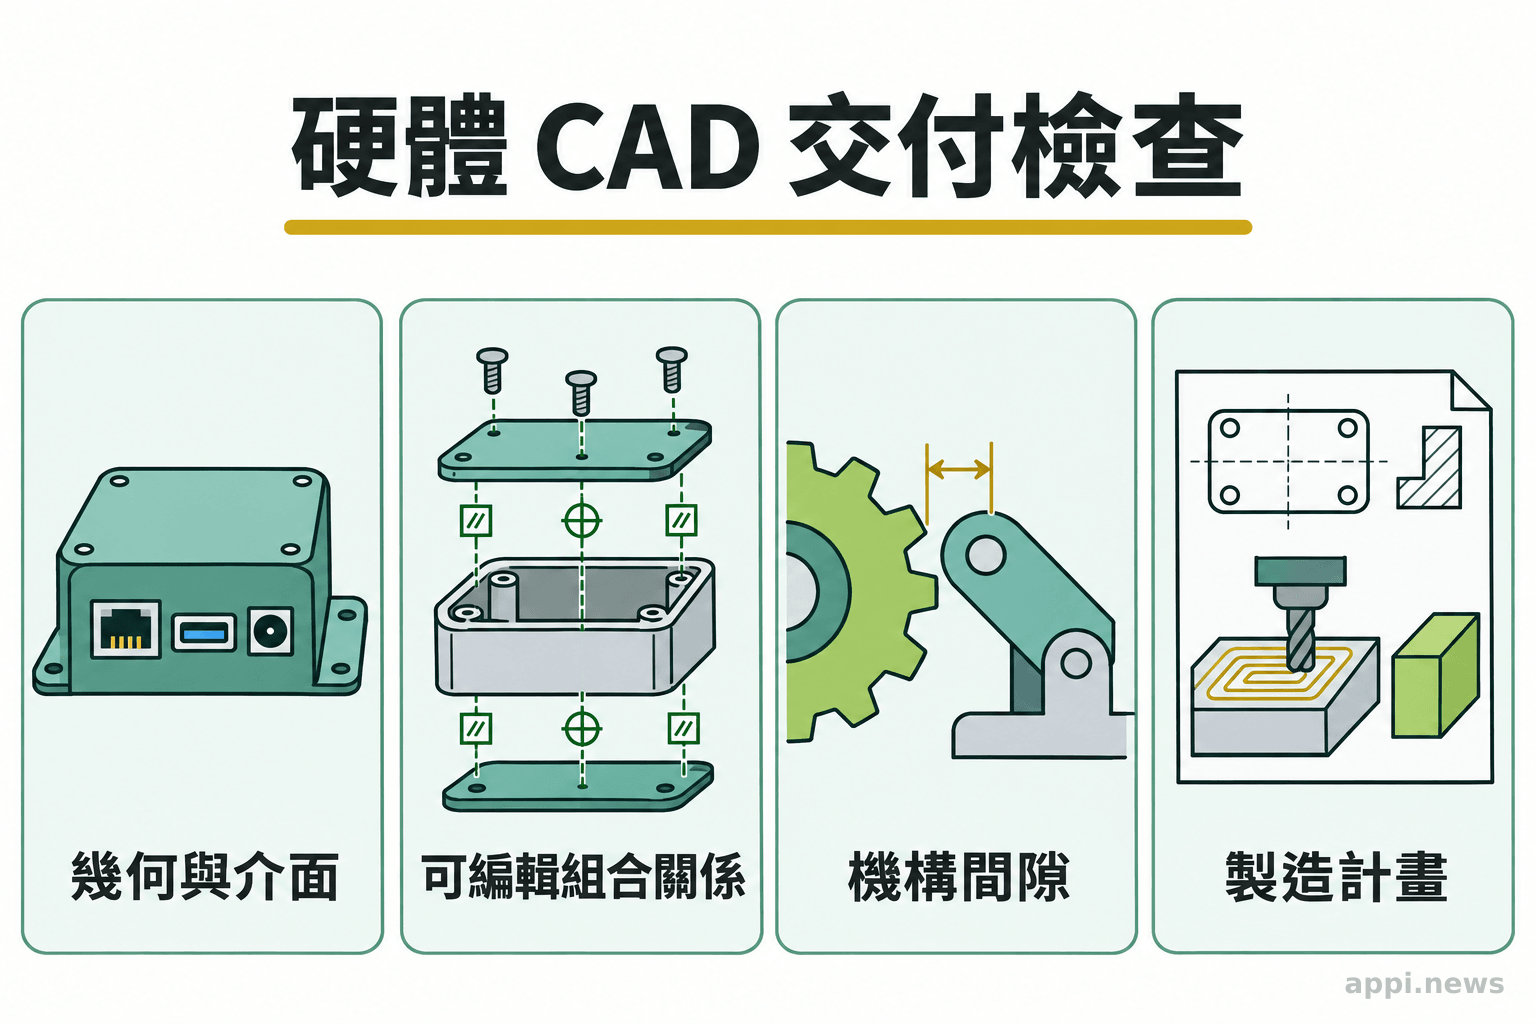
Beautiful Machines 提供的硬體設計任務,要求代理替壓縮機組件設計可射出成型的塑膠外殼,需定位內部零件、避開曲柄活動範圍、連接進氣濾網並能脫模。交付物包括可編輯的 SolidWorks 組合件、工程圖和製造計畫。
驗收會檢查組裝介面與機構間隙,修改尺寸後重建模型,並核對製造計畫。SemiAnalysis 表示,12 次執行都未完整通過;Opus 與 Astra 的部分成果可重建且通過間隙檢查,仍未符合所有製造性與設計意圖要求。這項任務呈現外型完成與可修改、可製造交付的差異。GDPx 原始任務描述列有驗收項目與模型失誤。
整體排行還混合模型能力與代理系統能力。模型使用各自原生的工具環境,工具配置、安全分類器和權限限制都可能影響任務結果。SemiAnalysis 表示,部分模型在資安、生物與對齊領域可能受安全分類器影響。
The Decoder 報導指出,GDPx 多數任務未公開,而且各家代理軟體條件不同,外界難以完整重現成績。這是媒體對可重現性的提醒,應和設計者提供的評測說明、已公開任務的具體成績分開判讀。企業若比較自選模型,最好固定代理框架和工具權限,避免把工具差距誤認成模型能力差距。
小樣本也限制領域排名的穩定度。官方總表涵蓋 206 項任務,但各領域數量不一,部分公開任務案例的執行次數也有限。
總分適合當模型比較的參考之一,不能代替對失敗原因、人工覆核需求、資料權限和錯誤代價的分析。若評估的重點是代理如何使用工具,沙盒安全評測還需檢查哪些項目也能補足另一面。
四、企業如何把基準測試轉成自己的驗收?
先把一項常見工作定義成可重複測試的任務,再以真實資料和明確的完成條件驗收。 除了完成率,也要記錄錯誤代價、人工接手時間與執行成本。
-
挑代表性任務:選常見且成果可檢查的工作,整理輸入、背景資料與例外狀況。
-
寫清完成條件:列出交付檔案、核對點與格式要求,區分致命錯誤和可修正的小錯。
-
固定測試環境:記錄模型、代理框架、工具權限、安全限制、提示與重試次數;比較時一次只改一項。
-
用多批任務重跑:保留未用於調整提示的案例,追蹤完成度、錯誤、人工修正量、時間與成本。另留一批任務檢查改善能否泛化,避免代理只迎合熟悉的測試題。
-
設定人工接手機制:定義停止條件、覆核者與回退時機;流程或模型更新後定期重測。
這份清單把外部 benchmark 轉成組織內部的驗收問題。對照AI 代理可靠度的多次測試方式,團隊可以避免用一次成功或一個總分決定是否交付權限。
若工作牽涉客戶資料、付款、法律文件或生產系統,錯誤造成的損失也應納入驗收門檻。先從低風險、可回復的步驟試行,才有空間觀察代理在真實資料和流程限制下會在哪裡失準。
驗收結果應指出代理可獨立交付的條件、必須停止的錯誤,以及人工接手所需時間。模型或流程變動後,再用保留任務確認結果。
- GDPx v1.0 是涵蓋 11 個選定領域的代理基準,不代表全體職務自動化率。
- 12.0% 是特定版本與評測設定下的總分,受任務、評分、工具環境和安全限制影響。
- 導入前應以組織自己的代表性任務驗收,並一併衡量錯誤、人工修正、時間與成本。
常見問題
Q1:GDPx 的最高分 12% 是 206 題只答對 12% 嗎?
不是題數正確率。GDPx 按領域採二元或部分評分,再將 11 個領域等權平均。
Q2:GDPx 的 pass@1 是什麼意思?
它表示單次嘗試的成功表現。GDPx 以三次執行的結果計算 pass@1;若是 pass@3,則會看三次中是否至少成功一次,兩者不能混為一談。
Q3:企業可以依 GDPx 排名直接選模型嗎?
可把排名當作外部參考,但仍應在自有任務、工具權限、資料和錯誤標準下測試。模型分數不能替代實際流程驗收。
Q4:比較模型時應記錄哪些條件?
至少記錄基準版本、模型、代理框架、工具環境、評分方式、安全限制、重試次數與成本,並使用相同的任務資料和完成標準。
參考來源
- Max Kan, Andrew Megalaa, Dylan Patel. (2026). GDPx: Measuring Frontier Model Capabilities Across the Most Valuable Domains. *SemiAnalysis
- SemiAnalysis. (2026). GDPx v1.0 Benchmark Leaderboard
- SemiAnalysis. (2026). Domains | GDPx
- Manuel Uth. (2026). No AI agent scores above 12 percent on SemiAnalysis' new real-world work benchmark. *The Decoder


