
搬家後要替孩子挑幼兒園,OpenAI 展示的 LifeVal 任務要求 AI 比較住家附近的園所、整理候選名單與入學資訊,頁面列出的分數是 93.1%。這個例子不只要模型回答「怎麼選」,還要它整理資料、形成可供家長檢視的結果。可是,93.1%究竟如何計算?它能不能告訴使用者哪一款 AI 最適合自己的工作?
LifeVal 是 OpenAI 用來追蹤 AI 在日常任務表現的評測。官方案例能讓讀者看見任務型 AI 評測的方向,卻還不足以單獨作為產品排名或採購依據。要讀懂分數,得先看任務從哪裡來、分數描述什麼,以及哪些測試條件尚未公開。
幼兒園篩選 93.1%,這個分數回答了什麼?
它是 OpenAI 列出的幼兒園篩選任務評測結果,顯示模型在該任務設定下的表現;官方頁面沒有交代足以重算分數的細節,因此不宜解讀成完成率或所有家庭都能得到的成功機率。
任務要求搬家後比較附近幼兒園、挑出較合適的選項,並整理入學資訊。展示結果提到已縮小到三所園所,還有兩項偏好需要使用者決定。這項評測呈現了從條件整理到提出候選方案的過程,超出單句問答的範圍。家長仍需確認資料是否正確,也要自行判斷哪些偏好最重要。
OpenAI 將 LifeVal 描述為追蹤日常任務進展的評測。頁面以「幫助人們處理實際生活挑戰」為方向,但沒有在這些案例旁列出評分規準、錯誤扣分方式、任務重複次數或人工介入條件。分數可以說明官方展示了什麼,不能補足未公開的方法細節。
LifeVal 怎麼把日常需求變成評測任務?
OpenAI 表示,LifeVal 的任務參考美國與跨國時間使用資料,再以 3,995 人的代表性調查了解哪些日常工作最希望由 AI 協助。
官方列出的資料來源包括美國勞工統計局的 American Time Use Survey,以及跨國時間使用研究 Multinational Time Use Study。前者記錄人們在工作、照顧兒童、志願服務等活動上投入的時間;後者整合多國時間日記資料。OpenAI 再以 3,995 人調查詢問受訪者希望個人助理協助哪些任務,據此挑選評測範圍。
LifeVal 涵蓋照護、健康、教育、家庭行政、個人財務、購物與政府服務等領域。這種設計的價值在於把評測問題拉近一般人每天處理的事,而不是只測模型能否答對一道知識題。不過,時間使用資料和意願調查回答的是「人們做什麼、想得到什麼協助」,不等於任務已代表台灣家庭的需求,也不會自動證明模型在真實環境裡完成得好。
讀者若想進一步判斷評測結果能否延伸到新情境,可參考檢查 AI 代理評測泛化能力的步驟,把任務代表性和測試條件也列入檢視。
「我們針對每項任務提出問題,找出一般人最希望個人助理協助的領域。」這是 OpenAI 對 LifeVal 任務來源的說明,指出評測從使用需求出發;它本身並非獨立驗證結果。
洪災志工與找房案例,分數能跨任務比較嗎?
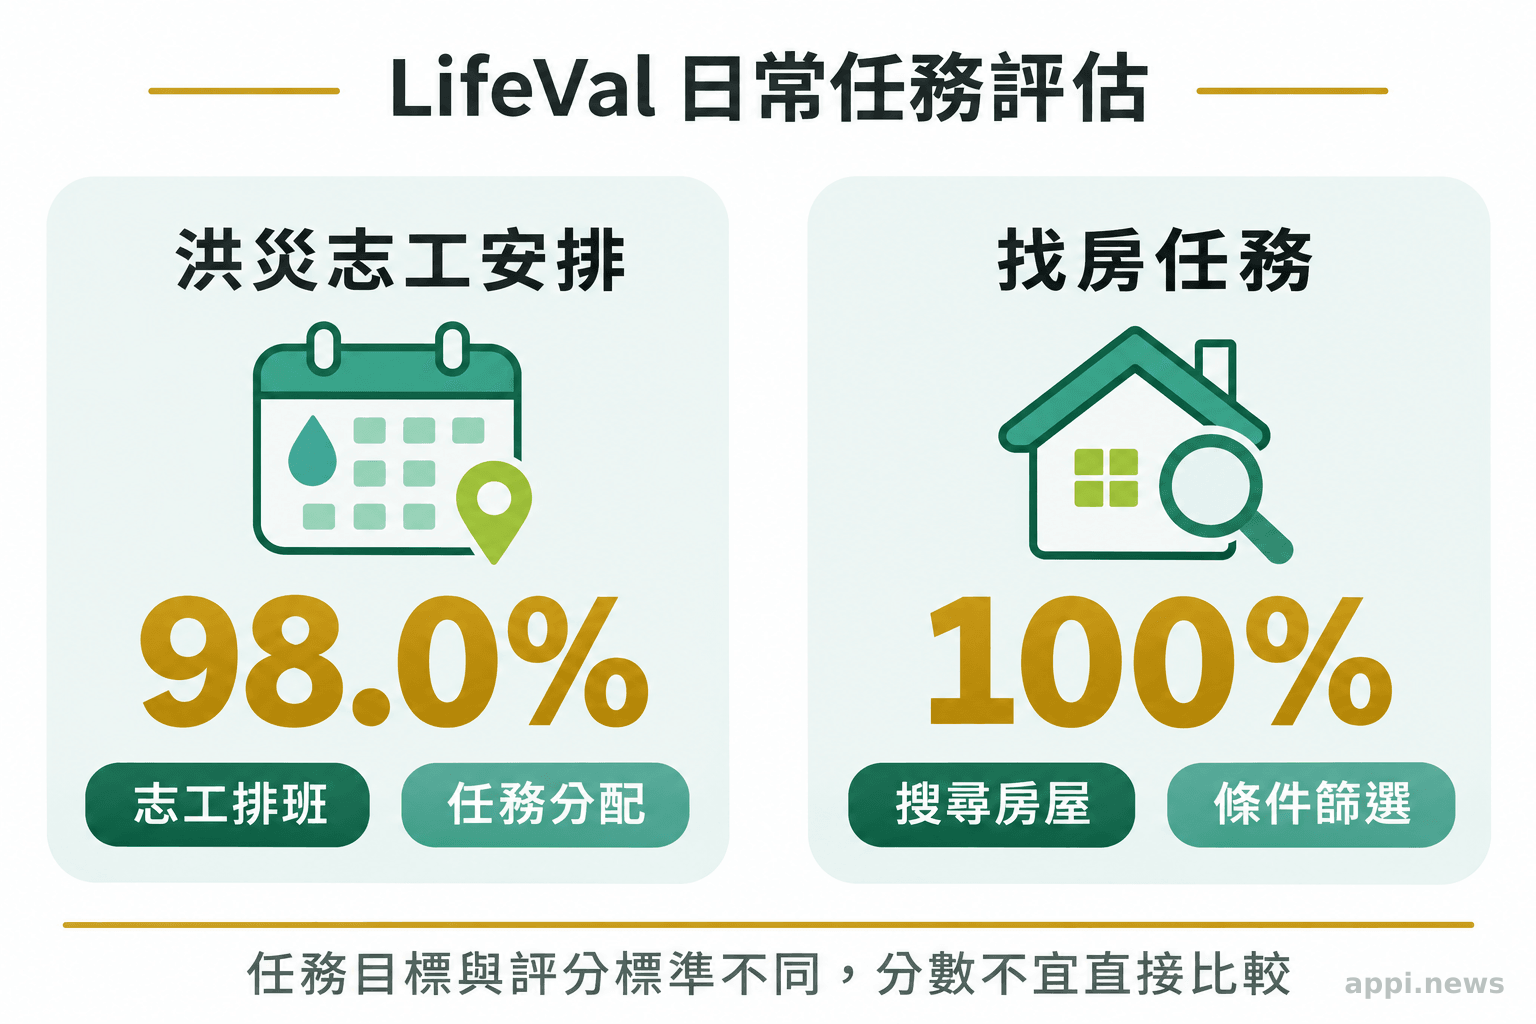
不宜直接比較。98.0%的洪災志工安排、100%的找房任務各有不同要求,官方頁面未提供共同尺度與任務難度校正方法。
洪災案例要求替四位需要防洪協助的鄰居安排社區志工,頁面列出 98.0%;找房案例則要求在賓州盧澤恩郡依預算、獨立居住空間與接送後通勤時間尋屋,並把契據放進政府紀錄購物車供使用者檢視,頁面列出 100%。兩者都包含多個條件與後續動作,但任務目標、可用資訊和完成判準並不相同。
因此,三個案例適合用來理解 LifeVal 涵蓋了哪些工作型態,不能據此認定找房能力勝過幼兒園篩選,也不能把百分比當成所有任務共用的排行榜。頁面展示數字時沒有同時說明樣本數、信賴區間或不同任務的難度差異;這些資訊未出現在頁面上,不代表測試一定沒有做,而是讀者無法只憑公開內容判斷。
這裡常常會把問題、原因和方法混在一起談。看見高分時,先追問任務怎麼設計、使用了哪些工具、哪些步驟由人確認,才知道分數究竟反映模型能力、工具與資料條件,還是任務本身較容易完成。
日常任務評測比問答分數多測了哪些能力?
任務型評測把規劃、整理資訊、使用工具及提交可檢視結果納入情境;問答分數通常聚焦於特定題目的回答,兩者衡量面向不同。
代理式 AI(能使用瀏覽器、電腦操作或連接器逐步處理工作的 AI)可能需要先理解限制,再搜尋資料、比較選項、整理產出,最後把需要人決定的地方交回使用者。幼兒園案例中尚有兩項偏好待家長確認,正好顯示任務可包含「完成可自動處理部分」與「保留人類決策」兩種步驟。
OpenAI 說明,過去一年訓練工作涵蓋瀏覽器使用、電腦操作與連接器任務,LifeVal 用來追蹤模型在日常工作上的進展。這些能力比單輪回答更接近實際流程,但也讓結果更依賴環境:登入權限、資料新舊、介面變動、連接器可用性和使用者給的指令,都可能改變任務表現。測試一項能力時,最好把模型、工具和流程條件一起記錄。
OpenAI 表示,真正有幫助的個人助理應能「採取實際行動,完成真正能辦成的事情」,這說明 LifeVal 為何關注任務流程;這是開發者提出的評測目標,不等同於外部機構確認其效果。
LifeVal 能支持哪些 AI 產品選型判斷?
LifeVal 可作為了解日常任務型評測的一項參考,但目前公開頁面的分數與方法資訊不足以單獨決定個人或企業的產品選型。
評估一項基準測試,讀者至少需要知道任務如何抽樣、成功條件如何判定、模型和工具版本為何、是否允許人工介入,以及結果能否由外部團隊重現。LifeVal 公開頁列出任務例子、部分分數、任務資料來源與調查樣本數;但沒有逐項提供評分細則、模型版本與工具設定,也沒有在頁面中呈現獨立重現結果。因此,這些分數的解讀應明確歸屬 OpenAI。
這些問題也適用於其他 AI 基準測試。讀者可搭配AI 評測與採購的檢查方向整理評估條件,再把需求轉成自家可重複執行的任務。
台灣的工作環境還有在地落差。找幼兒園涉及的制度、政府服務介面、資料語言與可用連接器都可能不同;慢性病患者看到官方例子中的糖尿病餐食規劃,也只能知道這是評測展示的一項任務,不能據此把 AI 當成個人化醫療或飲食建議。涉及健康決策時,應由合格醫療人員評估個人狀況。
採購或導入討論可把 LifeVal 當成「值得測哪些事情」的提示,再用自家流程確認品質、權限與錯誤成本。若評測頁後續補充方法、版本及外部驗證,應重新檢查證據是否足以支持更具體的比較。
試用 AI 前,如何用自己的任務做比較?
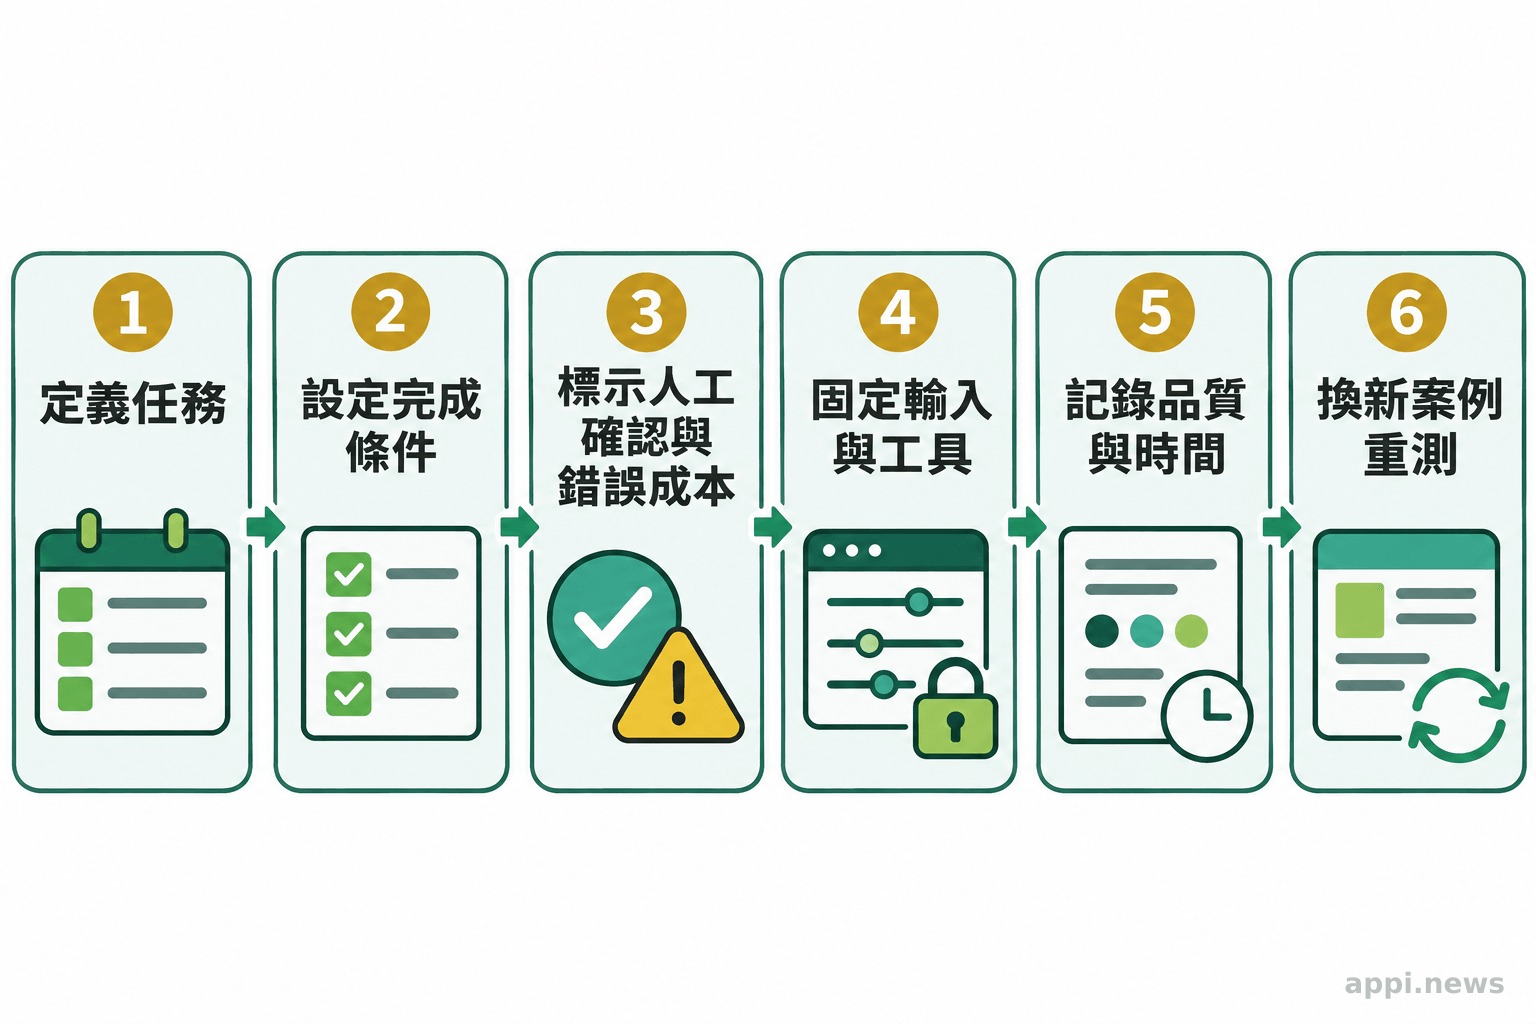
先把工作拆成可觀察的任務和完成條件,再讓候選工具在相同資料與權限下處理,逐項記錄品質、錯誤和人工修正量。
- 挑三項常做的工作:例如彙整會議資料、比較服務方案、整理申請文件。避免只挑最適合某一產品展示的任務。
- 寫下完成條件:列出必須包含的資訊、格式與截止時間,並說明哪些內容需要附來源。
- 標出錯誤成本和人工關卡:資料錯誤會帶來什麼後果?哪些步驟必須由人確認、簽核或對外送出?
- 固定測試條件:讓候選產品使用相同輸入、資料範圍、工具權限和提示,保存模型或產品版本及測試日期。
- 記錄可比較的結果:檢查正確性、遺漏、錯誤類型、人工修改時間、完成時間與總成本;高風險任務另記錄是否越權或捏造資料。
- 用新案例重測:不要只重跑同一份題目。換一組資料與例外情況,觀察表現是否維持,並確認流程或模型更新後是否需要再驗收。
完成這輪測試後,分數才會連到組織真正關心的結果。LifeVal 可協助理解業界正嘗試評估哪些日常工作;要決定產品是否適用,還是得回到同一組任務、同一套判準和可追溯的測試紀錄。
- LifeVal 以日常任務評估 AI,OpenAI 公布的 93.1%、98.0%與 100%是特定案例分數。
- 公開頁面的任務與方法資訊不足以支持跨任務排名、跨產品比較或台灣流程成效推論。
- 選型前用自家工作流程實測,固定資料與工具條件,記錄品質、人工修正、時間、成本與風險。
常見問題
LifeVal 分數適合用來認識 OpenAI 公布的特定任務結果,產品是否適用仍需以自家流程測試。
Q1:LifeVal 是什麼?
LifeVal 是 OpenAI 用來追蹤 AI 在日常任務表現的評測,任務範圍包括照護、健康、教育、家庭行政、個人財務、購物及政府服務等。
Q2:LifeVal 的分數代表 AI 完成任務的機率嗎?
官方頁面沒有提供足以判斷分數定義與計算方式的細節,因此不應直接稱為成功機率或完成率。可確認的是,該頁把分數列為特定任務的評測結果。
Q3:可以只看 LifeVal 分數選 AI 產品嗎?
不建議。任務、版本、工具、資料、人工介入與評分方法都會影響結果;應以自己的流程和相同條件試用比較。
Q4:LifeVal 的糖尿病餐食規劃案例能提供健康建議嗎?
那是 OpenAI 列出的評測任務例子,不是針對個人的醫療評估。慢性病患者的飲食或治療決定應與醫療團隊討論。


