
METR 在 2026 年 11 月公布對 Anthropic 的評估,研究者估計其模型在明確可量測任務上的進展速度,相較 2024 年 3 月至 2025 年 10 月約快兩倍,但可能接近 1.3 倍或 3 倍,部分證據遭遮蔽。評估報告留下更前面的問題:證據支持到哪一種自動化程度?
開發團隊應確認代理權限、紀錄和人工覆核是否形成責任鏈;AI 代理安全工程也談到這類治理。
METR 為什麼估計 Anthropic 的 AI 研發進度變快?
METR 估計特定模型能力任務的進展速度約為歷史兩倍,但不確定性高。這不代表所有研發工作都加速兩倍。
評估使用 Anthropic 版本的 Epoch Capabilities Index(能力指標,AECI)追蹤基準任務。METR 估計 2025 年 10 月後指標成長約為此前的 1.9 倍(95% 信賴區間 1.5 至 2.8 倍),約相當於一年取得過去兩年的基準進展。
AECI 側重可明確定義、驗證的任務,不代表複雜研究也同步加速。METR 指出資料稀疏且有時間落差,調整基準後估計範圍為 1.1 至 2.9 倍。
第二個案例是 METR 的評估流程:研究者取得 Anthropic 內部指標、問卷及訪談。METR 認為訓練計算資源成長不足以解釋加速,但招聘、資料和演算法等因素仍可能參與;AI 貢獻比例是主觀歸因。
研究者訪談與員工自我回報都支持 AI 正提高部分工作的產出速度,但這些資料不能直接換算成整個組織的研發加速率。個人覺得某項工作快了幾倍,和公司模型能力每年提升幾倍,中間還隔著任務難度、研究人力、實驗排程與成果整合。METR 也提醒,個別工作速度的自評數字,不等同整體進展速度。
「我們不會意外地發現,真實加速幅度更接近 1.3 倍或 3 倍。」(METR,Anthropic AI 研發加速評估(2026)) METR 表示 Anthropic 遮蔽了多項關鍵佐證,外界無法自行判讀。因此應寫「研究者估計約兩倍」,不能寫成「已證實 AI 讓研發翻倍」。
AI 參與研發,不等於 AI 已能自主開發 AI
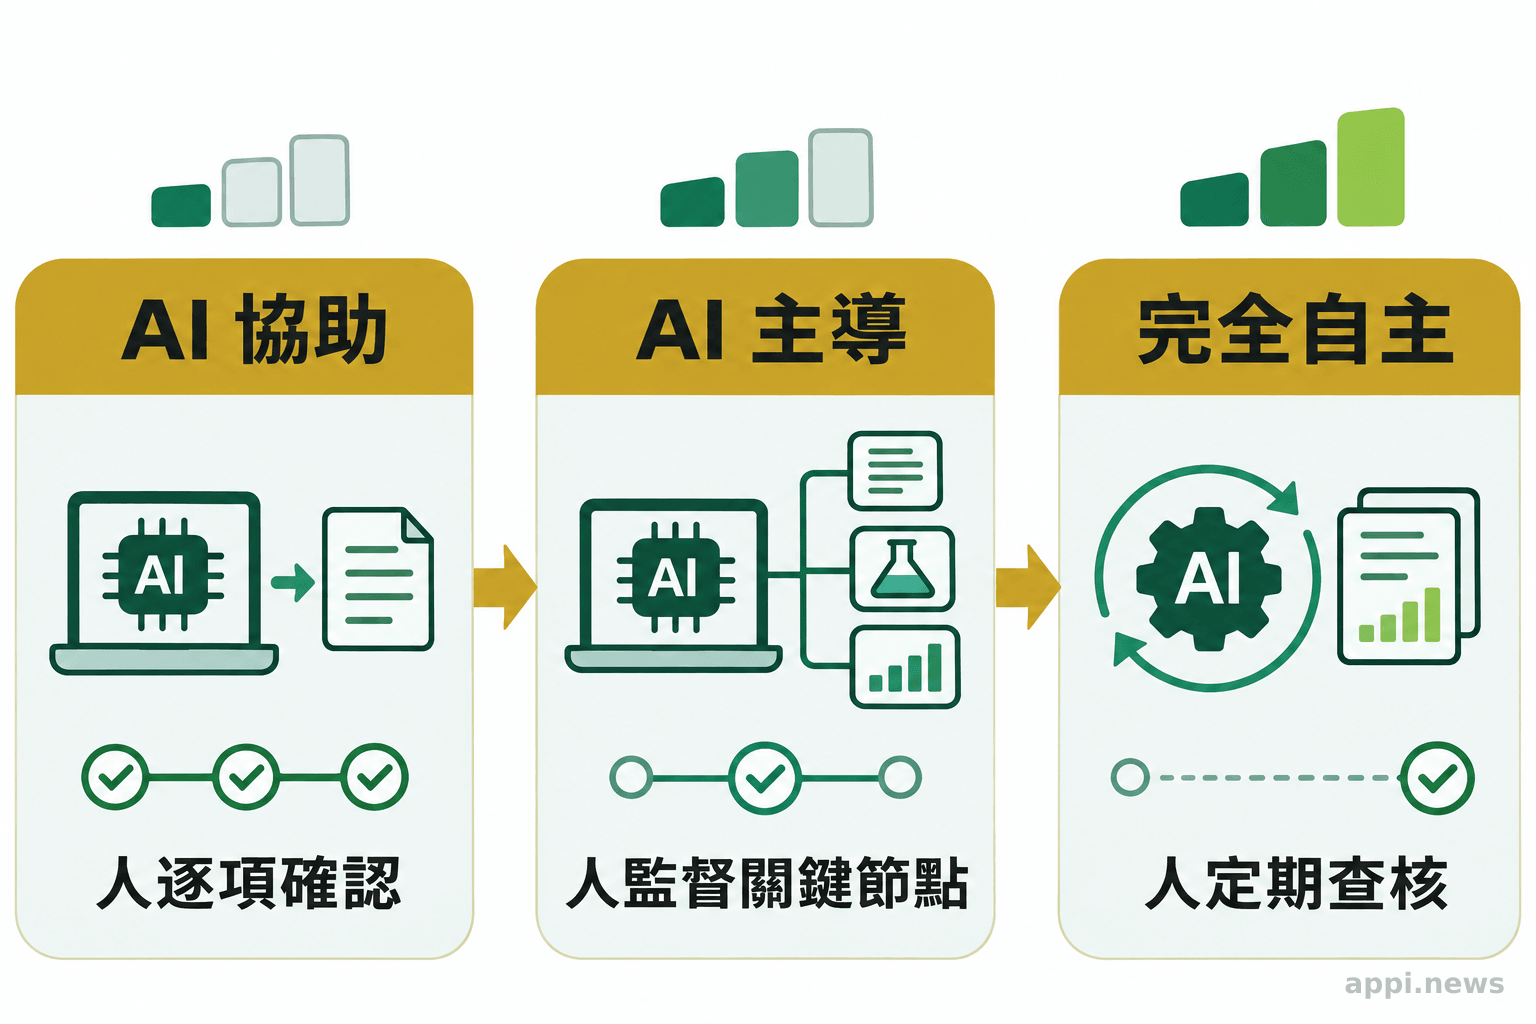
目前公開資料顯示 AI 已參與並能主導部分研發任務,但 Anthropic 表示其模型尚未在受測研發工作中完全自主運作。協助、主導與完全自主是不同層級,不能用同一個「AI 自己造 AI」概括。
Anthropic 在 2026 年 8 月公布原型指標,按工作類型評估 Claude 自動化程度:AL3 是密切指引下協作,AL4 是 AI 主導大部分工作、由人監督,AL5 才是完全自主。公司稱 Claude 當月主導 26% 的 AI 研發工作,超過 90% 至少達協作層級,受測工作沒有完全自主項目。這套自建指標仍待外部驗證,跨公司也沒有共同比較標準。
| 自動化層級 | 人與 AI 的分工 | 治理上要問什麼 |
|---|---|---|
| 協助 | AI 提供局部輸出,人設定步驟並檢查 | 輸出如何驗證,錯誤由誰修正? |
| 主導 | AI 可完成大部分任務,人設定方向並監督 | 人何時介入,能否中止或回復? |
| 完全自主 | AI 在任務範圍內自行執行,沒有人工介入 | 權限邊界、即時監控與事後稽核如何設計? |
另一個案例是 Anthropic 的代理監督數據。公司稱,2026 年 8 月常用平台約有 3 萬個代理處理研究與工程工作;監控器分析超過十億次決策,約 0.002% 遭線上阻擋。數字只涵蓋該平台且來自公司自述,不能單憑阻擋率證明所有風險都被發現。
監控設計還分為行動前的線上檢查,以及事後讀取代理活動的離線檢查。Anthropic 表示,線上監控器通常在數秒內檢查操作;離線系統每週標記約十萬份紀錄,再由分類器篩查,約五十件最高優先級個案升級給人員。遭線上阻擋的操作,人工檢視時間可達一週。這些數字讓讀者看見覆蓋、延遲和升級率是不同量尺,也指出高風險行動若等到事後才由人查看,可能來不及阻止不可逆後果。
「Claude 並未在任何受測的 AI 研發工作中完全自主運作。」(Anthropic,前沿實驗室 AI 開發進度衡量(2026)) 自動化比率和能力分數回答不同問題,分類與評分也由 Anthropic 設計,跨公司比較仍需共同方法及獨立查核。模型研發中代理提案與人類決策的分工可作延伸參考。
「遞迴自我改進」通常指系統能自主推進建造後繼模型的循環,不能只看 AI 寫了多少程式或主導多少任務。還要確認它是否能設定研發目標、完成訓練與評估,再依結果推進下一輪,而且整個循環不依賴人類關鍵決策。METR 的報告沒有證明這種閉環已形成。
研發加速後,哪些監督環節容易成為治理缺口?
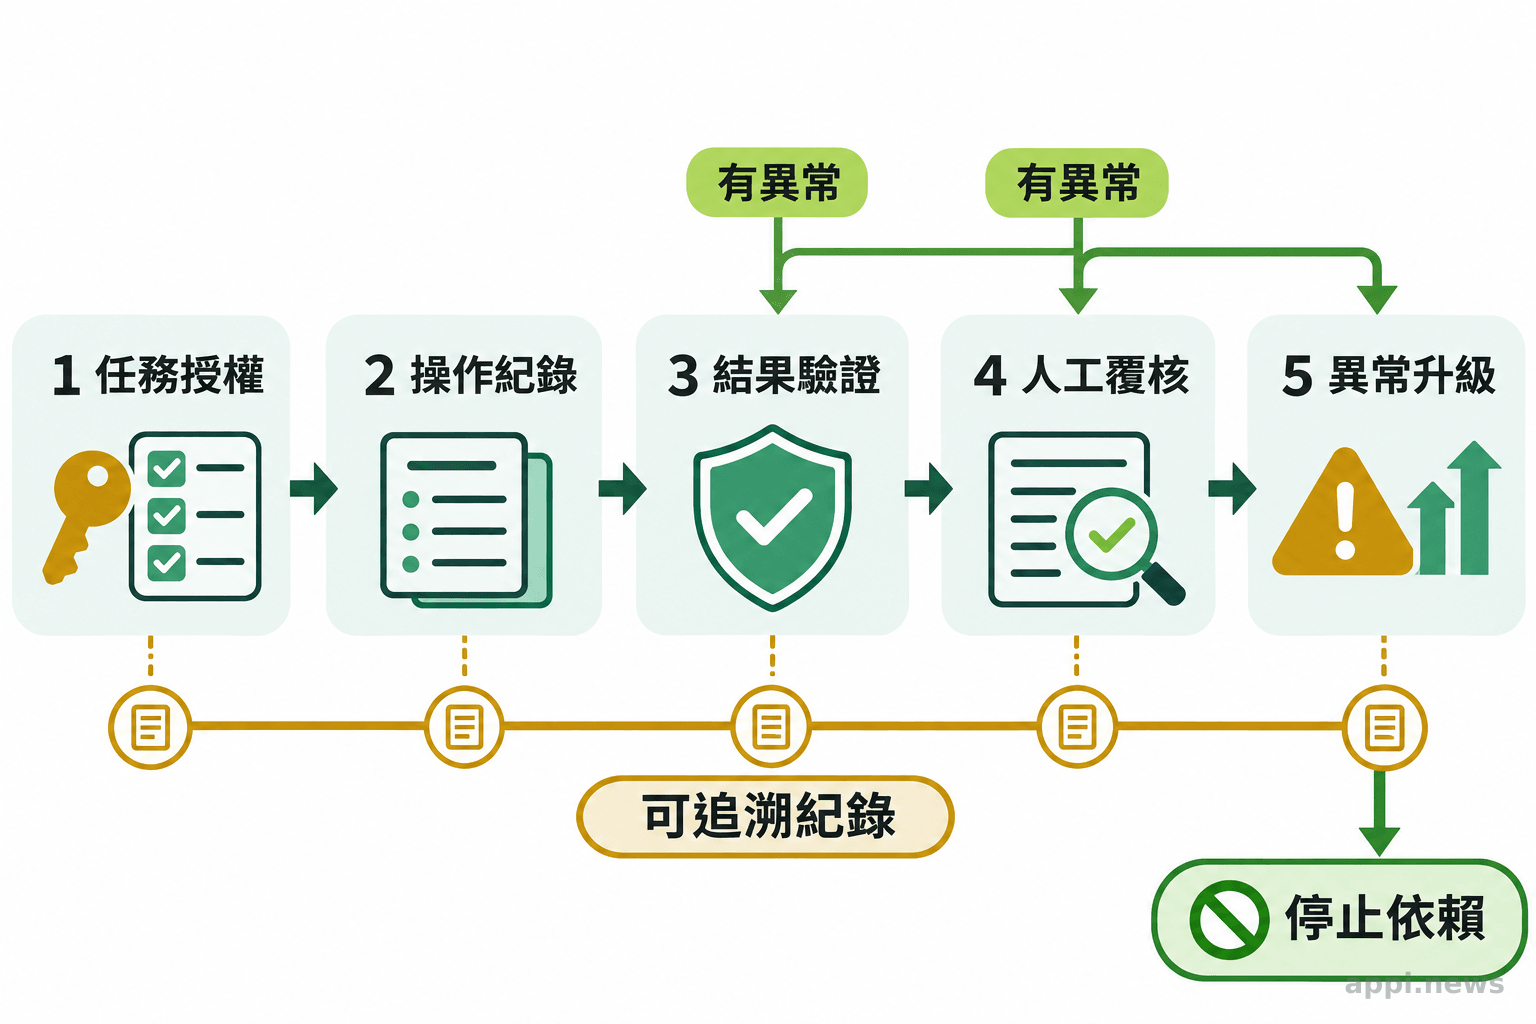
要追蹤的不只是模型做了多少工作,還包括它能動用什麼權限、每次操作如何留下紀錄,以及結果由誰驗證。如果這些控制點沒有隨自動化提高,團隊可能只知道效率變快,卻無法重建決策過程。
先看任務權限。代理可讀取、執行或修改哪些資源,應依風險分級。影響訓練資料、模型權重或正式環境的操作,需有明確授權、可撤銷界線和責任人。
再看紀錄與驗證。日誌應連起任務、工具、資料版本、結果和覆核者,才能在出錯時重建原因。程式變更可用測試和程式碼審查,重大研究決策則記下依據與批准者。AI 程式驗證責任鏈提供軟體流程的對照做法。
根因通常出在流程交界,而非單一模型分數:模型提出實驗後,誰確認假設;代理呼叫工具後,誰核對執行結果;測試通過後,誰批准把結果接進下一輪訓練。這些交接若沒有記錄,錯誤可能一路被當成已確認的前提。對讀者而言,審計軌跡的價值是讓團隊知道哪個環節出了偏差,並能停止後續依賴,而不只是事後追究操作人。
第三個案例是 METR 對 Anthropic 2026 年 8 月風險報告的檢視。METR 認為當時直接自動化關鍵研發的風險仍低,但「兩倍加速」警示門檻是否觸發,取決於公開報告未充分說明的判斷。這提醒監督也包括讓外界查核指標和決策理由。METR 的檢視指出,低風險評級與警示門檻是不同問題。
團隊可以用哪些檢查點判斷監督是否跟上?
逐項盤點任務權限、監控覆蓋、覆核延遲、驗證責任與異常升級,並確認每項都有可追溯紀錄。這些檢查點比單看「AI 做了幾成」更能指出流程缺口。
先盤點五項:
- 任務分級:列出代理可讀取、修改、執行或部署的權限;高影響操作另設授權。
- 監控覆蓋:記錄事前阻擋、事後抽查和未監控範圍,並說明覆蓋率的分母。
- 覆核延遲:記錄自動與人工檢查時間,定義哪些操作須先取得批准。
- 驗證與回溯:按程式、資料分析和研究決策設定標準,保存輸入、版本、結果與負責人。
- 異常升級:寫明警示由誰處理、何時停用代理或回復變更,並演練監控失效時的替代流程。
沒有通用的安全自動化比例。要看任務影響、錯誤可逆性和偵測速度;高影響操作應加強事前驗證。代理評測泛化檢查可供參考。
盤點時也可把每項任務分成低、中、高風險,並為每級指定最低控制。例如低風險的摘要整理,可抽樣檢查;修改程式或實驗設定,需保存版本並跑可重現測試;接觸模型權重、敏感資料或部署設定,就要採取最小權限、事前批准和即時中止機制。分級本身不是一次訂好就不變,模型能力、工具權限或工作流程更新後,都應重新確認原本的監督是否仍有效。
常見問題:AI 自動化研發是否已等於遞迴自我改進?
目前不能畫上等號。AI 已參與並主導部分研發工作,但公開評估尚未顯示模型能完全自主建造下一代模型。
常見問題
Q1:METR 說 Anthropic 研發速度翻倍,這是已證實的因果關係嗎?
不是。METR 綜合基準、訪談與內部資料,認為 AI 很可能是重要因素,但因果歸因仍不確定。
Q2:Claude 已經能完全自主研發下一代模型了嗎?
依 Anthropic 2026 年 8 月指標,受測工作沒有完全自主項目;部分工作由 AI 主導並由人監督。這是公司原型指標,不代表所有研發工作。
Q3:公司導入 AI 代理,先看哪一個治理指標?
先確認權限和紀錄,再看監控覆蓋、覆核延遲、驗證責任及異常升級。單報自動化或攔截比例無法說明監督是否有效。
- METR 的「約兩倍」是特定能力任務的估計,不代表所有 AI 研發都翻倍。
- Anthropic 公布的自動化指標區分協作、主導與完全自主;截至其報告所述時間,受測工作尚未完全自主。
- 團隊應把權限、紀錄、驗證、人工覆核和異常升級寫入流程,定期確認監控可供獨立查核。


