很多人第一個會先想到,代理執行步驟變多,就代表它更自主。但評估 AI 代理參與模型研發,還要分清楚工作量、提案權與最後選擇權:誰提出方法、誰設定研究目標、誰判斷結果足以採納,答案可能各不相同。Atria 團隊分析 Atria Dawn 模型開發中的 769 筆任務紀錄及代理日誌(代理操作留下的紀錄),發現代理承擔不少執行與修訂工作,人類仍多數選定方法、目標與驗收標準。
這是一個團隊的實際個案,能提供分工觀察,不能直接代表所有研發組織。
AI代理做得更多,是否代表它取得更多決策權?
不代表。代理執行量增加,和代理決定研究方向是兩件事;Atria Dawn個案中,AI常提出方法並處理修訂,人類則多數保留最後選擇權。
研發工作可拆成數個不同環節:設定要解決的問題、決定目標與範圍、提出候選方法、執行實驗、檢視證據、判定是否接受結果。若把這些合併成「AI做了多少」,就看不出代理是在依指令跑流程,還是已能自行決定接下來值得研究什麼。
論文也記錄了代理動作相對於人類提示的變化。在一組22位參與者的追蹤資料中,研究團隊觀察到每日代理動作數相對於人類提示的中位數上升;作者同時指出參與者間差異擴大。這個比值描述互動量,不等同於決策自主性、研究品質或效率提升。判斷自主程度,還要追問人類設定了哪些目標、代理能動用哪些資源,以及結果由誰核准。
769筆任務紀錄如何呈現模型研發中的人機分工?
代理較常提出方法與執行修訂,人類較常選擇方法、決定目標範圍及驗收標準。各項結果使用不同任務子樣本,必須連同分母一起讀。
研究團隊分析自家模型 Atria Dawn 的開發流程,將56位參與者的769筆任務紀錄與代理日誌合併觀察。769是整體任務紀錄數,並非每一項比例的共同分母。關於 AI 是否參與,論文表示739筆有明確回答的任務中,713筆使用 AI,約96.5%。這描述的是 AI 參與頻率,不能解讀為 AI 獨立完成了相同比例的研發工作。
方法與參數的提案、選擇分析,觀察的是擔任執行角色的參與者所回報的決策紀錄。這裡的統計單位是決策項,不是任務。
論文指出,在方法或參數決策中,「AI提出、人類選擇」是最常見的搭配,占55.4%。論文沒有列出這個子組的決策項總數,因此不能把769筆任務紀錄當作分母。
在目標或範圍決策中,人類最後選擇比例為93.4%;在驗收標準上則為81.9%。這些比例同樣來自執行角色參與者回報的決策項,論文沒有列出各類決策筆數。提案者與最後選擇者分別回答「誰提出選項」和「誰選定方案」,不能合成代理自主性的單一指標。
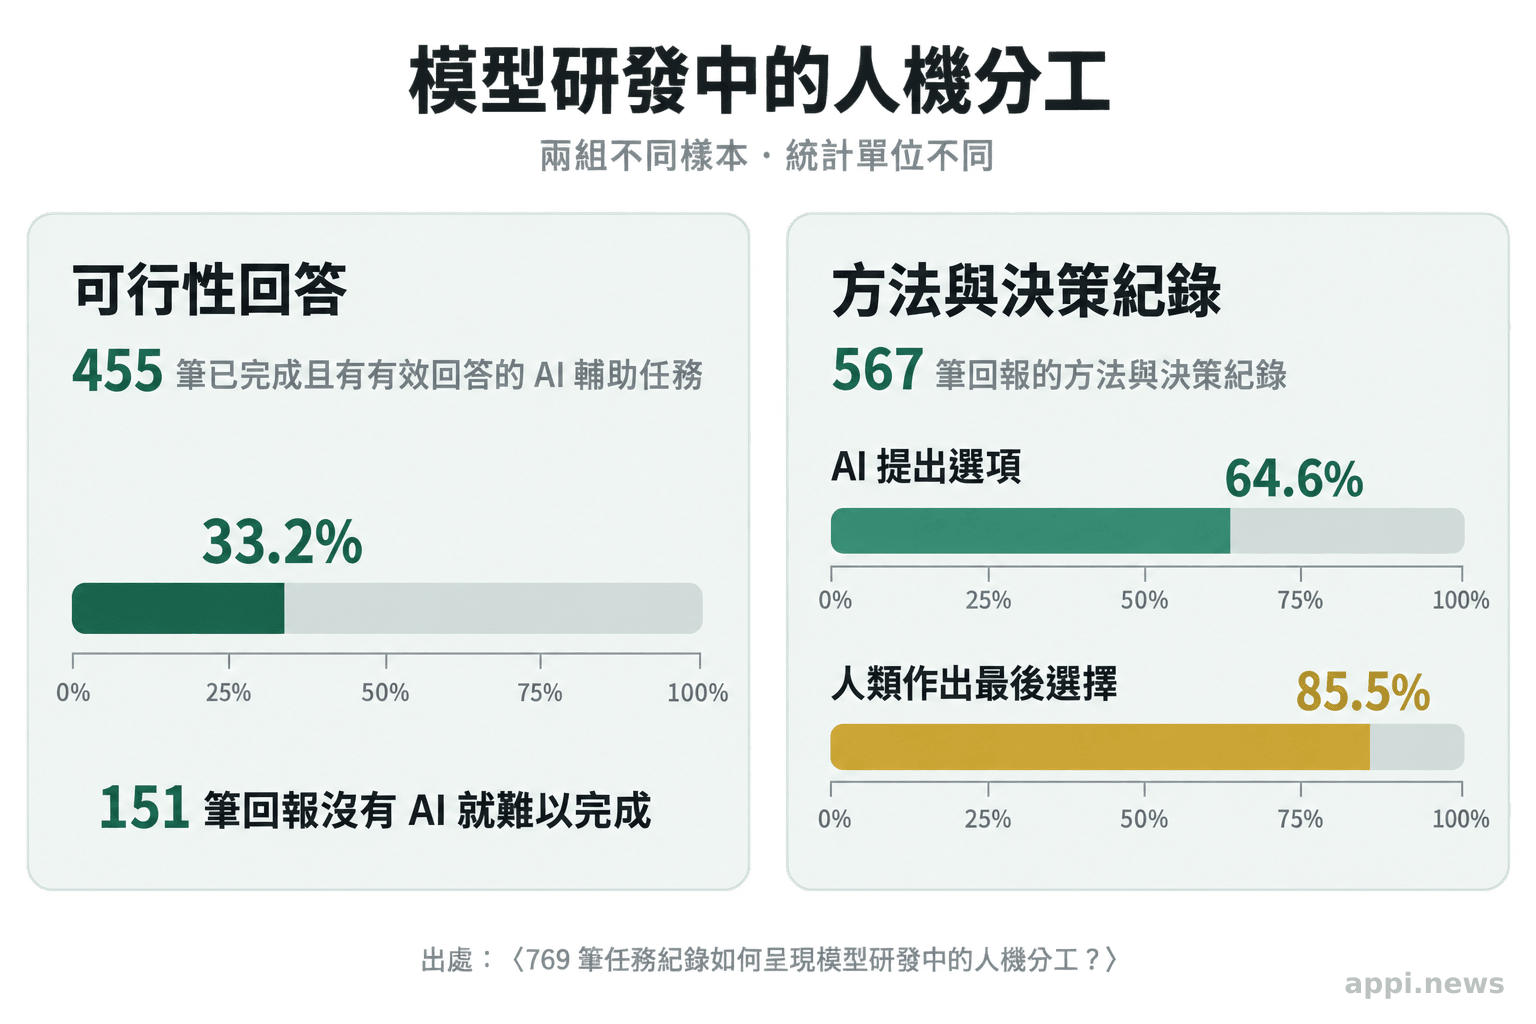
論文結論另彙整567筆回報的方法與決策。這組資料中,AI提出選項占64.6%,人類作出最後選擇占85.5%。
這兩個比例以回報的決策項為觀察單位,不是769筆任務的比例;同一項決策可由AI提出,再由人類選定。55.4%則是前述方法與參數決策中「AI提出、人類選擇」這種角色組合的比例。論文沒有提供該子組筆數,因此不能把55.4%與彙總樣本的85.5%當作同一分析的兩個比例,也不該說AI做了64.6%的決策。
讀數字時要先辨認統計對象是任務還是決策項,再看比例描述的是提案者、最後選擇者,或兩者的組合。同一任務可能有多項決定,分析單位也不等同參與者人數。
「人類選擇目標、補上代理缺少的脈絡,代理則提出多數選項並執行工作。」— Atria Team,研究結論意譯
這種分工也出現在「沒有 AI 能否完成」的回報中。研究者詢問任務範圍、品質要求及其他資源維持相同時,參與者是否認為自己能完成工作;這是假設同樣任務沒有 AI 時會如何的反事實情境。
455筆已完成、且有有效回答的 AI 輔助任務中,151筆被回報為沒有 AI 就難以完成,約33.2%,涵蓋56位參與者中的27位。這是參與者對反事實情境的自陳,研究者並未另設無 AI 對照組,因此不能視為因果結果。
出現困難時,人類介入的是什麼?
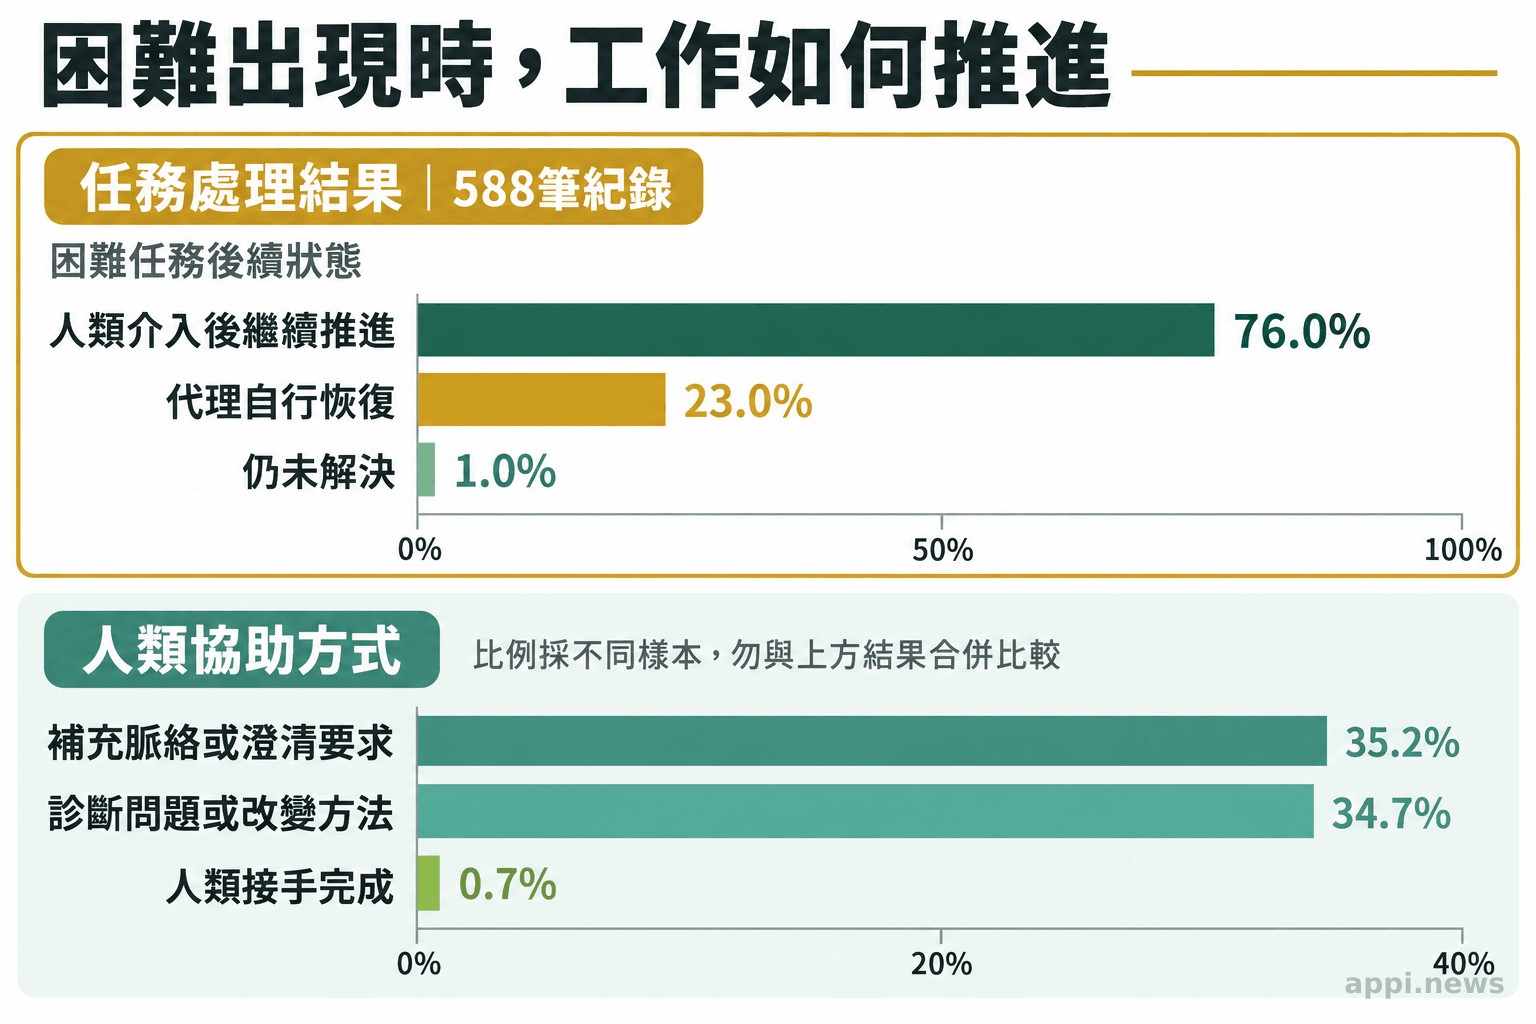
多數介入是補充情境、釐清要求或協助診斷,直接接手修改的比例較低。這表示人的作用常在調整問題理解與工作方向,不能只用「人有沒有親手做」衡量。
在有困難紀錄且記下如何處理的588筆任務中,76.0%在有人類介入後繼續推進,23.0%由代理自行恢復,1.0%仍未解決。人類介入內容以提供脈絡或澄清要求(35.2%),以及診斷問題或改變方法(34.7%)為主。親自修改一部分工作的比例為3.2%,由人類接手完成的比例為0.7%。以上百分比僅描述這組困難處理紀錄。
若實驗程式因資料欄位理解錯誤而跑出異常,代理可能有能力重新執行或調整程式;研究者仍得判斷錯誤究竟來自資料、假設或分析方法。
人類補上關鍵背景後,代理可能繼續完成修改,表面上看起來是機器完成修復,背後卻有人的診斷與方向選擇。對產品團隊而言,這也影響如何記錄工作:除了誰提交最後版本,還應保留代理收到的脈絡、誰判定問題原因、修正依據及結果由誰驗收。否則只看最後執行者,會把「人提供判斷、代理完成操作」誤記為代理獨立處理。
輸出修訂也呈現類似情形。627筆有主要 AI 輸出處置紀錄的任務中,354筆曾有實質修訂;在這354筆修訂任務裡,75.4%由 AI 依人類回饋修改,19.2%由人類直接編輯。草稿被修過,不必然代表輸出遭到否定;修訂者、回饋者與採納者也可能是不同角色。團隊若只記錄「最後檔案由誰產生」,就會漏掉促成變更的判斷鏈。
這項研究能說明什麼,又有哪些限制?
不能。這項研究提供 Atria Dawn 單一研發專案的觀察,呈現該團隊如何分配工作與決策;它沒有證明所有代理、模型或組織都會採取相同分工。
第一,研究者同時參與 Atria Dawn 的開發,觀察資料來自自家專案與工作紀錄。這有助於記下研發過程中的細節,也代表研究者兼具系統開發者與分析者身分,解讀結果時應保留這層脈絡。第二,56位參與者來自同一個專案,工作流程、工具權限、團隊文化及模型能力都可能影響觀察結果。其他團隊若有不同的核准制度或代理工具,決策分布可能改變。
第三,部分數字來自參與者事後回想或對假設情境的評估。像「相同條件下能否完成」的回答,呈現參與者的判斷,並未透過隨機分派比較有無 AI 的產出。第四,769筆任務是總體紀錄,決策歸屬、可行性與困難處理分別使用567筆決策紀錄、455筆有效可行性回答、588筆困難與應對紀錄等不同資料。讀者看到百分比時,應確認該數字的觀察對象和分母。
論文目前刊載於 arXiv,屬預印本,仍應視為研究團隊提出的初步個案分析。它沒有提供一套已驗證、適用所有組織的自主性評分標準,也無法由任務紀錄直接證明 AI 造成效率提升、模型能力成長或研究自主性上升。工作量、基準測試成績與決策權,分別需要不同證據來判斷。
產品團隊如何設計代理的研發責任界線?
先按可驗證性、影響範圍與失敗後能否回退分級,再為目標、採納結果及權限變更指定人工核准點。委派範圍應隨紀錄與風險逐步調整,不宜只看代理能否完成單一步驟。
第一類是結果容易檢查、出錯可以撤回的工作,例如整理實驗日誌、產生報表草稿,或在隔離環境執行已定義的測試。團隊可讓代理較完整地執行,但仍要保存輸入、工具呼叫、輸出與測試結果,並能重跑或回復版本。第二類是會影響後續實驗資源或研究判讀的工作,例如調整訓練參數、選擇資料範圍、變更分析流程。代理可以提供候選方案與證據,人類需確認適用條件、比較基準和是否值得繼續投入。
| 風險類型與工作例子 | 代理可執行範圍 | 人工核准點 | 權限、紀錄與回復方式 |
|---|---|---|---|
| 低:整理實驗日誌、產生報表草稿、執行已定義測試 | 可在隔離環境依既定步驟執行 | 人員檢視輸出與測試結果後採用 | 僅開放所需檔案與工具;保存輸入、工具呼叫和版本,必要時重跑或回復 |
| 中:調整訓練參數、選擇資料範圍、變更分析流程 | 提出方案與證據,經核准後小規模試跑 | 負責人確認適用條件、比較基準及資源投入 | 限定資料集與算力;記錄設定、資料版本及執行結果,保留原設定以便還原 |
| 高:使用外部或敏感資料、正式發布、擴張權限、不可逆資源消耗 | 僅執行明確核准的操作 | 指定責任人事前核准,超出上限須重新確認 | 敏感資料隔離並採最小必要權限;記錄存取與操作,設定額度、中止條件及回復責任人 |
以資料範圍調整為例,代理可先列出建議變更的欄位、預期影響及驗證方法;負責人檢查資料是否符合授權範圍,再核准小規模試跑。試跑前應保存原始設定與資料版本,執行時留下操作紀錄,結果則和既定基準比較。若指標超出預設範圍,流程應自動停止,由負責人決定是否回復原設定,並記下觸發原因。
這些紀錄讓團隊能重現操作、定位錯誤,也能確認代理是否只接觸完成任務所需的資料。遇到敏感資料時,隔離資料環境、限制下載與外傳、保留存取紀錄,應和模型輸出檢查同時設計。若一項工作無法明確界定資料權限、核准者或回復方式,就應縮小代理可執行的範圍,再從可驗證的小步驟累積紀錄。
判斷時可把工作拆成五個問題:代理可以執行哪個步驟?目標與驗收條件由誰設定?輸出用什麼獨立證據驗證?代理有哪些資料和工具權限?失敗時誰能停止流程並恢復狀態?回答後,團隊才能分辨「讓代理多做幾步」和「把決定交給代理」的差距。
- 列出代理可執行的工作,以及人類必須設定或核准的決策。
- 為每項輸出指定可重複的驗證依據,並記錄誰檢視、誰採納。
- 限定資料、工具、算力及外部操作權限,為高影響操作設人工核准。
- 設定中止、回復與事故紀錄方式,定期依實際任務紀錄調整委派範圍。
美國國家標準暨技術研究院(NIST)的 AI RMF Core 是可自願採用的風險管理參考架構,不是法規義務;它將治理、情境辨識、衡量與管理風險列為相互連結的工作。產品團隊可參考這些面向安排核准與驗證,並在模型與流程生命週期中定期檢查風險及委派範圍。
「持續自主研究需要同時提升探索能力與有意義的人類監督。」— Atria Team,摘要意譯
常見問題
Q1: 研究中的769筆紀錄都是AI完成的任務嗎?
769筆是分析的任務紀錄總數;其中739筆有明確的 AI 使用回答,713筆涉及 AI。代理參與任務與代理獨立完成任務應分開計算。
Q2: 33.2%代表AI已證明能完成原本做不到的工作嗎?
這個比例來自455筆有有效回答的已完成 AI 輔助任務,其中151筆被參與者回報為相同條件下無 AI 難以完成。它是自陳評估,沒有無 AI 對照實驗,不能當成因果證明。
Q3: 76%的困難由人類介入,是否表示代理常常失敗?
該比例指588筆有困難及處理紀錄的任務中,經人類協助後推進的比率。協助多為補充脈絡、釐清要求或診斷問題,不等同人類全面接手,也不能直接換算為所有任務的失敗率。
Q4: 產品團隊可以直接照研究比例分配工作嗎?
不宜。這些數字描述單一模型研發專案。團隊應依自己的工作風險、可驗證程度、資料權限與回退能力試行委派,並持續記錄代理執行、人類核准和結果品質。
- 任務紀錄顯示代理常提出方法與執行修訂,人類則多數選擇方法、設定目標並判定驗收。
- 769筆是總體紀錄,各項分析使用不同分母;比例須連同樣本條件解讀。
- 這是 Atria Dawn 單一專案的預印本個案,適合用來提出流程問題,不能當成所有組織的通用結論。
- 導入時應明列代理權限、人工核准點、驗證證據與失敗回退方式,再依實際紀錄調整。