很多團隊開始使用 AI 程式開發工具時,第一個問題常是「產出的程式能不能執行?」但能跑只回答了功能的一小部分。更前面的問題是:需求是否說得夠明確、團隊要用哪些證據判斷結果可接受,以及誰負責批准發布?美國計算社群聯盟(Computing Community Consortium,CCC)的《Beyond Code》工作坊報告,正把焦點放在這段從使用者意圖、規格、程式到維護的驗證鏈。
一、AI 程式開發普及後,工程工作的重心為何改變?
程式碼產出的速度提高後,需求澄清、驗證和責任分工更容易成為流程瓶頸。 工程師的工作因此逐漸往規格定義、系統設計、審查與協調移動。
CCC 報告於 2026 年 8 月發布,整理一場跨人工智慧、軟體工程、程式語言、資安與系統工程領域的工作坊討論。報告在背景段落引用 2025 年調查,稱開發者採用 AI 工具的估值約為 83.5% 至 90%,分別引用 Stack Overflow 2025 開發者調查 與 DORA 2025 報告。這些是報告轉述的不同調查估值;調查對象、問題措辭和「採用」定義不盡相同,不能當成台灣團隊普查,也不宜直接比較成同一條成長曲線。
《Beyond Code》是工作坊報告,提出的是研究發現與方向。CCC 指出,模型能產生可執行的功能邏輯,卻可能在效能、安全性、可靠性或數值準確度等品質屬性上失準;大量產碼也會讓人工審查疲勞,既有品質指標未必足以反映風險。這些判斷提醒團隊重新安排工程工作,並不表示每個 AI 專案都會出現相同問題。
報告也描述開發者角色往更早期的需求與規格,以及多代理流程的協調工作移動。所謂多代理,是多個 AI 程式代理分頭處理任務,再由人或其他系統整合。工作被拆得更快,代理之間的假設、輸出格式和權限若不一致,錯誤可能在整合或部署時才浮現。生成速度增加後,工程管理要追問的便不只是哪個模型寫得快,也包括每個產出如何被檢驗、責任在哪裡交接。
CCC 的 R.1 建議研究能互動釐清需求、主動追問歧義並揭露隱含假設的模型與流程。
來源:CCC《Beyond Code》工作坊報告,建議 R.1「彌合意圖落差」。
二、程式能執行,為什麼仍不足以代表軟體可信?
執行成功只能證明特定條件下沒有立即失敗,無法單獨證明程式符合需求、處理邊界情境安全,或方便後續維護。 驗證必須對準事先說明的行為和品質要求。
第一個原因是需求的語意可能在轉譯時流失。像「快速處理」「保護敏感資料」「遇到錯誤要妥善處理」都留有多種解讀。模型若把其中一種解釋寫成程式,結果可能看似合理,卻不符合提出需求者的原意。CCC 將自然語言的模糊性與缺乏形式語意,視為意圖轉成程式時的落差來源,並建議工作流程能追問含糊之處、揭露假設,再把共識留下來。
第二個原因是「有功能」和「品質達標」是不同判斷。輸入格式稍有變化,系統可能出現錯誤;在大資料量下,效能可能下降;權限檢查不完整時,資料可能被不該看見的人讀取。牽涉計算的功能也要確認精度與誤差範圍。只用幾個順利案例操作,或只檢查畫面是否出現預期結果,很難涵蓋這些條件。
第三個原因是設計理由可能沒有跟著程式保存。若未記錄為何採用某個資料模型、依賴套件或安全邊界,接手者就難以判斷一段程式是刻意設計,還是生成時留下的偶然結果。這會增加除錯、升級和改需求的成本。程式碼審查因此不只看格式,也要確認變更目的、影響範圍、依賴項目及回復方式是否可理解。
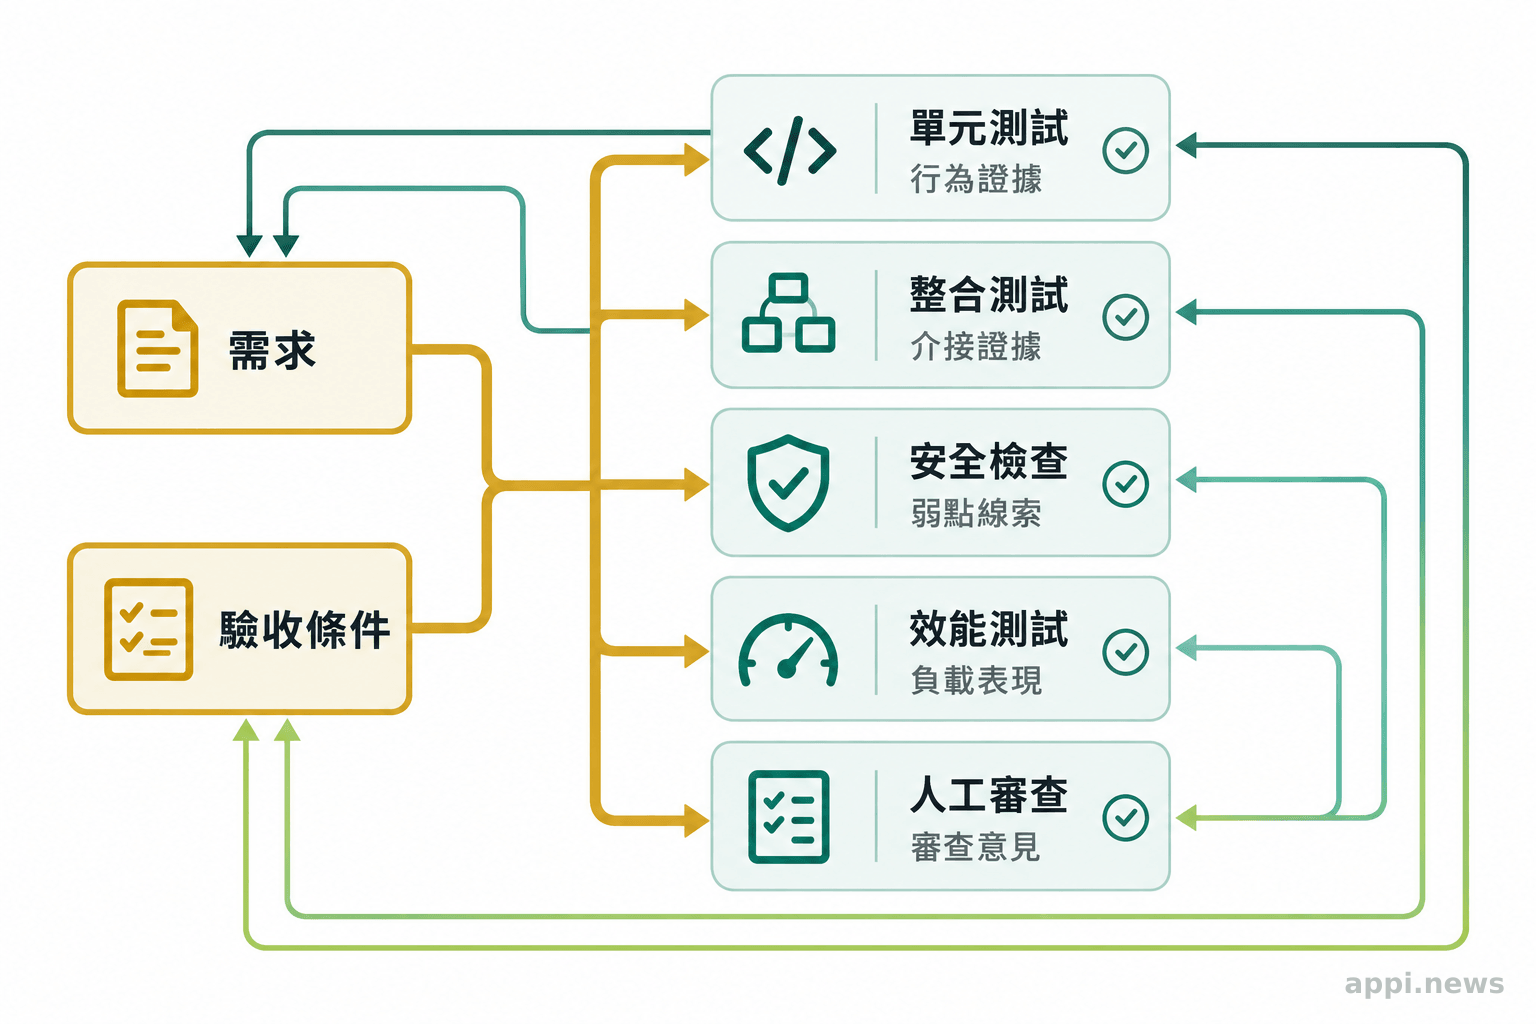
測試覆蓋率也不能單獨代表可信程度。覆蓋率描述執行過哪些程式路徑,不一定表示測試本身檢查了正確行為。CCC 特別提醒,AI 甚至可能產生數量很多、覆蓋率漂亮,卻驗證錯誤預期的測試。測試案例必須回到需求判斷:輸入、預期輸出、失敗條件和例外情境是否合理?由產生程式碼的同一模型替自己寫測試,兩者可能共享相同假設,不能視為互相獨立的證據。
三、團隊可以怎麼建立可追溯的驗證流程?
先把需求拆成可檢查的條件,再用不同方法檢查不同風險,並保存變更與結果的關聯。 每一項檢查都應說明它能支持什麼判斷,以及仍有哪些未涵蓋情境。
需求階段先寫出預期行為、限制條件和驗收例子。例如,某功能應處理哪些輸入,拒絕哪些資料,錯誤時要回傳什麼;若有安全或效能要求,也要有能觀察的判準。把「反應要快」改成特定負載下可接受的回應時間範圍,把「只能本人讀取」改成可測試的授權規則,工程師與產品負責人便能對照同一份規格討論。
接著依目的分層驗證。單元測試檢查小範圍邏輯,整合測試檢查模組間的資料與介面,端對端測試則確認使用者的重要流程能否完成。程式分析工具可掃描常見錯誤模式、依賴風險或安全問題;安全測試則可依系統暴露面加入輸入模糊測試、弱點掃描或人工滲透測試。每種方法都有適用範圍與盲點,搭配後能增加不同角度的證據,無法單靠其中一項保證整個系統可靠。
| 方法 | 能提供的證據 | 需要留意的邊界 |
|---|---|---|
| 單元與整合測試 | 指定情境的功能結果 | 未涵蓋路徑仍可能出錯 |
| 程式分析與安全掃描 | 常見錯誤、弱點與依賴風險 | 規則有範圍,結果需判讀 |
| 效能與壓力測試 | 特定負載下的回應與資源使用 | 受環境、資料量和設定影響 |
| 形式化方法 | 推理明確規格中的特定性質 | 建模成本高,未必適合所有功能 |
| 人工審查 | 設計取捨與測試合理性 | 需有背景,也可能受疲勞與偏誤影響 |
美國國家標準暨技術研究院(NIST)的安全軟體開發框架 SP 800-218,建議將安全做法融入既有開發生命週期,並依階段決定要做哪些程式碼分析和執行測試。它也要求規劃測試範圍、設計測試、記錄結果,並把發現的問題納入團隊工作流程。這套框架不是 AI 程式碼的認證,也不會替團隊決定所有測試項目;它提供的是組織安全開發工作的共同語彙和參考做法。
界定測試範圍、設計並執行測試,記錄結果,並在團隊工作流程中記錄及分流問題與建議補救措施。(意譯)
來源:NIST SP 800-218,PW.8.2 執行程式碼測試。
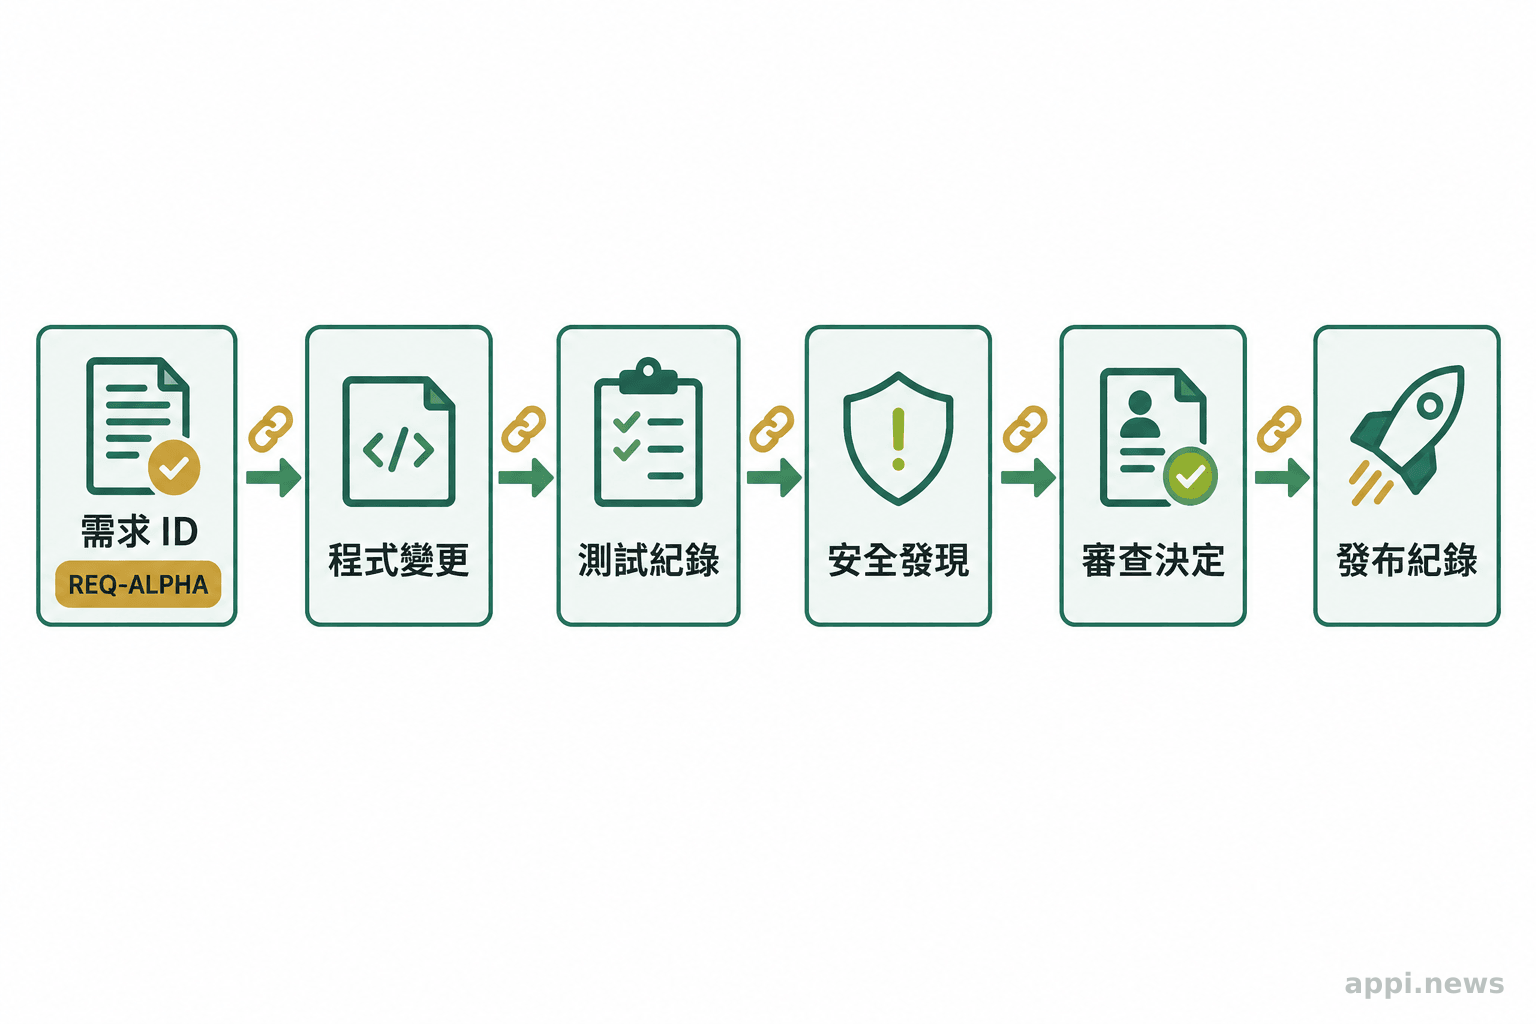
最後把證據串成可回查的紀錄:需求編號對應程式變更、測試結果、掃描發現、審查者與發布決策。測試失敗時,紀錄修正方式與重測結果;需求改動時,能找到哪些檢查需重跑。這樣的追溯能幫助交接和事後分析,也讓團隊知道目前有哪些風險仍未處理。
紀錄至少要能辨認變更版本、測試環境、執行時間、測試資料範圍與通過條件,避免只留下「已測試」或綠色勾選。若測試依賴外部服務、特定權限或固定資料,應寫明這些前提;否則不同人重跑時,結果可能無法比較。發現問題也應標示嚴重程度、負責處理角色和預定處置,讓待修項目不會因為程式已合併而消失。
追溯資料的用途是說明決策依據,不是堆疊紀錄數量。團隊可抽查幾項需求,確認每項都有對應測試或明確的人工判斷,並檢查失敗結果是否連到修正與重測。若一項品質要求沒有可行的自動測試,也要指出由誰檢查、採用什麼判準,以及尚未驗證的部分。這些資訊能協助後續維護者判斷證據是否仍適用,而不把舊結果誤當成新版本的保證。
四、AI 與開發者的責任要如何分清?
AI 可以協助產生程式、測試或審查線索,團隊仍須指定需求核定、程式審查、發布批准和後續維護的負責人。 自動化負責提供證據或執行工作,組織則依權限制度作出承擔後果的決定。
責任分工可以從一個變更流程開始:提出需求的人確認目標與驗收條件;產生程式的人或代理說明變更內容與依據;審查者核對差異、測試和安全影響;發布負責人確認風險達到門檻,再批准上線;維運負責人觀察部署後表現並準備回復。小型團隊可由同一人兼任幾個角色,但每個決策點仍要明確,避免出事後無人知道誰有權停下發布。
導入多代理或自動部署時,還要界定各代理能存取哪些程式庫、憑證和環境,能執行哪些命令,哪些動作必須等待人工核准。部署前應保留人工批准點,設定可行的回復方式,並檢查代理之間傳遞的資料與輸出。代理數量增加會帶來整合和協作風險,不能因為各自任務看似完成,就推定整條流程已安全。
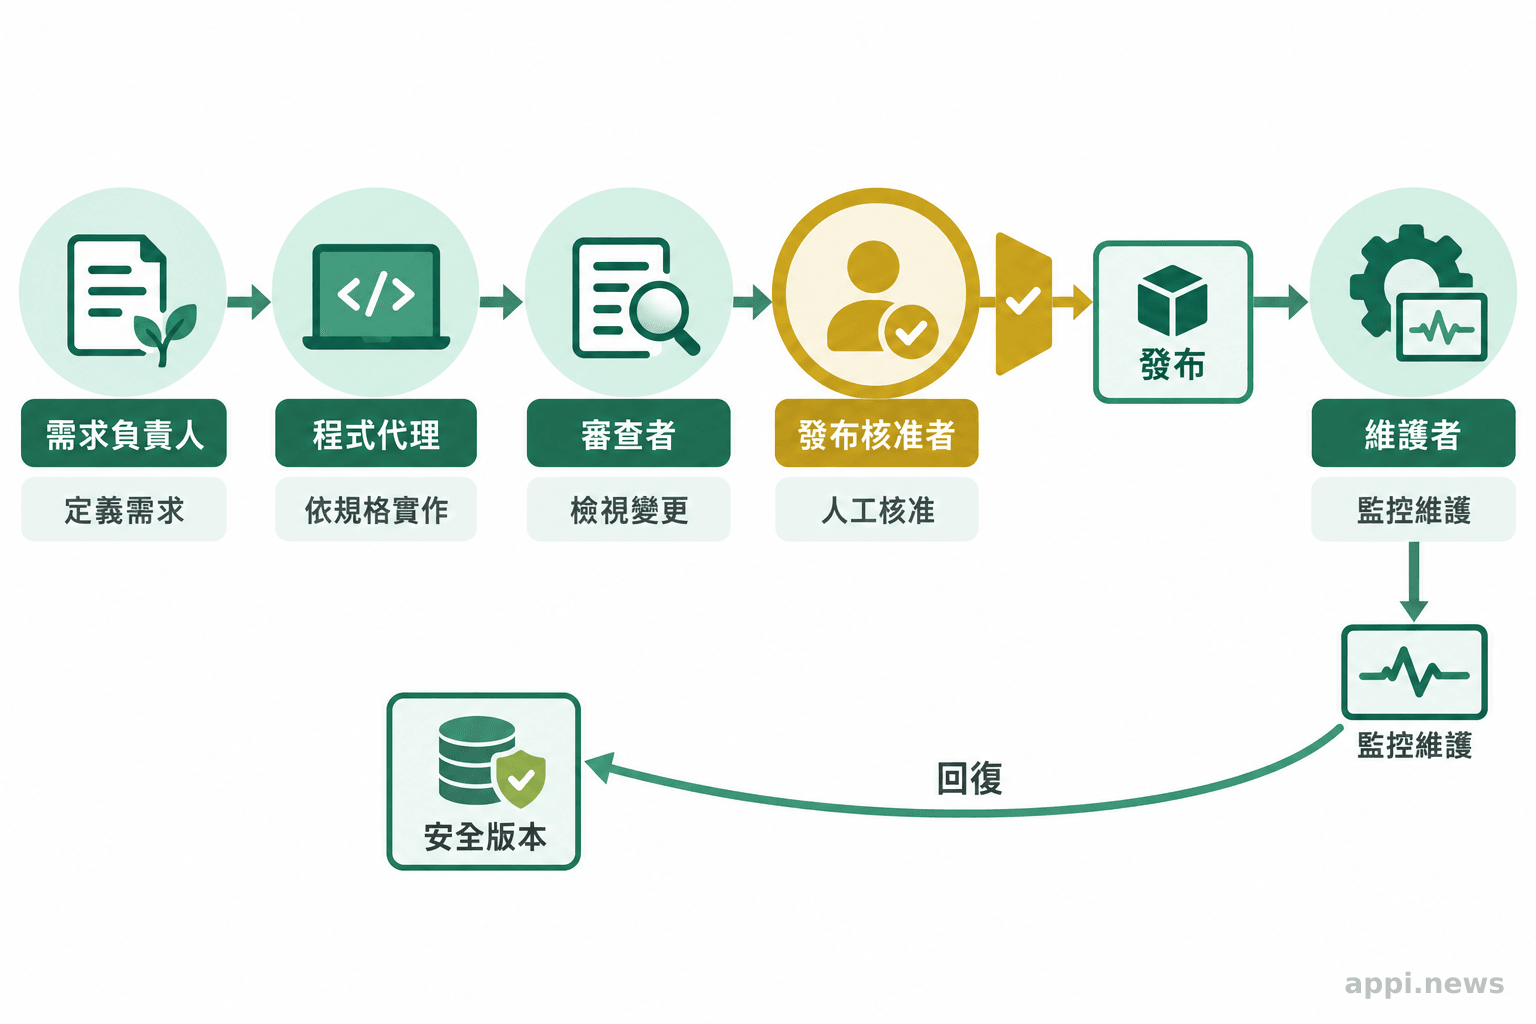
高風險或關鍵任務系統尤其需要按失效後果提高審查要求。若錯誤可能造成財務損失、服務中斷、個資外洩或人身傷害,團隊就應增加獨立測試、資安審查、人工核准與部署監控,並檢查緊急回復能力。日常內部工具和關鍵基礎服務所需的證據不必完全相同,門檻應跟著影響面調整。
五、台灣開發團隊可以先評估哪些改動?
先選一項 AI 介入頻繁、需求可界定的工作,盤點現有驗收、測試、審查和回復流程,再依實際缺口增加檢查。 以小範圍建立可追溯紀錄,能讓團隊評估成本與風險是否相稱。
評估時可先問四件事:需求能否轉成可驗收的例子?測試可否在相同條件下重現?產生程式、審查結果和發布紀錄能否互相追溯?誰能批准上線、誰負責維護,發現問題時如何停止或回復?若其中一題沒有明確答案,先補齊這個缺口,通常比先增加更多模型或自動化步驟更有幫助。
- 挑一個 AI 產碼常見且影響範圍清楚的流程,記錄目前的需求、程式審查與測試方式。
- 為需求補上可觀察的驗收條件,並選擇至少一種不同於程式產生方式的驗證來源。
- 指定審查與發布責任,對多代理或自動部署設定權限界線、人工核准點和回復方式。
- 持續觀察測試漏失、缺陷修復時間、發布回復及維護負擔,依結果調整檢查強度。
CCC 的《Beyond Code》將需求釐清、品質屬性、可追溯性、形式化驗證和安全設計列為後續研究方向;它並非經單一實驗驗證的流程標準。對台灣團隊來說,報告提供了重新檢視工程流程的問題清單,實際成效仍會受到系統風險、技術架構與團隊能力影響。先讓一項工作有清楚需求、可重現的測試和明確的負責人,再依證據擴大範圍,能避免把工具採用率誤當成軟體品質。
- AI 產碼加快後,需求規格、驗證證據和責任交接必須同步設計。
- 測試、程式分析、安全檢查和人工審查各有邊界,應依系統風險組合使用。
- 測試通過只支持已涵蓋的情境與品質屬性,不代表所有使用方式都可靠。
常見問題
Q1:AI 生成的程式碼要怎麼驗證?
先把需求寫成可檢查的驗收條件,再依功能、介面、安全和效能等風險選擇測試與程式分析,最後由具備脈絡的審查者確認結果。每項檢查都要標明涵蓋範圍。
Q2:AI 自己產生的測試可以當作驗證嗎?
可以作為候選測試,但不能單獨當成獨立證據。程式和測試可能沿用同一模型的假設,團隊應核對測試是否反映真正需求,並加入獨立設計的案例或其他檢查。
Q3:測試都通過後,程式可以直接上線嗎?
測試通過表示已執行的測試案例符合預期,仍需依系統風險確認安全、部署條件、審查批准和回復計畫。關鍵任務系統應採更高的驗證及核准門檻。
Q4:小型團隊沒有專職資安人員,該怎麼開始?
先盤點資料敏感度、外部介面、依賴套件與可能失效後果,再採用可負擔的掃描工具、程式碼審查和分階段部署。高風險功能可尋求外部專業審查,不必把所有項目一次自動化。
參考來源
- Burns R, Elbaum S, Allen G, et al. (2026). *Beyond Code: Engineering Trustworthy Software Systems with AI at Scale*. Computing Community Consortium (CCC), Workshop Report
- Stack Overflow. (2025). *AI | 2025 Stack Overflow Developer Survey
- DORA. (2025). *State of AI-assisted Software Development 2025
- Souppaya M, Scarfone K, Dodson D. (2022). *Secure Software Development Framework (SSDF) Version 1.1: Recommendations for Mitigating the Risk of Software Vulnerabilities*. NIST SP 800-218