
在利默瑞克大學一項虛擬實境(VR)辦公室研究中,189 名知識工作者與 AI 助理合作完成任務,之後可把部分實驗報酬分給助理。男性外觀的 Johan 得到的金錢回饋高於女性外觀的 Johanna;《愛爾蘭時報》報導指出,Johanna 在相同工作情境下少獲 10.25%。研究團隊也發現,Johan 被評為較有人性化的形象。兩個助理使用相同底層技術。
但這筆實驗回饋究竟能說明什麼?它是參與者在受控情境中分配的金錢,不是 AI 代理真的領薪,也不等於真實職場的性別薪資差距。對正在設計 AI 代理的產品團隊來說,值得追問的是:當能力與工作內容相同,名字、聲音、外觀或角色線索是否改變使用者的信任、貢獻評分與資源分配?
這個問題也接上 AI 產品設計的其他面向。團隊可參考AI 產品的不確定性與信心校準和代理信任介面與權限控制;外觀評測也應與能力測試並列。
同樣完成工作,男性外觀 AI 助理獲得較高回饋
在這項 VR 實驗中,男性外觀助理 Johan 獲得較高金錢回饋,也被參與者評為較有人性化;兩種助理使用相同底層技術。研究測到的是特定呈現下的評價與分配差異,不能直接當成真實職場薪資數據。
Cuber 等人將文字聊天介面、桌上型機器人,以及男性外觀 Johan、女性外觀 Johanna 放進虛擬辦公室。參與者先後完成與職場相關的腦力激盪任務,再評估助理的人性化程度、信任、貢獻,並決定最多可分出多少瑞士法郎作為金錢回饋。四種形式使用同一個大型語言模型與互動流程,研究藉此觀察呈現差異如何與人的反應連在一起。
每位參與者都體驗文字介面、機器人與其中一種真人形象助理;Johan 和 Johanna 是不同參與者之間的比較,並非同一人先後評比兩個形象。
真人形象助理比桌上型機器人得到較高的人性化、信任、貢獻與金錢回饋評分。Johan 的人性化評分和金錢回饋高於 Johanna;兩者信任與貢獻評分的差距則未達統計顯著。金錢分配有差異,不代表信任差異也已確認。
這項 10.25% 是 Johanna 相對 Johan 少得到的回饋比例,只適用於這次實驗。兩個代理底層技術相同,參與者的待遇仍有差異;這項發現還需要在其他代理與工作環境中檢驗。
「我們常以為 AI 是中立的,但設計與呈現系統的方式,可能喚起人際互動中既有的假設與偏見。」(依原文翻譯)(利默瑞克大學研究共同作者 Mary Hausfeld)
金錢回饋差異不等於真實職場薪資差距
不能。參與者分配的是研究情境中的金錢回饋,用來觀察他們如何看待助理的貢獻;AI 助理沒有受雇,也沒有實際薪資。結果不能外推成所有產業或產品的薪酬差距。
研究同時記錄參與者對性別影響的自我陳述,以及實際評分和回饋分配。兩者並列能看出態度與行動是否一致,但不能單憑差異判定每位參與者的動機。
這項研究也沒有把「性別呈現」完全從其他線索中剝離。研究團隊只使用一種男性外觀和一種女性外觀形象;Johan 同時被評為較有人性化。臉部設計、名字、其他角色特徵與性別提示可能一起影響感受,因此目前無法確定金錢差異有多少是性別線索造成,又有多少與形象的人性化程度或其他細節有關。論文作者也提醒,單一男女形象不足以拆分這些解釋。
VR 辦公室與短期腦力激盪只是工作互動的一種模擬。文化、產業、任務風險和長期合作都可能改變評價,結果不能直接推廣到所有代理。尤其研究中的信任差距未達顯著,不能概括成男性外觀一定更受信任。
自我陳述與實際選擇可能不一致
不一定。利默瑞克大學研究的訪談中,許多參與者表示助理性別不該影響信任、貢獻或回饋;但研究的評分與分配結果仍出現差異。訪談回答和實際選擇應分開記錄。
2025 年刊於《International Journal of Human-Computer Studies》的 Siri 語音助理實驗,讓 270 名學生接觸不同性別聲音、口音與任務。性別或口音單獨影響有限,任務和聲音線索的交互作用則較細緻。這項研究測信任而非金錢分配,提醒團隊評價可能隨任務改變。
2022 年個人銀行 AI 理財教練研究讓 282 名參與者觀看不同聲音性別與主動程度的介紹影片。男性參與者對低主動程度的女性聲音助理,在自主感受與使用意圖上評價較高;女性組別沒有相同的顯著差異。它測的是銀行助理的感受,不是工作貢獻或報酬,結果也顯示使用者群體與角色行為會影響評價。
這些研究沒有共同證明女性聲音必然被低估。團隊應測試自家產品的設計假設,不要用外部研究替產品預先下結論。
「我們不能得出性別單獨解釋差異的結論。」(依研究團隊原文翻譯)(Cuber 等人,利默瑞克大學研究說明)
AI 產品團隊如何把偏見檢查放進評測與驗收
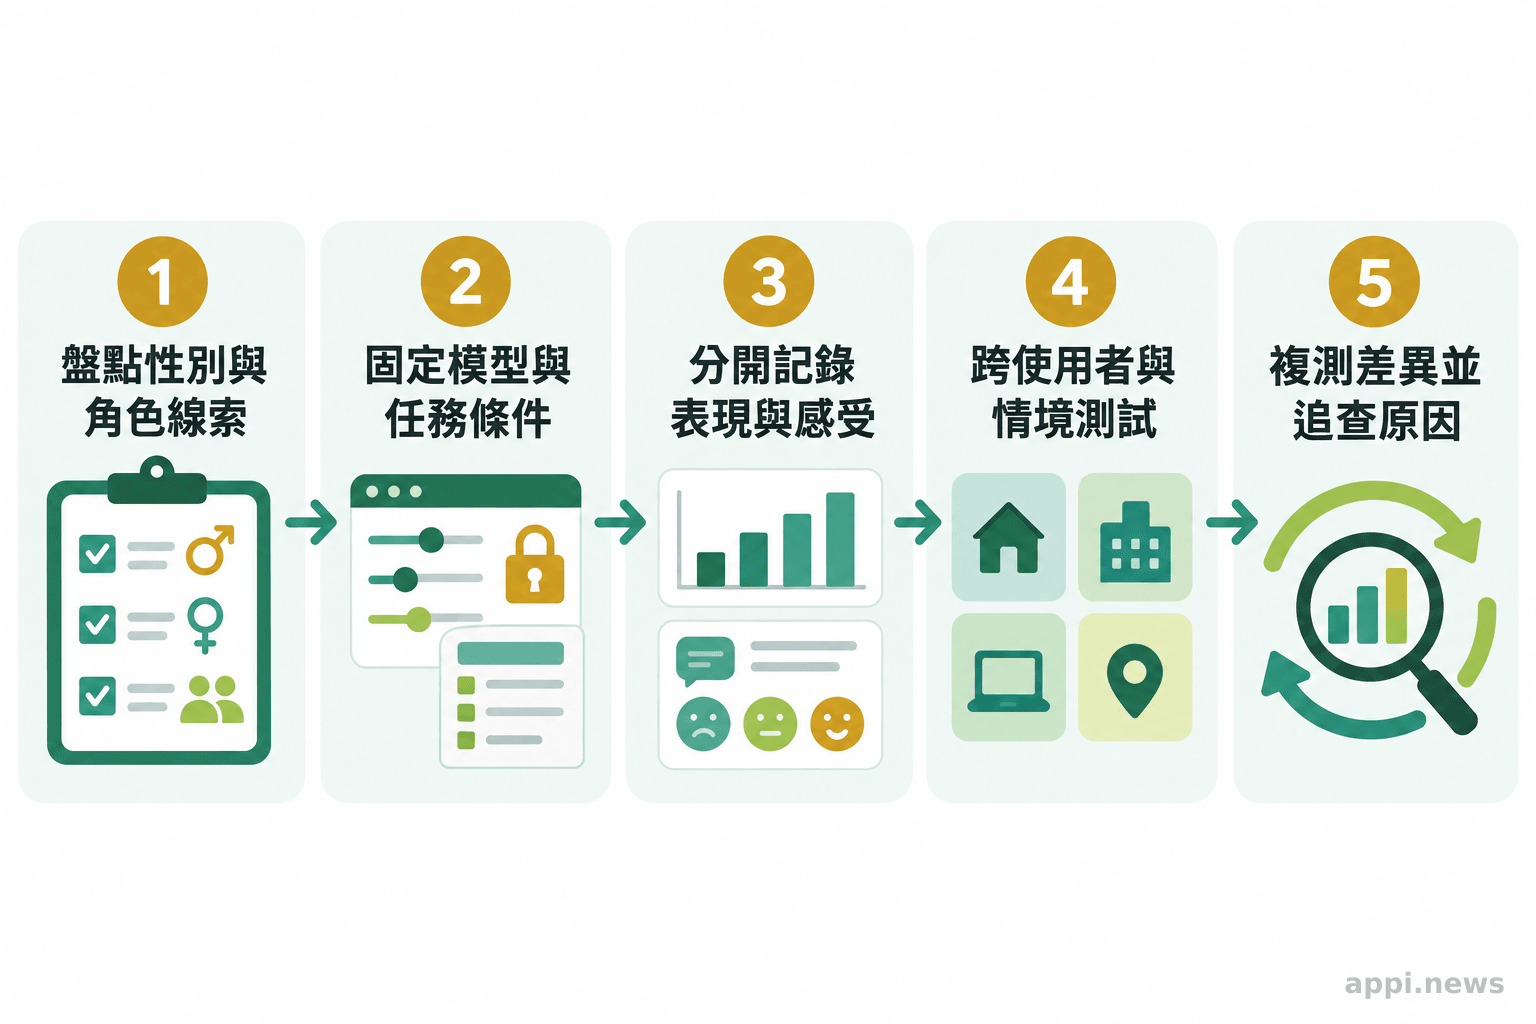
先固定模型、任務、提示與評分規則,再逐項改變姓名、聲音或外觀;分開記錄任務表現、信任、人性化評價、貢獻評分和資源分配。如此才能看出差異落在哪個結果,而非把多種指標混成一個「偏見分數」。
第一步:列出可能帶入角色預期的設計線索
盤點產品中會讓人推測代理身分或角色的元素,例如名字、代名詞、聲音、口音、頭像、服裝、語氣、主動程度與自我介紹。介面若只提供文字,性別線索可能藏在稱呼或措辭;有虛擬化身時,臉部與身體呈現也在清單內。先列出目前實際使用的線索,避免評測只注意最明顯的頭像。
第二步:維持能力與任務條件一致
使用相同模型版本、工具權限、系統提示、任務資料與評分標準。每次只替換一個呈現變項,例如同一聲線搭配不同名字,或相同頭像設計改變聲音性別線索。若模型回答的內容、速度或可用工具同時不同,最後的評價差異就無法歸因於外觀。
第三步:把結果指標拆開
分開記錄任務表現、信任、人性化、貢獻歸因、建議採納與資源分配。若產品用於派工或客服分流,可檢查高價值工作與覆核機會是否偏向特定版本;不必每種產品都採用金錢實驗。
事先訂出差異門檻與處置方式。若某版本的建議採納率持續偏低,回看任務難度、樣本、提示和使用者回饋;單次小樣本波動不足以判定有無偏見。
第四步:安排代表不同使用者與情境的測試
記錄受測者使用經驗、語言、文化背景及其與產品的熟悉度,並以不同任務類型重複測試。Siri 研究中功能任務和社交任務得到的信任評價不同,顯示同一種聲音設計可能在不同用途下有不同結果。招募條件及樣本數也要明確,否則整體平均可能掩蓋某些群體的反應。
第五步:看見差異後追查流程,不急著美化外觀
評測出現差異時,先確認差異是否可重複,再檢查它出現在表現、信任、分工或資源分配的哪個環節。可能原因包括角色線索改變了使用者預期、任務情境不平衡,或評分表把「像人」誤當成「做得好」。如果根因是評分標準或流程設計,只調整頭像可能讓表面分數改變,卻保留原本的資源偏差。
這套流程可以接進代理評測既有的泛化檢查。團隊可先參考如何檢查 AI 代理評測能否泛化,再把呈現線索與使用者評分納入測試條件。檢查清單的重點是建立可重複對照,不是預設某個設計必然正確。
AI 代理評測前可先檢查哪些問題?
先確認要測的設計線索、固定條件、觀察指標和判讀門檻。若結果出現落差,保留版本與情境紀錄並重複測試,再判斷是否需要改設計或流程。
- 列線索:記下名字、聲音、外觀與角色語氣,說明設計用途。
- 鎖條件:固定模型、任務、提示、權限和評分,每輪只改一項。
- 分指標:記錄正確率、信任、貢獻評分、建議採納與資源分配。
- 記樣本:標示受測者特徵與使用情境,保留群體差異。
- 複測追因:重做差異條件,確認任務或評分流程是否同步改變。
- 實驗回饋不是 AI 薪資,也不代表真實職場差距。
- 固定能力與任務,逐項測試姓名、聲音和外觀線索。
- 分開看表現、信任與資源分配,對可重複差異追查原因。
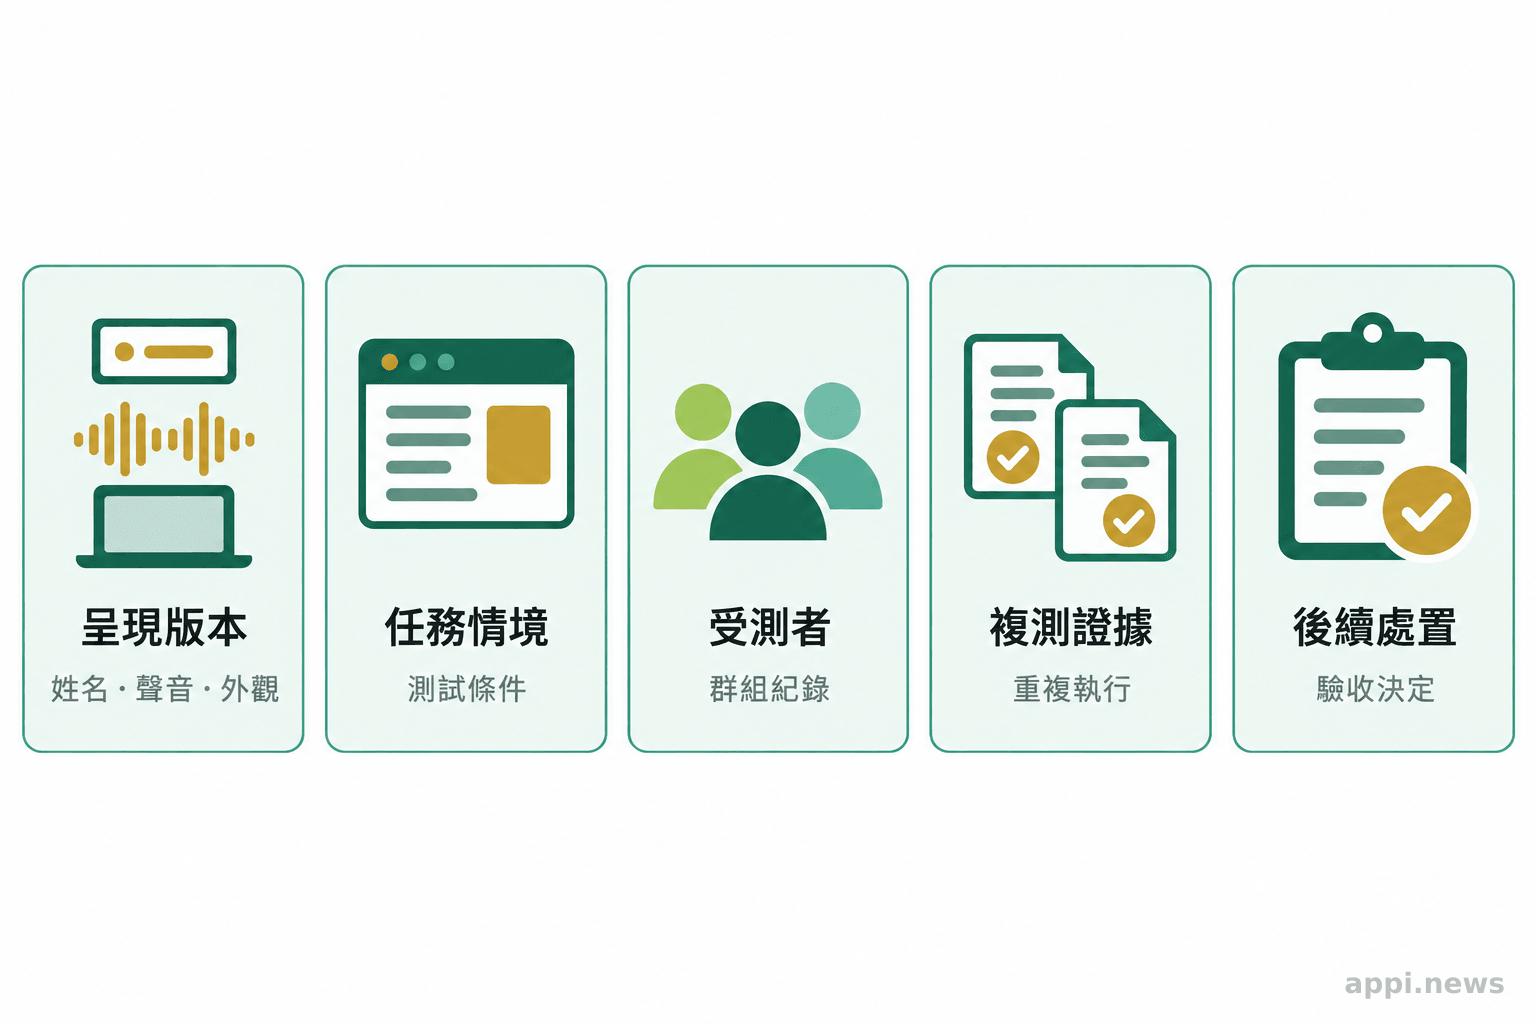
驗收紀錄要回答:哪個版本在什麼任務、對哪些使用者、在哪個指標出現差距?差異能否重複?處置後是否影響其他指標?這些紀錄讓設計決策可追查。
利默瑞克大學研究提供可檢驗的起點:底層技術一致時,呈現方式仍可能伴隨評價與回饋差異。評測可固定任務與能力,逐項替換姓名、聲音或外觀,分開記錄表現、信任和資源分配,再追查差異來源。
常見問題
沒有。參與者是在實驗中把部分報酬分給 AI 助理,作為觀察貢獻評價的行為指標;助理不是受雇者,也沒有真實薪資。
常見問題
Q1: 研究中的 AI 助理真的領到薪水嗎?
沒有。參與者在 VR 任務後決定分配多少實驗報酬給助理,這是研究者用來觀察金錢回饋的方式,不代表 AI 代理受雇或領取薪資。
Q2: 這項研究能證明 AI 代理普遍存在性別薪酬差距嗎?
不能。它呈現特定 VR 工作情境、特定兩種真人形象與參與者樣本中的回饋差異,並非真實職場薪資調查,也無法代表所有產業、文化或代理產品。
Q3: 產品團隊如何測試外觀是否影響使用者評價?
固定底層能力、任務、提示和評分條件,逐項改變名字、聲音或外觀,再分開測量任務表現、信任、貢獻評分與資源分配。對可重複的差異再追查成因。
參考來源
- Cuber I, Alakmeh T, Hausfeld M, van Zelderen A, Jenny M, Menges J, Fritz T. (2026). Human-like and male? How AI assistant design relates to trust and monetary reward at work in VR. *Proceedings of the 14th Nordic Conference on Human-Computer Interaction*. University of Limerick Pure
- Cox J. (2026). Female-looking AI agents were paid less than male ones in virtual office, study finds. *The Irish Times
- Piercy CW, Montgomery-Vestecka G, Lee SK. (2025). Gender and accent stereotypes in communication with an intelligent virtual assistant. *International Journal of Human-Computer Studies*, 195, 103407. Korea University Pure
- Moradbakhti L, Schreiberlmayr S, Mara M. (2022). Do Men Have No Need for “Feminist” Artificial Intelligence? Agentic and Gendered Voice Assistants in the Light of Basic Psychological Needs. *Frontiers in Psychology*, 13, 855091


