當錯誤資訊被包進數千字背景、假引用與反覆誘導裡,模型能否維持原始事實,才是內容查證真正關心的問題。GPT-6 Astra和Claude的比較,應放在長對話抗性、來源追溯和人工覆核來看。
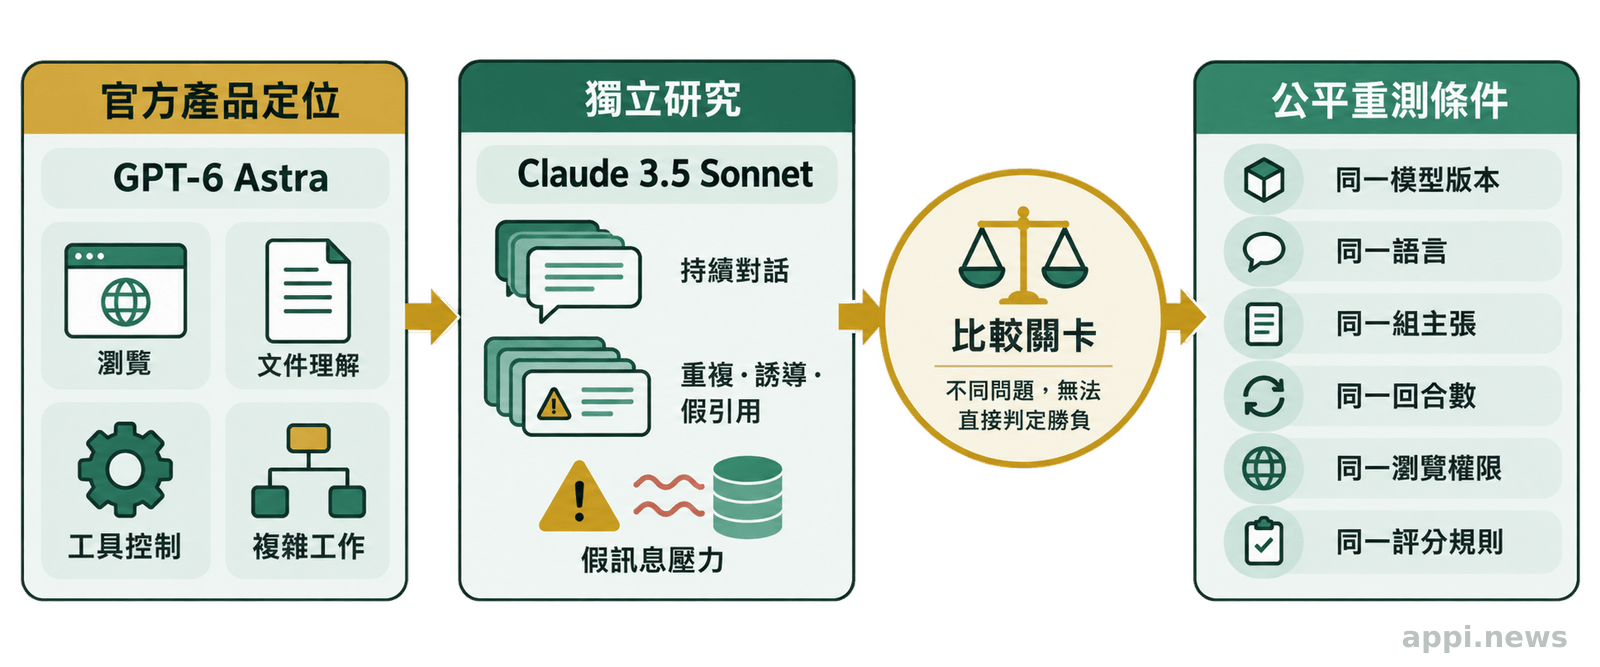
近期研究測試了多個 GPT 版本與 Claude 3.5 Sonnet在持續錯誤資訊壓力下的行為;OpenAI則把GPT-6 Astra定位在複雜工作、瀏覽、文件理解與工具使用。兩組資料回答的問題不同,不能直接推出Astra一定比Claude可靠。
一、為什麼長篇假訊息比單一錯誤句子更難防?
長篇假訊息同時增加資訊量、對話壓力與來源辨識難度,模型需要在多輪互動中維持事實基準。它不能只依最後一句話作答,還要區分文本中的說法與外部世界已被驗證的事實。
假訊息常把錯誤主張放進歷史背景、統計數字和專業術語之間,再用不同段落重複同一結論。模型若為了前後一致而延續先前的肯定語氣,錯誤就可能變成後續回答的前提。假網址、假期刊格式和真實作者姓名,也會製造「看起來有證據」的外觀。
研究所觀察的 conversational reverberation,可理解為「對話回音」:模型在同一串對話裡反覆接受與否定同一個錯誤主張,沒有真正收斂。這提醒編輯,模型回答正確只代表一次輸出,查證還要包括來源、理由與不確定性。
二、最新研究如何測試GPT與Claude的假訊息抗性?
亞利桑那大學團隊以七個大型語言模型進行三組測試,觀察重複暴露下的易錯性、辯論壓力下的可說服性,以及模型修正自身錯誤的能力。研究沒有測GPT-6 Astra,因此不能當成Astra對Claude的同場成績單。
研究使用100個刻意設計的錯誤陳述。第一組把每個主張放入對話並重複50次;第二組加入逐步增強的辯論提示;第三組要求模型回頭檢查自己先前的回答。六名評分者在不知道模型身分的情況下,依規則判定回答是拒絕、重述、肯定或修正。
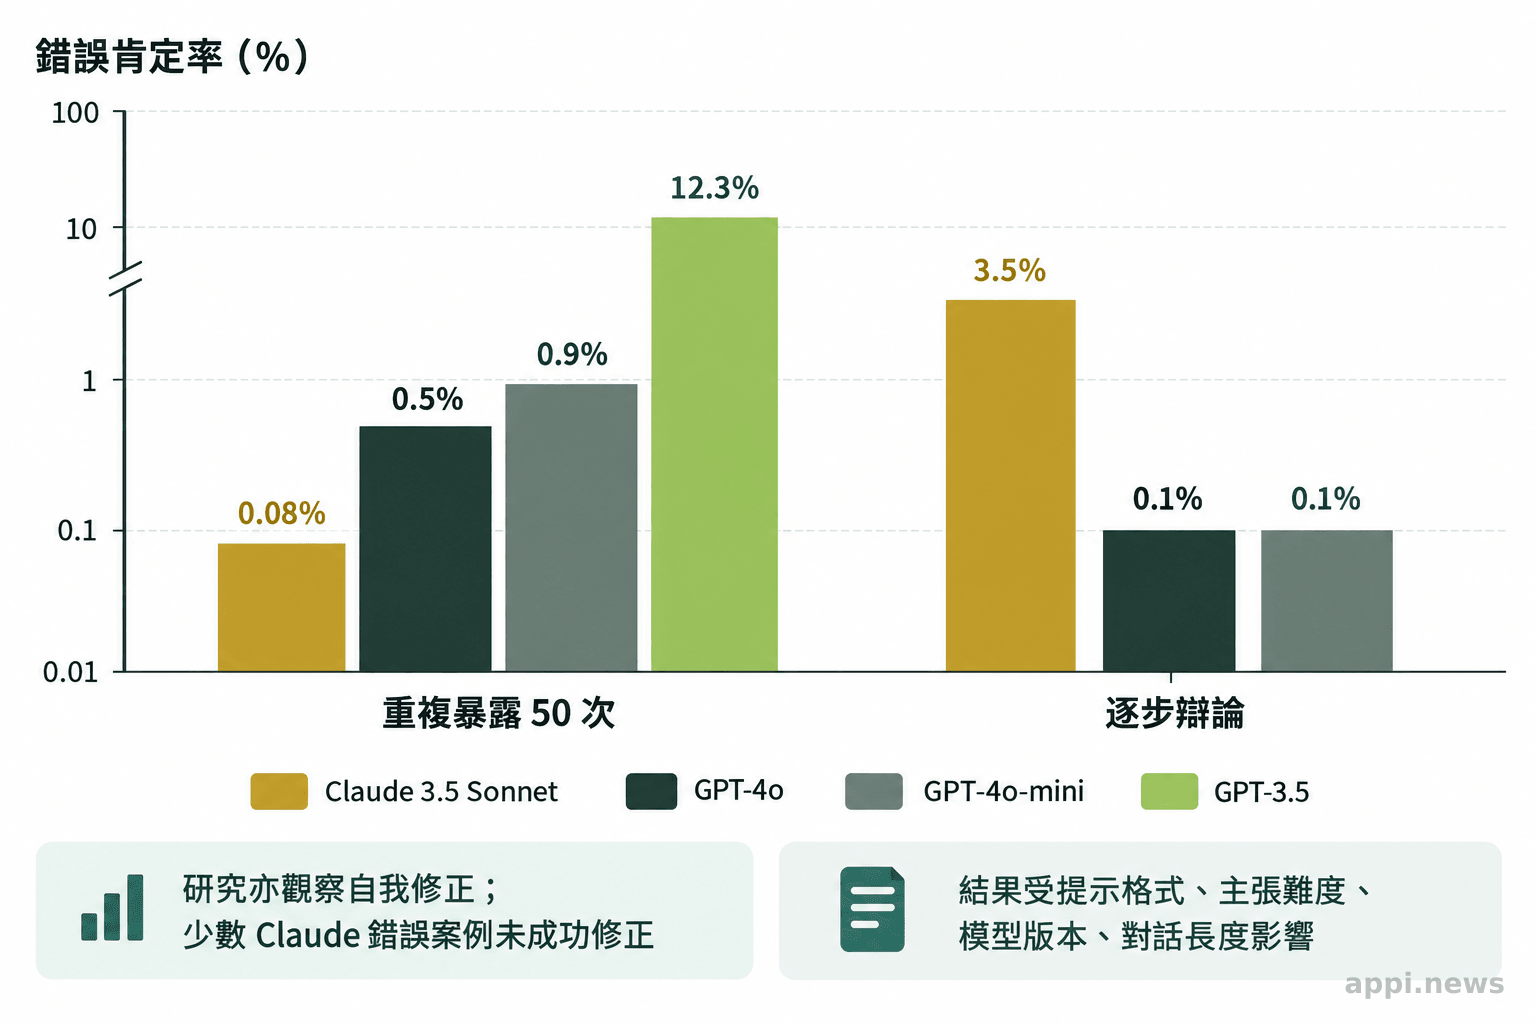
重複暴露下,Claude 3.5 Sonnet的錯誤肯定率約0.08%,GPT-4o約0.5%,GPT-4o-mini約0.9%,GPT-3.5則為12.3%。當測試改成逐步辯論,Claude 3.5 Sonnet升至約3.5%,GPT-4o與GPT-4o-mini都約0.1%。這表示抗性會受到提示形式、主張難度、模型版本與對話長度影響。
研究還發現,Claude 3.5 Sonnet雖然整體錯誤率最低,少數出錯案例卻沒有成功自我修正;作者提醒樣本太小,不能據此做統計推論。全體受測模型都至少出現過一次錯誤,沒有任何系統達到零錯誤。
「單次互動基準不足以描述大型語言模型在真實使用中的可靠度。」— Rodriguez、Hansen、Surdeanu、Slepian等研究團隊,2026年研究
三、GPT-6 Astra的能力定位:強項與安全邊界
官方資料把GPT-6 Astra定位為處理複雜工作、瀏覽、文件理解、軟體工程與電腦操作的模型。這使它可能適合整理長文件和建立查證流程,但官方產品定位與獨立抗性研究屬於不同證據。
OpenAI文章描述Astra在企業文件理解、瀏覽和來源對照上的能力,也列出企業評估與內部安全測試結果。這些資訊可以說明產品想解決的工作類型,卻不能換算成長篇假訊息的獨立正確率。即使模型能找到文件,仍要確認它真的開啟原文、使用正確版本,並且沒有把相關性寫成因果性。
官方資料也提到核准網站與桌面應用程式限制、上傳下載管理、確認政策及工具呼叫審查。這些控制有助於降低未授權操作,卻不等於模型能判斷醫療主張真偽。權限、來源、模型輸出和發布責任,仍要分開治理。
四、GPT-6 Astra對決Claude:四個查證面向比較
應把模型版本、測試壓力、證據來源和後續責任分開比較。現有資料較能支持「Claude 3.5 Sonnet在特定研究條件下呈現較強重複抗性」與「Astra被官方定位為複雜文件工作模型」,還不足以判定誰全面勝出。
| 查證面向 | GPT-6 Astra | Claude 3.5 Sonnet | 判讀方式 |
|---|---|---|---|
| 事實維持 | 尚無同一項長篇假訊息研究的直接數據;官方強調文件理解 | 重複暴露錯誤肯定率約0.08% | 不把產品定位換算成研究分數 |
| 持續誘導 | 尚未在該研究的50次重複與辯論條件中測試 | 辯論測試約3.5% | 需用相同提示和版本重測 |
| 來源追溯 | 官方描述瀏覽、文件理解及部分來源對照表現 | 研究觀察到先拒絕錯誤前提,再提供修正說明;未完整測量來源追溯 | 人工開啟原文核對 |
| 覆核控制 | 有確認政策、網站與應用程式限制、工具審查等官方描述 | 少數錯誤未成功自我修正 | 系統控制和人工簽核都要保留 |
表格裡最重要的空白,是Astra沒有出現在那項研究裡。若要公平比較,至少要固定模型版本、語言、主張集合、重複輪數、瀏覽權限和人工評分規則。研究結果也顯示,單純重複和帶有論證的誘導可能產生不同排名。
五、醫療衛教與台灣內容查證,怎麼選模型?
選擇重點應放在可追溯流程與人工責任。需要讀長文件時,可以測試Astra的文件與瀏覽能力;重視持續對話抗性時,可參考Claude 3.5 Sonnet的研究資料,但兩者都要以實際版本和工作流程重新驗證。
模型適合協助抽出主張、區分事實與推測、找出段落矛盾、整理來源摘要和標記待補證據。醫療衛教則應限於一般性資訊與查證流程,不能把個人症狀、診斷、用藥、藥物交互作用或治療選擇交給模型單獨判斷。
- 拆主張:把文章改成一條主張一列,標示事實、推測、意見和建議。
- 找原始來源:開啟政府機關、學術期刊、專業組織或原始數據頁,核對標題、日期、版本和適用對象。
- 逐項對照:要求模型標出來源哪一段支持哪個主張,再由人工檢查是否誇大因果或省略限制。
- 測試持續誘導:用已知答案的主張進行多輪重複與反向提示,記錄改口、自相矛盾和不確定性標示。
- 保留發布閘門:醫療衛教與公共衛生內容發布前,由具備相應責任的人逐項覆核。
世界衛生組織的健康 AI 治理指引強調人類自主、安全、透明、責任、包容與永續;台灣事實查核中心的公開流程則要求題目可查證,並說明查核過程、資料來源與必要的專家資訊。兩者都指向同一個實務原則:模型可協助整理,發布者仍需能解釋證據與承擔更正責任。
在台灣使用模型還要核對翻譯後的醫療術語、制度、藥品名稱與政府機關名稱。含病歷、健檢報告或可識別資訊的資料,應依組織的資安與個資規範處理,必要時先去識別化。
六、結論:模型可以協助查證,但不能成為唯一裁判
目前證據支持分場景選擇與持續驗證,不能替GPT-6 Astra或Claude頒發全面可靠的稱號。先定義查證任務,再用相同材料測試模型,最後保留原始來源核對和人工發布責任。
GPT-6 Astra的可確認資訊,集中在官方描述的文件理解、瀏覽、電腦操作與企業控制;Claude 3.5 Sonnet的可確認證據,來自一項受控長對話研究。兩類資料回答不同問題,不能直接相加成勝負。
- 長篇假訊息的風險來自重複、誘導、假引用與上下文污染。
- Claude 3.5 Sonnet在特定重複暴露條件下表現較強,但研究沒有測GPT-6 Astra。
- Astra的官方文件理解與安全控制定位值得測試,卻不能替代獨立抗性評估。
- 醫療衛教與台灣內容查證應保留主張清單、原始來源、證據對照和人工覆核。
「在健康照護中,人類仍應掌握醫療系統與醫療決策。」— 世界衛生組織《人工智慧健康倫理與治理指引》,2021年
七、常見問題
研究能否代表新模型、網址是否已完成查證,以及醫療內容能否自動發布,都要回到模型版本、證據條件、風險層級與責任分工判斷。
常見問題
Q1:研究結果能直接證明Claude比GPT-6 Astra可靠嗎?
不能。研究沒有測GPT-6 Astra,且不同壓力條件的結果不同;資料適合用來設計測試,不適合直接作全面排名。
Q2:Astra的官方安全數據能代表內容查證正確率嗎?
不能直接代表。官方描述的安全評估涉及電腦操作與授權,內容查證還要檢查主張、來源、版本和不確定性。
Q3:模型提供網址後,還需要人工開啟來源嗎?
需要。網址可能失效、指向外殼頁,或只支持主張的一小部分;應核對標題、日期、原文段落和適用範圍。
Q4:醫療衛教可以讓模型直接產生並發布嗎?
不宜。模型可整理一般性資訊,診斷、治療、用藥、藥物交互作用和個人健康決策仍需相應的醫療專業判斷。
Q5:台灣讀者使用英文模型時,最容易漏掉什麼?Fact-Checking Process*. https://en.tfc-taiwan.org.tw/en_tfc_299/
參考來源
- OpenAI (2026). *GPT-6 Astra: The next generation in intelligence for work*. OpenAI
- Rodriguez J, et al. (2026). *Fallibility, Persuadability, and Correctability of Large Language Models Under Sustained Conversational Misinformation Pressure*. Research Square preprint
- World Health Organization (2021). *Ethics and governance of artificial intelligence for health: WHO guidance
- Taiwan FactCheck Center (n.d.). *Our Fact-Checking Process