
很多人第一個會想到,水印能不能證明一個蛋白質來自 AI。這裡要先問一個更前面的問題:標記是加在數位序列、預測結構,還是最後合成出的分子?Google DeepMind 在 2026 年 9 月發表 SynthID Bio 概念驗證,研究的是 AI 設計流程輸出的蛋白質序列與預測結構,並以實驗室測試確認特定設計的結合功能。它提供的是可偵測的來源線索,現階段不能單靠標記認定作者、設計意圖或生物安全性。
一、蛋白質水印要先看標記放在哪裡
SynthID Bio 有兩條路徑:序列水印在 ProteinMPNN 取樣胺基酸時加入訊號,結構水印則透過微調 AlphaFold 3 的模型權重,讓輸出的原子座標帶有訊號。兩者針對的資料不同,不能把其中一種檢測結果直接套到另一種。
蛋白質序列是胺基酸排列,結構則是原子在三維空間中的座標。序列方法接在設計管線中:先有蛋白質骨架,再由 ProteinMPNN 依骨架產生候選序列。SynthID Bio 借用 SynthID-Text 的 tournament sampling(競賽式取樣),用秘密金鑰和先前的胺基酸位置計算候選分數,讓取樣稍微偏向可辨識的訊號;之後還要用偵測分數篩選設計。檢測端必須掌握相應金鑰,重新計算序列分數。
這個訊號不等於在序列尾端加一段固定文字。水印分散在胺基酸選擇裡,能否偵測取決於取樣時可選胺基酸的多樣程度、序列長度與設計流程。論文指出,蛋白質設計常使用較低取樣溫度來減少候選變化,這會壓縮可用訊號;提高可偵測性或加上篩選,也可能讓更多候選在設計流程中被淘汰,增加計算成本。
結構水印處理的是另一種問題。研究團隊微調 AlphaFold 3(AF3)的擴散模組,讓模型在預測蛋白質三維結構時,把訊號寫進原子間距離等幾何特徵,並另外訓練偵測器。水印在模型推論時形成,不是預測完成後再貼上去。偵測器可用於判斷輸出的結構是否帶有該訊號;這不表示它能辨認所有來源模型,也不代表模型推估的結構就是實驗測得的真實結構。
| 比較面向 | 序列水印 | 結構水印 |
|---|---|---|
| 標記位置 | ProteinMPNN 產生序列時的胺基酸取樣 | AF3 微調模型輸出的三維原子座標 |
| 偵測依據 | 序列分數與秘密金鑰 | 結構幾何特徵與專用偵測器 |
| 主要限制 | 重跑序列設計可能稀釋或移除訊號 | 結構鬆弛可能破壞訊號 |
| 研究驗證 | 三種目標蛋白的設計結合蛋白體外測試 | AF3 評估資料上的結構準確度與偵測能力 |
二、體外測試支持特定結合功能,不代表所有設計
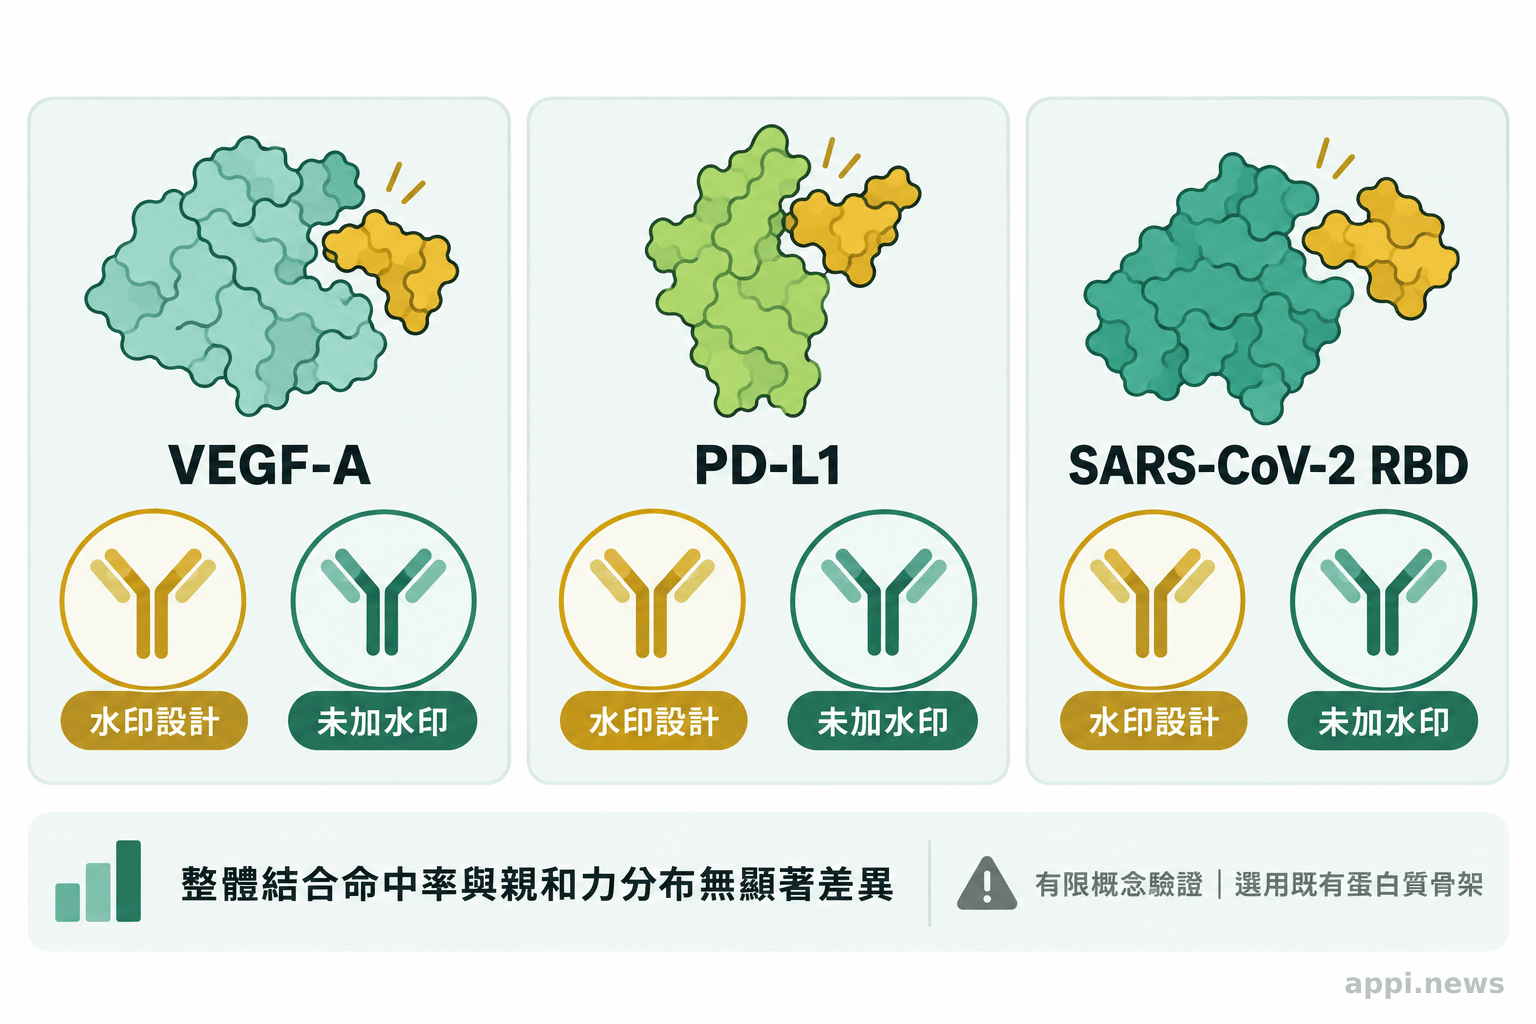
研究團隊在 VEGF-A、PD-L1 和 SARS-CoV-2 刺突蛋白受體結合域(RBD)三種目標上測試設計結合蛋白,並報告水印組與未加水印組的整體結合命中率及親和力分布沒有顯著差異。這是指定設計、目標與測試條件下的結果,不能推論成所有蛋白質都不受影響。
測試採用表面電漿共振量測結合親和力,研究者從 AlphaProteo 過去設計且已知結合能力的骨架出發,再以 ProteinMPNN 重新產生序列。論文說明,每個目標使用 15 個既有骨架;這讓團隊能比較不同骨架和序列條件,也提高取得可分析結合資料的機會。設計並非從零開始的廣泛蛋白質集合,因而不能代表所有蛋白種類、用途或設計模型。
不同水印參數也呈現取捨。論文將序列方法分成非失真與失真設定:前者在金鑰平均下維持取樣分布特性,後者會更明確地偏置胺基酸候選以提高訊號。作者在特定實驗設定中觀察到部分命中率差異,也指出偵測門檻會淘汰部分候選。換言之,研究同時在看水印可否辨認、設計能否通過篩選,以及實驗結合能力是否保留,不能只摘取「功能沒有影響」一句話。
「我們的實驗設計採用既有 AlphaProteo 設計的已知骨架,而非從頭進行完整設計,以提高每條序列成功結合的可能性。」— SynthID Bio 研究論文,研究方法說明
對結構方法,論文在 AF3 評估資料上檢查結構準確度和水印偵測表現,報告整體準確度影響有限,並測試旋轉、平移及加入雜訊等基本變動。這是模型評估,不是把所有輸出的結構拿去實驗室逐一解析,更沒有證明含水印結構在任何後續處理後仍可辨認。讀者要區分兩種證據:序列方法包含特定蛋白結合實驗,結構方法主要驗證模型預測和訊號辨識。
三、偵測到水印能支持來源判斷,不能替來源定案
陽性結果可支持某段序列或某份結構符合特定水印偵測器的訊號條件,成為追查相關設計流程的證據之一。它本身不能證明是哪個人設計、誰合成或如何使用,也不能判定蛋白質安全或有害;陰性結果同樣不能證明沒有使用 AI。
原因在於水印只回答有限的分類問題。這篇論文把序列與結構方法都定位為零位元水印,也就是偵測有沒有該訊號,不是把作者、時間、機構或版本等完整資訊編進標記。若研究者只看到陽性,就缺少把樣本連回具體機構或操作人的資料;若設計曾經過另一個模型改寫,標記可能消失,陰性也不能排除曾使用 AI。
研究直接測試了序列重設計風險:把水印序列再次交給未加水印的 ProteinMPNN 重新設計,可能使原訊號無法辨認。作者指出,這種重新設計也可能影響預估的結合命中率,但仍需要更多實驗量化攻擊後的影響。部分重設計、不同取樣順序和其他攻擊方式尚待研究。這提醒實驗室,樣本經過序列最佳化或改版後,水印陰性可能代表訊號未保留,未必能代表樣本起源。
結構水印則在模型權重中形成,研究因此檢查模型輸出經過雜訊、裁切或座標變換後的偵測情況。不過,作者也發現受限的結構鬆弛處理可以破壞水印。結構鬆弛是用計算方法調整原子位置、改善局部幾何的一類處理,常出現在結構分析流程。檔案格式轉換、後續模型處理或資料庫整理都可能改變輸入偵測器的資料,因此需記錄處理前後版本,不能把一次陰性掃描當作排除證據。
「將 SynthIDBio 實際用於來源追溯,仍需要更多創新,以及產業範圍的協調與標準化。」— SynthID Bio 研究論文,結論
安全性也必須分開判讀。水印是來源線索,不是毒性、致病性、環境風險或實驗安全的評估工具。陽性不等於有害,陰性也不等於無害。SARS-CoV-2 RBD 在這項研究中僅是蛋白質結合測試目標;本文不涉及病原體操作或製備指引。孕婦、兒童、慢性病患者與長期服藥者若看到相關內容,不應據水印判斷健康風險;本題不涉及營養補充品或藥物交互作用。
四、導入追溯流程還需要模型、實驗室與資料庫銜接
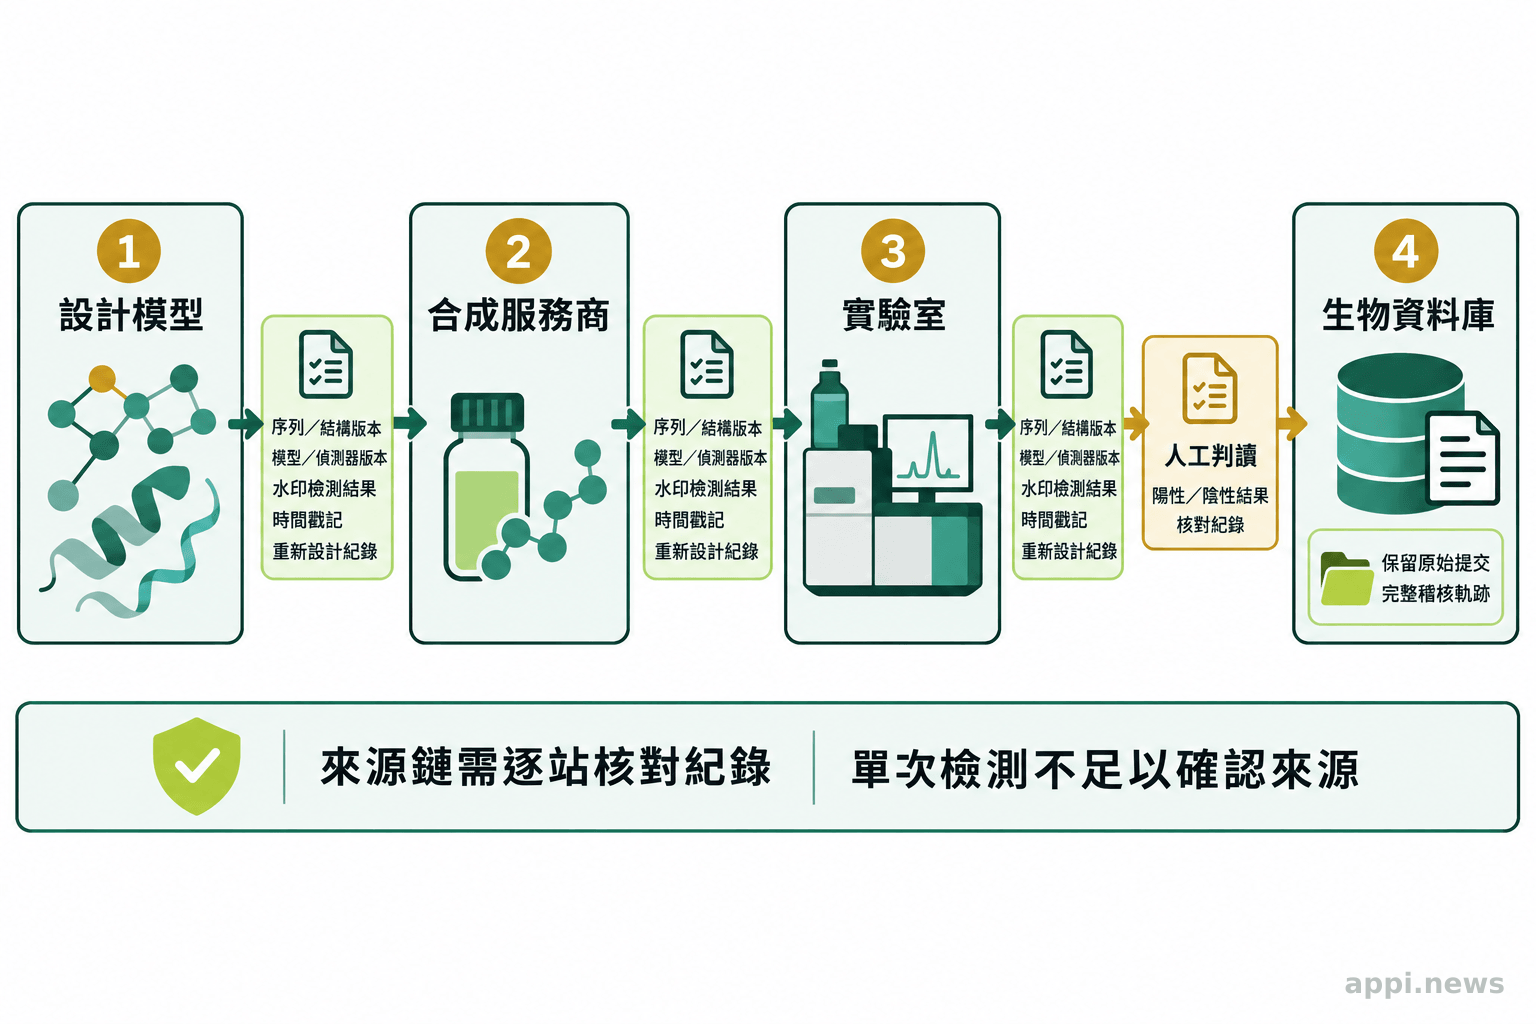
需要讓模型供應者、設計者、合成服務商、實驗室和資料庫共同保存可核對的流程紀錄,並約定誰能執行偵測、如何處理陽性與陰性,以及樣本改寫後怎麼更新來源資訊。單靠一個偵測器,無法建立完整來源鏈。
模型供應者需說明哪些模型版本會嵌入標記、偵測器由誰維護,以及金鑰如何保管和輪替。序列水印的偵測仰賴秘密金鑰;若金鑰外洩、失效或無法交接,過往資料可能難以持續驗證。結構方法的偵測器同樣需要維護,還要有對應的模型與資料格式版本。組織也要安排權限和稽核紀錄,避免來源判定依賴某個人的私人工具或單一供應者。
合成服務商與實驗室可在委託、樣本接收和結果回報時保存序列或結構版本、模型名稱與版本、偵測器版本、檢測時間、後續改寫紀錄及檢測結果。這些欄位要有一致定義;否則同一個「陽性」可能表示不同偵測器的門檻,跨機構也難以比對。涉及智慧財產或敏感研究時,還需界定哪些來源中繼資料可共享、誰能存取,以及如何避免不必要揭露。
資料庫則要決定水印結果如何附在紀錄旁、能否保留原始提交版本,以及更正或重新分析時如何留下稽核軌跡。水印與中繼資料各有用途:水印有機會在標記仍保留時提供隱性的偵測線索,中繼資料可記錄模型版本、處理者與日期等豐富資訊,但若沒有簽章,資料可能被移除或偽造。兩者搭配流程紀錄、存取控制和人工覆核,才能讓研究者追查線索,而非把單一標記當成完整履歷。
對台灣的研究機構與生技業者而言,評估時可先盤點現有的蛋白質設計、委外合成、樣本入庫和資料分享流程,再找出來源資訊在哪個交接點容易遺失。若不同實驗室使用不同模型、版本和檔案格式,導入前就要安排共同欄位與回報方式,並確認負責人離職或供應者停止服務時,歷史資料仍可查核。這些工作不會由水印自動完成,卻決定偵測結果能否被後續使用者理解。
五、評估生物設計水印時先檢查五個條件
先確認標記對應的資料種類、驗證證據、偵測門檻、失效情境與後續紀錄責任,再判斷它是否適合放進設計或合成流程。研究目前屬概念驗證,合成篩查、跨機構辨識與資料庫治理仍須實際流程驗證。
評估導入時,可逐項確認:
- 標記對象:偵測的是蛋白質序列、模型預測結構,還是其他資料?樣本經改寫後是否仍適用?
- 證據範圍:功能測試涵蓋哪些目標與條件?模型準確度測試是否被誤當成實驗功能驗證?
- 偵測條件:需要哪一版偵測器、金鑰或檔案格式?偽陽性門檻如何設定,誰負責更新?
- 失效處理:序列重設計、結構鬆弛或資料轉檔後若呈陰性,是否回查原始版本和中繼資料?
- 責任與治理:模型商、實驗室、合成服務商及資料庫各保存什麼紀錄?誰能覆核結果並更正判定?
AI 生物設計水印值得關注的地方,是它試著把來源訊號放進生成流程,並以序列實驗和結構評估檢查功能與可辨識性。實務判斷仍要把「有沒有水印」「來源紀錄是否完整」「樣本是否安全」拆成不同問題。評估工具時,先查水印對應的輸出、偵測器成立條件,以及訊號失效時如何用中繼資料、流程紀錄和人工審查補足,才知道它能在哪個環節提供幫助。
- SynthID Bio 分別為設計序列與預測結構加入可偵測訊號,兩種方法的標記位置和驗證證據不同。
- 三種目標蛋白的體外測試支持特定結合蛋白在研究條件下保留功能,不能推廣到所有蛋白質或用途。
- 水印陽性是來源線索,不是作者、完整來源鏈或生物安全證明;序列重設計和結構鬆弛都可能讓訊號失效。
- 真正導入需要偵測器治理、版本紀錄、中繼資料、跨機構協調與人工覆核。
常見問題
Q1:SynthID Bio 是直接在合成後的蛋白質上加標記嗎?
研究方法是在數位設計序列的取樣過程,或預測結構的模型輸出中嵌入訊號,再測試設計結合蛋白的體外功能。它不是在蛋白質合成完成後貼上可見標籤。
Q2:偵測到水印,就能確認蛋白質由 Google DeepMind 設計嗎?
不能直接如此判定。陽性表示樣本符合特定水印偵測器的訊號條件,還需要模型版本、金鑰管理和流程紀錄協助解讀;水印本身不記錄完整作者或機構身分。
Q3:沒有偵測到水印,代表蛋白質不是 AI 設計嗎?
不代表。重新設計序列、調整結構、改變檔案或使用其他模型,都可能讓訊號無法辨認。陰性結果不能單獨排除 AI 參與。
Q4:蛋白質水印可以判斷生物安全性嗎?
不可以。水印只提供來源訊號,不評估毒性、致病性或環境風險。生物安全需要依樣本、用途和適用規範另行評估。


