
《The Decoder》10 月 31 日報導轉述 Anthropic 的 API 客戶通知:Mythos 5、Opus 4.7、Opus 4.6 與 Sonnet 4.6 預定 11 月 3 日加入文字浮水印。報導稱,兩款 4.6 型號只有在 temperature、top_p、top_k 使用預設值時才支援標記,調整參數會停用標記。實際狀態仍須由帳戶通知確認。
Anthropic 官方模型表目前未替這四款標示文字浮水印支援,並說明舊模型標記正分階段加入,偵測 API 則仍為有限預覽。這個公開表格與報導所述客戶通知可能尚未同步,應分別記錄公開文件版本和帳戶實際通知。OpenAI 的文字浮水印適用範圍也可供比較,但不能套用其啟用條件。
一、四款模型的部署消息,哪些已由官方公開確認?
《The Decoder》報導轉述 API 客戶通知,四款型號預定 11 月 3 日加入;兩款 4.6 型號僅在 temperature、top_p、top_k 使用預設值時支援。官方模型表當時未勾選,兩種資訊可能尚未同步,實際狀態應向帳戶確認。
Anthropic 的原理說明介紹選詞標記;官方模型表逐款列支援狀態,四款被報導的型號文字欄當時均未勾選。這反映公開表格的狀態,不代表個別 API 帳戶尚未收到通知或完成部署。
表格也分列文字浮水印與檔案 C2PA 憑證。部分型號即使有檔案憑證勾選,也不能據此推論生成文字帶有水印;兩種標記不能互相替代。
企業應保存報導、官方文件版本及帳戶通知,並記錄模型 ID、供應平台與參數。
二、temperature、top_p、top_k 為何會成為覆蓋條件?
這些參數會改變模型挑選下一個詞元的候選範圍或隨機程度。報導稱兩款 4.6 型號調整參數會停用標記,Anthropic 尚未公開逐組驗證結果。
temperature(溫度)調整選詞分布;top_p(累積機率取樣)按累積機率保留候選範圍;top_k(前 K 項取樣)限制候選詞元數量。詞元可能是字、字的一部分或標點,效果依模型而異。
Anthropic 將浮水印描述為選詞序列中的統計模式,由偵測金鑰檢查。取樣設定可能改變生成分布;「調整即停用」目前仍是媒體報導所述條件。
另一個具體案例來自 Google DeepMind:研究團隊在 Gemini 服務觀察近 2,000 萬則回應,並比較有無 SynthID-Text 水印的文字品質,未發現統計顯著差異;另以 3,000 個 ELI5 問題進行人類評比。這些結果只適用於該研究的 SynthID-Text 與 Gemini 情境,不能當作 Claude 測試結果。更多Google SynthID 的辨識範圍可作不同系統的比較。
「這只能回答文字有多大可能曾由 Claude 部分撰寫。」這是 Anthropic 對自家水印判讀範圍的說明,描述的是機率訊號,不是作者身分證明。
報導所述通知談的是 Anthropic API 客戶,不能直接推廣到 Bedrock、Google Cloud 或 Microsoft Foundry。官方文件雖提及部分合作平台,但各平台支援的標記類型與功能不同;團隊須向各供應商分別確認,再記錄模型 ID、參數和部署日期。
三、偵測結果能說明什麼,哪些文字較難留下訊號?
偵測到標記表示 Claude 可能參與生成或處理文字,不能確認作者、編輯比例、使用者身分或其他模型的參與。陰性結果也不能證明文字未經 AI 處理。
模型端水印以選詞統計模式和 Anthropic 持有的金鑰檢查;一般 AI 偵測器則從文字特徵推估來源。兩者依據不同,分數不能當成作者紀錄或生成比例。
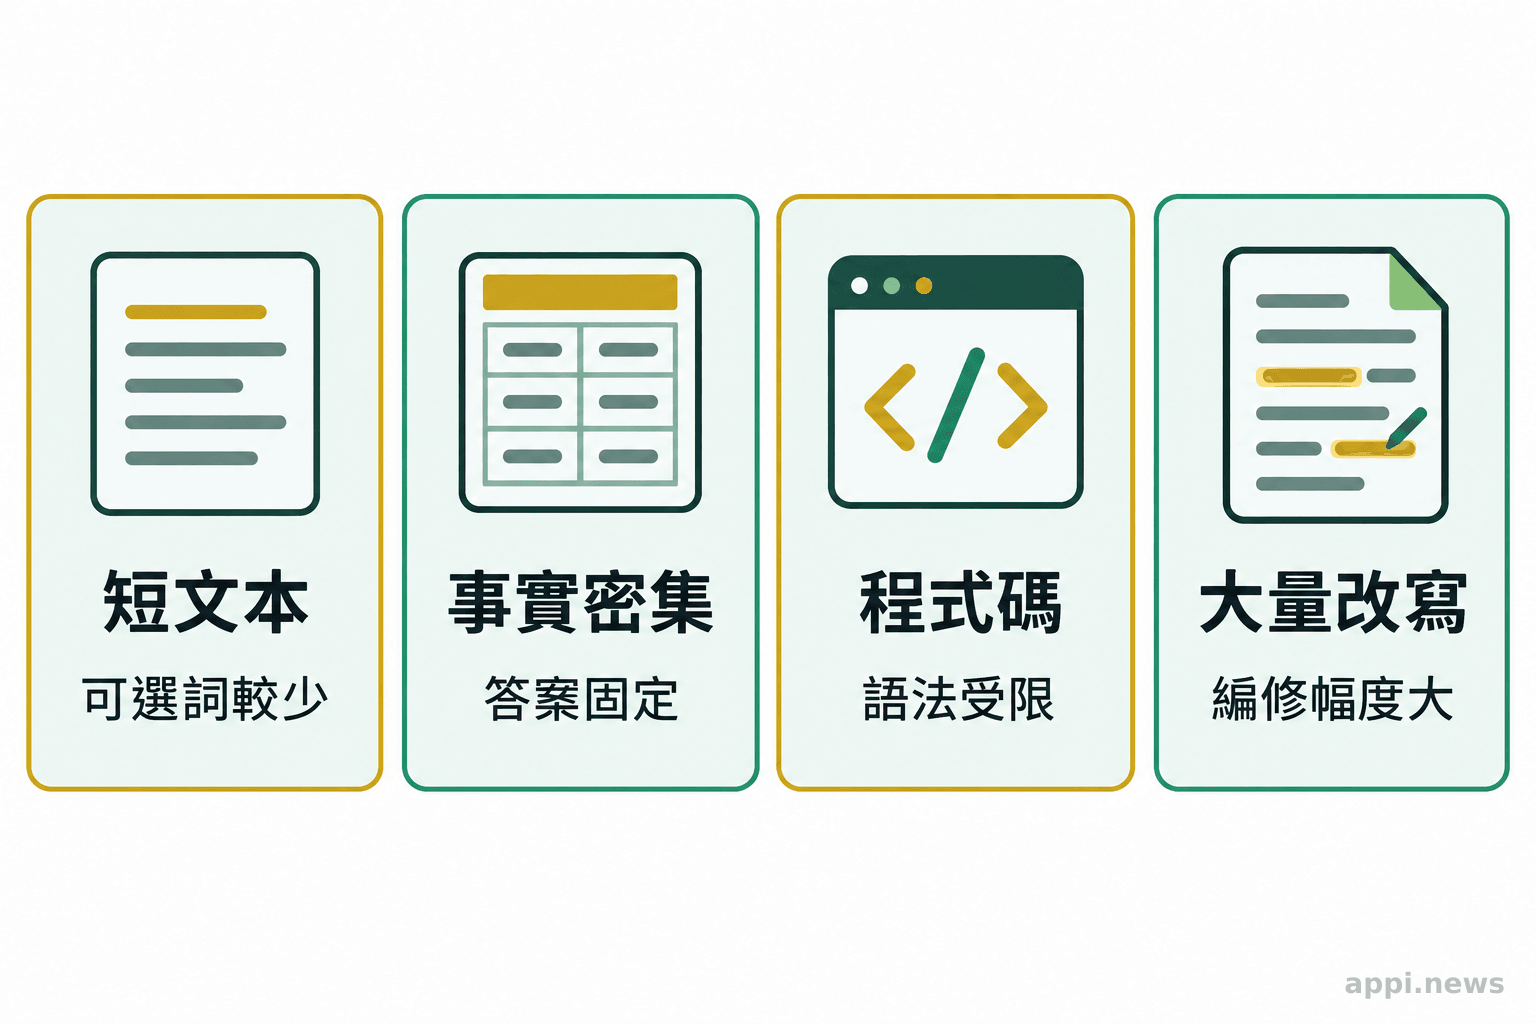
短文本可供統計檢查的選詞有限。Anthropic 指出,事實性內容常只有固定答案,例如 Isaac Newton 的著作名稱;只校正文法與標點時,模型可選的字詞也少。
程式碼受語法和結果限制,可供選詞空間小,註解則可能留下標記。完整改寫或大量編輯也可能削弱訊號,單次陰性結果不能替整份文件背書。
Google DeepMind 的 SynthID-Text 論文指出水印應與其他方法互補,改寫可能削弱訊號;研究不能代表 Claude 的失敗率或辨識門檻。
Google DeepMind 研究團隊指出,生成式文字水印應與其他方法互補。該研究評估 SynthID-Text,不能代替 Claude 的實測。
四、採用團隊如何建立可重現的查核紀錄?
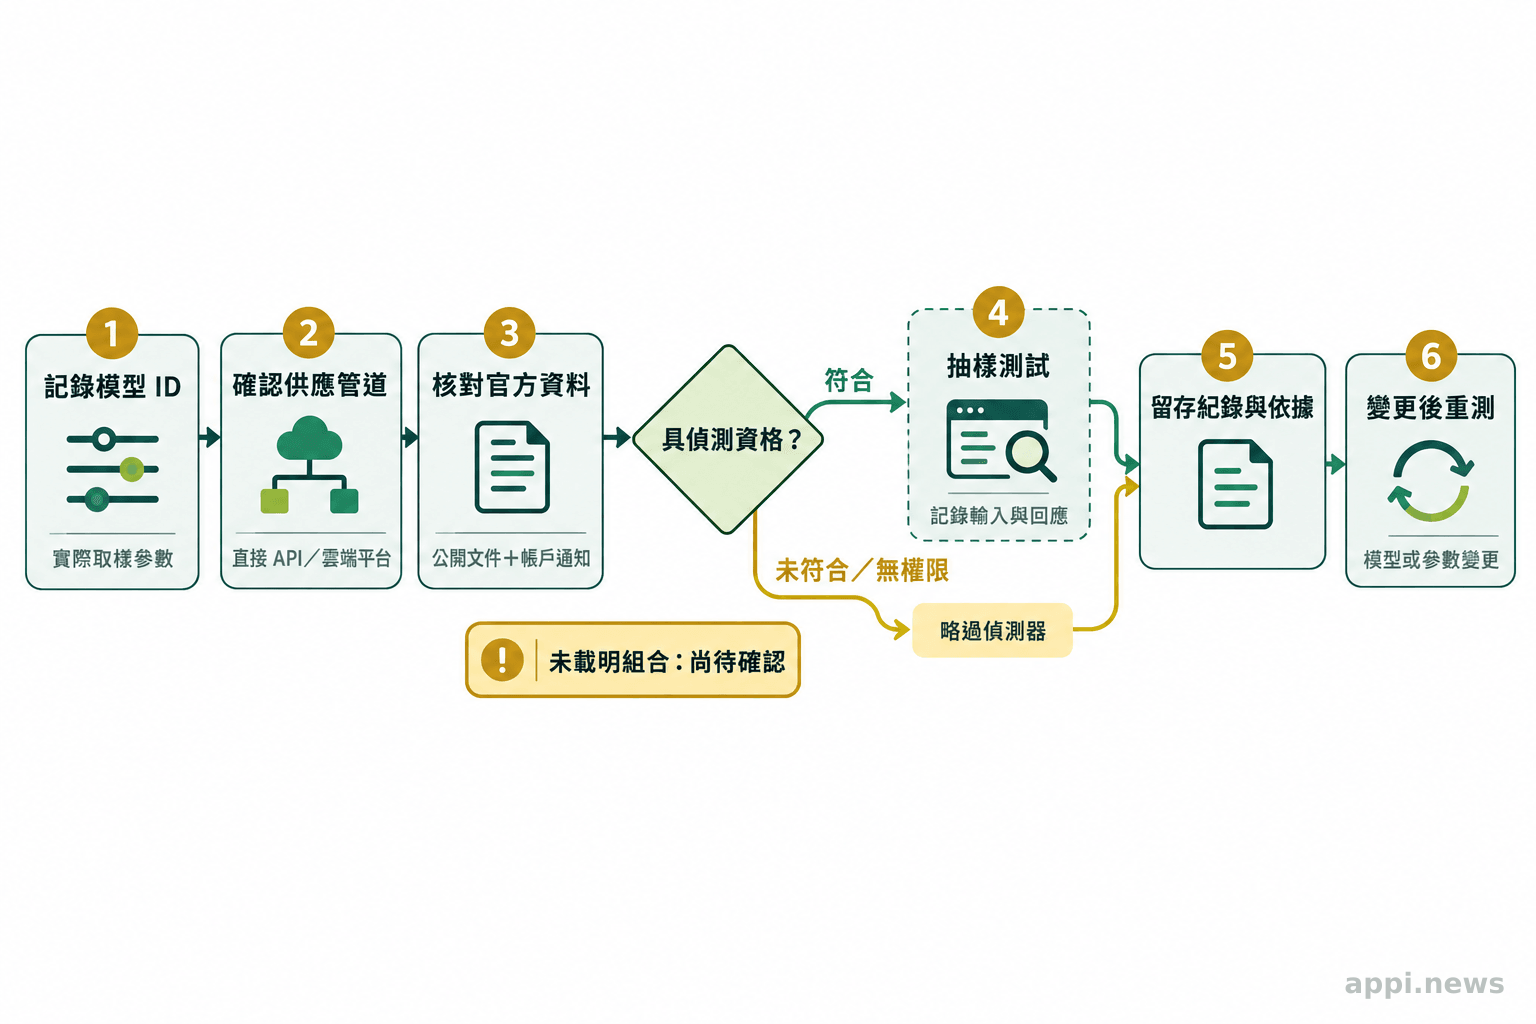
抽查模型 ID、取樣參數與供應管道,對照官方文件及帳戶通知,並記錄偵測 API 資格與回應。未確認的組合標為待核實,變更後重測。
- 盤點設定:從 request log 記錄模型 ID 及實際送出的
temperature、top_p、top_k。 - 核對平台:記下直連 API 或雲端平台、區域與功能,分別確認文字浮水印和 C2PA 支援狀態。
- 留存依據:保存官方文件版本、日期、帳戶通知、模型版本與參數;文件未說明的組合標為「官方資料未確認」。
- 測試樣本:如有偵測 API 權限,測試長文、短文、事實密集內容、校對文字及程式碼,並記錄輸入與回應。樣本結果不代表所有內容。
- 補足來源紀錄:保存請求、來源、人工修改及審核紀錄;模型或參數變更後重測。
文字偵測 API 仍為有限預覽,團隊應先確認資格。無權使用時,可向供應商索取驗證或稽核資料,並以本地紀錄維持追溯性;無法檢測不等於沒有水印。
部署支援不代表每次輸出都可檢出。短文、固定答案、校對與改寫會影響訊號;偵測 API 也無法補回未記錄的模型 ID 或參數。合規流程須同時管理模型狀態、工具資格與紀錄保存。
- 兩款 Claude 4.6 模型的預設取樣條件目前見於媒體報導,部署狀態應以帳戶通知和 Anthropic 官方資訊交叉核對。
- 浮水印只能提供模型可能參與處理的線索,不能單獨證明作者或生成比例;短文本、校對與精確內容更容易缺乏可辨識訊號。
- 留存模型 ID、參數、供應管道、文件版本和人工編輯歷程,模型或設定改變時重測。
五、Claude 文字浮水印常見問題
不能。標記只表示 Claude 可能曾生成或處理文字;作者與編輯過程須查來源及版本紀錄。
常見問題
Q1:Claude 浮水印會顯示在文字或文件上嗎?
文字標記嵌入選詞統計模式,不會以可見字元呈現;支援的檔案則可能附 C2PA 憑證。
Q2:Opus 4.6 或 Sonnet 4.6 調整參數後一定沒有水印嗎?
參數條件來自《The Decoder》轉述的客戶通知,官方尚未公開各組合測試結果。請向帳戶或供應商確認。
Q3:偵測器沒有找到標記,可以判定文字不是 Claude 產生嗎?
不可以。模型或平台支援、文本長度、編修程度及工具適用性都會影響結果;陰性只表示該次檢測未辨識到標記。
Q4:一般企業現在都能使用 Anthropic 偵測 API 嗎?
偵測 API 仍為有限預覽,資格與功能應以官方頁面或帳戶回覆確認。
參考來源
- Anthropic (2026). *How Claude’s text watermark works
- Anthropic (2026). *How Claude marks AI-generated content
- Dathathri S, et al. (2024). Scalable watermarking for identifying large language model outputs. *Nature*, 634, 818–823
- Bastian M. (2026). Anthropic's watermark rollout leaves a loophole on two older Claude models. *The Decoder


