很多人第一個會先想到:有了文字浮水印,就能判定一段文字是不是 AI 寫的嗎?答案要先從適用範圍看起。OpenAI 在 2026 年 10 月 5 日表示,未來數週將分階段為歐盟符合資格的 ChatGPT 與 Codex 文字輸出加入不可見水印;全球 API 客戶則可為部分模型選擇啟用,預設關閉。兩種安排並非全球所有產品一律加標記。對企業來說,先確認輸出經過哪條產品與編輯流程,比看到「水印」兩字就更改審查制度重要。
一、OpenAI 文字浮水印先看適用範圍:歐盟產品與全球 API 分開
OpenAI 公布的是三條不同路徑:歐盟 ChatGPT 與 Codex 分階段加入、全球 API 對部分模型開放選用,以及雲端合作服務後續安排。
「歐盟版」指 OpenAI 所稱在歐盟提供的符合資格 ChatGPT、Codex 使用者,不代表全球帳號不論所在地都會收到標記。官方在公告時說將於未來數週推出,屬於分階段計畫;實際帳號、方案與輸出是否已涵蓋,仍須以服務端當時的說明為準。這個時間狀態會變動,導入文件應記錄查核日期,避免把公告計畫寫成所有使用者已全面啟用。
API 是另一條路。OpenAI 表示全球客戶可為「部分模型」選擇啟用文字水印,預設為關閉。官方客戶指引補充,管理者可在特定專案或組織設定啟用;但公告沒有表示每個模型、每個端點或每種輸出格式都支援。串接方需要查看目前帳戶控制台和模型文件,將已確認支援的模型與設定記錄下來,不能只憑「全球可選」便假設自己的請求已加標記。
雲端合作服務又是第三種情況。OpenAI 說正與雲端夥伴合作,目標是在未來數週讓透過其服務取得的 OpenAI 模型輸出也能使用水印。這表示客戶若是經由雲端平台呼叫模型,不能直接套用 OpenAI API 的設定流程;要另外確認合作服務何時支援、設定由哪一方控制,以及輸出在服務內是否保留訊號。
| 使用路徑 | 公告中的安排 | 整合者應確認 |
|---|---|---|
| 歐盟 ChatGPT/Codex | 符合資格的文字輸出分階段加入不可見水印 | 使用者地區、方案及功能是否已上線 |
| OpenAI API | 全球客戶可為部分模型選用,預設關閉 | 模型支援清單、專案或組織設定、實際輸出 |
| 雲端合作服務 | OpenAI 正與夥伴安排後續支援 | 夥伴的發布時程、控制台設定及訊號保留 |
這項公告回應 EU AI Act 的生成內容來源規則,產品功能推出和法律義務應分開看待。歐盟 AI 法第 50 條第 2 款要求相關系統提供者,使合成文字等輸出以機器可讀方式標記並可被辨識,同時要求技術方案在技術可行範圍內有效、互通、穩健且可靠;條文也列有標準編輯輔助等例外。
第 4 款另對部署者發布涉及公共利益資訊的 AI 生成或操弄文字設有揭露要求,若經人工審查或編輯控制且有人承擔出版編輯責任,則有例外。兩款規範對象和情境不同,OpenAI 的產品水印本身不足以證明使用組織已完成所有合規工作。
「我們不會在推出時將文字浮水印設為全球預設。」(中譯)來源:OpenAI,〈Our approach to EU text provenance rules〉
二、不可見水印如何運作?textGrain 偵測的是什麼訊號
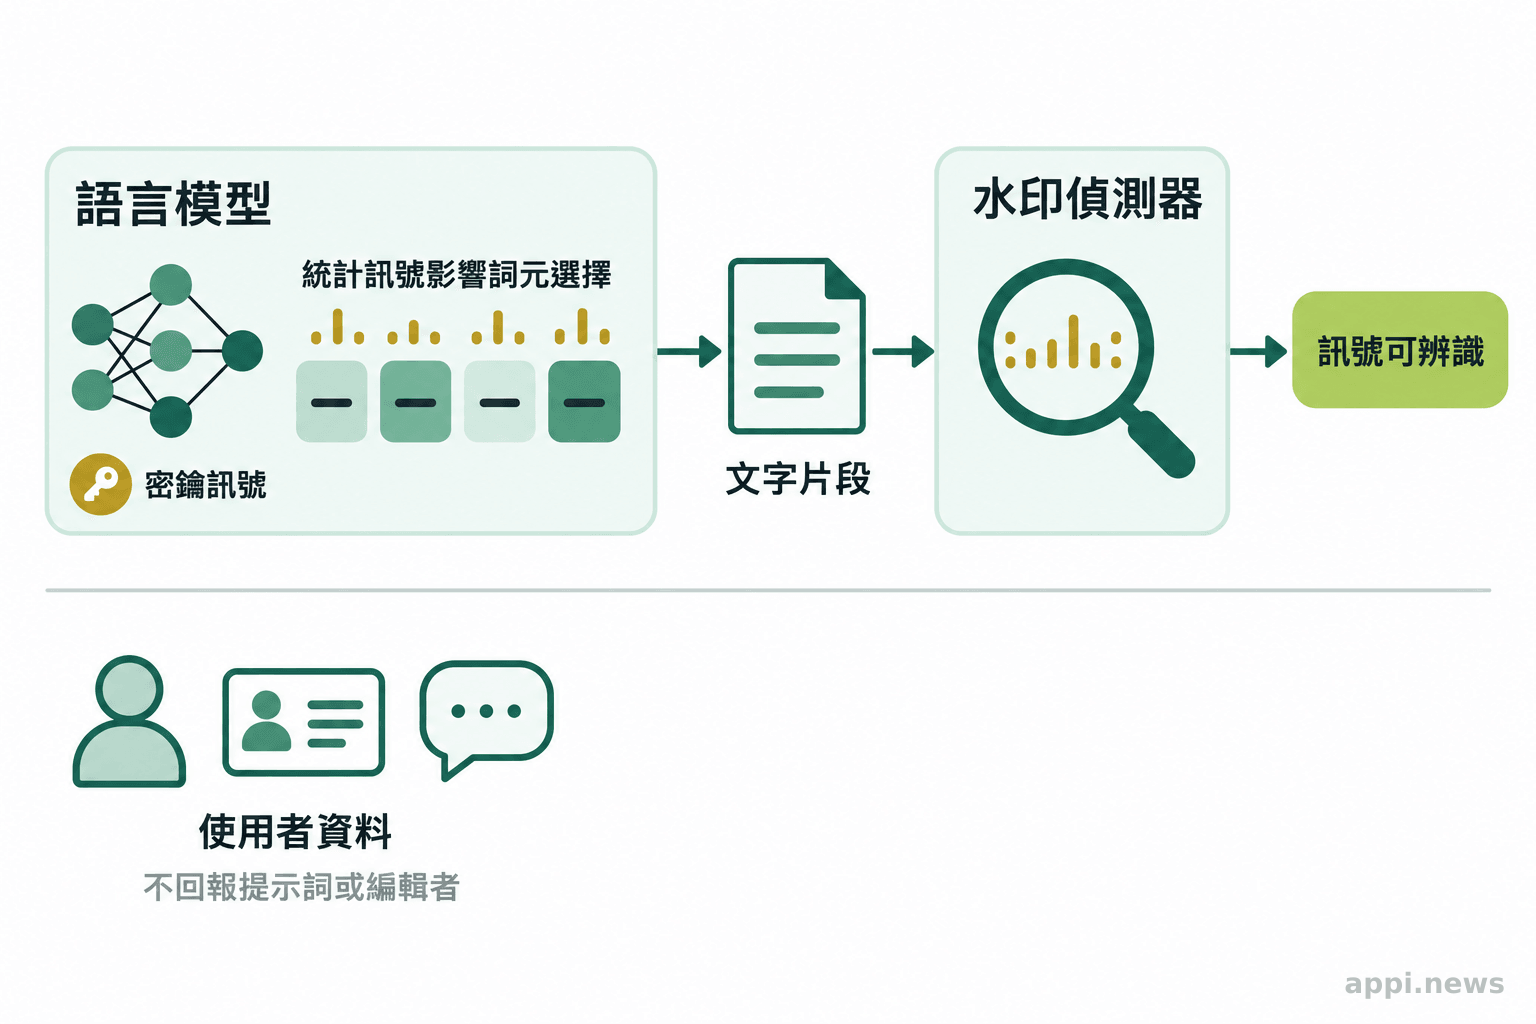
textGrain 會在模型逐步選擇詞或詞片段時加入統計訊號,再由偵測器檢查一段文字是否含有 OpenAI 水印。
這項技術不會在畫面上顯示「AI 生成」標籤,也不會在檔案旁附上作者欄位或一般文字中繼資料。OpenAI 的技術報告說明,模型每次生成下一個詞元時,會根據前文和密鑰相關的偽隨機訊號調整抽樣方式;整段文字的詞彙選擇因此帶有可供偵測器統計檢查的關聯。詞元是模型處理的單位,可能是一個字、詞的一部分或標點。讀者看不到特殊字元,但偵測端會檢查整段文字中的模式。
理解偵測器的判讀範圍尤其重要。它回答的是「這段文字是否帶有可辨識的 OpenAI 水印訊號」,不直接回答「誰寫了它」或「作者用了多少 AI」。人可能先生成草稿再大幅重寫,也可能只用模型改一小段;偵測結果無法量化人類判斷、編輯和創作各自的比例。它也不會連結到使用者、帳號、提示詞或對話紀錄。
因此,偵測到水印可以作為來源線索,不能作為作者身分證明、著作權判斷、內容真偽檢查或責任歸屬的結論。OpenAI 也說明偵測器初期只開放給核准的研究者與專業組織申請,逐案審核;它不會在推出時提供公開的文字檢測工具。組織不能預設任何讀者都可以自行拿文章跑一次偵測,也不能把供應商尚未提供的工具當成現有審核環節。
OpenAI 公布的效能數據需連同條件一起讀。其公告以目標誤報率 1% 為條件,稱在心理學題材中,偵測器可在約 80% 的 200 token 段落與約 95% 的 400 token 段落辨識水印;數學等詞語選擇較受限制的內容,偵測率明顯較低。這是 OpenAI 自行評估的特定資料與設定,不能外推為繁體中文、所有專業題材或實際平台轉貼後的普遍準確率。
水印也會與生成品質取捨相關。OpenAI 表示,依其使用的多項基準測試,加入標記前後沒有觀察到有意義的效能差異;這仍是廠商在其基準與最新模型上的結果,不等於每種語言、提示方式、長文任務都已由外部獨立測試。產品團隊若把文字水印納入服務規格,宜將品質與偵測效果分開評估:前者看任務輸出,後者看訊號能否在預定流程中保留。
三、改寫、翻譯與短文字會讓偵測結果改變
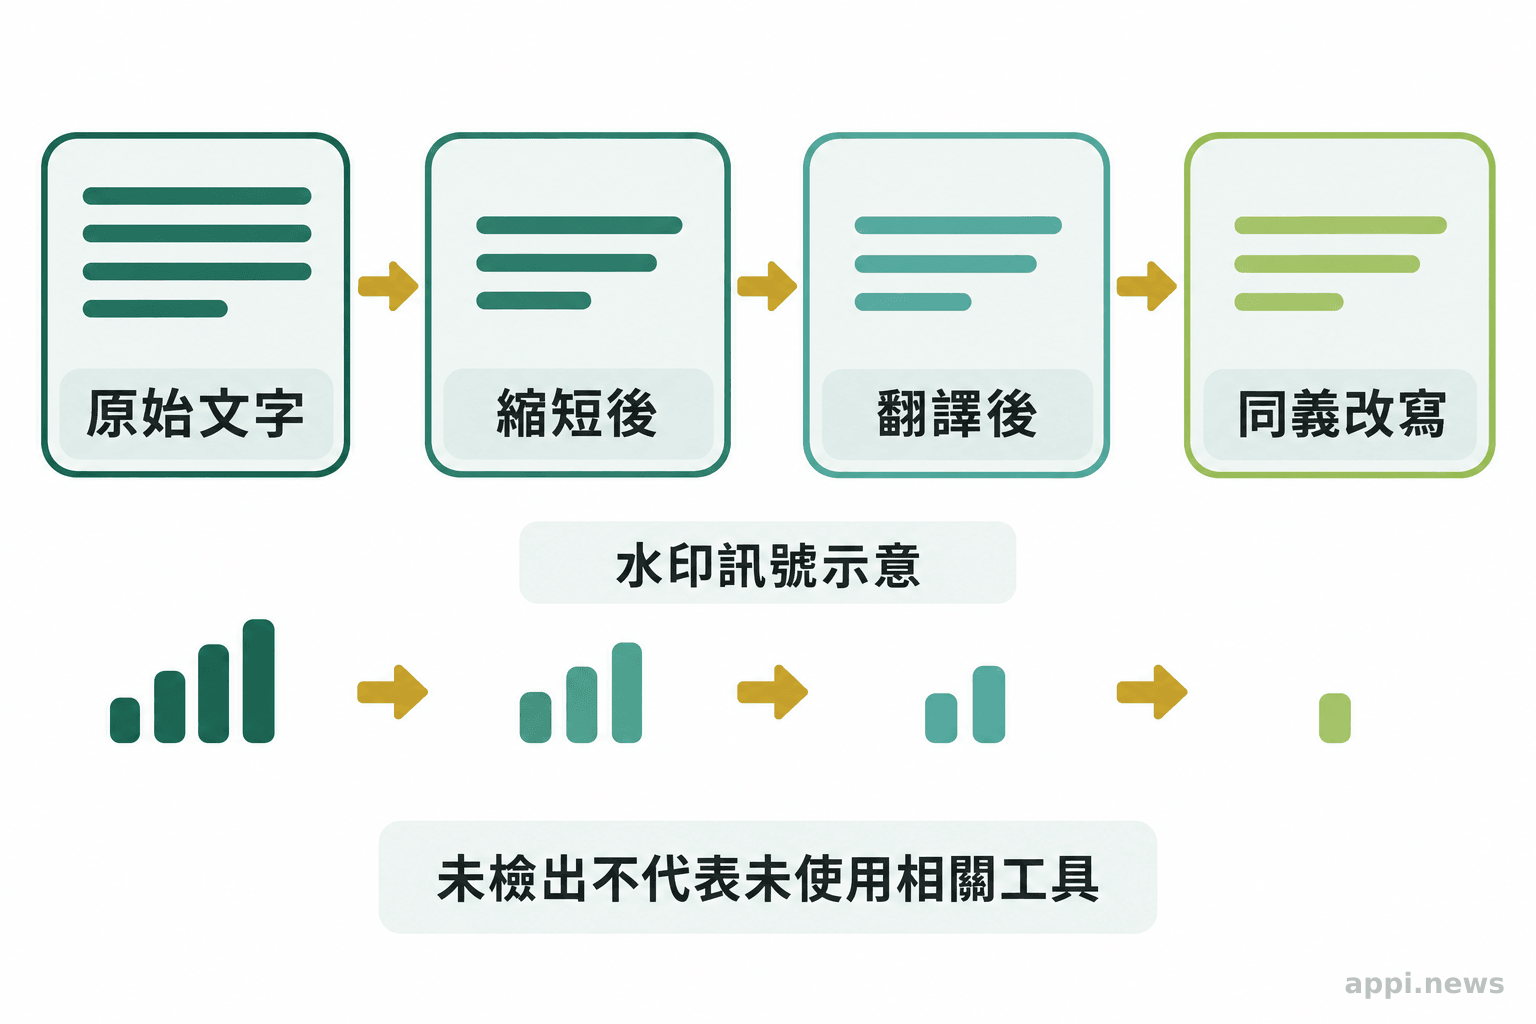
短文、受限制的題材和較大幅度的改寫都可能降低偵測能力,未檢出不能反推文字由人撰寫。
文字和影像、音訊不同,通常會被複製、潤飾、摘要或翻譯;每一次改動都可能改變原先累積的詞彙統計訊號。OpenAI 的測試顯示,在 400 token 英文段落中,以同義詞替換 10% 的詞後,偵測率由約 92% 降至 66%;替換 25% 後降至 17%。這些數字來自特定英文測試段落的替換實驗,不能視為每種編輯方式都會產生相同結果,但足以提醒整合團隊:文字一旦經過改寫,偵測結果可能不同於初稿。
翻譯也會重組用字和語序,摘要則會縮短可供統計的文字量,因此都可能影響判讀。OpenAI 將翻譯列為水印可靠性需面對的限制,並表示會持續研究訊號在編輯與翻譯下的表現。若系統會自動翻譯、改寫成品牌語氣、轉成條列摘要,或只保留生成內容中的一句話,便應在流程圖上標出這些節點。對照原始輸出與發布版本,有助團隊理解訊號在哪裡改變,但不能用來推定特定人的使用情形。
偵測器會有兩種錯誤。偽陽性是文字沒有水印卻被判為有;偽陰性則是文字帶有水印卻未被辨識。當結果要用來審稿、標記內容或調查爭議,兩種錯誤都會帶來成本。尤其未檢出可能源於內容太短、題材限制、編輯或翻譯、使用未支援的模型,或生成時間早於功能上線。它不能成為「一定由真人寫」的證據;檢出也不能成為「整篇由 AI 自動完成」的證據。
「沒有偵測到水印,不代表文字是人類撰寫。」(中譯)來源:OpenAI,〈Our approach to EU text provenance rules〉
這也說明為何偵測器推出時不開放一般大眾使用。當技術仍有漏報與誤報,而且只有專業使用者可申請時,產品設計就不該先承諾「使用者貼上文字,即可確認 AI 身分」。較實際的做法是把偵測當作一個有限的訊號來源,並與模型呼叫紀錄、人工編輯流程、使用者揭露和出版責任資料並列。若訊號和其他紀錄不一致,應進入人工查核,而非由單一結果自動判定作者或處分內容。
四、台灣團隊如何檢查 API 與跨區內容工作流?
先盤點使用者地區、模型與服務路徑,再確認水印設定、文字編輯節點和結果如何被使用。
歐盟規則的義務須依提供者、部署者、服務情境和條文例外判斷;不能只看公司註冊在台灣或 API 從哪個區域呼叫,就推定一定適用或一定不適用。若台灣服務面向歐盟使用者、透過歐盟產品提供功能,或在當地部署 AI 系統,應讓法務或合規人員按實際角色與服務方式檢視規範。此處談的是技術流程盤點,不能取代個案法律判斷。
開始調整服務前,可沿著「生成—加工—發布—查核」畫一張最小流程圖。標出 ChatGPT、Codex、OpenAI API 或雲端合作服務各自負責哪一步,並記下輸出是否經過翻譯、摘要、同義改寫、模板拼接或人工覆核。若流程中有多個模型供應商,還要記錄哪些段落來自哪個模型;OpenAI 的水印只針對它自己的可辨識訊號,不會替其他供應商建立來源紀錄。
API 整合者應直接在管理介面確認專案或組織的啟用狀態,核對實際呼叫的模型是否列入支援範圍。記錄至少包括查核日期、模型名稱、專案設定、請求路徑、原始輸出保存方式和下游加工步驟。這些紀錄屬於團隊作業軌跡,不能單獨證明文章所有編輯過程;當輸出後續被修改或發生爭議時,仍能協助團隊重建處理流程。若雲端夥伴尚未提供明確的設定或支援資訊,應先向服務商確認,不要把直連 API 的功能描述套用到代管服務。
內容團隊也要先定義偵測結果將用來做什麼。若目的是研究模型輸出在改寫後的訊號保留程度,應保留原始與編輯版本並設定抽樣規則;若目的是對外揭露,需確認適用規範要求的是機器可讀標記、讀者可見揭露,或兩者皆有。若是用來處理作者爭議或工作評鑑,單一水印沒有提供足夠證據支持這種判斷,制度應改採能說明來源、審稿和責任的紀錄程序。
- 盤點地區與角色:列出服務對象所在地、產品提供方式,以及團隊在相關流程中是模型提供者、部署者或內容出版者。
- 核對產品設定:分開檢查歐盟 ChatGPT/Codex、OpenAI API 和雲端合作服務;在 API 端確認特定模型支援與專案/組織開關狀態。
- 標出文字變形點:記錄摘要、翻譯、改寫、人工編輯等步驟,並保留足以重建輸出來源的作業紀錄。
- 限制偵測結果用途:把水印視為來源線索,不單獨用來宣告作者、判定真偽、認定違法或自動懲處。
- 安排覆核與更新:由內容、工程與合規負責人共同確認錯誤處理方式,產品設定或官方支援範圍變更時更新流程文件。
- 歐盟 ChatGPT/Codex 的分階段安排,與全球 API 對部分模型的選用設定不同;API 預設關閉,雲端合作服務還有各自的支援時程。
- textGrain 偵測的是文字中可能存在的 OpenAI 水印訊號,不能確認使用者、作者比例、內容真偽、責任或合法性。
- 短文、題材限制和改寫可能造成漏檢;有無水印都不應單獨成為作者歸屬或治理決策。
常見問題:沒偵測到水印代表文字由人撰寫嗎?
不代表。偵測不到可能是文字太短、經過編輯或翻譯、模型不支援,或生成時間早於水印功能上線。
常見問題
Q1:EU AI Act 要求所有網站文章都標示 AI 生成嗎?
第 50 條分開規範提供者的機器可讀標記義務與部署者的揭露義務,後者針對以告知公眾公共利益事項為目的發布的 AI 生成或操弄文字,並列有人工審查或編輯控制等例外。適用與否要看角色、情境和條文條件,不能簡化成所有網站文章一律標示。
Q2:OpenAI API 的水印現在是預設開啟嗎?
不是。OpenAI 表示 API 的文字水印預設關閉,全球客戶可對部分模型選擇啟用。實際支援模型與控制台設定仍需依帳戶當下文件核對。
Q3:水印偵測器可以查出是誰輸入提示詞嗎?
不可以。OpenAI 表示偵測器回報的是文字是否含有 OpenAI 水印,不會辨識使用者,也不會揭露提示詞或對話內容。
Q4:文章沒有水印,是不是能證明沒有用過 AI?
不能。未檢出不排除曾經使用 OpenAI 工具,也無法排除使用其他公司的模型。水印只是特定來源技術提供的一種訊號。
參考來源
- OpenAI (2026). *Our approach to EU text provenance rules
- Li X, et al. (2026). *textGrain: Entropy-Calibrated Watermarking for Language Model Text*. OpenAI Technical Report
- European Union (2024; consolidated text as of 2026-07-27). *Regulation (EU) 2024/1689, Article 50: Transparency obligations for providers and deployers of certain AI systems*. AI Act Service Desk
- European Commission (2026). *Guidelines on transparency obligations for providers and deployers of certain AI systems