
一個解壓縮程式的計數器在罕見輸入下發生下溢,導致越界寫入;Anthropic 表示,Claude 在嘗試證明程式性質時找到了這個問題。該輸入約 20 MB,還帶有特定排列,傳統模糊測試較難碰到。這個案例呈現形式化驗證的另一項用途:推導證明的過程可能暴露反例,供團隊修補程式。
Anthropic 與 Theorem 的實驗涵蓋 OSS-Fuzz 的 123 個開源函式庫、239 個測試入口,產生約 1.8 億行 Rocq 證明程式碼。入口數、函式庫數和證明行數是不同單位。審查者仍要確認證明的程式、輸入和執行環境是否符合實際部署。
Claude 為 239 個入口證明了什麼?
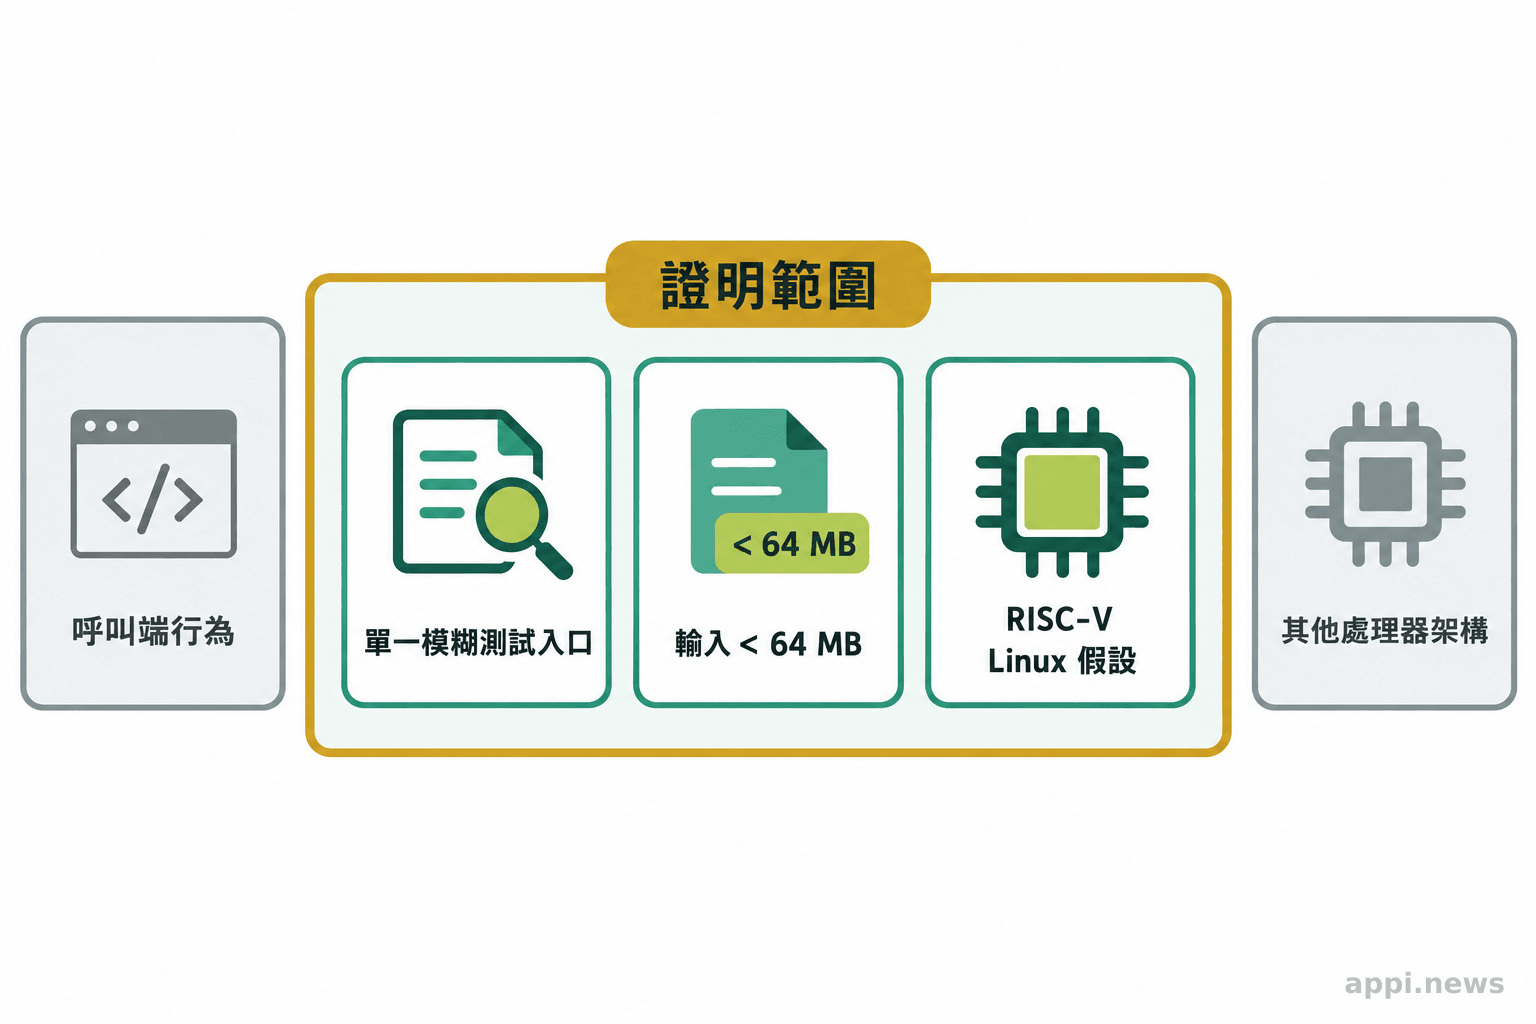
它證明特定模糊測試入口在指定條件下,對小於 64 MB 的輸入會正常結束,不觸發該測試定義的崩潰、記憶體安全錯誤或斷言失敗;涵蓋範圍是 123 個函式庫中的 239 個入口。
模糊測試大量產生輸入找崩潰,無法窮舉所有可能。形式化驗證把性質寫成數學規格,再證明程式符合規格。這次沿用既有測試入口,要求程式對範圍內任何輸入都不崩潰。RISC-V 是處理器指令集架構;程式先編譯成 RISC-V 執行檔,再用形式化的指令及 Linux 程序模型描述執行方式。
Claude 生成證明,Rocq 核心檢查器確認它符合規格。審查重點因此包括定理敘述、機器模型和檢查器。Anthropic 表示典型證明約 60 萬行,總量約 1.8 億行,這些數字不代表程式庫或漏洞數量。
這項流程從既有模糊測試開始:測試入口收到輸入後若崩潰,就代表測試定義的性質失敗。研究團隊把「所有小於 64 MB 的輸入都不讓測試崩潰」轉成形式規格,再將編譯後的 RISC-V 指令、Linux 程序模型和規格交給 Claude 推導證明。Rocq 檢查器檢查的是推理是否符合定理;它不會替團隊判斷定理是否回答了正確的產品需求。
若證明推導失敗,反例也可能指出可重現的問題,研究團隊再修補並重新產生規格、證明。這時版本關係尤其重要:證明若對應修補前的二進位檔,不能直接替修補後版本背書。Anthropic 也說明,為避免模型用「把程式改成永不崩潰」的捷徑讓定理變得容易證明,他們限制並稽核程式修改。審查者應把補丁與證明一併檢視,確認修補保留原本應有的功能。
「Claude 撰寫證明;Rocq 核心檢查器依規格檢查證明。」這是 Anthropic 描述此流程的分工。模型輸出需由獨立的證明檢查器接受,證明才成立。
這是 Anthropic Frontier Red Team 與 Theorem 的合作報告,尚未由獨立團隊重現;成果數字屬研究團隊公布的實驗結果,須按各證明的範圍解讀。
為什麼通過證明仍不能代表程式安全?
證明只保證程式符合已寫明的規格,並依賴規格中的處理器、作業系統及執行假設;它不會自行確認規格是否完整,也不會覆蓋未納入的程式入口、呼叫方式或部署環境。
證明假設程式是單執行緒、靜態連結的 RISC-V 執行檔,使用固定記憶體預算並依 Linux 模型運作。實際部署常用 x86 或 ARM、動態連結與不同函式庫,平台差異會形成缺口。未驗證的入口、函式庫其他路徑及呼叫端錯誤使用,也不在這份證明內。
例如,證明涵蓋某個模糊測試入口,不表示正式產品透過其他 API 呼叫同一函式庫時也受保護。呼叫端若未遵守函式的前置條件,仍可能造成錯誤;要把保證延伸到實際服務,還得寫出呼叫端責任與跨模組互動的規格。即使所有已知入口都完成驗證,未被入口觸及的程式碼仍可能存在,故審查範圍要對照產品實際呼叫路徑。
規格也要審查。若既有測試只把崩潰視為失敗,證明便無法回答輸出是否符合需求、權限是否正確等未寫入的問題。AddressSanitizer(記憶體錯誤檢查工具)能抓到部分越界或錯誤存取,Anthropic 指出它仍無法偵測所有記憶體安全問題。
「形式化驗證不代表沒有漏洞。」Anthropic 在限制說明中指出,剩餘風險可能來自規格、機器語意模型,也可能位於證明未涵蓋的程式行為。
其他案例如何顯示形式驗證的用途與成本?
Anthropic 另報告 zlib 格式規格檢查、Rust 撰寫的 Python 解譯器行為比對,以及 PDF 閱讀器的安全檢查;它們的證明目標不同,不能與 OSS-Fuzz 入口的「不崩潰」結果混成同一種保證。
zlib 案例把 RFC 1950 壓縮格式寫成規格,再證明 Linux 核心的 zlib 實作符合規格。另一實驗以 Rust 寫 Python 解譯器,使用 Verus(Rust 程式驗證工具)證明它符合論文描述的 CPython 語意;另以 170 萬多個隨機程式比對,Anthropic 報告 99.95% 行為一致。這是測試結果,不代表所有程式都一致。
這些例子採用的驗證對象和證據不能互換。zlib 案例問的是實作是否符合壓縮格式規格;Python 解譯器的形式證明以論文列出的 CPython 語意為準,99.95% 則來自隨機程式測試的觀察值。測試比例描述抽樣結果,證明描述規格範圍內的性質,兩者都不能單獨回答完整產品是否沒有錯誤。閱讀成果時應先看規格與測試對象,再看數字。
第三個例子是 PDF 閱讀器安全檢查。Anthropic 表示,一週內發現的漏洞數量相當於平常一年通報的數量,但未公開產品名稱與清單。這些案例的目標各異,結果都應連同適用條件閱讀。
Klein 等人的 seL4 研究記錄,正確性證明約投入 20 人年,其中 9 人年用於形式框架與工具,11 人年用於 seL4 證明。這項研究展示專家如何建立從 C 實作、二進位碼到存取控制與資訊流性質的機器檢查證明。Claude 的實驗降低部分證明撰寫勞務,但不同系統、規格與模型仍需各自維護。Airbus 航電團隊使用 Astrée 靜態分析器時,也需調整設定、處理誤報,並與工具供應商合作提升精度。
| 方法或案例 | 核心檢查目標 | 團隊仍需確認 |
|---|---|---|
| 模糊測試 | 尋找會讓測試入口失敗的具體輸入 | 測試時間、輸入生成方式與尚未探索的路徑 |
| Claude + Rocq 證明 | 證明程式符合明確規格及模型 | 規格、模型、入口和部署條件是否吻合 |
| 靜態分析器(如 Astrée) | 分析程式是否違反指定性質 | 分析設定、誤報與適用程式類型 |
開發團隊如何把證明納入程式審查?
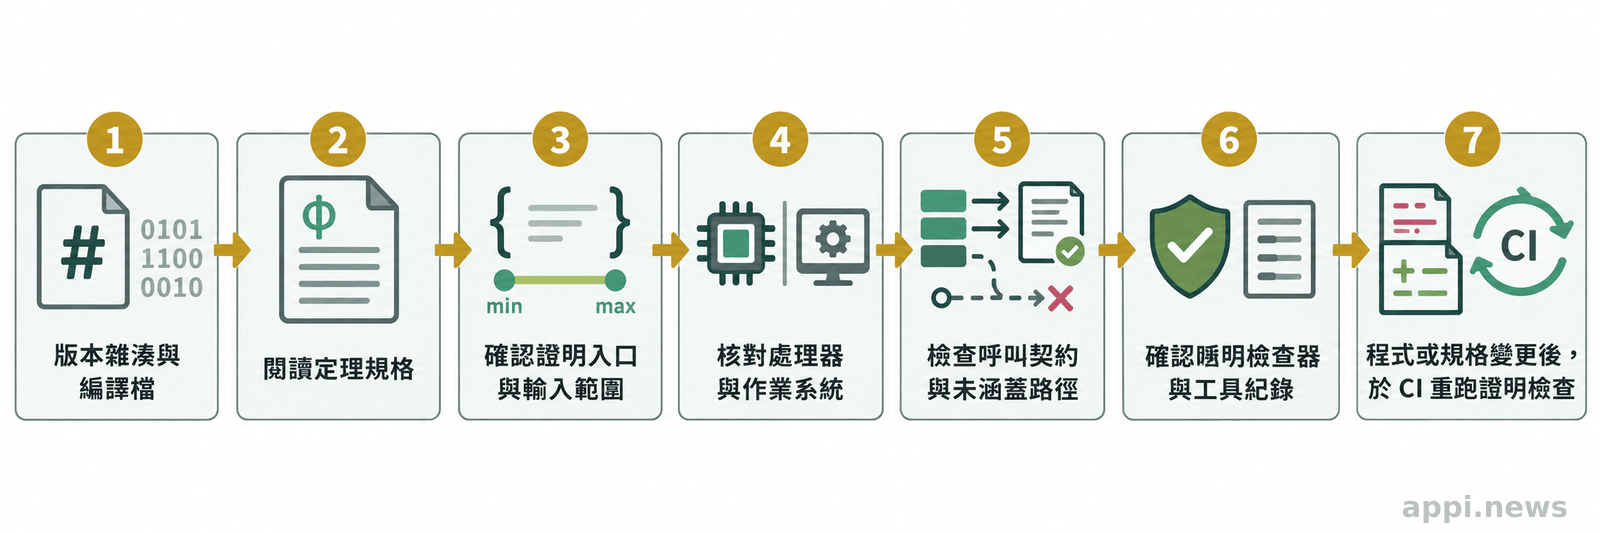
先核對證明對應的程式版本、規格、入口、輸入範圍和目標環境,再確認證明檢查器與信任元件;只有這些條件與實際部署一致,證明才可支援該次程式審查。
-
確認證明綁定的程式版本。 比對提交雜湊、編譯參數與產出二進位碼。若程式修改後重新編譯,確認舊證明是否仍適用,並要求對新版本重新檢查。
-
讀定理敘述。 把「安全」拆成可核對的性質,例如指定入口在特定輸入範圍內不觸發記憶體錯誤。查明哪些行為沒有被寫進規格,避免把一種性質擴張成整體安全保證。
-
逐項比對部署環境。 檢查處理器架構、作業系統、連結方式、函式庫版本、執行緒與記憶體假設。任何差異都應視為待補驗證的缺口。
-
確認覆蓋面和呼叫契約。 列出已證明的入口、未覆蓋路徑,以及呼叫端必須遵守的條件。若入口不能代表正式產品的使用方式,補上相符規格或測試。
-
保留獨立檢查與變更紀錄。 讓持續整合流程在程式或規格改動時重新執行證明檢查,記錄工具版本、證明結果和人工核准者;對證明失敗或規格變更保留審查流程。
證明可補足測試難以窮舉的部分,無法替團隊判定需求完整,也不會自動涵蓋修改後版本。導入成本還包括規格、平台模型、失敗排查及維護;Anthropic 指出,生成證明會消耗大量模型 token,效率仍是普及條件。
- 239 指測試入口,123 指開源函式庫,約 1.8 億行指證明程式碼規模,三種數字不可混用。
- Rocq 檢查的是證明是否符合規格;規格是否貼合需求、執行模型是否貼合部署環境,仍需人工確認。
- 審查時先核對版本、定理、入口、輸入範圍、架構與作業系統,再決定證明可支援哪些結論。
常見問題
Q1: Claude 這次驗證了 1,000 個程式庫嗎?
沒有。Anthropic 原文公布的是 123 個 OSS-Fuzz 函式庫中的 239 個測試入口,以及約 1.8 億行 Rocq 證明程式碼。入口、函式庫和證明行數是不同計量單位。
Q2: Rocq 檢查通過,是否代表程式沒有漏洞?
不能這樣解讀。它表示證明符合指定規格;規格、處理器與作業系統模型的假設,以及未納入的程式路徑,都會限制結論範圍。
Q3: 團隊能否用這種證明取代程式碼審查?
不宜直接取代。證明可增加審查者對指定性質的把握,但需求完整性、版本差異、部署落差和呼叫端使用方式仍需檢查,其他測試與人工審查也應依風險保留。
參考來源
- Anthropic Frontier Red Team. (2026). *LLMs are making formal software verification feasible at a much larger scale*. Anthropic
- Klein G, et al. (2014). *Comprehensive formal verification of an OS microkernel*. *ACM Transactions on Computer Systems*, 32(1), Article 2
- Delmas D, Souyris J. (2007). *Astrée: from Research to Industry*. Airbus France S.A.S


