
語音模型降價,不代表整套產品成本同步下降。阿里 Qwen 於 2026 年 9 月發布 Audio 3.1 系列五款產品;媒體報導最高降價 95%,但官方 9 月 22 日生效的公告列出新加坡及北京國際站兩款調價型號:qwen-audio-3.1-tts-flash 與 qwen-audio-3.0-realtime-flash,未列 ASR。[1][2][8]
開發者應按任務核對可呼叫模型與計費單位。錄音轉寫、文字播報和即時語音助理的介面不同,估算也要納入重試、連線、資料保存與改接成本。
一、Qwen Audio 3.1 這次新增了什麼?
Qwen 發布五款產品:ASR、ASR-Next、TTS、TTS-Next 和 Realtime。產品名稱描述系列能力,不能直接當成 API 型號;文件查得到的型號及狀態如下。[1][3][4][5]
ASR(語音辨識)將聲音轉成文字,可用於錄音整理、字幕和客服逐字稿。官方指南列出的檔案轉錄型號包括 qwen-audio-3.1-asr-flash-filetrans;串流型號與功能須依相應文件確認。驗收時以原音比對文字,特別檢查方言、贅詞與專有名詞。[3]
ASR-Next 的發布資訊提到說話者區分、情緒與環境音理解及音訊問答;目前公開 API 文件尚未核實其正式 model ID、端點、價格或商用條件,暫列為待確認的發布能力,不納入可部署選型。[1][3]
TTS(文字轉語音)可用於朗讀、播報或多語內容製作。聲音表現與專有名詞須用實際稿件試聽驗收。
TTS-Next 的官方 API 型號為 qwen-audio-3.1-tts-next,支援文字及參考音訊輸入;每次最多 3,000 字元,播客輸出最長 240 秒、其他情境 120 秒。[4] Realtime 提供雙向互動,連線方式依型號文件核對。[5]
| 發布產品 | 已核對的 API model ID | 文件狀態 |
|---|---|---|
| ASR | qwen-audio-3.1-asr-flash-filetrans | 引用的非即時辨識指南列出檔案轉錄型號;串流型號未由此來源核實,不在此列。[3] |
| ASR-Next | 尚未核實 | 發布能力,不列為可部署端點。[1][3] |
| TTS | qwen-audio-3.1-tts-flash | 官方調價公告列出型號與計價變更;呼叫格式依控制台文件確認。[8] |
| TTS-Next | qwen-audio-3.1-tts-next | 官方模型頁列出 API 與限制,價格頁列北京區域標價。[4][7] |
| Realtime | qwen-audio-3.1-realtime-plus;調價型號另為 qwen-audio-3.0-realtime-flash | 官方文件與價格公告列示不同型號,不可將產品名稱視為同一端點。[5][8] |
| 工作 | 對應類型 | 先核對的限制 |
|---|---|---|
| 錄音轉逐字稿或字幕 | ASR | 單檔長度、語言與方言、潤飾和時間戳選項 |
| 文字生成旁白或播報 | TTS | 支援語言、音色授權、串流或完整音檔輸出 |
| 製作含旁白與環境音的內容 | TTS-Next | 單次輸入與輸出上限、提示詞和參考音檔規格 |
| 讓使用者用聲音與系統對話 | Realtime | 協定、延遲、插話處理、工具呼叫及上下文管理 |
二、依使用情境挑模型:轉錄、串流、合成或即時互動
依任務挑選已在官方文件核實的端點:錄音轉文字評估 ASR,生成語音或聲景評估 TTS 系列,雙向對話則評估 Realtime。ASR-Next 尚未核實 API,不列入部署方案。
離線轉錄適合可容忍處理延遲的工作。接入前確認檔案格式、長度、時間戳和續傳方式;非同步任務需保存識別碼並及時下載有期限的結果。[3]
串流辨識可用於字幕、語音輸入和通話逐字稿;它是「輸入語音、輸出文字」,與會生成語音回答的雙向即時對話不同。整合時要處理斷線重連、語句切分及中間稿更新,並確認重連是否會重送音訊。
固定稿件轉音檔適合評估 TTS,重點是聲音品質、批次量與快取;Realtime 則需維持連線並管理插話、播放佇列和對話上下文。客戶端也要處理麥克風權限、網路中斷與錯誤提示。
驗收指標依任務設定:轉錄量字錯率,合成檢查自然度,即時互動記錄延遲與斷線恢復。素材納入台灣用語、中英夾雜及背景音。
| 候選工作流 | 主要收益 | 接入重點 | 不適合的情況 |
|---|---|---|---|
| ASR 檔案轉寫 | 批次處理、可延後取結果 | 長度、檔案 URL、非同步查詢 | 必須即時回應使用者 |
| ASR 串流辨識 | 邊說邊顯示文字 | WebSocket 事件、斷線重連 | 需要模型直接口語回答 |
| TTS/TTS-Next | 將文字變成語音或音景 | 音色、語言、檔案格式、單次長度 | 需要持續雙向對話 |
| Realtime | 聽說同步、可插話互動 | 持續連線、延遲、播放與中斷狀態 | 單純的離線字幕批次作業 |
阿里雲 Model Studio 將檔案模式定位於可接受較高延遲的離線處理,並將即時模式用於語音助理、客服與同步口譯;實際選擇仍看應用的延遲和互動需求。[6]
三、API 價格怎麼算,降價後成本是否真的更低?
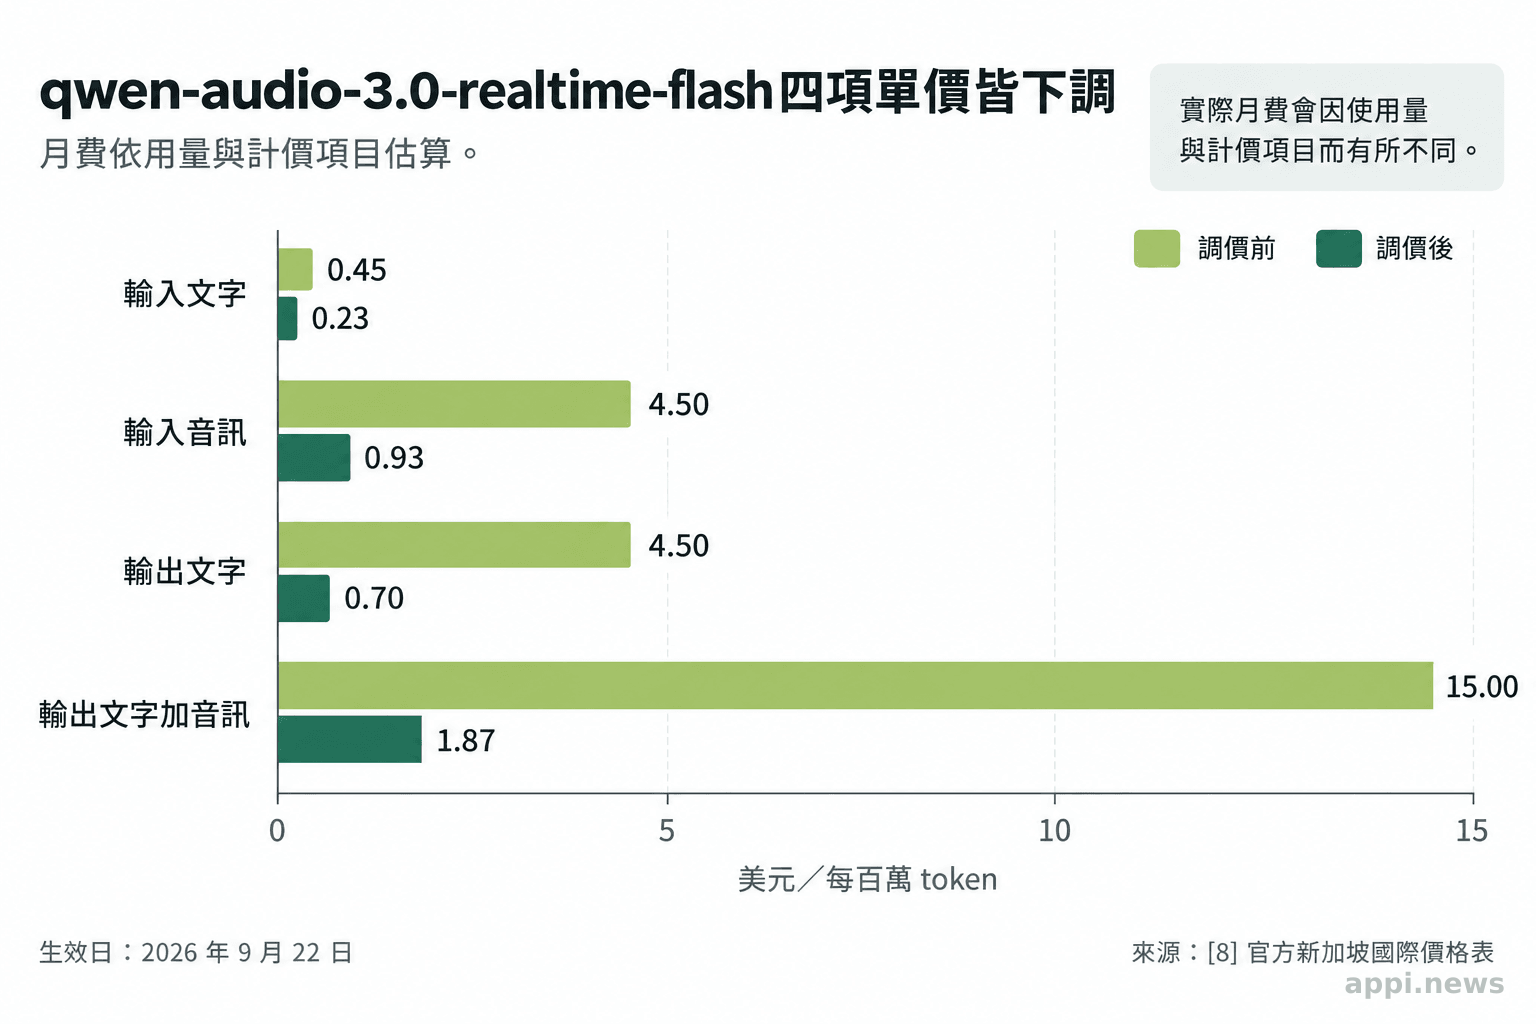
不能把媒體報導的最高降幅套用到所有型號。下表列出官方公告所列兩款調價項目,價格為新加坡國際站美元標價,調價自 2026 年 9 月 22 日生效;北京國際站實際價格仍應登入控制台核對。[2][8]
| 官方公告型號 | 調價前(美元/原計價單位) | 調價後(美元/新計價單位) |
|---|---|---|
qwen-audio-3.1-tts-flash | 輸入文字每萬字元 0.15 美元 | 輸入每百萬 token 0.23 美元;輸出每百萬 token 1.87 美元 |
qwen-audio-3.0-realtime-flash | 輸入文字/音訊、輸出文字/文字加音訊:每百萬 token 分別 0.45/4.5/4.5/15 美元 | 同項依序 0.23/0.93/0.70/1.87 美元[8] |
TTS Flash 舊價按文字字元計,新價則按輸入與輸出 token 計,兩種單位不能直接比較標價或據此推算降幅。報導所稱最高降價 95% 是特定型號與比較條件下的最高值,不代表整個系列或每種用量都能達到。[2][8]
這是不同計量方式下的單價變更,不代表每個工作負載都降 95%。標準定價頁按區域列價:ASR 文件/串流端點按輸入、輸出 token 計;Realtime Plus 依輸入文字、輸入音訊、輸出文字及輸出音訊分項計;北京區域 TTS-Next 的輸入、輸出標價為每百萬 token 0.848、1.696 美元,均不含活動優惠。[4][5][7]
成本比較固定同一批素材、任務與目標區域,先換算成每分鐘音訊或每段對話等相同業務單位,再分列輸入、輸出、重試、上下文及儲存/代理費。用日誌估月用量,與舊方案帳單及改接工時一併比較;試用額度另核資格和期限。[7]
- 最高降幅是特定比較結果,不等於每個專案的實際節省比例。
- 先核對端點、地區與計費單位,再以真實月用量換算。
- 將重試、上下文、併發、儲存與中介服務費納入總成本。
四、API 整合與部署方式要檢查哪些條件?
先確認帳戶可用模型、區域、端點和請求格式。代管 API 不代表權重可下載;本機部署需求須另核對權重與授權。
非同步轉錄以 HTTP 提交和查詢,串流服務維持長連線,TTS-Next 以 HTTPS 回傳音檔;整合前核對 SDK、逾時、錯誤碼、檔案限制和配額。[3][4][5]
代管 API 免自行配置推論伺服器,但仍受資料傳輸、配額與服務生命週期限制;自行部署則須確認權重、商用授權、硬體和維護責任。
Realtime 文件說明以 WebSocket 交換事件,並處理分段串流及插話時的播放佇列。[5] 延遲也受網路和播放緩衝影響。
依資料內容與用途確認適用的個資、著作權或其他權利要求,必要時請法務確認;取得必要同意並限制用途。[9][10]另須查明保存期限、存取權限、傳輸區域及服務商條款。
五、台灣開發者上線前的查核清單
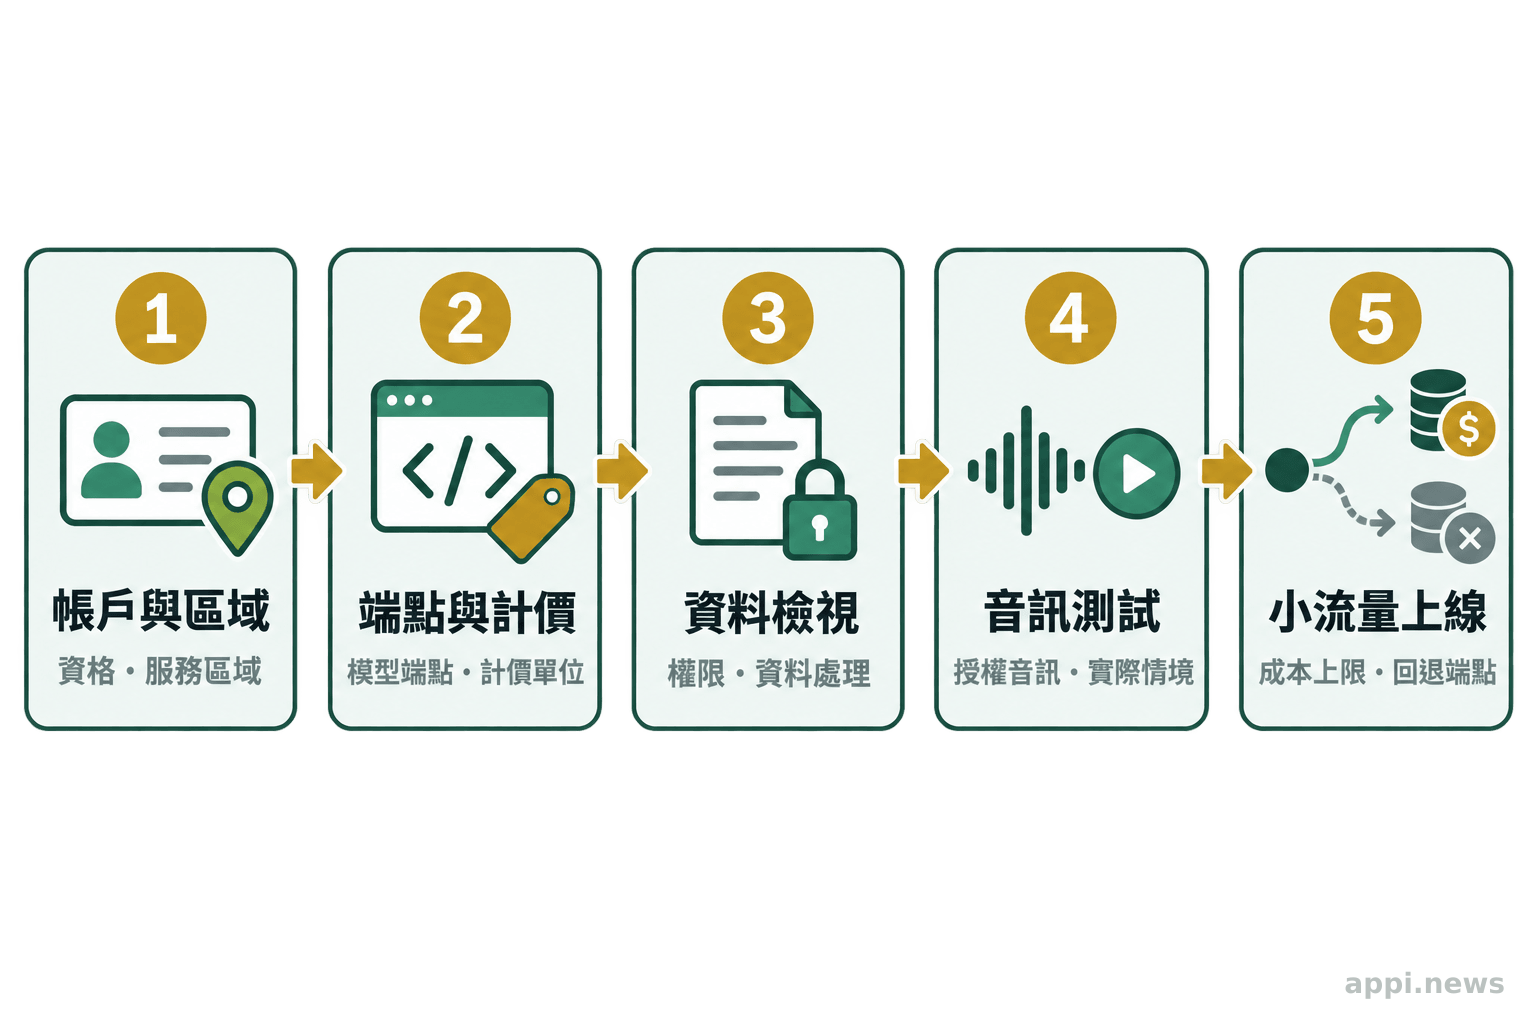
不能由「國際服務」推定台灣帳戶可用。各模型文件所列區域不同,應以控制台和合約確認帳戶資格、付款、端點及資料條款,再用小額請求驗證。[4][5]
若經代理商使用,另確認資料流向、責任與帳單來源。用獲授權素材測方言、中英夾雜、背景聲及弱網情境;先小流量對照,設定費用上限並保留回退端點。
- 選代表性素材,記錄語言、用量與輸出需求。
- 核對帳戶、區域、端點、計價和資料條款。
- 用相同素材比較品質、延遲及總費用,再小流量上線並保留回退路徑。
結論:先用代表性工作負載試算與小規模測試
以代表性素材確認帳戶區域、正式端點與計價方式,再比較辨識品質、延遲和總費用。依任務選模型;未核實 API、帳戶資格或音訊權利前,不納入正式服務。
常見問題
Q1: Qwen Audio 3.1 的五類模型可以互相替代嗎?
不能。ASR 轉錄語音,TTS 生成語音,TTS-Next 生成語音或聲景,Realtime 用於雙向互動。ASR-Next 僅見發布資訊,API 尚未核實,不列為可用端點。
Q2: 報導所稱最高降價 95%,怎麼估算自己的節省金額?
官方公告列出的調價型號不含 ASR。先在帳戶可用區域核對端點與計價單位,再按實際用量估算,並以相同素材比較新舊服務及周邊費用。
Q3: 台灣開發者能否使用新加坡端點?
公開文件列有新加坡區域端點,但不能據此保證所有台灣帳戶均可開通。請登入帳戶確認模型、付款資格、區域與資料條款,並在正式導入前完成實際 API 請求。
Q4: Qwen Audio 3.1 可以下載模型到自己的伺服器執行嗎?
雲端 API 文件說明的是由 Model Studio 提供推論服務,不能由此推定同名模型權重可供自行部署。若需要本機執行,應另外查找對應權重倉庫、授權條款、硬體需求與更新方式。
參考來源
- 千問大模型 (2026). 🎧五模齐发!能听懂、能创作、能聊天今天,我们正式发布 Qwen-Audio-3.1 系列语音大模型. *新浪新聞*(轉載千問大模型官方認證帳號發布內容)
- Matthias Bastian (2026). Alibaba launches Qwen Audio 3.1 with new models and slashes AI audio prices by up to 95 percent. *The Decoder
- Alibaba Cloud Model Studio (2026). Non-real-time speech recognition
- Alibaba Cloud Model Studio (2026). qwen-audio-3.1-tts-next model information
- Alibaba Cloud Model Studio (2026). Qwen-Audio real-time voice model
- Alibaba Cloud Model Studio (2026). Speech-to-speech models
- Alibaba Cloud Model Studio (2026). Alibaba Cloud Model Studio model pricing
- Alibaba Cloud Model Studio (2026). [Model Studio] Price Reduction Notice for Selected Audio Models
- 中華民國法務部 (2025). 個人資料保護法. *全國法規資料庫
- 中華民國法務部 (2022). 著作權法. *全國法規資料庫


