
Hugging Face 發表的 Carbon-X,將 DNA 序列和自然語言放進同一個聊天介面。模型卡列出五項 DNA 基準測試,涵蓋變異效應判讀、序列特徵理解與下一個鹼基預測;同一份模型卡也明確說明,它尚未經臨床驗證,不能用於醫療決策。這些特定任務的計算評測能告訴研究者什麼?模型可以先協助形成待驗證的研究假說,但「回答得像樣」和「細胞裡確實發生」仍是兩件事。
Carbon-X 的基準測試結果,回答了哪些研究問題?
Carbon-X 可協助研究者用自然語言探索 DNA 序列、提出變異效應或序列特徵的初步假說;模型團隊公布的測試分數只描述特定資料集與評分方法下的表現。
Carbon-X 是一個約 148 億參數的解碼器語言模型,由 Hugging Face 與合作研究團隊共同開發。模型把一般文字和 DNA 以不同詞元方式編碼,再放進同一個序列中處理。DNA 部分以六個鹼基為一組的 6-mer 表示,因此使用者可以在對話裡附上序列,再詢問某個變異可能造成什麼影響,或請它指出序列中可能具有調控功能的區域。
這個操作方式適合探索問題,不等於它能替代專門的生物資訊工具。模型卡列出的五項評測,包含蛋白質編碼區變異、複雜變異、DNA 理解、下一鹼基預測及單鹼基變異效應。團隊報告 Carbon-X 在編碼區變異效應測試的平衡準確率為 74.9%,複雜變異為 85.1%;但在 GenomeQA 的剪接位點題目為 29.8%,組蛋白標記題目為 34.6%。各項分數對應不同任務與評分方法,不能概括為模型整體能力,實際使用仍要看任務是哪一種。
其中 FrontierVEP 與 NextBase 是開發團隊自行建立的評測集;其餘取自既有文獻。這些測試不是外部團隊獨立重做,也不是細胞或動物實驗。若要問某段序列是否影響基因表現,可把答案當候選線索,再用註解資料、既有實驗或其他工具交叉檢視。精確數鹼基、定位座標或改寫序列,模型卡提醒可能誤數或出錯,應交給程式處理。
「Carbon-X 是連結 DNA 與語言研究的起點。」這是模型團隊對模型定位的描述,並非臨床效能結論。來源:Hugging Face Carbon-X 模型卡。
模型預測為什麼還不能當成生物功能證據?
同一段 DNA 的作用會隨細胞、組織、基因背景與實驗條件改變;基準測試中的分類或預測成績,不能直接證明特定生物情境下的功能。
基因表現受周遭調控區域、細胞內的調控因子與染色質狀態共同影響。模型收到的序列片段未必包含所有脈絡,提示中若缺少基因、方向、座標或註解,它可能推測出不正確的序列身分或功能。Carbon-X 模型卡也提醒,輸入超出訓練資料長度很多時,表現尚未充分評估;雖然可接受較長上下文,這不等於長序列能力已被驗證。長 DNA 生成的品質也會下降,團隊說明模型主要是讀取與解釋現有序列,並未訓練成設計新序列的工具。
Enformer 提供另一個理解模型驗證的例子。Avsec 等人在 2021 年發表的研究,讓模型根據 DNA 序列預測基因表現相關訊號,並以 MPRA 測得的飽和突變資料評估 Enformer 對非編碼變異效應的預測。這類比較的價值,在於檢查計算預測是否能對上實驗觀察;它不能直接證明每個變異在人體內都會造成相同結果,也不能把 Enformer 的表現移植成 Carbon-X 的實驗證據。
2025 年,Kosicki 等人以人類誘導神經元中的 MPRA,並搭配小鼠轉殖試驗評估神經增強子活性。研究以超過五萬條序列進行 MPRA,並在 MPRA 中測試超過兩萬個變異;另以小鼠試驗評估選定序列。作者報告兩種方法的結果有相關性,也發現小鼠試驗呈現 MPRA 未觀察到的多效性。這個案例指出,MPRA 可以大量測試序列在特定細胞設定下的活性,但培養皿裡的報導系統與活體情境並不完全相同。對候選變異的判讀,應依問題選擇互補的實驗與分析方式。
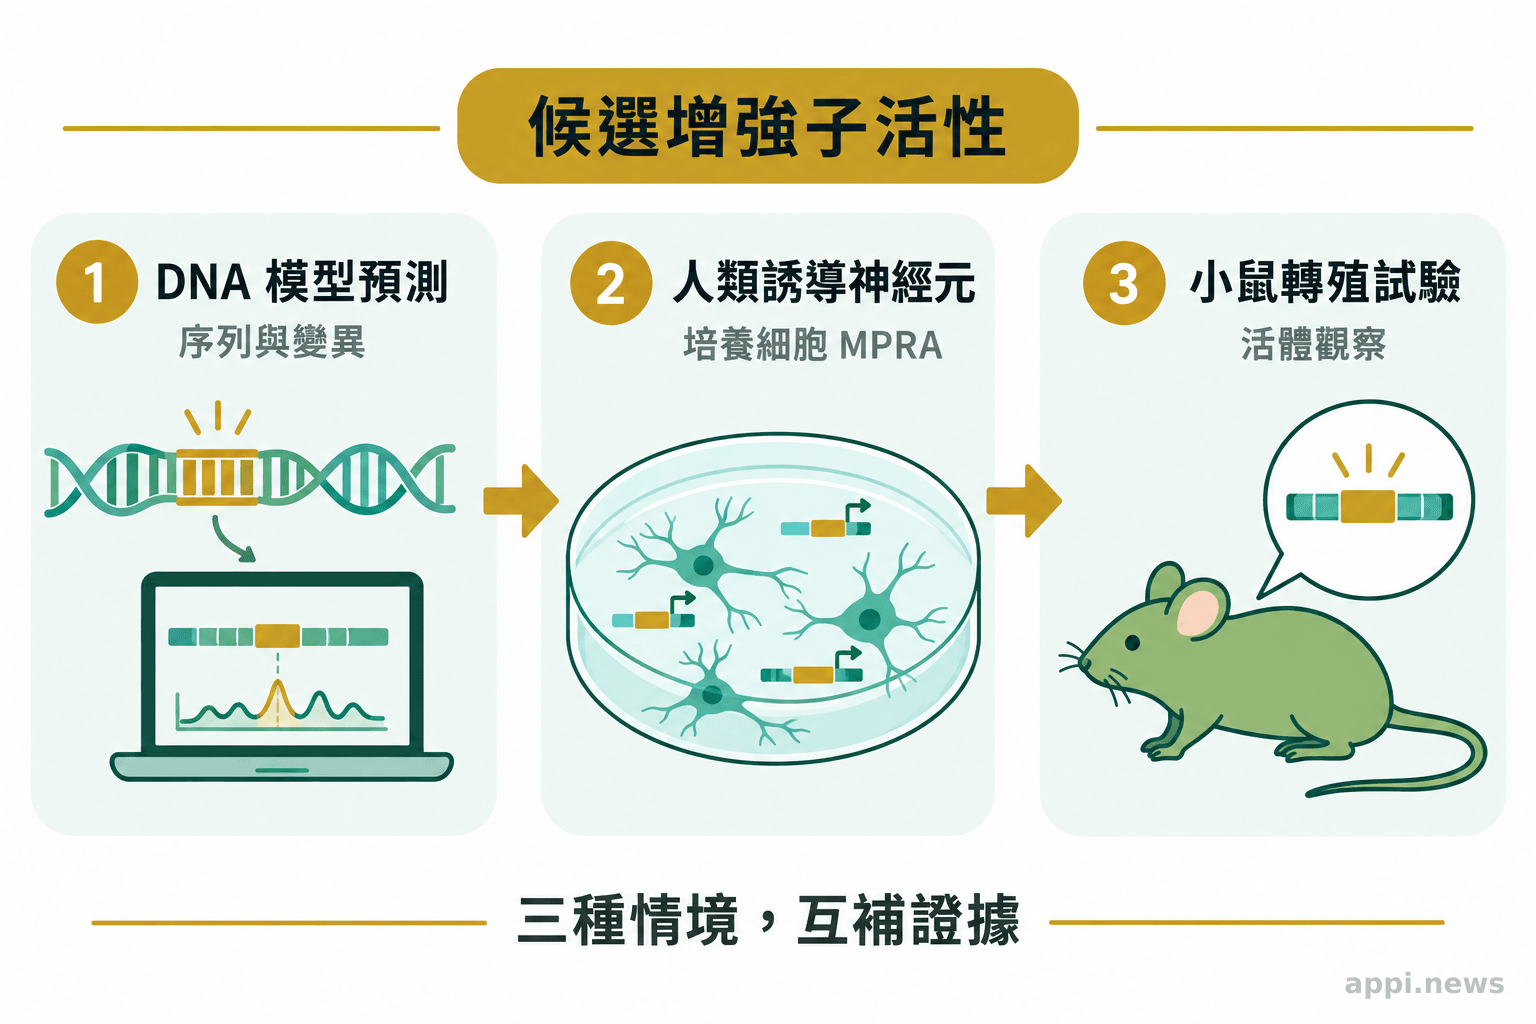
「MPRA 與小鼠轉殖試驗提供相關且互補的資訊。」這是 Kosicki 等人 2025 年研究的結論,研究範圍聚焦神經增強子,不能直接推廣到所有基因與疾病。來源:Nature Communications。
模型輸出因此應被視為研究流程中的一個候選訊號,而非功能已被證實的標籤。細胞種類、培養條件、基因背景、物種差異與測量方法都可能影響結果。研究者還要先界定所問的是基因調控、變異分類、序列辨識還是療法候選探索,才能挑選能回答該問題的驗證方法。基因療法牽涉靶點、遞送方式、劑量與安全性等多層決策,單一序列模型不會自動回答這些問題。
Carbon-X 接進研究流程,成本與風險在哪裡?
研究團隊要把 GPU、部署維護、資料整理、實驗確認與隱私管理一起計算。開源權重增加部署選擇;GPU、維護、資料整理與實驗確認仍須納入成本。
Carbon-X 採 Apache 2.0 授權,模型卡說明可透過 Transformers 或 vLLM 執行;以 bfloat16 在單張 80 GB GPU 上部署是團隊提供的參考條件。硬體費用之外,還要安排儲存與網路、環境相依套件、模型更新、效能監控和人員維護。團隊若沒有相容 GPU,可能需要租用雲端算力;若自行部署,則要有人負責版本控管、權限設定、記錄保存與資安修補。這些都是實際成本,並不會因模型檔可下載而消失。
開源模型不代表所有使用方式都把資料留在本地。機構自行部署,與把序列送進第三方 API、推論端點或公開示範空間,資料經手的系統和管理者可能不同。Hugging Face 模型卡提醒,基因資料高度敏感,各服務的處理方式也不同。上線前要核對傳輸、保存、存取權限、日誌、刪除政策與委外條件。可識別特定個人的基因資料屬個人資料;蒐集、處理及利用時,應依《個人資料保護法》確認法定依據、目的與安全維護義務。若研究另受研究倫理審查規範,也須依相關程序辦理。
另外,模型團隊的低推論成本估算,依其硬體與評測設定計算,不能當成每個實驗室都會拿到的報價。真實總成本還取決於工作量、序列長度、同時使用人數、GPU 租用或採購、資料標註及實驗驗證。模型卡目前列出的授權有利於研究團隊檢視條款,但仍應確認下載版本、相依程式、資料集與後續部署的授權條件。若日後改用服務供應商,也應持續檢查價格、資料政策和服務可用性。
| 做法 | 可用來做什麼 | 需要另外確認 |
|---|---|---|
| Carbon-X 本地推論 | 以自然語言探索候選序列與變異 | GPU、環境維護、版本與存取控管 |
| 第三方端點或示範空間 | 快速試用,不必先架設完整環境 | 序列是否上傳、保存多久、誰可存取 |
| 專門分析程式與實驗 | 精確定位、統計或測量特定功能 | 輸入品質、實驗設計與適用的細胞情境 |
研究者如何安排輸出驗證與實驗確認?
先把研究問題和序列資料寫清楚,再檢查變異位置、比對獨立工具與資料,最後依生物情境安排實驗;每一步都保留可追溯紀錄。
可從五個檢查點開始。第一,寫明問題,例如「候選變異是否改變某細胞中的增強子活性」,別只問「這段 DNA 有什麼功能」。第二,核對序列來源、基因組版本、方向、座標及參考/替代鹼基,避免輸入錯誤。第三,記錄模型版本、提示、參數與輸出。第四,以獨立註解資料或分析工具核對,分清模型推論和實驗支持。第五,依假說和組織情境選擇實驗,如 MPRA;涉及活體效應時,再評估更接近生理情境的模型與研究資源。
- 定義一個可檢驗的研究問題,指定目標細胞或組織。
- 核對序列版本、座標、方向及變異前後鹼基,精確操作交給程式。
- 保存模型版本、提示、輸入來源與輸出,並標記團隊評測或自行驗證的結果。
- 以獨立工具和既有實驗資料交叉檢查,規劃能回答該問題的實驗。
- 完成必要驗證前,不把模型結果送入療法設計、臨床評估或個人健康判斷。
孕婦、兒童、慢性病患者及長期服藥者,不應根據 Carbon-X 的解釋改變治療或健康決策;處理可識別基因資料的研究團隊,也要先確認參與者同意、資料用途及存取安排。本文不提供用藥建議,藥物交互作用不適用於本文討論範圍。基因療法研究更不能由模型單獨決定候選序列、療效或安全性。較穩健的做法,是把 Carbon-X 用在可被公開資料、獨立工具或既有實驗核對的探索階段,等證據累積後再決定是否進入下一個研究步驟。
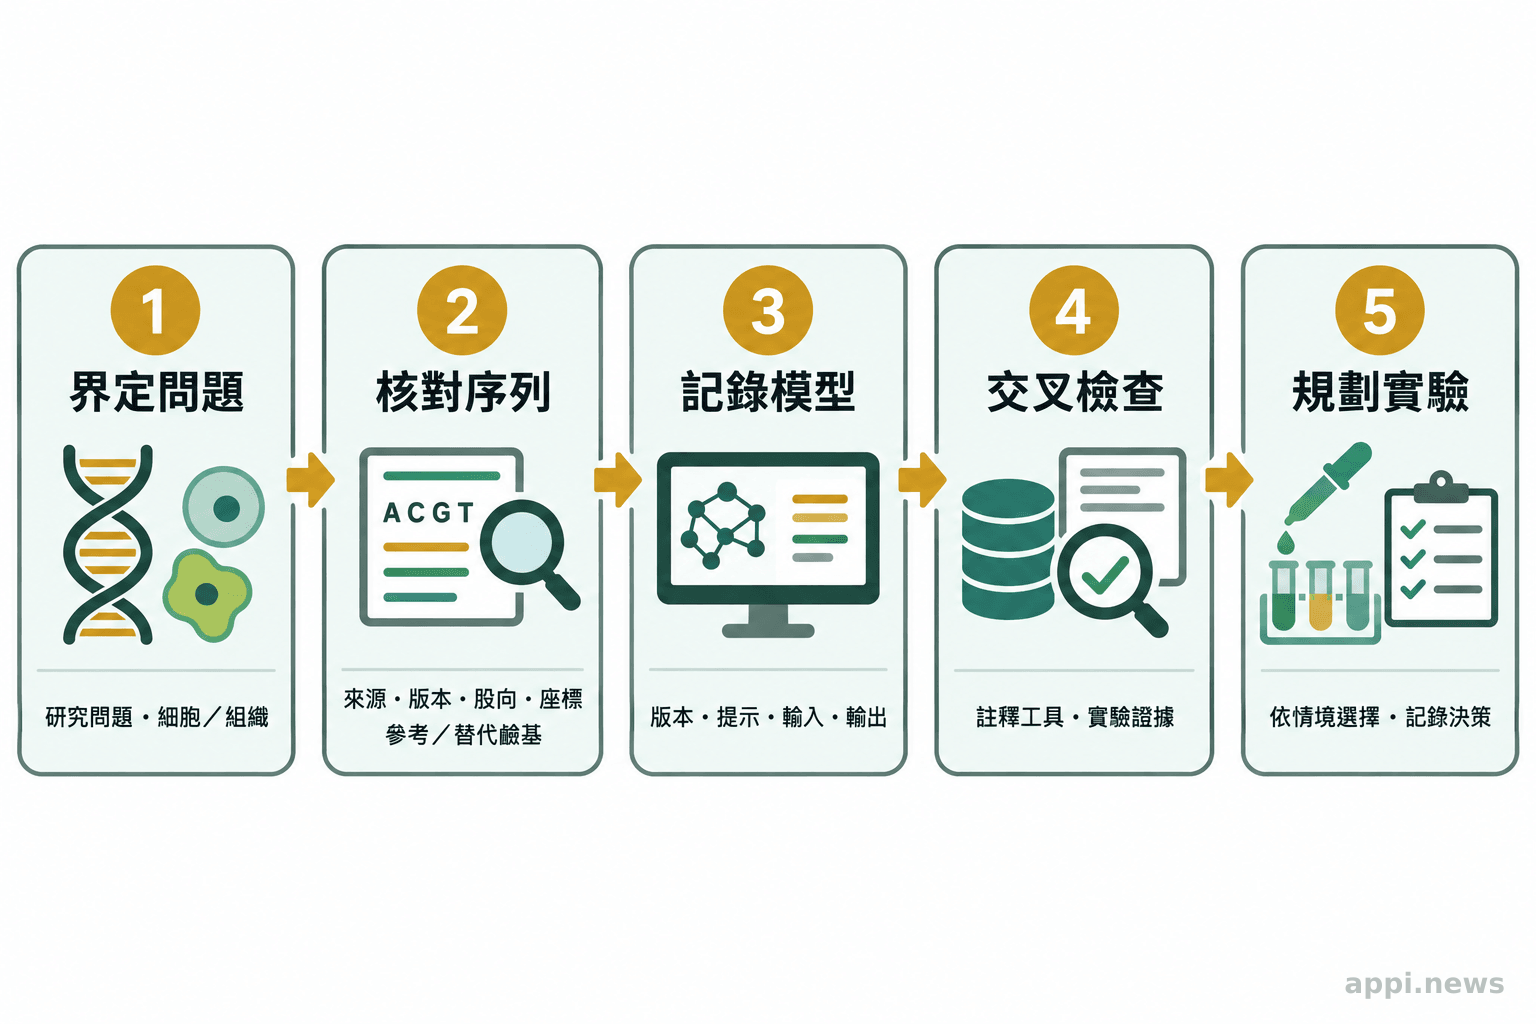
- Carbon-X 的自然語言介面能協助探索序列特徵與形成待驗證假說。
- 五項基準測試分數是模型團隊報告的計算評測,不是獨立實驗或臨床驗證。
- DNA 的精確操作、功能判定與基因療法決策,都需要程式、實驗或專業流程補足。
- 開源權重不代表第三方端點或示範空間會採用相同的基因資料處理方式。
常見問題
Q1:Carbon-X 可以直接設計基因療法用的 DNA 嗎?
不適合據此直接設計療法序列。模型卡指出長序列生成品質會下降,Carbon-X 未經臨床驗證,主要用於研究探索與解釋既有序列;候選設計還須經適當的計算分析、實驗確認與研究審查。
Q2:Carbon-X 的基準測試能證明臨床準確度嗎?
不能。基準測試只反映指定資料集、任務和評分方式下的表現;模型團隊也說明 Carbon-X 尚未經臨床驗證,結果不能用來診斷或決定治療。
Q3:使用開源模型是否代表基因資料不會外流?
不代表。若權重在研究單位管理的設備上執行,資料路徑可由單位自行控管;使用第三方 API、推論端點或示範空間則要依各服務政策確認資料是否傳輸、保存與供誰存取。
參考來源
- HuggingFaceBio/Carbon-X · Hugging Face (2026)
- Avsec Ž, et al. (2021). Effective gene expression prediction from sequence by integrating long-range interactions. *Nature Methods*, 18, 1196–1203
- Kosicki M, et al. (2025). Massively parallel reporter assays and mouse transgenic assays provide correlated and complementary information about neuronal enhancer activity. *Nature Communications*, 16, 4786
- 全國法規資料庫(2025)。個人資料保護法
- TechNews 科技新報(2026)。用白話文與 DNA 對話,Hugging Face 發表 Carbon-X 助攻基因療法


