
很多人看到模型變快,第一個反應是整次多模態任務都會更快;但要判斷 LFM2.5-VL-DSpark 對服務有沒有幫助,得先拆開等待時間:影像編碼、提示預填,還是文字解碼?Liquid AI 在 2026 年 9 月 24 日發布這個實驗性草稿模型,目標是加快視覺語言模型生成文字的階段。它可能縮短使用者等回答的時間,卻不會自動消除影像處理與整合流程的耗時。
LFM2.5-VL-DSpark 是搭配 LFM2.5-VL-3B 使用的推論加速模型。它採用「投機解碼」:較小的草稿模型一次提出數個候選詞元(token,模型生成文字時使用的基本單位),再由原本的目標模型驗證。官方公布的結果顯示,不同設備和任務的解碼速度、端到端延遲改善幅度並不相同。因此,評估重點是自己的工作負載是否卡在解碼,以及框架、記憶體和品質驗證能否配合。
一、LFM2.5-VL-DSpark 加速生成流程中的哪一段?
它加速的是 LFM2.5-VL-3B 生成回答時的文字解碼,以小型草稿模型先提候選詞元,再由目標模型驗證;影像編碼與提示預填不會因此同步加速。
影像編碼、提示預填與文字解碼各做什麼
視覺語言模型收到含圖像的問題後,通常先由視覺編碼器把圖片轉成模型能處理的特徵或視覺詞元,再將這些資訊與文字提示一併送進語言模型。提示預填會處理整段輸入,建立後續生成所需的狀態;文字解碼則依序產生回答中的詞元。三段工作前後相接,整體等待時間是它們共同造成的。
例如讀取收據時,圖片尺寸與文字密度影響影像編碼,視覺詞元數量和問題長度影響預填,回答長度則影響解碼。解碼占比越高,加速越可能反映在等待時間。
草稿模型提出候選,目標模型負責驗證
一般自回歸生成逐次預測下一個詞元。投機解碼由草稿模型先提出候選序列,再交給目標模型驗證;目標模型接受符合其分布的部分,遇到不符時從差異處接續生成,減少逐詞元解碼等待。
DSpark 草稿模型參考目標模型指定層的隱藏狀態(模型內部的上下文表示)提出候選。Liquid AI 表示,圖片區塊與文字詞元進入相關層前已投影至共同表示,因此可沿用文字版 DSpark 的投機解碼流程;它仍須搭配指定目標模型,不能任意接到其他視覺語言模型。
官方發布資料稱,草稿模型約有 2.8 億參數,約為 30 億參數目標模型的 8.9%,仍會增加模型檔與執行時的記憶體需求。這個增幅是參數量比例,不等同於實際常駐記憶體一定增加同樣百分比;精度格式、快取、框架配置和併發量都會影響峰值用量。部署前仍要在目標裝置上量測,而不能只用參數比例估算。
二、官方測試的速度提升,如何解讀才不會高估?
不能直接套用。 Liquid AI 公布的數據是在特定硬體、框架、區塊大小與視覺任務下測得,解碼速度提升幅度和整個請求完成時間的改善幅度不同。
解碼吞吐與端到端延遲回答不同問題
解碼吞吐以每秒生成詞元數或相對倍率呈現;端到端延遲則計入影像處理、預填、排隊、傳輸及回答生成。解碼若只占總時間一小部分,即使快數倍,總等待也不會同比縮短。
這符合 Amdahl 定律:整體改善受未加速部分限制。團隊應以服務的階段計時確認解碼占比。
Liquid AI 在官方發布說明指出,投機解碼不會加速視覺編碼或提示預填,因此解讀解碼倍率時也要查看端到端延遲。
設備、框架與任務都會改變結果
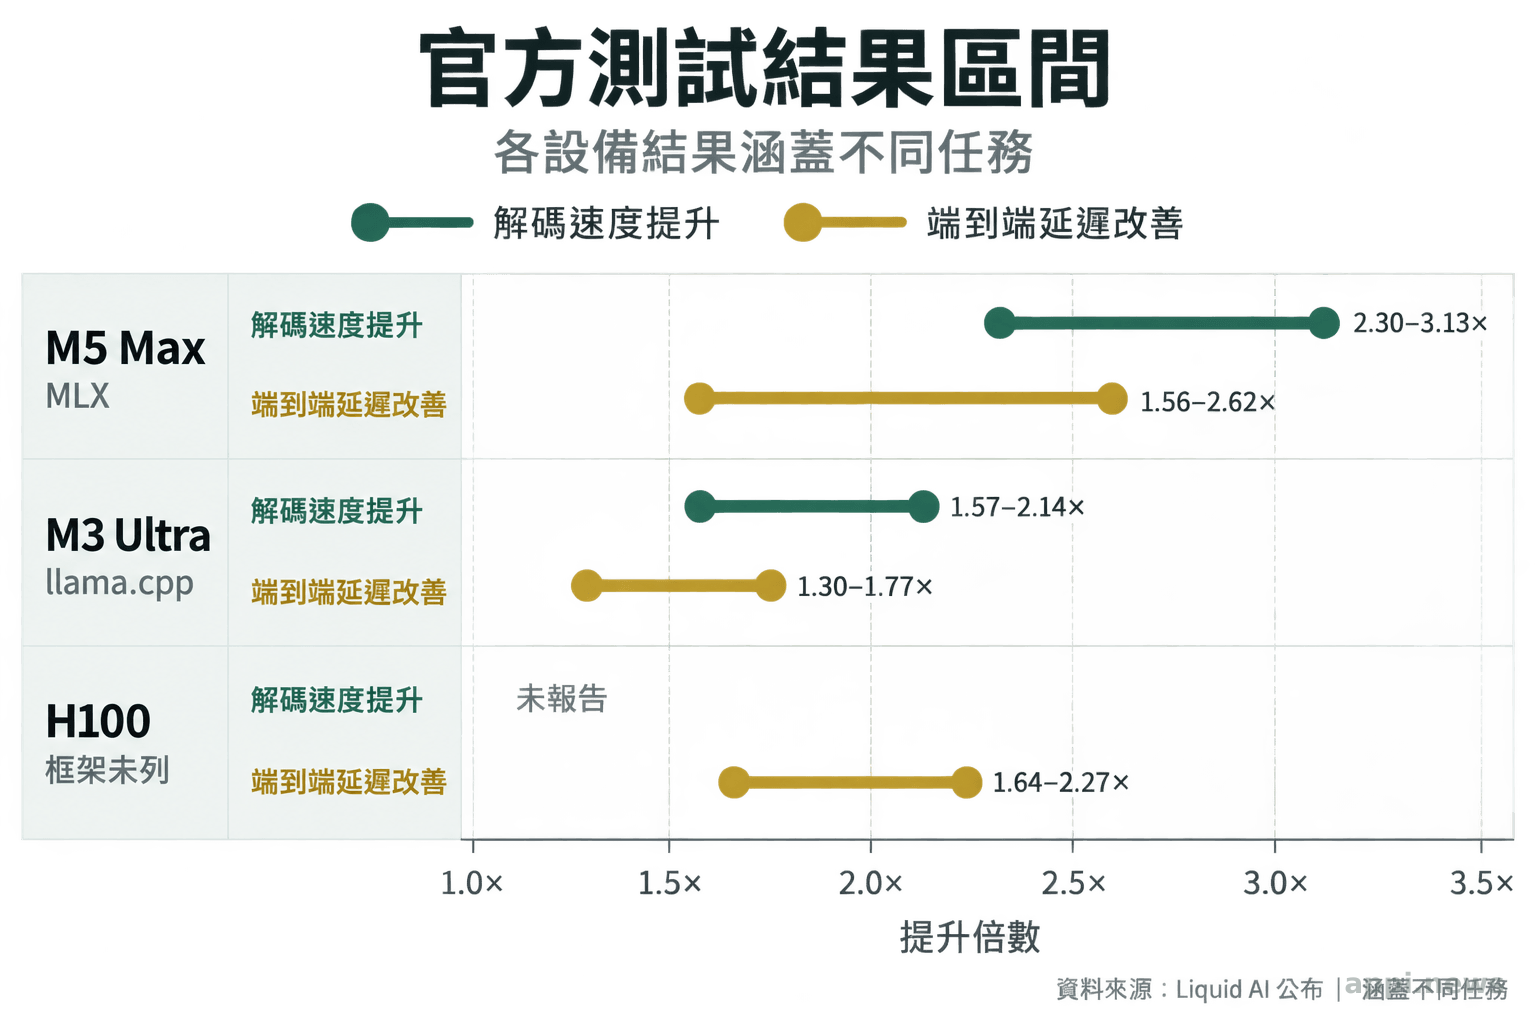
Liquid AI 列出一般視覺問答、圖片文字問答、圖表問答、圖片說明、複雜推理和多輪對話六類測試。以下為廠商公布的基準結果,並非 MMSpec 論文對 DSpark 的獨立驗證。
| 裝置 | 推論框架 | 解碼速度提升 | 端到端延遲改善 | 測試範圍與歸屬 |
|---|---|---|---|---|
| M5 Max | MLX | 2.30–3.13 倍 | 1.56–2.62 倍 | 六類視覺任務,Liquid AI 公布 |
| M3 Ultra | llama.cpp | 1.57–2.14 倍 | 1.30–1.77 倍 | 六類視覺任務,Liquid AI 公布 |
| H100 | 發布資料未列 | 未列 | 1.64–2.27 倍 | Liquid AI 公布 |
各區間涵蓋不同任務,非自有服務實測,不能直接外推至其他輸入或伺服器負載。
批次大小、輸出長度、精度、併發量及框架版本都會改變結果。單一請求延遲與多人使用時的總吞吐也應分開衡量。
MMSpec 是評估方法的背景研究,不是 DSpark 測試。該論文在其比較條件下發現,吞吐加速不能可靠代表延遲表現,且任務特性會影響投機解碼效果。MMSpec 論文
三、加速邊界在哪裡,為什麼整體收益會不同?
因為投機解碼只縮短生成階段,影像編碼與提示預填仍照常執行。 未加速階段占總等待時間越多,端到端改善就越有限。
視覺輸入會增加解碼前的工作量
視覺編碼器會將圖片轉成模型可處理的特徵或視覺詞元;高解析度或文字密集圖片可能增加處理量。實際區塊數取決於模型的影像處理策略,語言模型之後仍須處理視覺資訊與文字問題。DSpark 不會取代影像編碼與預填。
視覺語言模型的效益也隨任務而異:簡短圖片問答的解碼占比可能低,整理多張收據或輸出長清單則可能較高。
未加速部分如何限制整體成效
若只記錄每秒詞元數,可能看不出請求各階段的耗時;應拆分階段計時。長篇辨識或多輪代理若主要耗時在生成,解碼改善才可能更直接。
測試應涵蓋真實圖片、提示與回答長度,避免快取或固定短答扭曲結果;除平均值外,也要觀察高百分位延遲。
「單看吞吐加速,無法可靠反映延遲表現。」— MMSpec 研究團隊的基準研究結論。研究來源
四、併入既有模型服務,需要評估哪些整合成本?
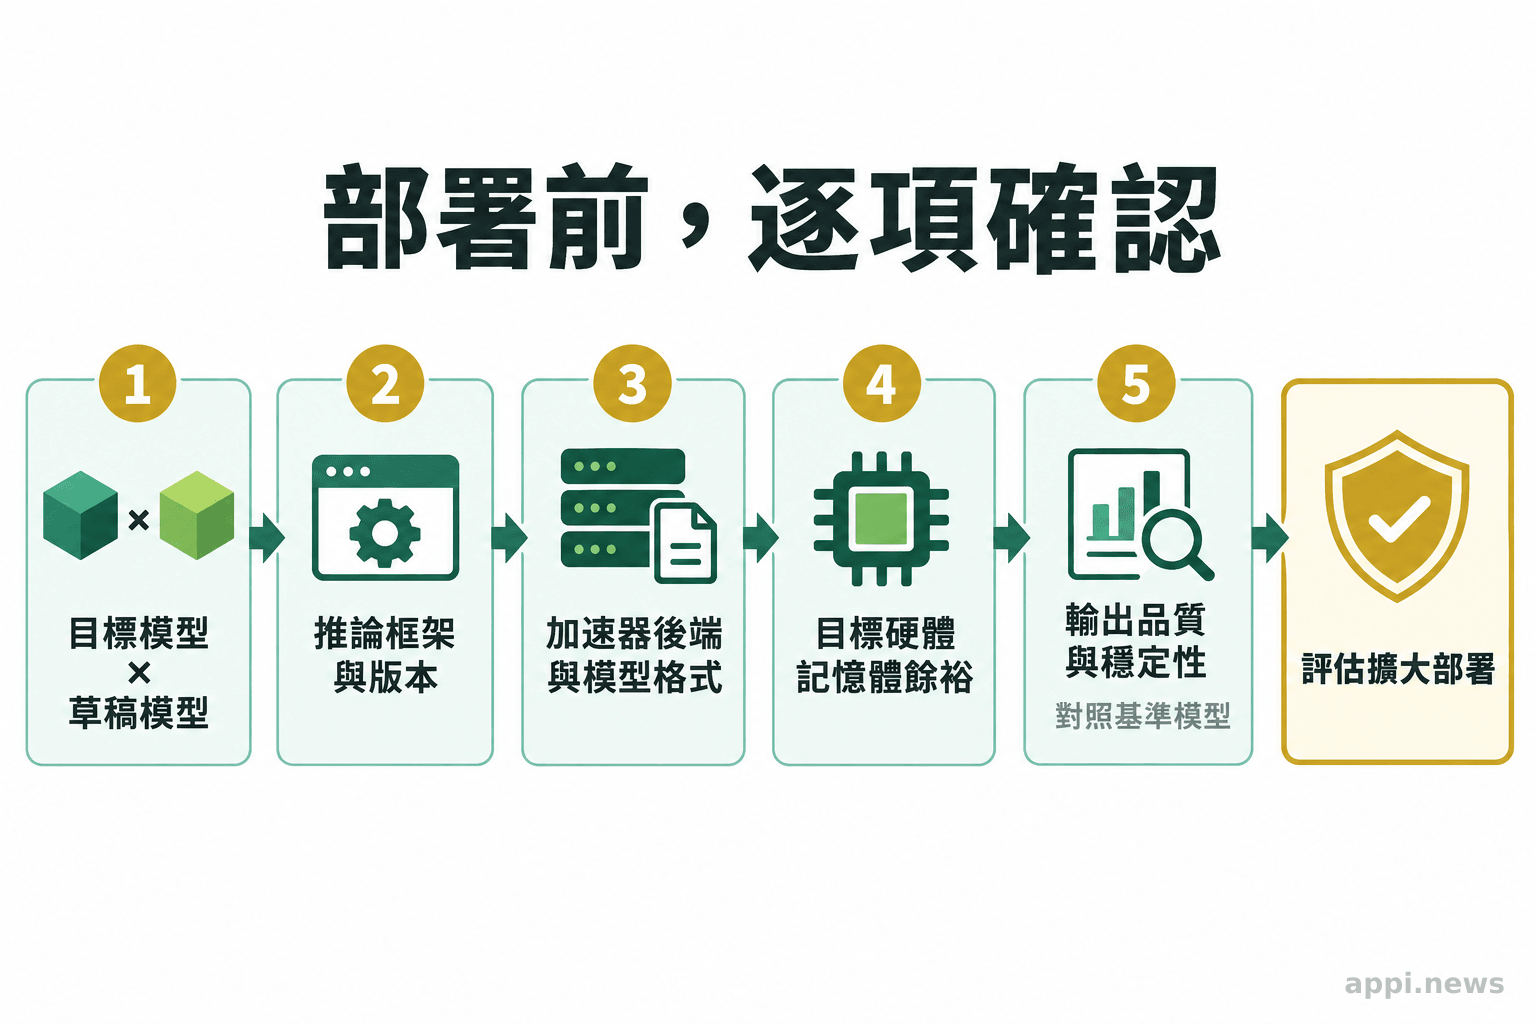
先確認目標模型與草稿模型配對、推論框架支援、記憶體餘裕和現有瓶頸,再做有無 DSpark 的對照測試。 只下載權重並不足以完成部署。
模型配對、框架版本與硬體支援
DSpark 是為 LFM2.5-VL-3B 訓練,須按官方指引配對。Liquid AI 列出 llama.cpp、MLX-VLM 和 SGLang 整合支援;部署前仍須核對支援版本、作業系統、加速器後端及模型格式。舊版框架可能需升級或編譯,並進行回歸測試。
基礎模型卡列有 Transformers、vLLM、SGLang、llama.cpp 等環境,但能執行基礎模型不代表可載入 DSpark。請以模型卡、發布指引及框架文件核對功能旗標、格式與相容版本。
延遲、品質、穩定性與版本維護
草稿權重、執行時狀態與快取都會占用資源;記憶體不足可能提高峰值用量、降低併發量或造成載入失敗。應在目標硬體與正式框架下量測,並檢查伺服器的批次調度和佇列。
比較兩種模式的任務正確性、格式、圖片細節與多輪一致性。Liquid AI 表示,在其支援的貪婪解碼實作中,候選經目標模型驗證後可與目標模型單獨生成的結果一致;此說法限於該設定,其他參數及框架仍須測試。對照時固定生成參數並保留代表案例。
目標模型、草稿權重或框架升版可能改變相容性、速度與資源使用;記錄版本、硬體、提示樣本及測量方式,作為回歸基準。
五、哪些部署情境值得納入評估?
當服務已確認生成解碼是主要瓶頸、工作負載與框架支援相符,且硬體有額外記憶體空間時,值得先做受控試測。 若時間主要耗在影像前處理或提示預填,應先處理那些環節。
解碼占比高時,先從有限流量試測
適合納入評估的服務可能包含長篇圖片說明、文件欄位整理、圖表問答,或需要多輪產生內容的視覺代理。判斷關鍵在追蹤數據是否顯示文字生成持續占去可觀比例的時間,而非只看服務有沒有接收圖片。若環境能載入配對權重,且記憶體與加速器配置保有餘裕,可先選少量內部流量對照基礎模型和 DSpark 模式。
試測納入短長答案、高解析度圖片、表格與多輪請求;記錄首詞元時間、每秒輸出詞元數、端到端延遲、錯誤率及峰值記憶體,並查看中位數與高百分位延遲。
瓶頸在前處理或預填時,先優化前段
若圖片解碼、裁切、傳輸或視覺詞元處理才是主要等待來源,可先檢查圖片尺寸、重複上傳、預處理並行和提示長度,同時確保不損及辨識內容。
改採自架模型也會增加硬體、更新、監控及故障處理成本,與託管服務的資料流向、費用和供應商相依一併比較。LFM Open License允許年營收低於 1,000 萬美元的公司依條款商用;達到門檻後須向 Liquid AI 取得商業授權。導入前仍應逐一核對兩組權重隨附的授權及產品情境。
導入前可執行的對照流程
- 從日誌拆出影像前處理、提示預填、首詞元等待和解碼時間,找出瓶頸。
- 確認模型配對、框架版本、格式與硬體支援,並核對兩組權重的 LFM Open License 條款。
- 選取具代表性的圖片與任務,固定提示、生成參數和併發量,執行有無草稿模型的對照。
- 同時比較端到端延遲、解碼吞吐、答案品質、錯誤率與峰值記憶體,並觀察高百分位等待時間。
- 納入升級、監控與回歸測試成本,再決定是否擴大部署。
LFM2.5-VL-DSpark 是生成階段的加速選項。是否導入,取決於解碼瓶頸、硬體餘裕及相同工作負載下的端到端測試結果。
- LFM2.5-VL-DSpark 以草稿模型提出詞元候選,由 LFM2.5-VL-3B 驗證,主要加速文字解碼。
- 官方測試的數字受設備、框架、任務和輸出條件影響,解碼倍率不等於端到端延遲倍率。
- 導入前須量測瓶頸、確認相容性與記憶體,再比較延遲、品質、錯誤率和維護成本。
常見問題
常見問題
Q1:加入 DSpark 會不會改變模型輸出?
Liquid AI 表示,在其支援的貪婪解碼實作中,候選經目標模型驗證後可與基礎模型產生相同序列。其他生成參數、框架版本與視覺任務仍應在自有環境測試。
Q2:官方公布的加速數字能直接套用到自有系統嗎?
不能。數字對應官方測試的設備、推論框架、任務和測量方式。自有系統的提示長度、圖片處理、併發量及回答長度不同,端到端結果也可能不同,應重新量測。
Q3:導入前應記錄哪些端到端指標?
記錄影像前處理、提示預填、首詞元時間、解碼吞吐、完整請求延遲、答案品質、錯誤率及峰值記憶體,並按圖片、回答長度與併發情境分組。
「草稿模型以少量記憶體增加,換取更高的解碼速度,同時不改變輸出品質。」— Liquid AI 團隊對 DSpark 的發布說明。發布資料


