
NVIDIA 在 2026 年 10 月 28 日公開 Nemotron 3.5 Transcribe,將語音轉錄、翻譯、說話者標記和依提示調整文字格式放進同一個開放權重模型。這對整理會議、訪談和課程錄音的團隊很直接:原本要把音檔送過數個服務的流程,可能有機會集中處理;但「能做」不代表「在自己的語言、設備和逐字稿規則下夠準」。官方模型卡也將它定位為離線錄音處理,並非即時串流服務。評估部署前,應先把語言支援、硬體容量和人工修訂成本放進同一張驗收表。
Nemotron 3.5 Transcribe 提供哪些能力,先看哪個限制?
NVIDIA 表示模型可轉錄 40 種語言、提供 31 種語言與英文互譯,並在 13 種語言支援多人說話者標記;錄音最長一小時。這些數字分屬不同任務,應先對照目標語言和工作需求,不能將「40 種語言」理解為每種功能都同樣支援。
這個模型採用語音增強語言模型(Speech-Augmented Language Model,將音訊編碼器與語言模型結合),可依自然語言指令選擇逐字保留、書面化整理、補充領域詞彙提示,或要求翻譯與說話者標記。提示詞在此是指定輸出形式和詞彙線索,不是保證模型一定辨對專有名詞。若在會議系統中使用說話者標記,需理解它表示音檔內的發言者區分,不會確認錄音人物的真實身分。
對台灣團隊而言,模型卡列有普通話轉錄與英語互譯,但沒有因此證明台灣華語、台語混說、特定口音或繁體中文格式都能符合需求。官方支援矩陣也提醒,不同語言在轉錄、翻譯、多人發言和語碼切換上的能力有別。可先讀Granite Speech 的工作分工與驗收方式和離線轉錄導入前的檢查項目,再列出自己最常遇到的語言組合與交付格式。
「一段錄音沒有唯一正確的逐字稿,正確與否取決於閱讀者和用途。」這是 NVIDIA 技術報告對轉錄格式的說明(譯)。若法律紀錄要求保留語助詞,課堂筆記偏好刪除重複語句,兩者需要的輸出規則便不相同。
為什麼支援多語,仍不代表逐字稿可直接使用?
語言名稱只是起點,口音、混合語言、專有名詞、重疊發言和收音方式都會改變錯誤型態。發言者分離(diarization,標出不同聲音輪次)也可能把重疊對話的句子配錯人,需按用途人工覆核。
實例一是 NVIDIA 與 Agora 公開的課堂示範:課程結束後才把錄音交給 Nemotron,產生附逐字時間戳的文字,讓學生可沿著字幕回播。這呈現的是錄播後搜尋與複習的產品流程,不是即時字幕服務,也不是大規模課堂的效能證明。它提醒導入者先說清楚輸出要用在哪裡:搜尋回看可容許少量錯字;逐字引用或會議決議則需要更嚴格的人工確認。
第二個例子來自 NVIDIA 的醫療語音調校示範。團隊以印度醫療語音測試集做領域微調,在保留說話者的測試切分上,詞錯率由基礎模型最佳提示的 22.44% 降至 12.17%;然而品牌藥名完全吻合率仍是 36.6%,低於專科模型的 38.3%。這是特定資料、提示與評分方法下的技術案例,不代表一般會議或台灣醫療錄音會得到相同幅度改善。案例更重要的訊息是,整體詞錯率下降,不等於關鍵實體都已可靠。
語碼切換也值得單獨測試。PubMed 收錄的 HiACC Hinglish 語料研究包含成人與兒童的英印混語音訊;作者以其測試集進行基線實驗,發現以單語資料訓練的標準語音辨識模型,詞錯率表現約差 42%。這項結果只對應 Hinglish 資料與研究中的基線,不可套成 Nemotron 的成績;它說明「支援多語」與「能處理一句內切換語言」是不同驗收問題。
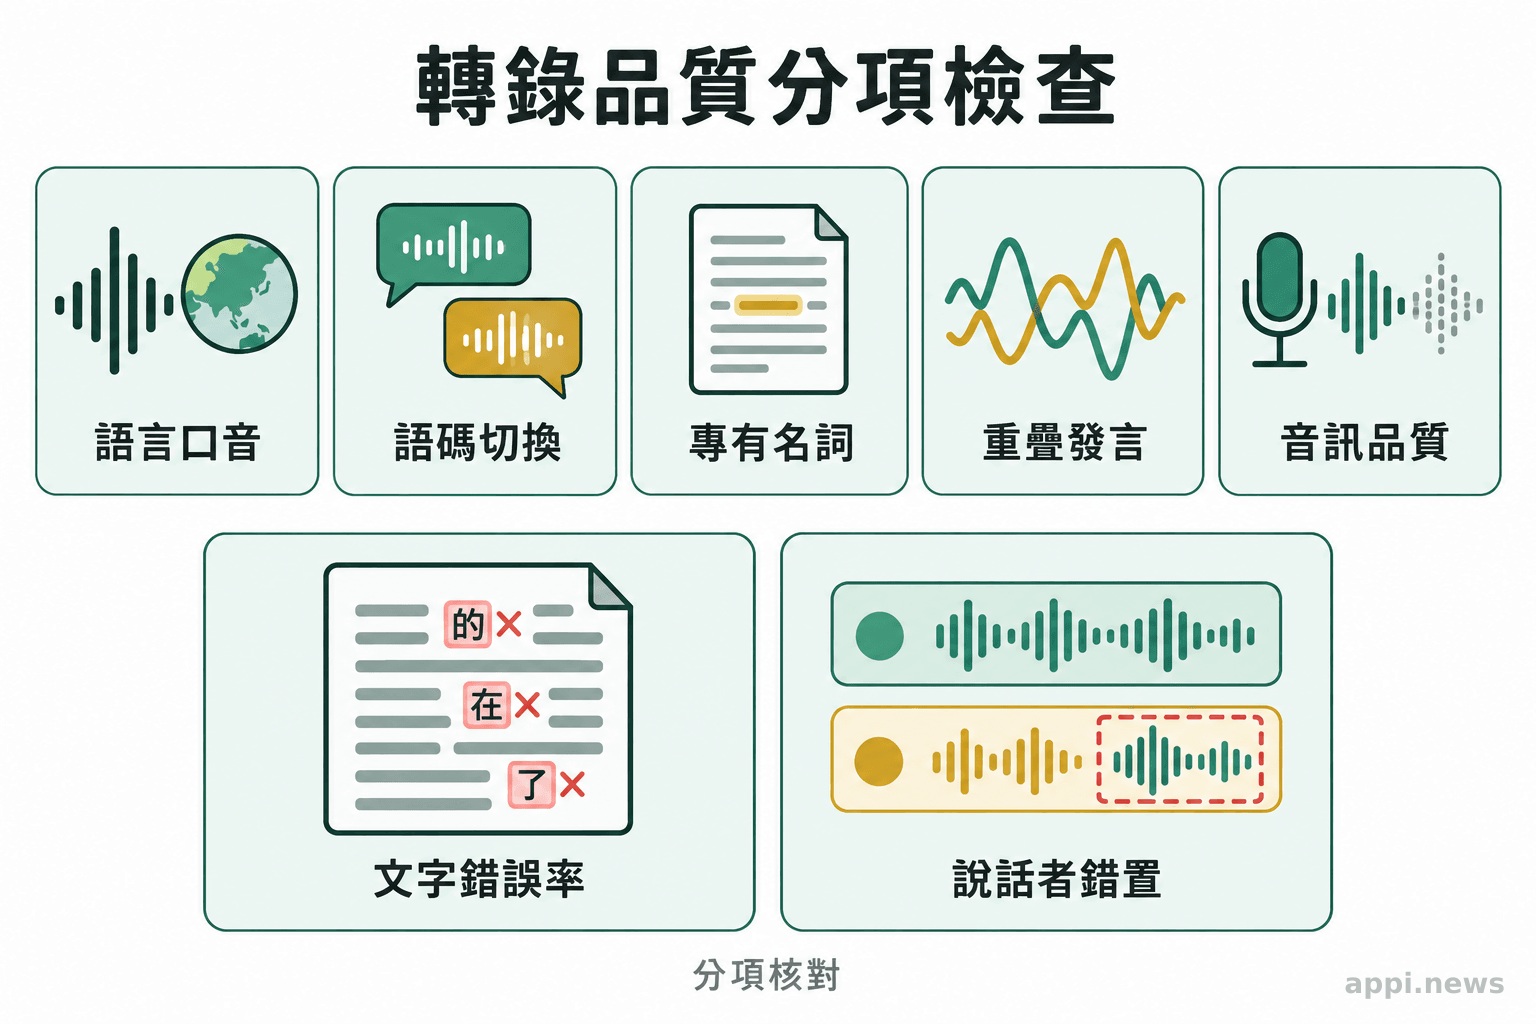
NVIDIA 官方基準公布多組公開資料集成績,並稱模型在部分開放權重排行榜居前。公開排行榜能提供同條件比較線索,但測試集、正規化方式和語言分布會影響數字;榜單的平均詞錯率不能代替組織內音檔驗收。測試至少要把逐字錯誤、專有名詞錯誤、說話者錯置、時間戳偏差和翻譯品質分開記錄,否則單一總分會掩蓋不適用的部分。
「如同任何語音模型,姓名、說話者變化與回答都應對照錄音抽查。」Hugging Face 上 NVIDIA 的模型說明也特別提醒這一點(譯)。模型輸出的流暢度不能當作音訊證據,尤其發言者標記若被拿去歸責、辨認身分或作為正式紀錄,更需要明確覆核程序。
自行部署時,運算和資料治理要怎麼盤點?
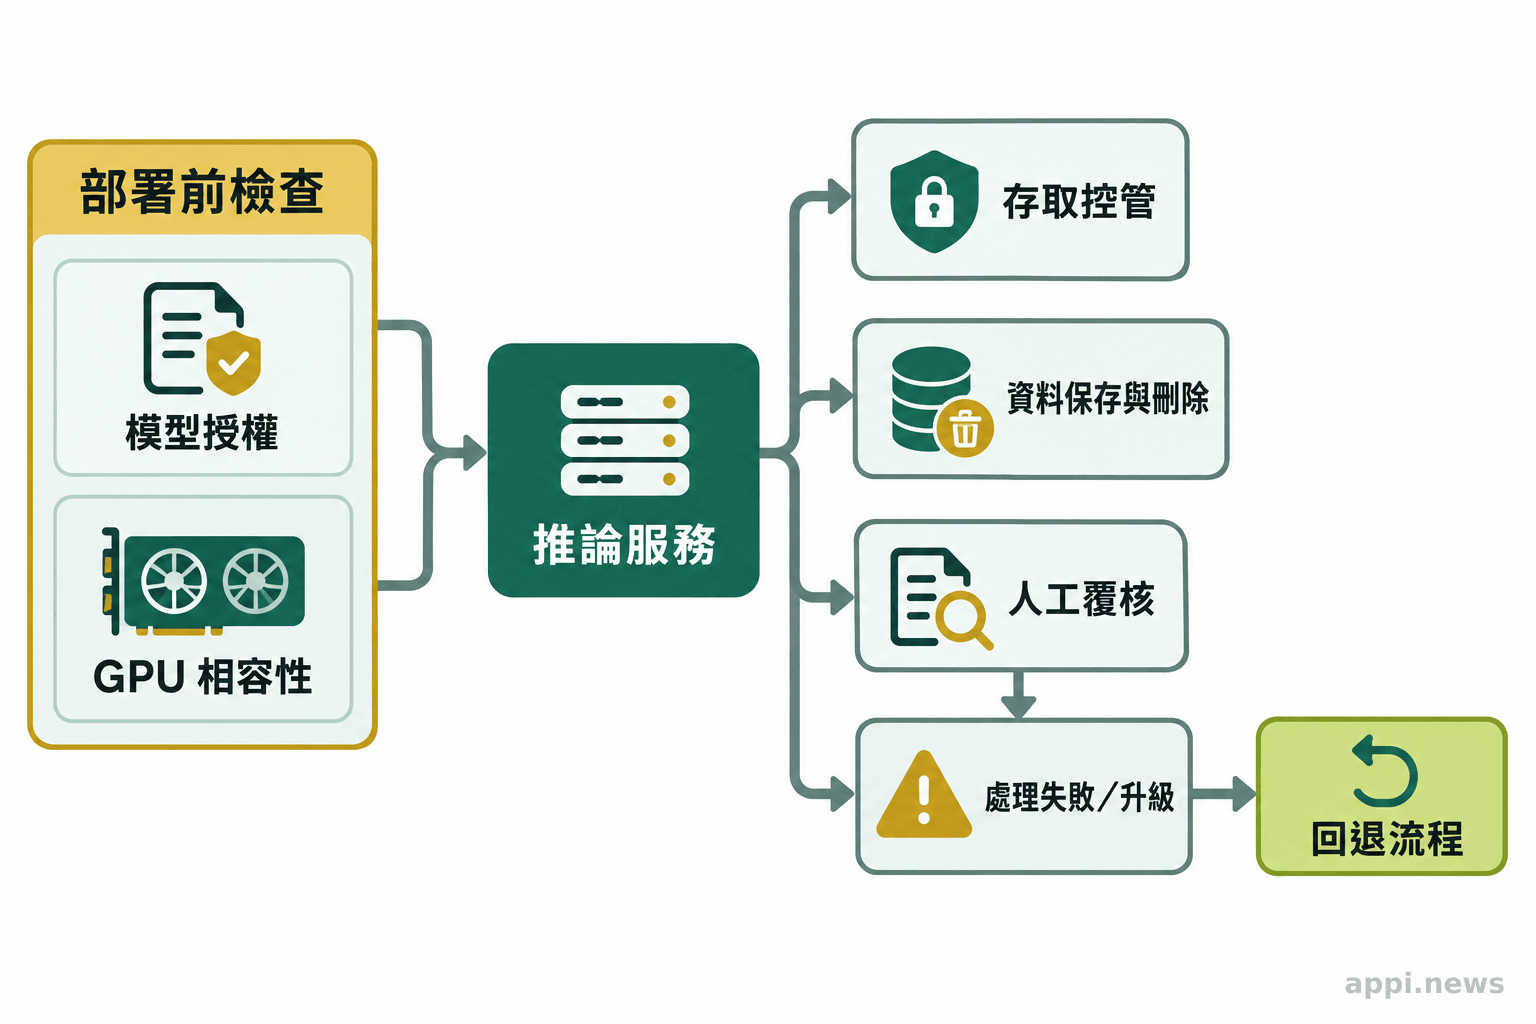
先確認權重版本和推論硬體,再估算音檔量、處理時限、併發數與重跑成本。模型卡列出的基準部署為單張 H100 80GB,另有不同精度版本及硬體相容表;活躍參數較少不等於整個模型不佔記憶體,也不代表一般桌機可直接部署。
實例三是 NVIDIA 官方模型卡提供的運行方式:模型可經 vLLM 或 SGLang-Omni 以服務介面整合,也可用支援的程式庫在應用程式內呼叫;權重有 BF16、FP8、NVFP4 等版本,但各版本對應的硬體與推論框架不同。這些選項改變的是部署路徑與效能取捨,團隊仍須用預計使用的 GPU、音檔長度和併發量實測延遲及記憶體。模型頁指出它處理的是錄製音訊;內部切分音訊並不等於提供即時串流辨識。
許可也要讀完整。官方模型卡將模型列為 OpenMDW-1.1 授權,並提醒套件可能包含第三方元件,使用者仍須遵守各自授權與告示要求。「開放權重」描述可取得模型參數,不代表程式、資料集和所有依賴都採相同授權,更不能直接推論任何商業用途都沒有條件。部署前應列出模型、推論框架、資料、外掛和硬體的版本與授權負責人。
音訊留在自有環境能改變資料傳輸路徑,卻不會自動解決個資與機密資訊管理。先確認錄音的處理依據、誰可存取、保存多久、是否需要去識別化、如何刪除,以及錯誤逐字稿由誰核准。若使用外部託管端點,還要確認資料傳送、保存及服務條款。這些設計應與既有會議或客服流程一起檢查,也可參考多人會議逐字稿的發言者標示方法。
如何用小規模測試判斷是否納入語音工作流?
挑選已取得使用權且具代表性的音檔,先建立人工校對稿,再讓現行服務與候選模型在相同條件下處理。逐項衡量辨識品質、延遲、總成本和治理要求,並預先定義哪些錯誤必須人工介入或退回原流程。
- 定義任務和輸出規則:區分逐字稿、整理稿、翻譯、時間戳與發言者標記;規定數字、英文縮寫、專有名詞和標點格式。
- 抽樣涵蓋困難音訊:納入目標語言、不同口音、台語或英語夾雜、多人重疊、遠場收音與背景噪音;不要只用乾淨的單人朗讀音檔。
- 建立人工基準:由熟悉語境的人校對參考稿,標出關鍵詞、發言輪次及需保留的語氣,再以同一批音檔比較現行流程與模型。
- 分項計算代價:記錄詞錯率或字錯率、專有名詞錯誤、說話者錯置、每小時音檔處理時間、GPU 時間、重跑比例及人工修正分鐘數。中文逐字稿可搭配字錯率,翻譯則另由雙語審核,不要混成單一分數。
- 設定門檻和回退:將「可自動發布」「需抽查」「必須逐句覆核」分級,設計模型失敗或低信心時回到原流程的方式。通過一小批測試後,再以新錄音持續抽查,避免測試樣本只代表少數使用者。
最後比較的是整體工作流,而非一次推論的速度:模型節省的整理時間,是否大於部署、整合、人工校正和維護的成本?若目標是錄音後整理,Nemotron 3.5 Transcribe 可列入離線候選;若需求是直播字幕、台灣華語混台語或高風險逐字紀錄,應先用自有樣本證明品質,再決定是否擴大使用。
- 先按任務核對語言矩陣,不把「40 種語言」視為各功能的共同保證。
- 以代表性音檔比較現行流程,分開計算文字錯誤、發言者標記、延遲和人工修訂。
- 導入前確認模型與依賴授權、GPU 資源、音訊保存規則及人工覆核責任。
常見問題
Q1:Nemotron 3.5 Transcribe 支援繁體中文嗎?
官方矩陣列出普通話轉錄與英文互譯,但沒有把繁體字輸出、台灣華語或台語混說列為單獨保證。用實際音檔測試辨識與字體格式,再決定是否需轉換或人工修訂。
Q2:它可以直接做即時會議字幕嗎?
官方說明定位為離線錄音處理,不是即時串流 ASR。課程示範是在錄音結束後送出音訊,再將含時間戳逐字稿與回放連結,因此不能據此推論直播延遲或即時穩定性。
Q3:說話者標記等於辨認出與會者身分嗎?
不是。標記的用途是區分錄音內的發言者或輪次,不能證明聲音屬於哪個真實人物。若逐字稿涉及決議、責任或正式紀錄,應由熟悉會議的人核對。
參考來源
- NVIDIA. (2026). NVIDIA Nemotron 3.5 Transcribe: Intelligent Transcription with a Speech LLM
- Motamedi M, et al. (2026). NVIDIA Nemotron 3.5 Transcribe and Granary v2: Intelligent Multilingual Transcription You Can Prompt and Adapt. *Hugging Face Blog
- Adams M. (2026). How Live Teaching Can Become a Lasting Learning Resource. *Agora
- Singh S, et al. (2025). HiACC: Hinglish adult & children code-switched corpus. *Data in Brief*, 62, 111886


