
Google DeepMind 表示,Gemini 4 Carbon 曾在內部連續工作數日,嘗試追查並修補大型程式碼庫和低階系統中的複雜錯誤。這是廠商描述的內部案例,呈現 Carbon 的長流程工程定位,尚不能直接代表一般團隊導入後也能得到相同成果。Carbon 公布時仍先提供給部分資安防禦者及受信任合作夥伴;正在評估模型的團隊,第一個問題因此是:手上的任務是否需要這類長時間代理能力,以及現在能否取得可測的產品介面?
若團隊目前已能使用 Gemini 4 Argon,可以先用自己的代表任務建立品質、時間與成本基準;Carbon 可列入候選,等開放後再以相同條件複測。這種安排也呼應如何評測 Gemini 4 Argon:從入口確認到任務成本驗收所整理的做法:先確認入口,再計算任務成本,而非只看宣傳頁上的單一分數。
Google 發表 Carbon,但目前採分階段開放
截至 2026 年 10 月 28 日,Google 表示 Carbon 先向部分資安防禦者開放,再逐步提供給 Fairwind 計畫中的受信任合作夥伴;開發者、企業與一般消費者尚未全面開放。
Google 表示,Carbon 在自家團隊的長時間編碼工作中,可處理跨大型程式庫追查根因、修補細微錯誤等多步任務。這讓 Carbon 的定位偏向持續執行、需要多輪工具操作的工作;若任務只是摘要、改寫或短程式補全,這類能力提升未必能抵銷等待、整合和覆核成本。發布消息也沒有提供一般使用者可立即選用的入口。
Gemini 4 Argon 已有 Gemini App、Gemini API、Google AI Studio、Gemini for business 等發行管道,具體可用範圍仍要看帳戶、地區、方案與產品條款。Google 的 Argon Model Card列出這些分發管道;台灣團隊應以登入後實際可見的模型與 API 文件確認,而不要從全球發布消息推定本地帳戶已取得權限。
Gemini 4 Carbon 和 Argon 基準比較:依任務看差異
Artificial Analysis 比較頁以 Gemini 4 Carbon (High) 和 Gemini 4 Argon (High) 為比較對象,列出的 Intelligence Index v5.0 分數為 59 對 50。這是該平台依其評測彙整出的比較結果,不等於 Google Model Card 的單項基準分數。
同一比較頁列出 Terminal-Bench 4.0 為 Carbon 65%、Argon 57%,FrontierCode 2.0 為 41% 對 26%,AutomationBench-AA 則是兩者皆為 78%。其中 AutomationBench-AA 是 Artificial Analysis 比較頁列出的測項,不能與 Google Argon Model Card 中 AutomationBench 的 51.3% 直接互換,兩者名稱、版本或評測口徑不同。該頁也列出兩者每百萬 token 標價相同,但估算任務成本及回應延遲不同。這些分數只描述頁面所列測項與設定,不能推成所有程式工作都會有同等提升。平台頁面並註明 Carbon 尚無公開 API,因此外部使用者目前無法依一般 API 方式重現所有測試。
Google 官方另公布 Carbon 在 SEC-bench Pro 漏洞發現測試為 88.2%、ExploitGym 測試為 54.8%、CWE-bench 修補測試為 71.0%,並表示這些資安基準是在未啟用防護措施下評估。指標各自測量漏洞發現、可利用性驗證和修補,不代表實際攻防環境的完整安全成效,也不能解讀成部署後的防護保證。資安能力評測涉及雙重用途,相關討論應限定在防禦評估、漏洞修補及安全治理。
「Carbon 在多項資安基準上的評估未啟用防護措施。」這項測試條件由 Google DeepMind 在發布說明中揭露,引用分數時應一併保留。
第三方測試提供另一種觀察角度。Artificial Analysis 在自家 Intelligence Index v5.0 列出 Carbon 59、Argon 50;WebDev Arena 則以使用者對戰投票形成網頁開發 Elo 排名,Google 表示 Carbon 增加 89 分後排名第 4。前者是第三方設計的多項基準彙整,後者偏向網頁成果的成對偏好評比,兩者都不是在讀者自己的程式庫、資料或安全政策下測出來的部署結果。Google 的發布資料另稱,Carbon 產生安全程式碼的內部成功率較 Argon 高逾兩倍;這是廠商內測,不等同獨立重現。
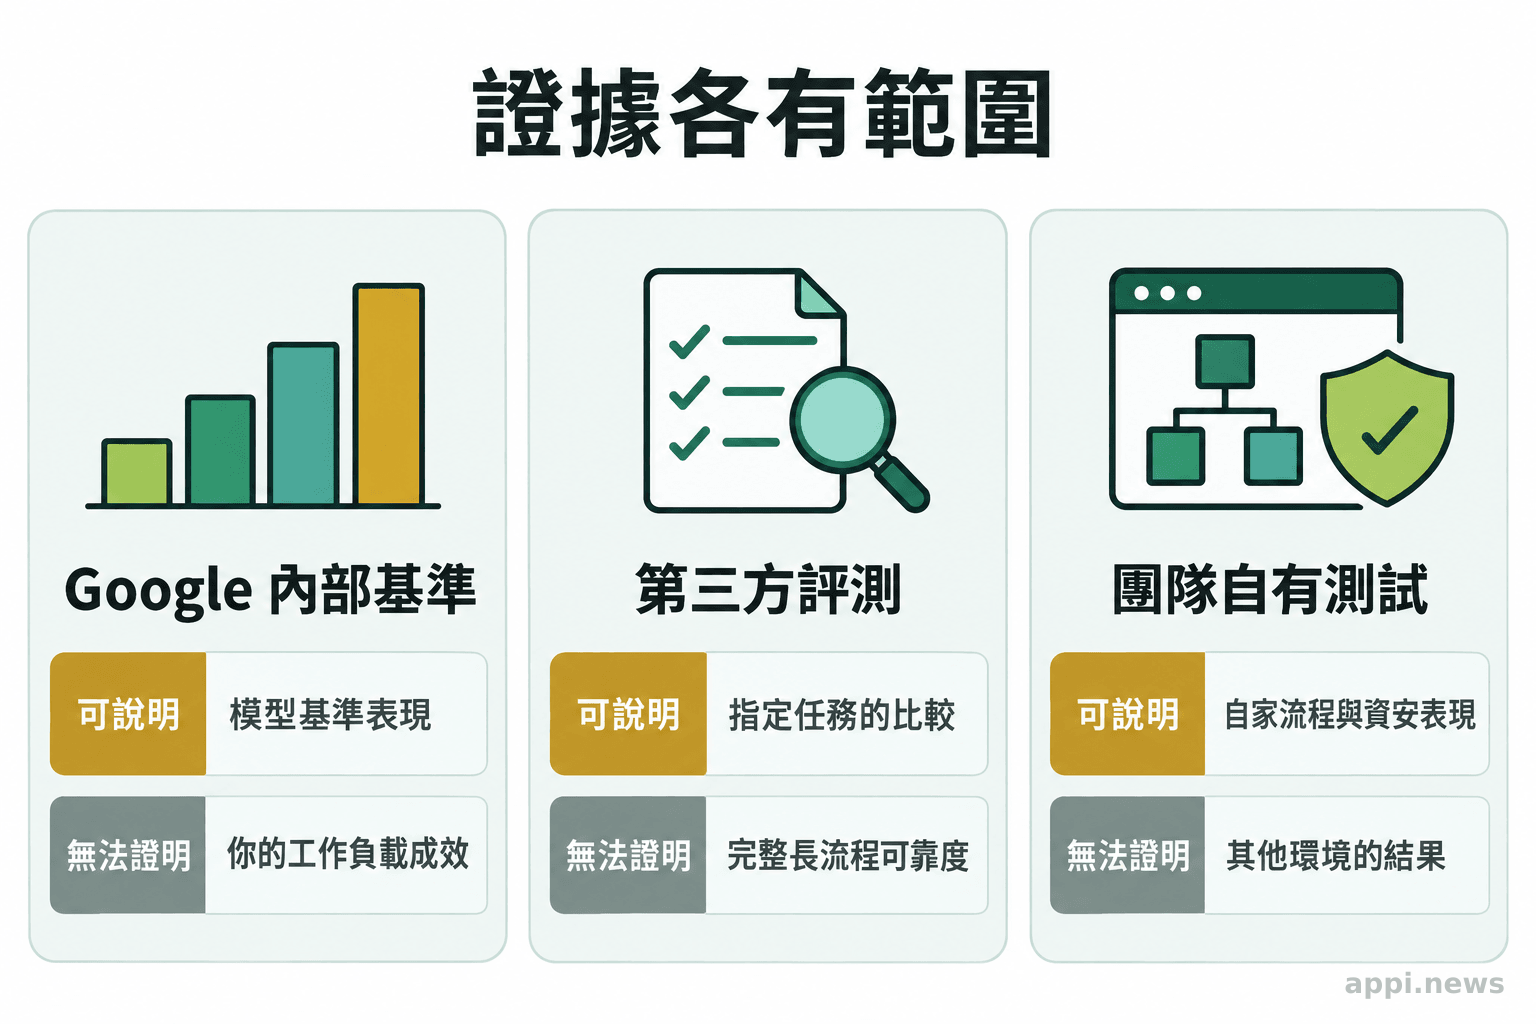
高分為什麼不等於工作流程會變好
不能直接代表;任務內容、測試環境、推理設定、工具權限、資料品質與防護措施都會改變模型輸出和完成成本。
例如,程式碼修補測試可能提供可執行的專案、明確的錯誤條件和測試工具;企業內部工作卻可能遇到需求含糊、權限分散、舊系統文件不足等狀況。即使模型在基準中成功修補,仍須檢查改動是否符合團隊架構、測試能否通過、審查者是否能理解差異,以及代理是否只碰到授權範圍。
「長時間任務」也包含模型以外的系統條件。模型需要哪些檔案權限、能否呼叫終端或外部服務、遇到不確定時會否停下詢問、日誌如何保留,這些都影響任務是否能安全完成。若權限與回復機制沒有設計好,模型更能持續行動也可能擴大操作錯誤的影響範圍。
Google 在 Carbon 發布說明中指出,SEC-bench Pro、ExploitGym 與 CWE-bench 的分數是在未啟用 guardrails(防護措施)的評估條件下取得。這些結果可用來比較特定能力,不宜外推到具備產品防護的實際服務;團隊還要核對部署版本的安全控制、授權、人工覆核和事件處理流程。Google 的Argon Safety & Security Report也說明 Argon 評測會區分模型本身能力與部署緩解措施,兩者不能混為一談。
現在先測 Argon,還是等 Carbon 開放?
若已取得 Argon 且有明確任務,可先建立自有基準;若專案依賴 Carbon 尚未公開的入口或安全條件,則把它列為待驗證候選,不預設發布即能接入。
先測 Argon 適合需要近期決策、能取得模型入口,也能由人員核對輸出的團隊。以相同資料和工具跑數次代表任務,記錄一次成功率、人工修改量、耗時、token 使用、費用和失敗類型。若任務涉及大型程式庫,可另記模型是否找到根因、測試是否覆蓋修補,以及是否越出授權範圍。這比只用一個看似完整的成功案例更能反映日常變異。可參考Gemini 4 Argon 適合哪些工作?先看任務、成本與驗證條件把任務、成本與驗證條件放在同一張評估表。
等待 Carbon 期間,先列出開放後的驗收條件:同一批任務、相同工具權限、同一套測試和覆核標準;再確認 API 或產品入口、資料保留與訓練政策、區域支援、服務條款、價格及配額。若工作涉及客戶資料或醫療資料,需額外確認敏感資料處理、權限控管、操作日誌、人工覆核和供應商依賴。模型發布不會自動替團隊完成這些決策。
「我們會逐步向更多受信任夥伴提供 Carbon,並在向開發者、企業與消費者開放前持續調整防護措施。」這是 Google 對開放順序的說明,並未承諾一般開放日期。
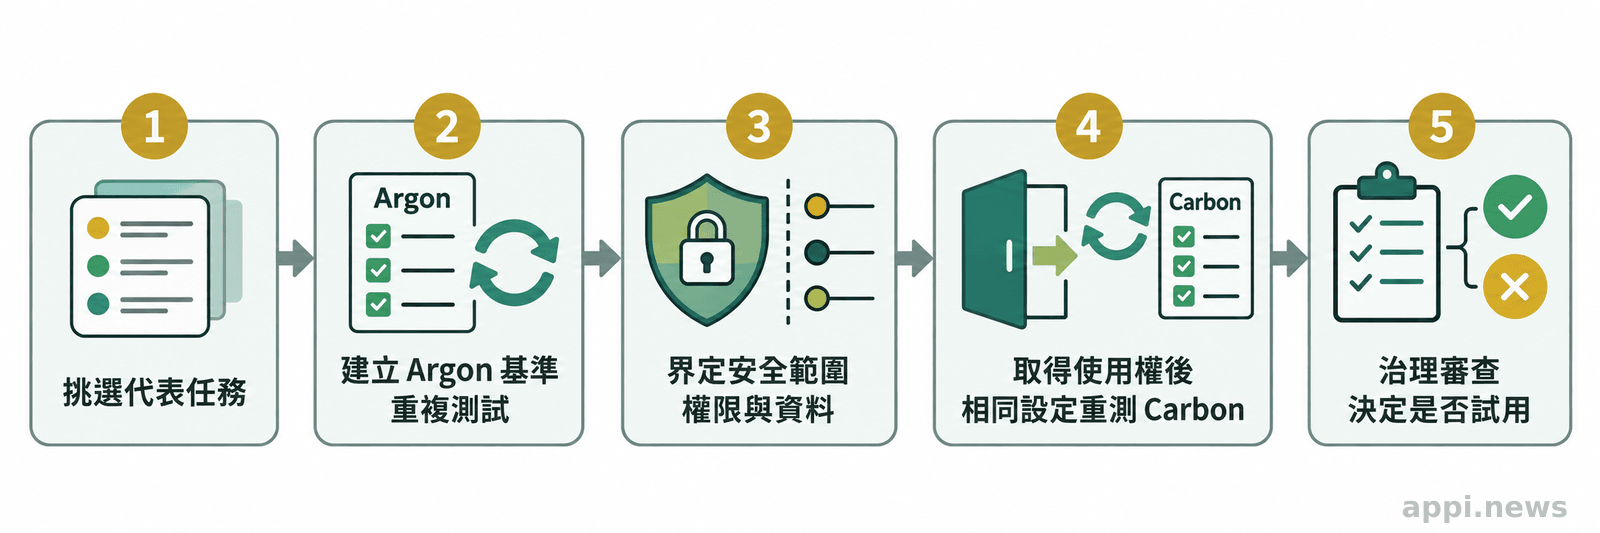
用小型任務評估表做模型選擇
先用一項可重複、可由人員驗證的代表任務比較輸出品質、耗時、成本和人工覆核,再加上資料政策及權限條件。
- 挑一項團隊每週會遇到的實際任務,保留固定輸入、成功標準與測試資料,移除不必要的敏感資訊。
- 以目前可取得的 Argon 執行多次,記錄正確率、人工修改時間、總耗時、token 成本與失敗原因。
- 定義不可接受的錯誤、必要的人工作業關卡,以及代理可讀寫的資料和工具範圍。
- Carbon 開放後,使用相同設定重測;只有當品質或成本改善足以抵銷整合與治理成本,才進入小規模試用。
- 每次模型版本、價格、地區或服務條款變動時,重新核對入口與資料處理方式。
| 評估面向 | Gemini 4 Argon | Gemini 4 Carbon | 團隊要核對的事 |
|---|---|---|---|
| 開放狀態 | Google 列出 App、API、AI Studio、商務等管道 | 先開放給部分資安防禦者及受信任夥伴 | 自己的帳戶、地區與產品是否有入口 |
| 公開基準 | Google 與第三方均有多項測試結果 | Google 公布資安、編碼與長流程結果;第三方有部分比較 | 測項與設定是否對應實際任務 |
| 費用 | 依方案與產品而異 | Google 公布的初期 API 定價資訊為與 Argon 相同;目前尚無公開 API 供一般團隊實測 | 正式開放時以實際價目、快取及配額為準 |
| 導入條件 | 可先建立當前基準 | 尚需確認可用介面、權限與防護 | 資料、日誌、人工覆核及退出方案 |
- Carbon 的基準領先幅度依任務而異;相同分數不代表相同工作效益。
- 截至 2026 年 10 月 28 日,Carbon 尚未全面開放,Argon 可作為目前的測試基準。
- 用同一項自有任務比較品質、時間、成本、覆核工作與資料治理,再決定是否切換。
常見問題
Q1:Gemini 4 Carbon 何時能一般使用?
截至 2026 年 10 月 28 日,Google 尚未公布一般開放日期,僅表示先提供給部分資安防禦者及受信任合作夥伴,之後再逐步擴大。
Q2:Argon 還值得測試嗎?
若團隊現在能取得 Argon,且已有具體任務和人工驗收方式,測試可建立基準,供 Carbon 開放後公平比較。先確認自己的帳戶及地區是否有相應功能。
Q3:Carbon 的基準分數可以當作導入效益嗎?
不宜直接視為效益。基準分數只反映特定任務與設定,導入還要計算完成品質、錯誤處理、工具整合、人工覆核、費用和資料治理成本。
Q4:資安測試分數代表模型可以直接拿來防護嗎?
不代表。需確認測試是否啟用防護措施、產品版本的權限與監控設計,並在授權的防禦環境中由人員檢查結果。
參考來源
- Google DeepMind (2026). Introducing Gemini 4 Carbon. *Google Blog
- Artificial Analysis (2026). Gemini 4 Carbon (High) vs. Gemini 4 Argon (High). *Artificial Analysis
- Google DeepMind (2026). Gemini 4 Argon Model Card. *Google DeepMind
- Google DeepMind (2026). Gemini 4 Argon Safety & Security Report
- Ryan Whitwam (2026). Google announces Gemini 4 Carbon, its latest frontier AI model that you can’t use. *Ars Technica


