
Anthropic 研究團隊以單張 H100 為 400B 參數的 Llama 4 Maverick 生成證明,批次速率每秒約 110 token、單份約 19 MB;相較 vLLM FP8 prefill,GPU 時間多約 70 至 95 倍。
回答看來正確,仍無法單憑文字辨認服務呼叫哪個模型。AI 數學證明的檢查方式也在驗證主張,但對象是推導,FlashProve 則檢查模型推論。
AI 模型驗證要看什麼?FlashProve 實測揭露證明成本
Anthropic 以 Llama 4 Maverick 展示推論可附上簡短證明;其特定測試中,GPU 時間高於 vLLM FP8 prefill。
模型服務商只交付輸出時,使用者看不到權重;多模型路由與評測因此需確認版本。FlashProve 以承諾連結輸出與權重。
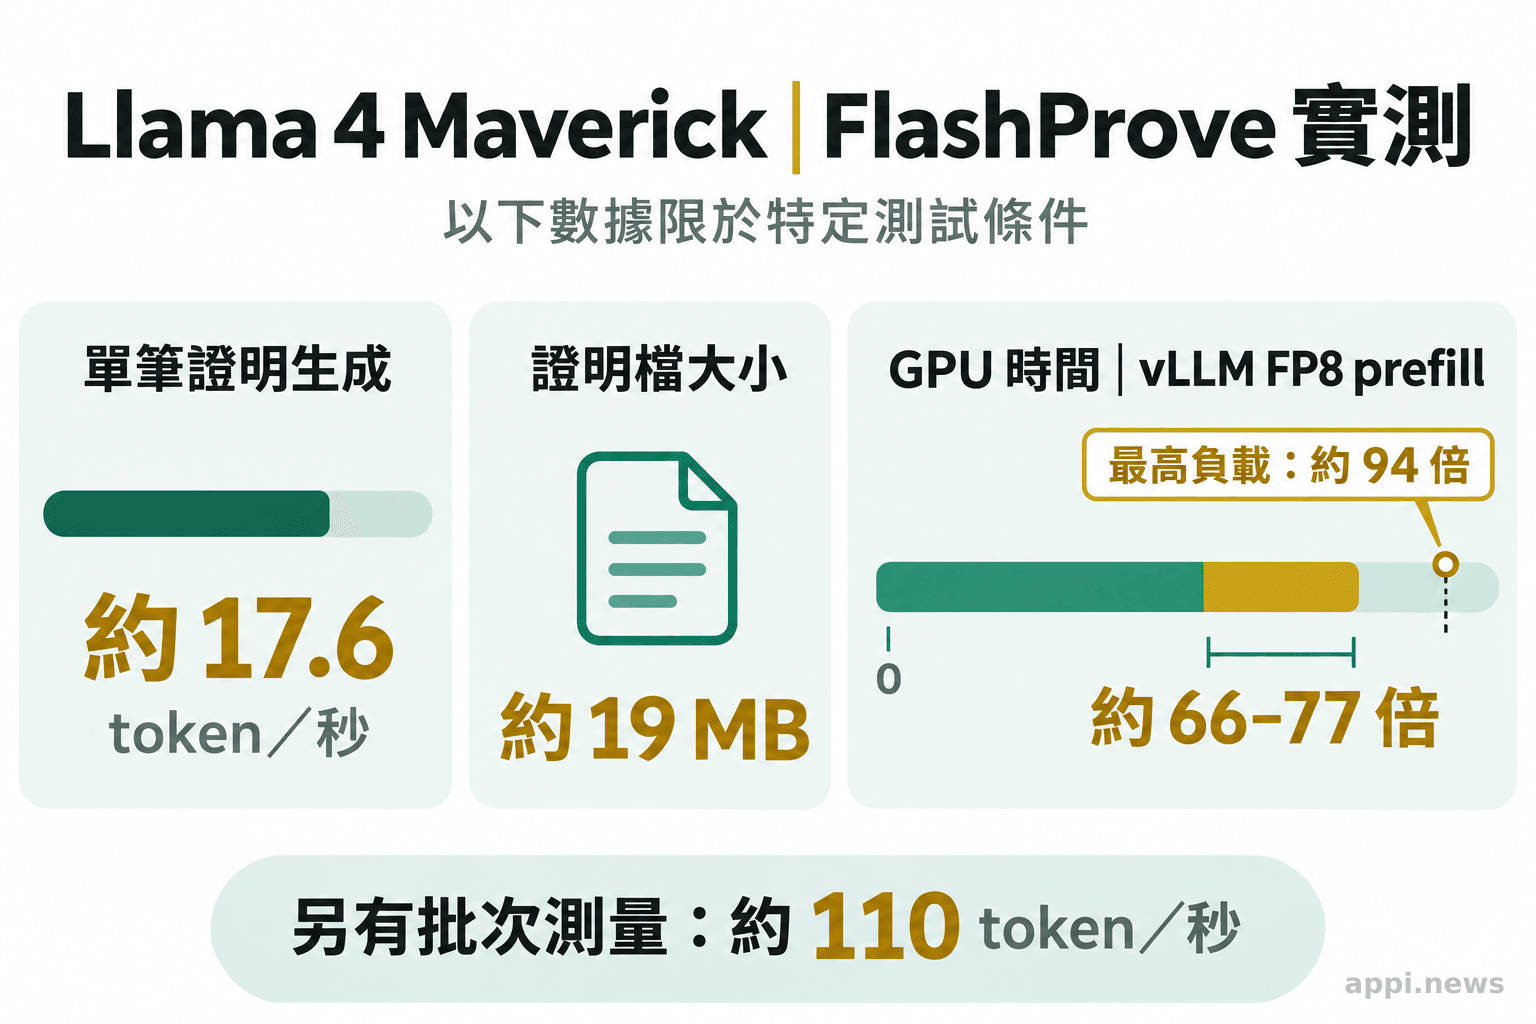
研究在單張 H100、24 個 CPU 核心上測試 4-bit 權重轉成的整數模型。1,024-token 窗口中,每份只檢查提示後一個 token;24 件批次約 223 秒,證明約 19 MB。相較同模型 vLLM FP8 prefill,GPU 時間約 66 至 77 倍,最高負載約 94 倍,僅適用此條件。
VerInf 研究者為 Llama 4 Maverick 生成證明,Anthropic 整理結果為每秒約 0.02 token、證明 93.6 GB、驗證近一天。商業團隊 Attestable 則以單張 H100 為 Gemma 4 31B 示範生成,回報每秒 53 至 77 token,當時未公開程式庫。條件不同,不宜直接排名;數據見Anthropic 整理。
模型來源證明要驗證什麼?從權重承諾到回答證明
服務商先公布權重承諾,再為提示與輸出生成證明供驗證者檢查。
「承諾」像權重的密碼學指紋。服務商離線公布承諾,驗證者可保存而不取得權重。在密碼學假設及流程成立時,承諾可綁定權重,不能直接還原權重;更換權重須以新承諾驗證。
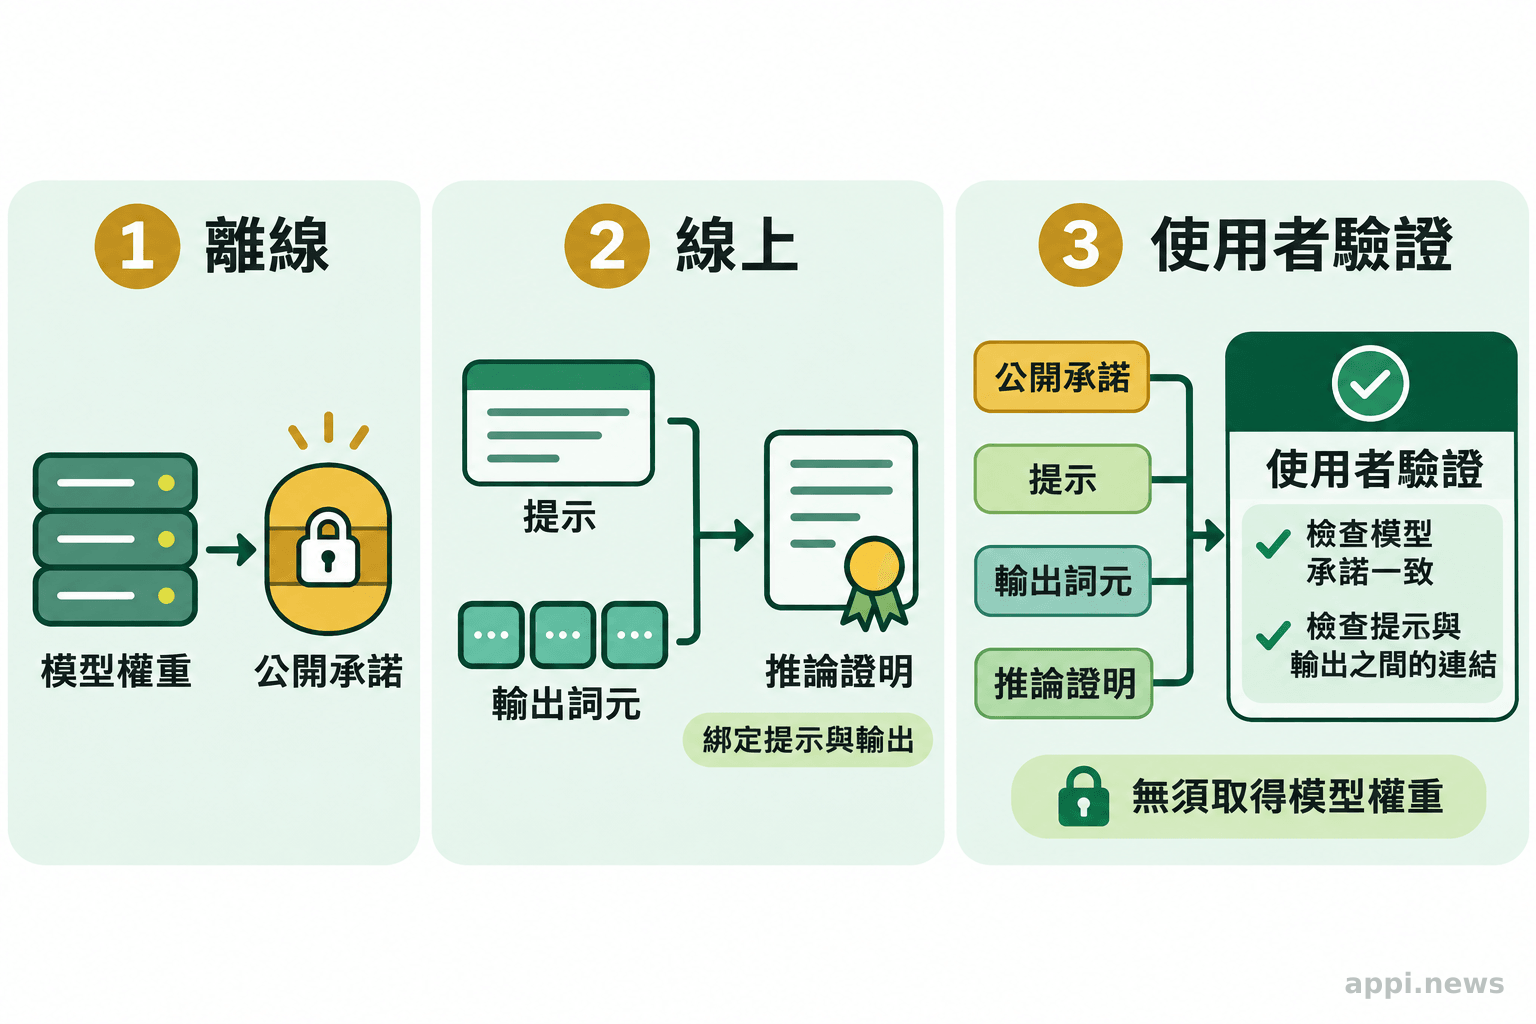
服務商在線上為請求產生證明。驗證者持承諾、提示、輸出 token 和證明即可檢查,不必下載權重或重跑模型;報告測得 CPU 驗證約 17 至 21 秒。
「任何持有承諾、提示與回答的人,都可以在沒有權重的情況下檢查:這組已承諾的權重在該提示下會產生這些 token。」Anthropic 等作者於《FlashProve: an open-source library for provable inference》的說明(譯述)
第三方可藉此確認模型版本;模型更新後重新驗證舊評測仍須檢查表現與資料品質。
零知識證明能確認模型身分,但不能替回答品質背書
不能。它確認的是指定權重在特定推論條件下產生指定 token,不判斷答案是否符合事實、完整或公平。
零知識證明(zero-knowledge proof)讓驗證者確認計算條件而不取得秘密資料。FlashProve 隱藏權重與推論中間步驟,不隱藏架構;研究使用 Mixture-of-Experts(專家混合,MoE)。
「我們的系統隱藏模型權重;隱藏模型架構並非本系統的目標。」Anthropic 研究說明(譯述)
證明通過不代表回答正確、無幻覺或偏見,也不代表模型適合任務。稽核仍須檢查輸出品質、版本、資料處理與責任。
部署前要先算證明生成成本與服務延遲
效能受硬體、量化、負載與批次設定影響,部署前須以自身流量量測。
測試窗口為 1,024 token,但證明只檢查提示後一個 token,採 greedy decoding(貪婪解碼)。逐筆約 58 秒、每秒 17.6 token;檢查每個輸出 token約每秒 39.1 個,證明檔約 19 MB。
即時服務須量測等待、傳輸、驗證及重試,並決定證明完成前是否顯示回答。
哪些使用情境值得評估 FlashProve,哪些限制仍待解
模型路由、獨立評測或稽核可評估來源證明,合用與否取決於延遲、成本及模型條件。
採購者可查核合約指定模型,評測者可確認測試使用同一權重,稽核者可追查模型版本。這些是需求情境,並非已部署案例;Anthropic 當時沒有部署計畫,GitHub 標示原型不再維護。
目前方法聚焦 MoE、整數權重與 greedy decoding,不能外推至其他架構、浮點或抽樣解碼;長上下文也待驗證。Lean(形式化證明助理)呈現數學性質,但程式與規格尚未完成等價證明。
試用先限定模型、解碼及請求長度,再比較成本與延遲。
整合前用五項問題檢查模型來源驗證是否可用
向模型服務商確認承諾、證明範圍、驗證者、失敗流程與成本。
-
承諾如何固定? 確認權重承諾如何對應模型版本及更新紀錄。
-
證明涵蓋什麼? 確認檢查整段輸出或特定 token,是否含系統提示、工具呼叫及前後處理。
-
誰負責驗證? 確認執行者,以及驗證器和快速執行程式碼能否獨立檢查。
-
失敗時怎麼處理? 定義證明缺漏、驗證失敗或版本不符時的拒收、隔離與紀錄方式。
-
成本如何量測? 以實際模型、上下文、解碼與併發量,測量生成時間、延遲、檔案大小及驗證時間。
- FlashProve 以權重承諾和推論證明,檢查輸出是否符合指定模型。
- 證明不揭露權重,但不證明回答正確,也不隱藏模型架構。
- 效能數字來自特定測試,需另量測延遲與成本。
常見問題
Q1: FlashProve 是已經可以採用的商用服務嗎?
不是。Anthropic 當時沒有部署計畫,GitHub 標示原型不再維護。
Q2: 零知識證明會把 AI 模型架構也藏起來嗎?
不會。FlashProve 隱藏權重與推論中間資訊,不隱藏架構。
Q3: 證明通過就代表 AI 回答可信嗎?
不代表。它驗證模型與輸出,不評估答案正確性、偏誤或用途適切性。
Q4: 為什麼不能直接用 110 token/秒估算自己的服務成本?
這是特定模型與硬體量測;模型、流量及解碼方式都會影響結果。
參考來源
- Roy Rinberg, Alex Allain, Alessandro Chiesa, Miranda Christ, Rahul Dalal, Giacomo Fenzi, Ben Mayer, Guy Weissenberg. (2026). *FlashProve: an open-source library for provable inference*. Anthropic 等作者技術報告
- Anthropic. (2026). *Progress on provable inference for large language models
- Russell Brandom. (2026). *Anthropic is working on a system to prove AI models’ identity*. TechCrunch
- Anthropic. (2026). *GitHub - anthropics/FlashProve: A research prototype for zero-knowledge proofs of AI inference. Not maintained. · GitHub


