
Underdog 在 2026 年 11 月展示 Woof:TechCrunch 報導指出,這款約 32MB 的文字轉語音模型被放進瀏覽器互動遊戲,玩家在打字機輸入文字後,遊戲會把它唸出來;轉動音樂調諧器則能生成不同音樂。這讓「小模型也能在本機做語音功能」有了可操作的展示,但還不能直接回答它在不同手機、筆電上的速度與音質是否足以支援正式產品。
開發者第一個要分清楚的,是展示證明了某種能力存在,還是證明它能穩定滿足某個產品需求。Woof 的報導沒有提供標準化延遲、不同硬體的重現結果或獨立音質評測。若正在規劃離線語音功能,可先參考文字轉語音模型的評測指標與限制,再把 Woof 放進自己的測試條件,而不是只看模型檔案大小。
Underdog 的瀏覽器展示能確認哪些能力?
目前可確認的是,Woof 被用於瀏覽器中的文字轉語音互動,展示也包含音樂調諧器生成音樂。 這些是產品展示中可觀察到的功能,並不等於已有完整的效能或品質測試。
TechCrunch 報導,Woof 約 32MB、含約 3,100 萬個參數;Underdog 說模型可在多數裝置上執行,且不需網路連線。這項離線能力是公司的說法,報導沒有列出支援的裝置清單、瀏覽器版本或測試條件。對開發者而言,這表示可以把它列為候選方案,尚不能據此承諾所有目標用戶都能順利執行。
同一報導也提到 Underdog 先前推出 Bark 語音轉文字模型,並另有可在筆電執行的 270 億參數模型。它們是不同用途、不同規模的產品案例:Bark 面向語音辨識,Woof 面向語音合成,筆電模型則是另一種本地執行方向。這些發布顯示廠商正在探索裝置端模型,但單一公司的產品組合不能替代跨裝置測試,也無法證明模型適合相同的工作流。
這三個案例可以各自回答不同的問題。Woof 的打字機與調諧器呈現語音、音樂生成介面;Bark 的定位是語音辨識,報導提到它可用於轉錄與聽寫;另一款 270 億參數模型則被描述為能在筆電執行。它們讓開發者看到「本地 AI」涵蓋不同模型大小和任務,但 TechCrunch 沒有提供彼此一致的速度、品質或資源基準,因此不能把發布資訊排成效能排名。若要比較,需自行選定同一組裝置、輸入和指標。
瀏覽器裡能跑起來,還要看瀏覽器與裝置提供什麼執行條件。MDN 對 WebGPU 的說明指出,這項 API 目前並非所有主流瀏覽器都支援,並且只能在安全環境中使用;實際可用功能與限制也會依裝置和瀏覽器而異。這也是Phonon TTS 裝置端部署檢查所涉及的共同問題:模型小,不代表執行環境自動相容。
「WebGPU API 並非 Baseline,因為它無法在一些最廣泛使用的瀏覽器中運作。」(MDN Web Docs,WebGPU API 說明(中文意譯))
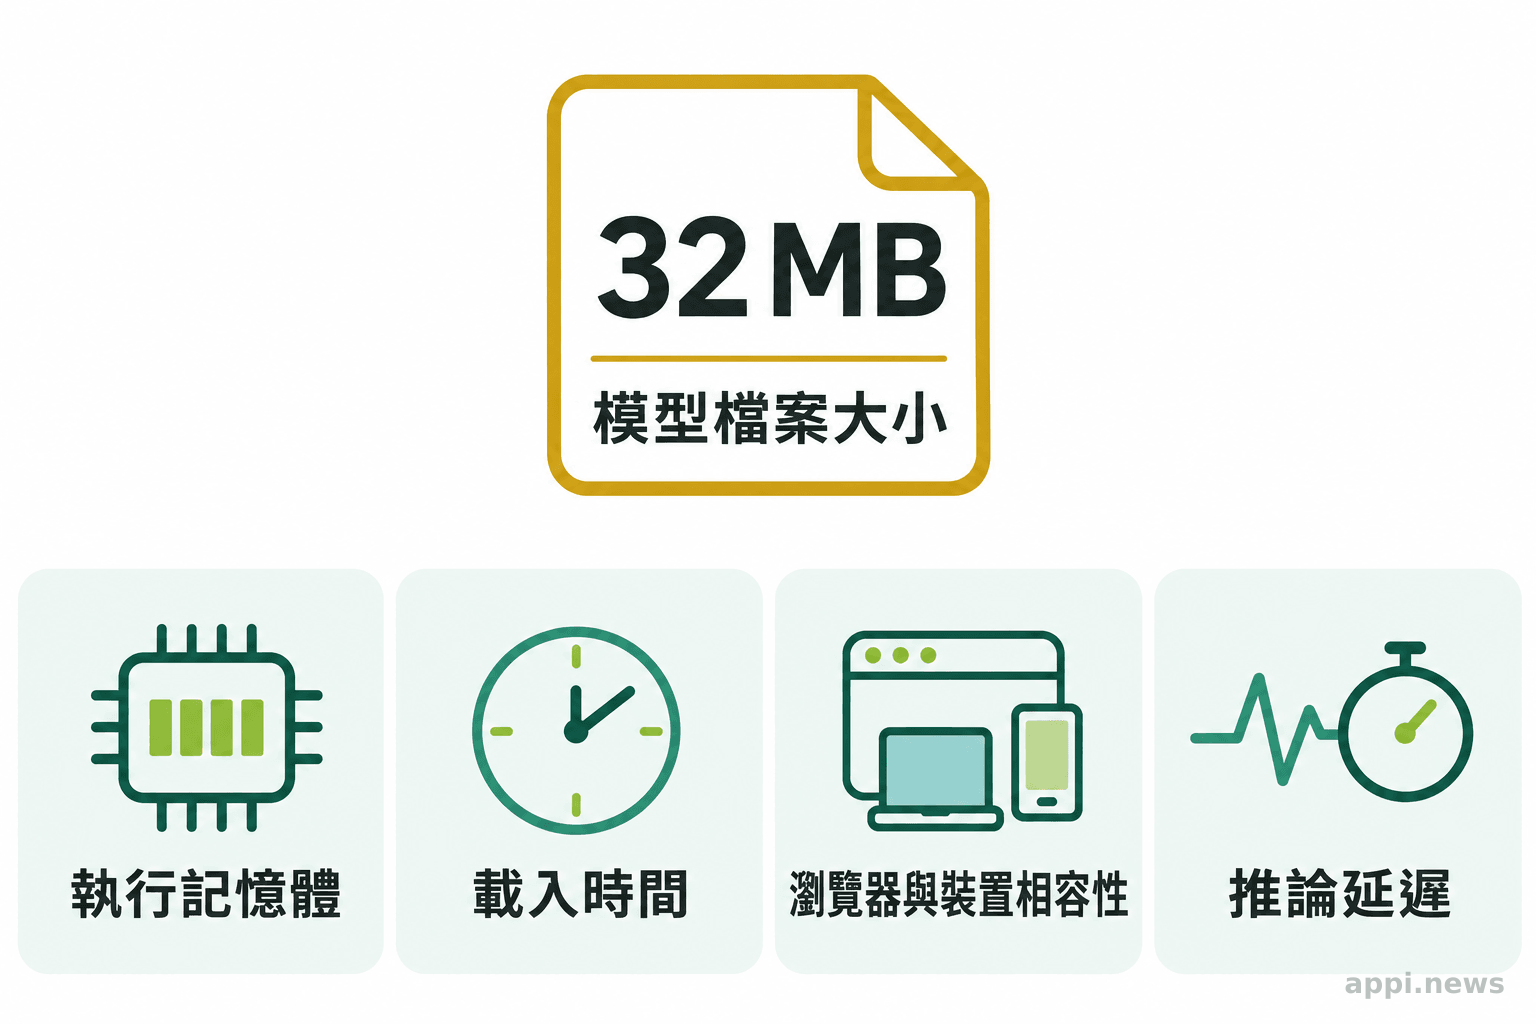
32MB 檔案大小為何不能代表執行效能?
不能。32MB 描述的是報導中的模型大小,並未說明推論時的記憶體占用、載入時間或生成速度。 這些數值需要在預定使用的軟硬體環境實測。
模型檔案下載後,程式還要將資料載入執行環境,建立運算所需的中間資料,並處理輸入文字與輸出音訊。使用 GPU 或 CPU、瀏覽器分配的資源、同時開啟的分頁,以及裝置可用記憶體,都可能影響實際使用感受。光看下載檔案大小,無法推算完成一次語音生成需要多少時間或記憶體。
Chrome 開發者文件整理 WebGPU 無法使用的常見情況,包括瀏覽器版本、硬體或驅動支援、圖形加速設定和安全連線要求。即使某台電腦的瀏覽器成功開啟展示,也不代表不同作業系統、瀏覽器版本與整合方式會得到相同結果。測試時至少要記錄裝置型號、作業系統、瀏覽器版本、GPU 或 CPU 執行路徑,以及模型首次載入和後續生成的時間。
Underdog 創辦人 Sigil Wen 在 TechCrunch 報導中談到,希望把更多模型帶到人們已擁有的裝置上。這是產品發展方向的陳述,不是 Woof 在多數裝置上已通過效能驗收的證據。若產品要支援低階手機或舊電腦,工程團隊仍得訂出最低規格,並測試記憶體不足、GPU 不可用、分頁被背景暫停等失敗情境。
「我認為幾個月內,我們就能在你已經擁有的裝置上執行今天多數能力成熟的模型。」(Underdog 創辦人 Sigil Wen,接受 TechCrunch 訪問時的說法(中文意譯))
語音與音樂要怎麼分開驗收?
語音要檢查可懂度、發音和長文字穩定性;音樂則要另外確認輸出變化是否可控、音質是否符合用途。 一段展示能產生聲音,不能代替這兩類品質驗收。
語音測試要使用產品真正會遇到的文字,而不只是短句。可準備一般句子、較長段落、數字、日期、縮寫、專有名詞與不同語言,逐項檢查漏字、誤讀、停頓和語調。若功能是朗讀通知,短句清楚也許已足夠;若要播報長篇內容,則還要觀察連續生成時的穩定度、音色一致性和聽覺疲勞。
音樂調諧器呈現的是可以透過介面操作音樂生成。真正接入產品時,還要回答使用者能控制哪些特徵、同樣輸入是否可重現、輸出格式和長度是否合用,以及是否有延遲或中斷。這些問題與文字轉語音的發音品質不同,不能用一個「聲音聽起來不錯」概括。
產品驗收還要把隱私與離線分開。若模型確實在裝置本機推論,音訊可能不必送到雲端;但仍須檢查網頁載入時是否下載模型、遙測是否傳送使用資料、更新機制如何運作,以及網路中斷後哪些功能仍可用。本地執行本身不能證明整個應用程式不會傳送資料。
開發者如何判斷 Woof 能否放進工作流?
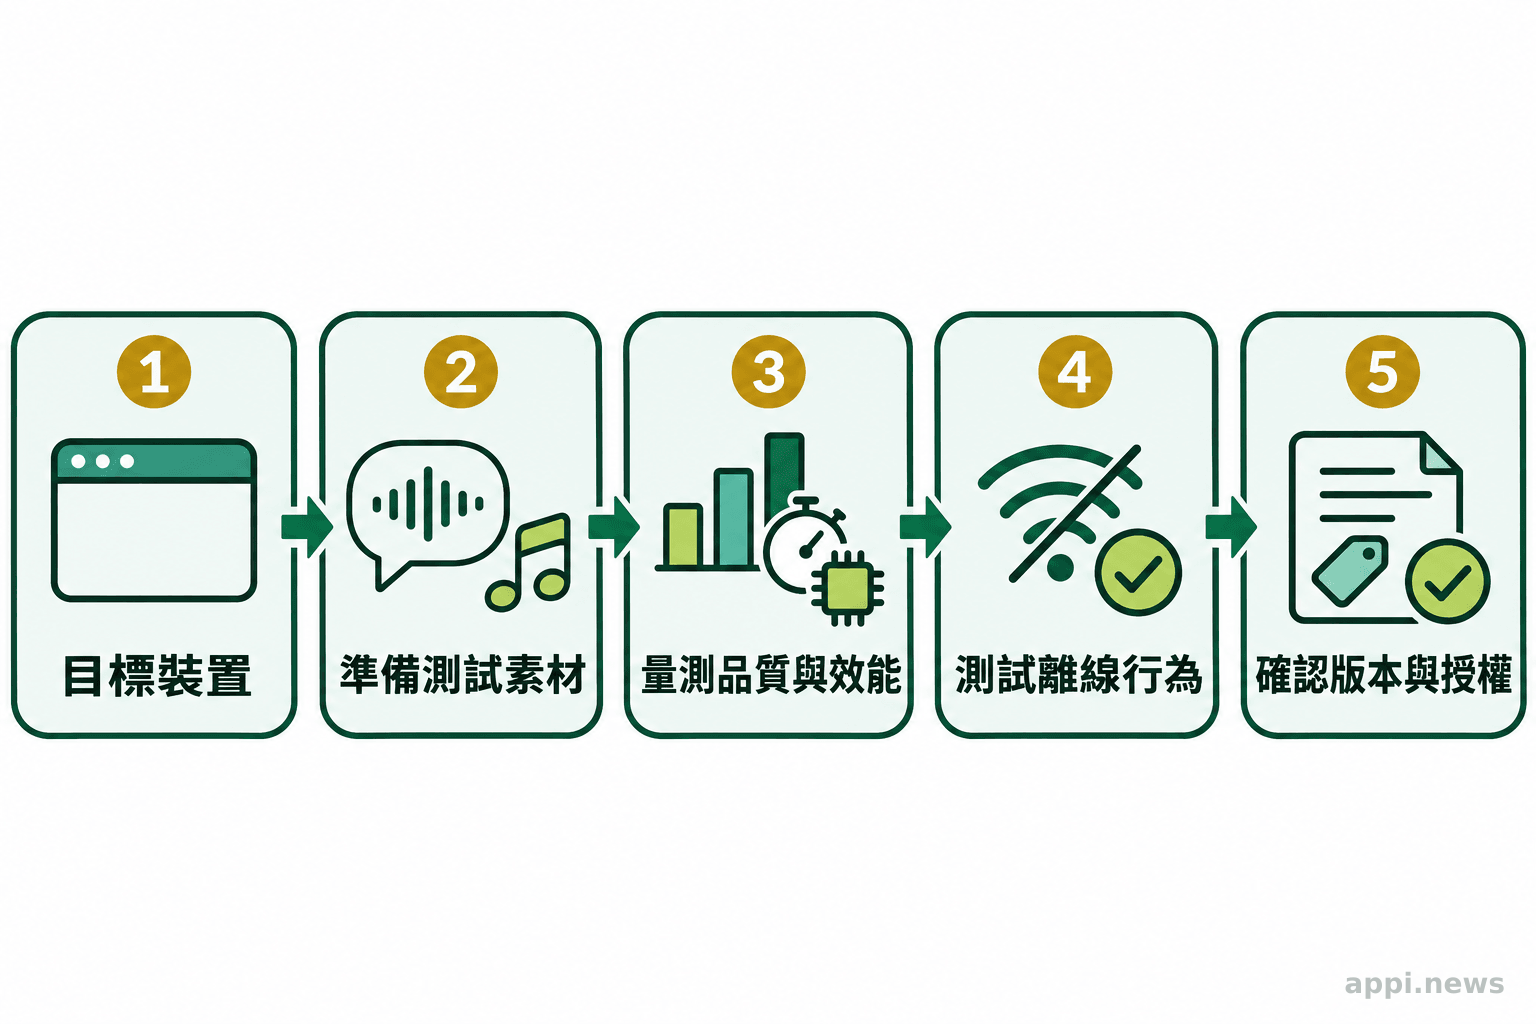
先定義要支援的裝置和可接受的品質門檻,再用固定測試材料量載入時間、生成延遲、資源占用與離線行為。 最後核對模型版本、下載來源和授權條款,才決定是否整合。
- 列出目標環境:記下最低規格裝置、作業系統、瀏覽器及是否要求 GPU;若有 CPU 備援路徑,也列入測試。
- 固定輸入樣本:準備短句、長句、數字、日期與專有名詞;音樂功能另設不同調諧設定,檢查輸出是否符合預期。
- 分開記錄結果:測首次下載與載入時間、生成速度、記憶體或資源使用、輸出品質、重複執行穩定性,以及斷網後能否完成任務。
- 設定放行門檻:按產品用途決定可接受的錯讀率、最長等待時間、音質和資源上限,並明訂不符合時的替代方案。
- 確認交付條件:核對模型版本、檔案來源、更新方式、授權範圍及商用條件;未取得正式條款前,不推定可以商用。
這份檢查表的價值,在於把「小模型能不能用」拆成可回答的工程問題。若 Woof 在指定的瀏覽器和裝置上通過測試,它才適合進入下一階段整合;若只在展示環境成功,結論就應限於展示環境。決定前也要考慮模型更新、瀏覽器改版與目標硬體汰換後,團隊是否有能力持續回歸測試。
測試裝置不必一開始就涵蓋市面所有組合,但應包含產品承諾支援的低階設備和常見設備,並用實際部署的瀏覽器版本重跑。若產品需要在沒有網路時啟動,也要先載入模型,再關閉網路測試完整流程,分辨「已下載後可離線運作」和「第一次開啟就完全不需要網路」的差別。這兩種使用條件對下載、快取和錯誤提示的設計並不相同。
- Woof 的瀏覽器展示呈現文字轉語音與音樂生成操作,並未提供跨裝置的獨立效能數據。
- 32MB 是模型檔案大小資訊,不能直接代表執行記憶體、生成速度或音質。
- 是否適合產品,要在目標環境測試語音、音樂、離線行為與資源使用,並核對授權條款。
常見問題
TechCrunch 報導轉述 Underdog 稱模型可在多數裝置離線執行,但沒有提供跨裝置測試資料;商用條件則應以正式授權文件為準。
常見問題
Q1: Underdog Woof 是什麼?
Woof 是 Underdog 展示的文字轉語音模型,報導描述它約 32MB,並以瀏覽器互動遊戲展示語音與音樂功能。
Q2: Woof 可以離線執行嗎?
Underdog 表示模型能在多數裝置上不連網執行。現有報導未列出完整裝置、瀏覽器與測試條件,實際使用需在目標環境確認。
Q3: 32MB 代表只需要 32MB 記憶體嗎?
不代表。模型檔案大小和執行期間的記憶體、運算資源、載入時間是不同指標,應分別量測。
Q4: Woof 可以直接用在商業產品嗎?
不能只憑展示報導判斷。整合前應查看模型的正式版本與授權文件,確認商用、再散布和修改等條款。


