
Allen Institute for AI(Ai2)研究團隊讓 GPT‑5.4 評估同一批人類研究點子與 AI 生成點子的配對,只改了提示詞,準確率便從 93.5% 降到 40.9%,低於隨機猜測水準;模型對超過半數配對改了判斷。差異源於評審收到的任務描述,而非資料或模型更換。研究團隊若用大型語言模型(LLM)替研究點子打分,該把這個分數當成可靠結論嗎?
Novelty Bench 是 Ai2 隨研究〈Old Ideas, Novel Problems〉發布的評測資料與流程,用來測試 LLM 判斷研究新穎性的表現。它提供一個值得注意的訊號:評分可協助初步比較與流程檢查,但模型是否看過合適的既有文獻、提示如何描述任務、評估資料代表什麼,都會左右結果。讀者若也在比較 AI 評測,還可參考如何判斷 AI 代理評測有沒有泛化,先分清基準測試回答的問題與實際使用場景。
同一組研究點子,換個提示詞就可能得到相反判斷
在 Novelty Bench 的 Human+Generated 配對測試裡,提示詞是否提到審稿者已判定新穎性,讓 GPT‑5.4 準確率相差 52.6 個百分點。這表示評審結論對任務措辭敏感,不能只讀單次分數。
GPT‑5.4 在 Human+Generated 配對中的準確率變化
研究團隊讓 GPT‑5.4 比較一個人類撰寫、已由審稿意見標記為高新穎性的點子,以及一個由語言模型產生的點子。第一種提示告知模型,每組配對中有一項曾被審稿者認定為新穎;另一種提示只問哪個點子新穎。後者讓準確率從 93.5% 跌至 40.9%,而同一配對在兩種提示下有超過一半得到不同判斷。這是評測設計的實例,並不能推成所有模型或所有學科都會有相同幅度的變動。
此處的準確率來自成對比較任務:模型要選出兩個點子中哪一個較新穎。當研究團隊把點子生成、評審與篩選串成流程,提示詞可能影響哪些候選進入後續研究。與其只呈現最高分,不如保留評審提示、模型版本、資料來源及重測結果,才能知道分數變動是來自點子本身,還是評估設定。
Sternlicht 等人指出,同一個評審在相同配對上可能因合理的提示設定而改變判斷,生成點子上的變化尤其明顯。(研究結果意譯,2026)
Novelty Bench 如何建立新穎與較低新穎性的比較資料
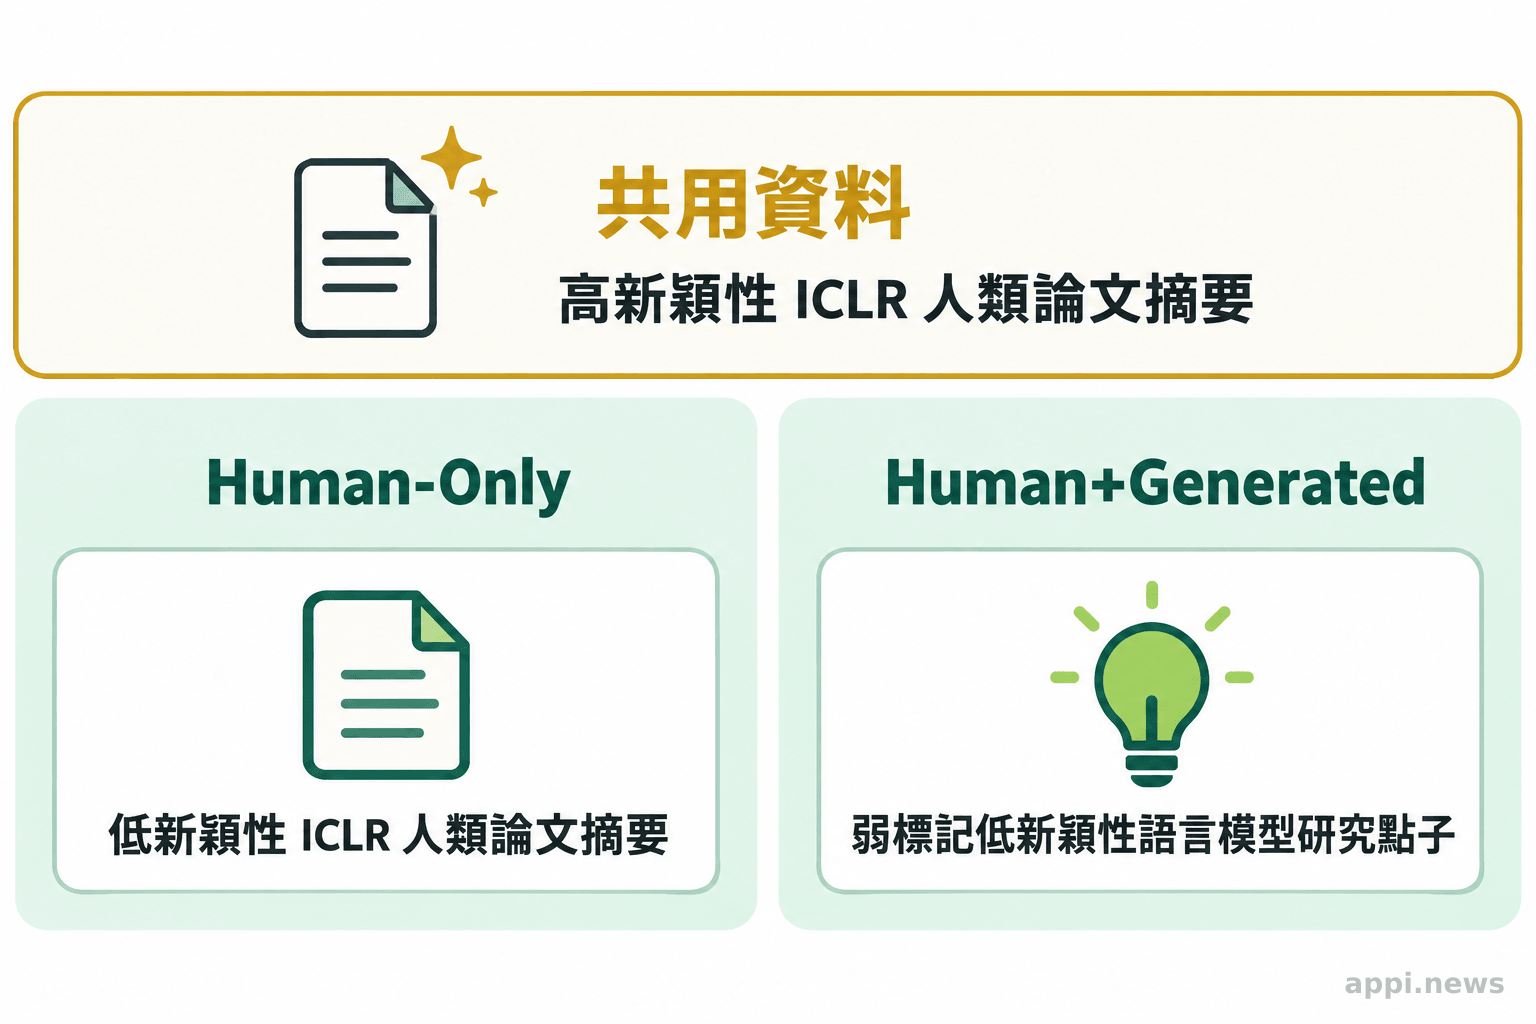
Human-Only 與 Human+Generated 共用一組高新穎性的人類論文點子,差別在較低新穎性的一側:前者取自人類論文,後者以 AI 生成點子替代。兩種設定因此測到不同資料來源下的評審表現。
Human-Only 與 Human+Generated 的標記依據不同
研究者從 ICLR 2026 的 OpenReview 審稿意見擷取明確肯定或質疑原創性的文字,再保留審稿者意見一致、且評分位於研究領域高端或低端的論文。論文摘要作為被評估的研究點子。Human-Only 的兩側都由人類論文組成:高新穎性一側取高端論文,較低新穎性一側取低端論文。
Human+Generated 保留同一批高端人類論文,另一側則改用模型生成的點子。生成模型只收到對應論文的 ICLR 領域名稱,單次產生研究方向,沒有檢索文獻、外部工具或反饋。研究把這些生成點子假設為新穎性較低,屬於弱標記,並非逐筆經專家確認的標準答案。作者另請一位電腦科學教授盲評 30 組配對,作為檢查這項假設的抽樣檢視;抽樣結果無法代替對整份資料逐項標註。
逐題評分與成對比較測試的是不同判斷方式
逐題評分要模型判斷單一點子是否達到頂尖 AI 會議的研究新穎性門檻;成對比較則要模型在兩個同領域點子中選出較新穎者。前者測分類,後者測相對排序,答案不必相同。例如一個點子在比較中勝出,仍可能未達逐題評分的門檻。
論文以 ICLR 資料建構測試集,因此標記承接特定會議的審稿語境、評分分布與研究領域。研究結果反映這批資料和指定模型設定,不能直接代表所有領域對「新穎」的定義,也不能等同實際審稿流程。想了解文獻搜尋如何支援研究點子形成,可搭配閱讀LitPivot 的文獻探索流程與查證步驟,但提出新方向與判定它是否新穎,仍是兩個需要分別驗證的工作。
評審準確度會受提示、模型與評估流程影響
不能由流程更複雜就推定結果更準。這項研究中,檢索與推理預算帶來的改善有限且依模型而異,專用評估器也沒有穩定勝過簡單提示基準。
更多檢索或推理不保證判斷更好
研究設定之一讓評審取得 5 篇相關論文摘要,另一項則降低推理預算,觀察兩種改動對同一評審的影響。降低推理預算通常影響不大,檢索只在部分模型上改善結果,有些情況甚至降低表現。研究團隊也檢查檢索造成錯判的案例:模型原本認為某個結合兩種概念的點子新穎,看到分別談兩種概念的文獻後,反而把它視為既有元素的直接拼接。檢索資料能否回答「這個具體貢獻是否已有先例」,取決於找到的文獻與研究問題是否對得上。
另一項實驗把即時、反覆搜尋 arXiv 的 GPT‑5.6 Sol 評審,與可查看五篇預先檢索摘要的模型比較。在 Human+Generated 逐題任務中,前者 macro-F1 為 0.78,低於 Claude Opus 4.6 的 0.89,每次判斷成本約高十倍。這顯示搜尋範圍和推理資源增加後,仍要以相同資料、指標和成本檢查實際收益;單看「用了更多檢索」不足以判定評審品質。
專用評估器與簡單基準要連同成本和資料設定解讀
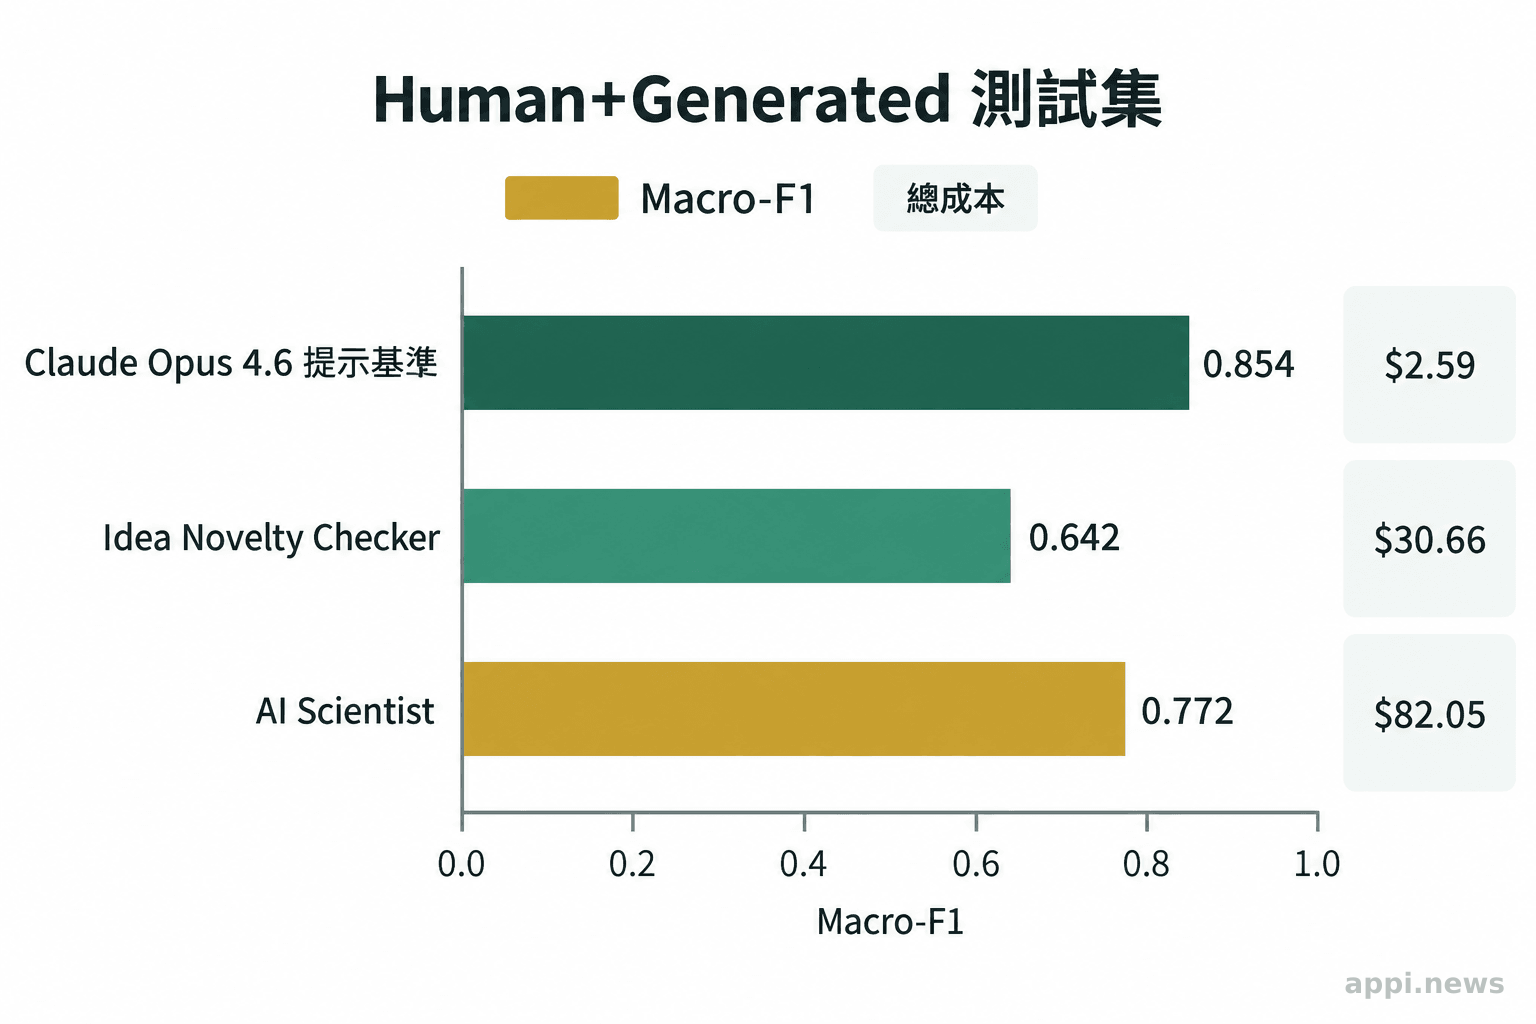
研究團隊將兩種專用新穎性評估系統與一般提示式評審比較。在 Human+Generated 測試中,低推理預算的 Claude Opus 4.6 提示搭配三次投票,macro-F1 為 0.854,總成本 2.59 美元;Idea Novelty Checker 得分 0.642、成本 30.66 美元;Sakana AI Scientist 得分 0.772、成本 82.05 美元。數字來自作者設定的資料、模型與計價條件,不能解讀成通用排名,但足以提醒研究團隊:專用名稱、額外功能或較高費用本身不會保證判斷更好。
這也是讀 benchmark 的基本功:確認評測任務、樣本和指標是否與自己的使用情境相近,再看不同提示和模型之間的波動。若模型分數被拿來比較研究生成系統,還需測試同一評審提示改動後,系統排名是否改變。Novelty Bench 提供可檢驗的問題與測量方法,適用範圍仍限於研究設定,尚未構成跨領域標準。
Ai2 研究團隊的測試顯示,檢索與更高推理預算未能一致改善新穎性判斷,兩種專用評估器也落後於其測試中的簡單提示基準。(研究結果意譯,2026)
研究團隊怎麼使用 LLM 評審而不把分數當結論
先確認任務和資料適配,再測提示敏感度、抽樣人工複核,最後回到相關文獻確認是否已有近似工作。評審輸出應保留為初篩訊號,並記錄設定與人工覆核結果。
- 定義評審問題:要判斷單一點子有沒有達門檻,還是比較兩個點子的相對新穎性?選用相符的資料和指標,避免將分類準確度當成排序能力。
- 固定樣本,重測設定:準備一批具代表性的研究點子,固定模型後改寫提示詞;再固定提示,換模型測試。記錄每次判斷、分數、拒答或平手比例。不同設定的分數若明顯變動,先找出變動集中在哪些題型。
- 抽樣人工複核:由熟悉領域的研究者檢查一致與不一致案例,確認引用的先前工作是否真正涉及相同問題、方法或貢獻。抽樣複核可揭露錯誤型態,不能宣稱抽樣結果驗證了每個自動判斷。
- 把結論寫出適用範圍:報告資料來源、領域、模型版本、提示詞、指標和檢索設定。若結果只在一個基準或一批弱標記資料上成立,就照此描述,不要外推為所有研究流程的表現。
- Novelty Bench 顯示,LLM 新穎性判斷可能對提示設計與資料來源敏感。
- 評測分數可協助初步比較;文獻脈絡和研究者判讀仍須納入流程。
常見問題
Q1: Novelty Bench 能證明哪些模型最會判斷新穎性嗎?
不能直接得出跨領域的總排名。研究比較了六種評審模型,但成績會隨提示、資料來源、任務格式與判定指標改變;應把結果解讀為特定實驗條件下的比較。
Q2: LLM 評審說點子新穎,就代表文獻中沒有類似研究嗎?
不代表。模型可能沒有取得相關文獻,也可能誤讀檢索結果。研究者仍需搜尋並比對研究問題、方法和貢獻,確認新穎性主張有文獻脈絡支持。
Q3: 研究團隊可以怎麼驗證自己的新穎性評審流程?
固定一批點子,分別測試提示詞和模型變化,記錄結論及不確定情況,再抽樣請領域研究者查對相關文獻。若評分對設定敏感,應限制在初篩或比較用途,並公開適用範圍。


