
Ollama v0.40.12 的版本紀錄列出 MLX runner 新增 LFM3 與 d1 支援;模型與量化方式左右實測結果。開發者 Zach Rattner 在 M1 Ultra 比較 Qwen3.8-27B,4-bit 時 MLX 生成速度比 Ollama 高約 41%,換成 8-bit 後優勢消失。這不是 LFM3 或 d1 的測試,不能據此推論特定模型一定更快。Apple 晶片上的 MLX 與 Ollama 實測
這次更新提供執行選項;可先參考Ollama 0.40 和 MLX 在 Mac 上的差異整理,再核對安裝版本與模型名稱。Ollama v0.40.12 版本紀錄
Ollama 0.40.12 增加了哪一種本機執行選項?
Ollama 的 v0.40.12 版本標籤列出 MLX runner 新增 LFM3 與 d1 兩個模型支援項目;這是版本變更紀錄,界定的是 runner 支援範圍。
MLX 是 Apple 機器學習研究團隊維護的陣列運算框架,設計對象包含 Apple 晶片;其官方文件說明,MLX 在 Apple silicon 裝置使用共享記憶體模型。Ollama 將其包進 runner,讓使用者沿用 Ollama 管理模型與呼叫服務的方式。版本紀錄回答「runner 支援什麼」,模型頁則說明「模型做什麼」;兩者是不同層次的資訊。MLX 專案說明可用來理解框架定位。
這項新增也不是所有模型都自動改走 MLX。Ollama 在 v0.40.4 的版本紀錄先列出 Kev decision models 對 Apple silicon 上 MLX runner 的支援;到了 v0.40.12,變更摘要再點名 LFM3 與 d1。兩個版本事件呈現支援清單的變化,但不能據此推定每種量化版本、模型標籤或周邊應用都相容。v0.40.4 版本紀錄
獨立開發者 Alex Hiesch 在 M3 Max、64 GB 記憶體的 Mac 上,以 7 種模型和 8 種後端完成 791 組本機推論測量,記錄首 token 延遲、生成速度與記憶體。這類多模型、多後端的比較能提醒使用者分開看載入與生成表現;測試沒有涵蓋 LFM3、d1,也不是 v0.40.12 的 MLX runner 結果。Apple silicon 本機推論測試
Ollama 團隊也公布一組 Apple silicon MLX 測試:以 Gemma 4 12B 比較量化格式,使用 8,300 token 輸入、重複跑 10 次測生成速度,並測量 perplexity;文章另以 MacBook Pro M5 Max 示範將模型接入 coding agent。這是供應方對特定模型與設定的測試,能作為驗收指標的參考,不能代替目標裝置上的 LFM3 或 d1 測試。Ollama 的 Apple silicon MLX 測試
「MLX 是一個為 Apple silicon 設計的機器學習陣列框架。」這是 MLX 專案對自身定位的說明,代表它提供運算框架,不構成特定 Ollama 模型在特定裝置上的效能承諾。來源:MLX 專案。
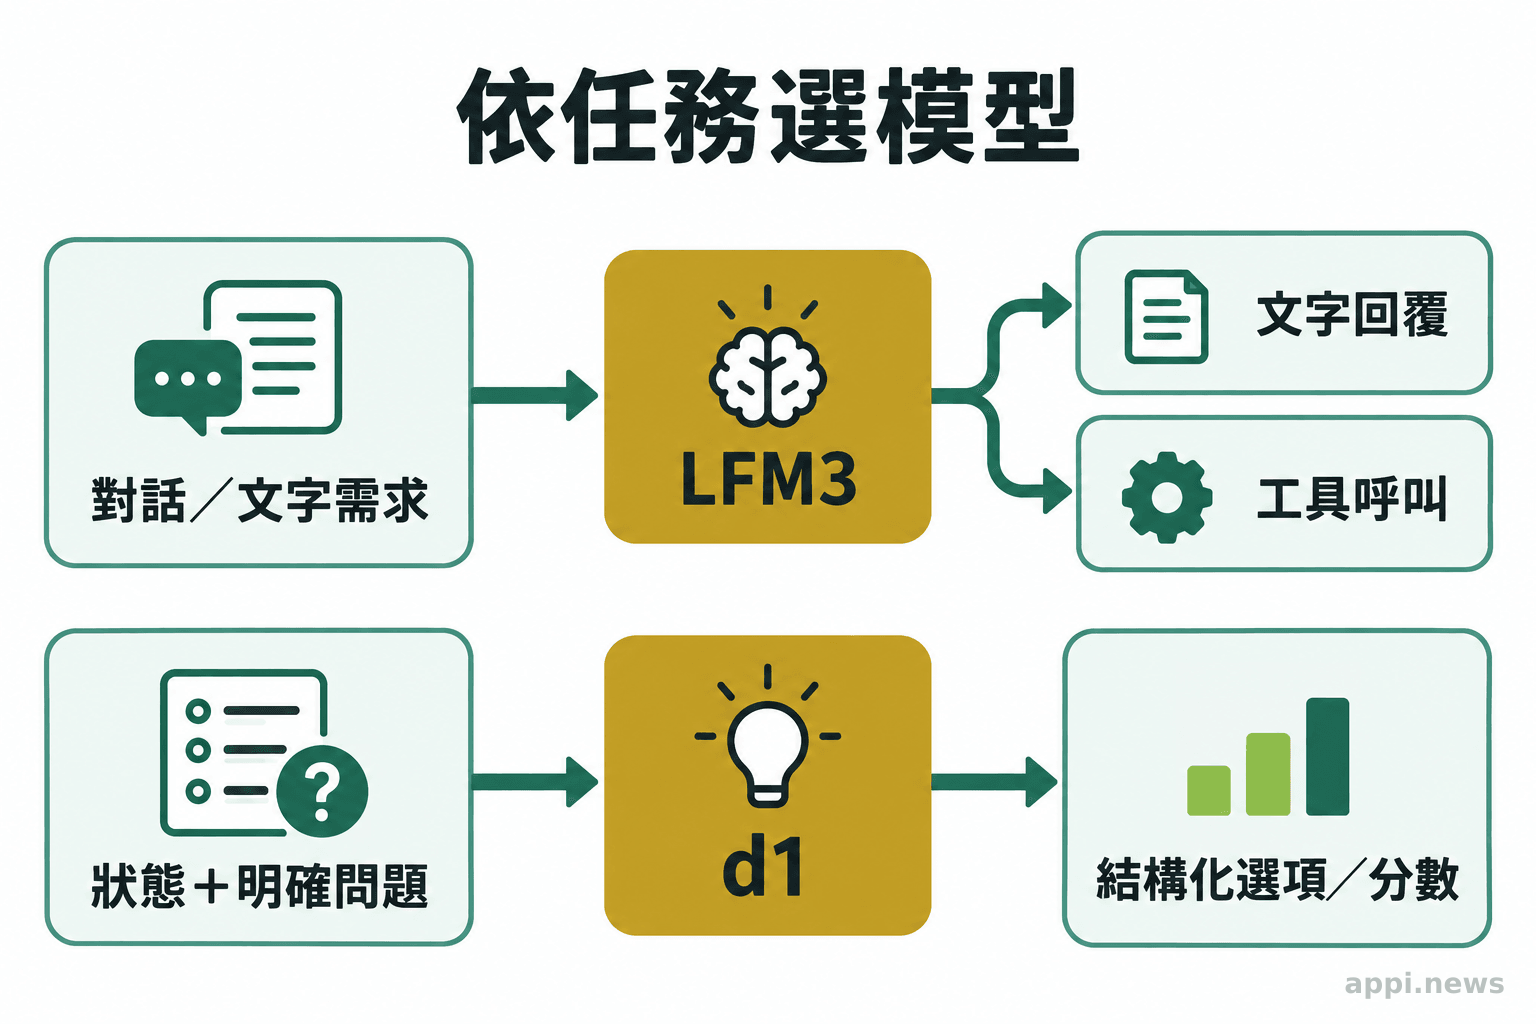
LFM3 與 d1 的任務定位不同
Ollama 模型頁將 LFM3-1.7B 描述為文字模型,定位在本機代理與專門應用,包含工具呼叫及結構化輸出;d1 則是決策模型,依照輸入狀態和指定問題回傳答案機率。選型要先看任務需要生成文字,還是需要在選項間判斷。
| 比較項目 | LFM3 | d1 |
|---|---|---|
| 輸入型態 | 對話訊息或交給模型處理的文字 | 文字、JSON、圖片或混合狀態,搭配明確問題 |
| 輸出型態 | 生成文字,也可依設定呼叫工具或輸出結構化欄位 | 回傳指定選項的機率或結構化判斷結果,不生成一般聊天文字 |
| 適用工作 | 對話回覆、整理內容、將請求轉成欄位、工具流程 | 分類、路由、排序或評估預先定義的選項 |
| 主要驗收項目 | 回覆品質、工具呼叫格式、欄位完整性、拒答處理 | 分類結果、機率校準、低信心案例、錯誤代價 |
| 限制 | 小型模型不適合直接承擔複雜多步推理;知識密集任務宜搭配檢索 | 需先定義問題和候選選項;機率不等於準確率,需保留人工覆核 |
LFM3 的官方模型頁展示了透過 Ollama chat API 傳送訊息,也將工具使用、結構化輸出列為用途。這表示它可納入需要生成回覆或呼叫工具的流程候選,例如把使用者請求整理成固定欄位,再交給後續程式處理。頁面同時提醒,知識密集任務可搭配檢索或搜尋,且不建議把小型模型直接用於代理程式撰寫或複雜多步推理。這些是模型供應方列出的定位與限制,仍需用自己的提示、工具定義和錯誤案例驗證。LFM3 模型頁
d1 的工作方式不同。Ollama 模型頁描述它可接收文字、JSON、圖片或混合狀態,再依照使用者定義的問題回傳選項機率;頁面明確說明它不是聊天模型,也不負責生成一般文字。官方 API 範例將客訴內容作為 state,讓模型判斷是否緊急、應由哪個團隊處理、嚴重程度為何。這是文件中的使用範例,不是獨立的準確率測試;企業若用於路由或審核,仍須準備標註資料、檢查錯誤類型,並設計人工覆核門檻。d1 模型頁
LFM3 模型頁也列出 Hermes Agent、OpenCode 等應用,並示範以 ollama launch hermes --model lfm3 啟動 Hermes Agent。這是官方接入指令,說明如何把模型接進代理程式,不是部署成效或品質測試。LFM3 模型頁
d1 模型頁也提供工單範例:一則「應用程式自早上更新後對所有使用者啟動即崩潰」的支援請求,被送入模型判斷急迫度、負責團隊與影響嚴重度。文件回應將案件分到 technical,該選項機率為 0.973,嚴重度分數為 2.582。d1 模型頁
0.973 的選項機率與 2.582 的嚴重度分數,是 d1 模型頁示例輸出,不是實測準確率或企業成效;將它接入工作流前,仍須以標註資料檢查分類結果與錯誤代價。
接入前要確認版本、硬體與模型標籤
先核對 Ollama 是否為含該變更的版本、裝置是否為 Apple silicon,再記下模型頁上的標籤與大小。這些資訊不足以推算可用記憶體、延遲或工作負載容量。
第一步是從 Ollama 官方版本頁確認安裝版本,並用明確的模型名稱執行,而不是假設 latest 永遠指向同一份權重。模型頁會列出可用標籤、檔案大小與上下文資訊;這些值可能更新,應在部署當天核對。下載大小也不等於推論時的記憶體需求,因為執行還會受上下文長度、同時請求數、快取及其他常駐程式影響。對共享工作站或筆電而言,留出系統和其他程式所需空間,並記錄模型載入時的記憶體變化,較能看出實際餘裕。
第二步是檢查授權和資料流。LFM3 與 d1 的模型頁列出 LFM Open License v1.0;使用前應查看授權全文對商用、再散布及衍生作品的條件。更新下載、遙測設定、外部工具或代理程式 API 仍可能傳送資料。若輸入含客戶或機敏內容,要追蹤資料經過哪些程序、日誌存放位置和外部服務端點,再決定是否能用於正式流程。
第三步是把模型能力與介面相容拆開驗證。先用 Ollama 官方提供的命令或 API 測最小輸入,再接上既有腳本或代理框架。LFM3 要看工具呼叫格式、結構化欄位與拒答處理;d1 要看候選選項設計、機率輸出、低信心案例及格式錯誤時如何處理。使用者若正在比較 Ollama 的其他本機功能,可參考本機語音工作流接入 Phonon 前要檢查的條件;語音生成與這次兩種模型的 MLX 支援是不同功能,測試指標也不相同。
「d1 不是聊天模型,也不會生成文字。」這是 Ollama 的 d1 模型頁對其任務邊界的說明。把它放進聊天介面時,應由呼叫端負責整理問題、呈現判斷結果及處理不確定案例。來源:d1 模型頁。
更新後怎麼驗收,才能判斷是否留在工作流?
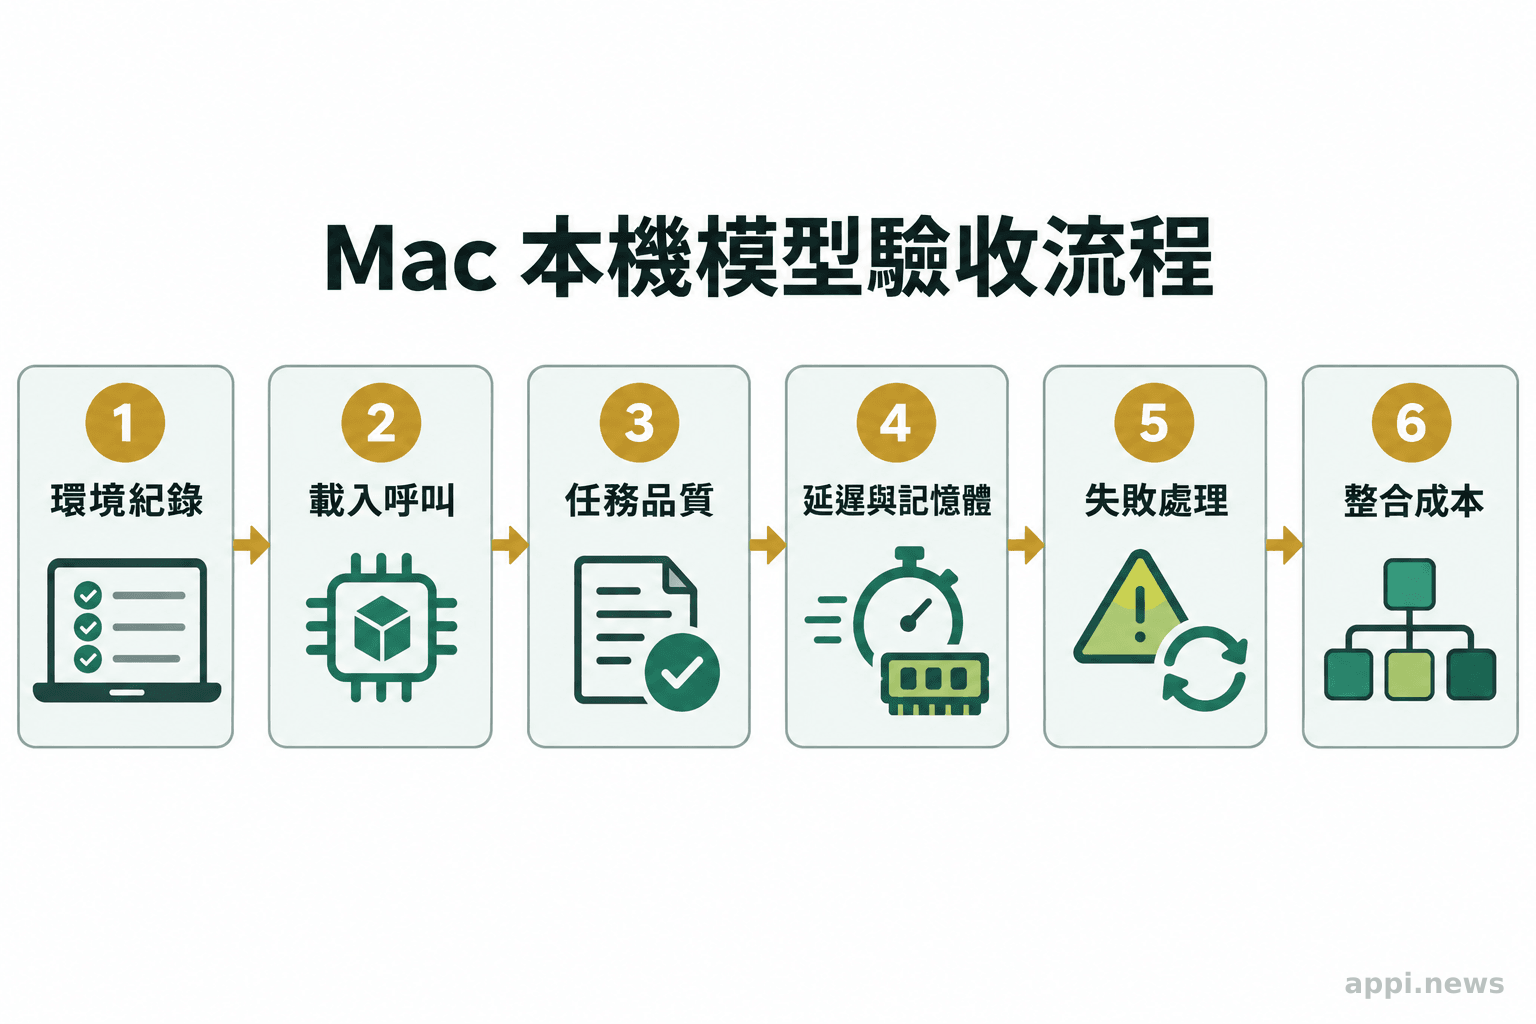
使用同一台裝置、同一組輸入和同一項任務,依序驗證載入、功能、品質與失敗處理,再與目前版本比較。測試前先替延遲、記憶體、輸出品質與失敗率訂出符合該流程的門檻;只有重複測試都達標、沒有靜默失敗,且整合成本可接受時,才納入工作流。
- 記錄基準環境:寫下 Mac 型號、晶片、記憶體、macOS、Ollama 版本、模型標籤和上下文設定,避免把環境差異當成模型差異。
- 測試可載入與基本呼叫:分別拉取 LFM3、d1,檢查啟動錯誤、首次載入時間、重複請求能否完成,以及模型是否依預期由 MLX runner 執行。
- 用真實任務檢查輸出:LFM3 準備常見請求、工具呼叫、格式錯誤和需檢索的問題;d1 準備正常、邊界和難以分類的樣本,檢查分類、機率及低信心結果。
- 比較資源和延遲:在同樣的輸入長度與請求數下,記錄冷啟動、暖機後延遲、記憶體峰值、連續請求穩定性;不要只挑一次最快結果。
- 測試失敗後的流程:模擬模型不可用、輸出欄位缺漏或判斷不確定,確認系統會提示、重試或轉交人工,而非靜默採用錯誤結果。
- 估算整合成本:計入模型更新、授權確認、監控、提示維護、日誌管理與人工覆核,再決定升級、先並行測試或維持現況。
測試設計還要追問失敗從哪一層開始:為什麼離線範例看似正常,接進應用後仍可能出錯?常見原因包括上游資料格式不一致、提示或問題定義含糊、模型輸出與程式預期欄位不符,以及逾時後沒有回退路徑。驗收時應把錯誤樣本按來源分類,確認修正責任落在資料、提示、介面還是執行環境;若任務涉及分類決策,則用保留測試集檢查 d1 機率門檻與錯誤代價。關於 Ollama 決策 API 的介面與限制,可延伸閱讀System One 評分 API 的本地模型支援整理。
- v0.40.12 的版本紀錄列出 MLX runner 新增 LFM3 與 d1 支援,這是執行器支援範圍的變化。
- LFM3 偏文字生成與工具使用,d1 偏結構化判斷與選項評分,輸入、輸出和驗收方式不同。
- 用同一裝置、同一任務比較載入、品質、延遲、記憶體與錯誤處理,再衡量整合成本,決定是否升級。
常見問題
先依模型任務選 LFM3 或 d1,再用目標裝置和真實工作資料驗證執行與整合表現。版本支援只確認執行路徑存在,不能代替工作流驗收。
常見問題
Q1:Ollama 0.40.12 是否代表 LFM3 和 d1 一定會在所有 Mac 上跑得快?
不是。版本紀錄確認 MLX runner 加入模型支援,沒有發布所有 Mac 型號的速度或品質保證。實際結果取決於晶片、記憶體、模型標籤、輸入長度與同時工作量,應在目標裝置上測量。
Q2:LFM3 和 d1 可以互相替代嗎?
不能直接互換。LFM3 定位在文字生成、工具使用等情境;d1 依指定問題回傳決策類結果,例如選項或評分機率。先依任務輸入和所需輸出選模型,再驗證其介面是否符合應用程式。
Q3:模型頁顯示的下載大小就是需要的記憶體嗎?
不是。下載檔案大小與執行時記憶體占用不同,後者還受上下文、快取、並行請求及系統背景程式影響。以實際模型標籤和工作負載在目標裝置測量。
Q4:在本機執行就能確定資料不會離開裝置嗎?
不能只憑本機推論判定整個應用的資料流。檢查更新、遙測、代理工具、外部 API、日誌與備份的連線和保存方式;處理敏感資料前,先依組織規範確認資料處理邊界。
Q5:什麼情況適合升級?
當工作確實需要 LFM3 的文字或工具能力,或 d1 的結構化決策輸出,而且目標裝置通過載入、品質、延遲、記憶體和失敗處理測試時,可考慮納入。若目前工作不需要這些能力,或整合與維護成本高於效益,可先保留既有版本。


