
模型能讀圖、呼叫工具,就能長時間替團隊執行代理任務嗎?NVIDIA 於 2026 年 10 月 15 日發布 Nemotron 3.5 Super VL,將它定位為可處理視覺理解、程式、推理與代理工作流的開放權重模型。對評估導入的團隊而言,先要定義的不是「模型有多少能力」,而是它接手哪個明確環節、錯誤如何被發現,以及何時交由人員接手。
這款模型適合放進候選清單評估,不能只憑產品定位就視為可持續自主工作的代理。總參數與啟用參數、模型權重與可用硬體、單次回答與完整工作流可靠度,都是不同層次的問題。若先用可重現的任務測出品質、延遲、成本與失敗型態,技術團隊才有依據決定試用是否值得擴大。
Nemotron 3.5 Super VL 發表了什麼?
Nemotron 3.5 Super VL 是 NVIDIA 發布的 120B-A12B 開放權重視覺語言模型,可接收文字、圖片與影片,並以推理、程式、文件理解及工具使用為應用方向。廠商公布的能力和評測結果仍須放回各團隊的資料、硬體與工具環境驗證。
120B-A12B、開放權重與視覺能力怎麼理解
120B-A12B 表示模型總參數約 1,200 億,其中推論時每個 token 啟用約 120 億參數。Nemotron 3.5 Super VL 使用混合專家模型(Mixture of Experts,MoE),推論時依輸入選取部分專家參與運算。啟用參數較少,不能直接推導出模型只需儲存 120 億參數,也不能單獨用來估算顯存。完整權重、上下文快取、並行請求、視覺輸入與推論框架都會影響實際資源需求。
「開放權重」說的是可取得模型參數,讓團隊能自行部署或調整;它不自動等於所有程式碼、訓練資料與使用條款都不受限制。Hugging Face 模型卡列出 BF16 權重與 NVFP4 量化版本,並將權重適用的下載條款指向 OpenMDW-1.1。團隊若要再訓練、散布衍生版本或提供服務,仍應逐項確認適用條款、第三方資料權利及內部法務要求。
視覺語言模型(Vision-Language Model,VLM)能把圖像或影片畫面與文字指令一起處理。NVIDIA 的模型卡列出文件理解、影片理解與工具使用等用途,也說明模型採用 Mamba-2、注意力層、MoE 與視覺編碼器的組合。這些能力適合拿來測試圖表讀取、表格擷取、畫面辨識或文件分類,但不代表所有版面、語言、掃描品質與特殊格式都能準確處理。特別是欄位漏讀、表格跨頁、單位辨識與小字錯讀,應列入測試資料,而非只展示容易成功的範例。
NVIDIA 對代理任務的定位
NVIDIA 的發布資料將 Super VL 放在長時間運作的代理工作脈絡,並提及視覺理解、工具使用、多步驟工作流與程式任務。這是發布方對產品定位的說明;模型卡和技術報告中的 benchmark 也屬於特定設定下的測試結果。兩者可協助團隊挑選值得驗證的任務,不能直接代表自家系統的成功率、速度或總成本。
NVIDIA 將 Super VL 描述為支援文字、影像、影片與互動式工具環境的多模態模型;實際部署仍應依模型卡的推論設定與使用情境測試。
「長時間工作」也不等於模型可以不受監督地持續操作。代理通常包含模型、提示、工具介面、記憶或上下文管理、排程、權限與錯誤處理。模型負責產生判斷或動作建議,外部控制層則決定是否執行、執行到哪裡、如何記錄以及何時停止。缺少這些控制,模型即使單步能力不錯,也可能在多步驟流程中累積偏差。
哪些 AI 代理任務適合先試?
先從輸入明確、工具範圍有限、結果可以人工抽查的文件或影像任務開始,例如擷取表單欄位後建立草稿,或依固定規則分類並附上來源位置。涉及付款、刪除、對外發送或權限變更的動作,初期應停在建議或待核准狀態。
從文件、影像理解與規則化工具呼叫開始
合適的試驗任務通常有三個特徵:輸入來源可控、正確答案能由既有紀錄確認、錯誤不會直接造成不可逆後果。像是從合約或報表擷取指定欄位、把截圖中的錯誤訊息整理成分類結果、依客服政策把案件分派到草稿佇列,都能先以歷史樣本離線測試,再接上受限的工具介面。
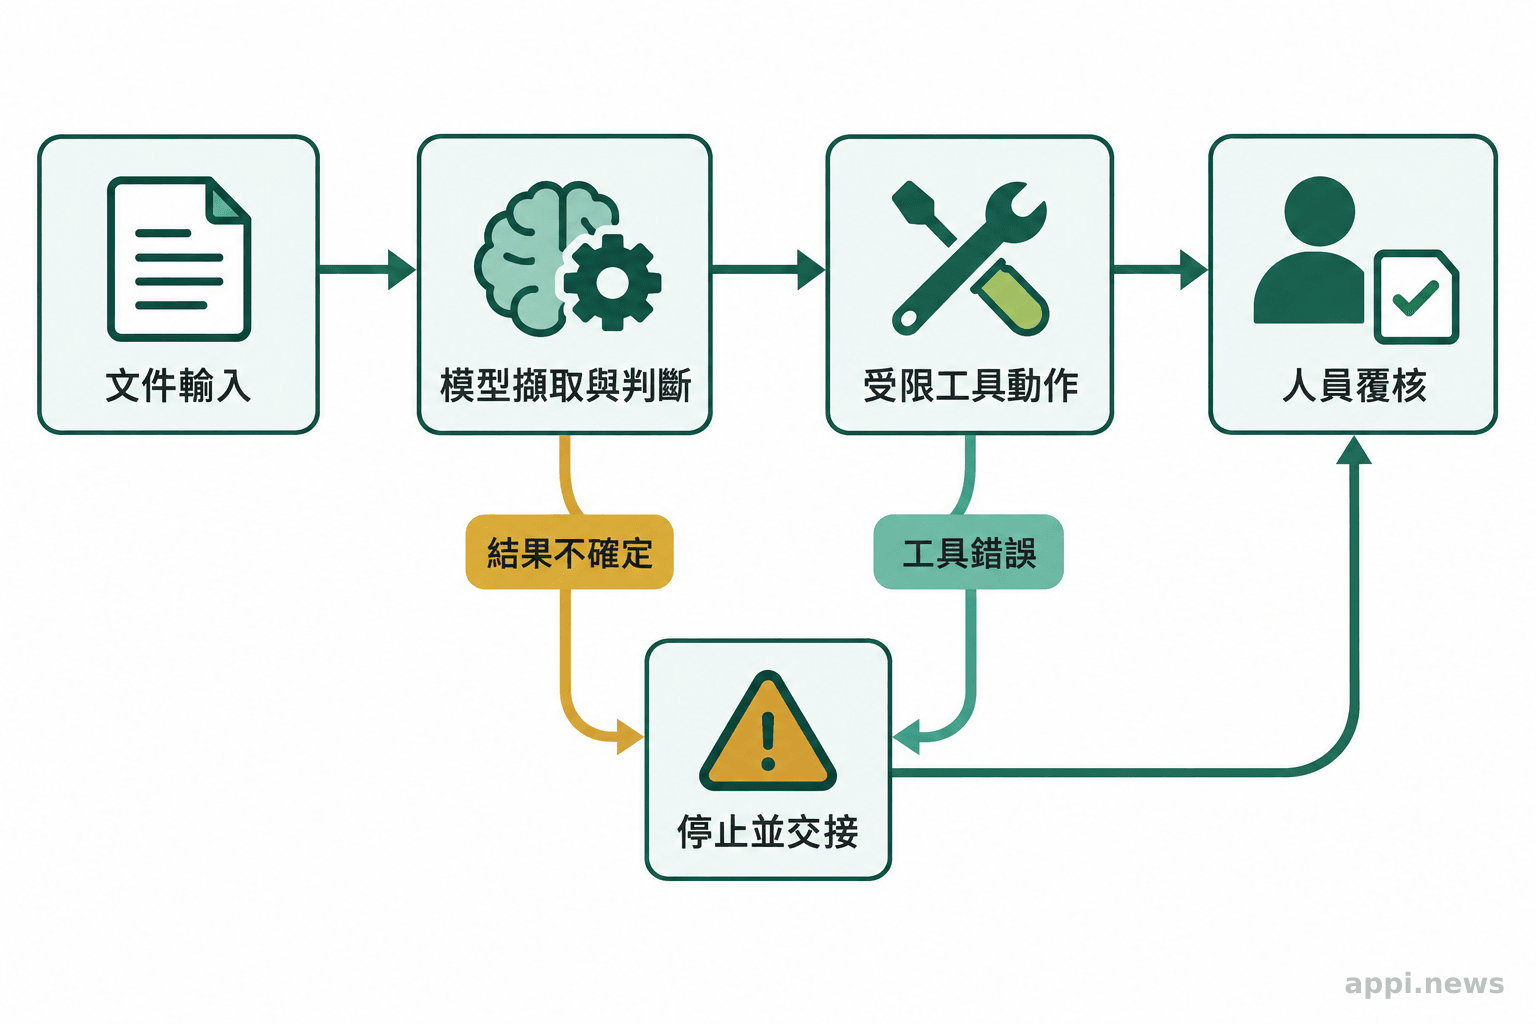
工作流可拆成四段:接收資料、抽取或判讀、提出工具動作、確認結果。每一段都應留下可檢查的輸出。例如,文件擷取除了欄位值,也記錄頁碼或文字區域;工具呼叫除了動作名稱,也記錄輸入參數與回傳狀態。這能讓人員分辨是圖片辨識錯、規則判斷錯,還是工具執行失敗。
把任務拆成輸入、判斷、動作與人工交接
在試用前,先把「成功」寫成可核對的條件,而非「看起來回答得合理」。若任務是從發票擷取資料,成功條件可以包括欄位完整、金額與日期格式正確、來源區域可追溯,以及遇到模糊影像時回報不確定而不自行補值。若模型需要呼叫工具,則要限制可用工具、參數範圍與可存取資料,並保留人工確認點。
測試集也不能只收集乾淨、格式一致的例子。應納入低解析度影像、不同版型、缺欄、重複頁、模糊指令與矛盾資訊。工具端則要模擬逾時、權限不足、回傳空值、重複提交等狀況。代理遇到問題時若能停止並交接,通常比繼續猜測更容易維持流程安全。
為什麼模型能力不等於代理流程可靠?
代理流程的結果同時受模型、資料、工具與控制規則影響;單次回答正確,不代表連續多步都能維持正確。若系統沒有驗證、停止與復原條件,錯誤可能隨工具呼叫與上下文更新逐步放大。
分辨模型錯誤、工具失敗與流程設計問題
同一個失敗結果可能來自不同原因。模型可能看錯表格欄位;工具可能收到錯誤參數或回傳格式改變;流程可能把不完整的前一步輸出當成確定事實;權限則可能允許代理執行不該自動執行的操作。若只記錄最後一句回答,團隊就難以定位故障,也容易把工具問題錯當成模型能力不足。
因此每個步驟要保留輸入摘要、模型輸出、工具呼叫參數、工具回應、重試次數與人工介入紀錄。當錯誤發生時,依序檢查資料品質、辨識或推理、工具介面、權限設定與流程條件。對高風險動作加入前置驗證,例如比對識別碼、檢查金額上限、確認目標帳號,並以冪等設計避免重試造成重複操作。
文件和影像也可能包含提示注入(prompt injection),也就是把指令藏在待處理內容中,試圖改變代理行為。模型應把文件文字視為待分析資料,不能當成高優先級的系統指令;工具端要採用最小權限、允許清單與操作確認。對可能含有個資、商業機密或受授權限制內容的資料,還要確認傳輸、保存、存取及刪除政策。這些防護要透過惡意文件與錯誤辨識測試驗證,不能只靠提示文字宣告完成。
設定權限邊界、停止條件與失敗復原
長流程需要明確的停止條件,包括最大步數、總耗時、重試上限、費用上限,以及連續遇到不確定結果時的人工交接規則。每個動作前都要問:模型是否只提供建議,還是能直接修改資料?該修改是否可撤銷?若回應逾時,重新呼叫會不會重複建立紀錄?答案會決定工具要採用唯讀、草稿、雙人覆核或正式執行權限。
失敗復原也要在上線前演練。測試服務中斷後是否能從安全位置續跑、部分完成的工作是否可以辨識、人工接手時是否看得到前面每步的依據。系統能解釋「目前停在哪裡」與「為何停下」,團隊才有能力安全地處理未完成工作。長時間運作的價值取決於這些流程條件,而非單看連續生成能力。
技術團隊如何驗收與估算導入成本?
以代表性任務集建立可重複的基準測試,同步量測品質、人工介入、延遲、成本與資源占用。比較時固定資料、提示、工具版本與推論設定,並把 NVIDIA 公布的結果標成發布方測試,不當作自家系統的預測值。
建立代表性任務集與對照基準
任務集應覆蓋日常案例、邊界案例與失敗案例,標註可接受結果、必須拒答或交接的情況,以及錯誤的影響程度。常用指標包括欄位精確率與召回率、工具呼叫正確率、任務完成率、人工介入率、錯誤復原率、端到端延遲、每件任務成本及 GPU 記憶體占用。對有多個步驟的流程,分別計算單步正確率與全流程成功率,避免平均分數掩蓋中途失敗。
至少應用同一組資料比較現有方案與新模型。若任務可以用傳統 OCR、規則引擎或較小模型完成,也把它們納入對照,確認視覺推理帶來的增益是否足以抵銷新增的部署和維運成本。NVIDIA 技術報告列出多種 benchmark 與特定硬體測試設定,可用來理解模型接受過哪些評估;團隊仍需根據自有資料與代理框架重跑測試。
比較權重格式、推論資源與維運負擔
模型卡提供 BF16 的部署參考配置,但這是特定推論框架和服務設定下的起點,不是所有團隊都必須採用的固定硬體門檻。BF16、NVFP4 等格式代表數值精度或量化方式不同,會影響權重占用、速度與輸出品質。量化可降低部分部署負擔,也需以自己的視覺與工具任務確認精度變化是否可接受。除權重外,還要預留上下文快取、批次併發、圖片或影片處理與系統服務所需資源。
部署成本也包含環境建置、推論框架相容、模型更新、監控告警、安全修補、資料治理、故障排除與人員訓練。若本地部署能降低敏感資料外送風險,仍須盤點誰能存取主機與日誌、模型是否會記錄輸入、備份保存多久,以及資料刪除如何落實。選擇自管環境或代管服務,應把控制權、維運負擔與服務依賴一起比較。
| 評估項目 | BF16 權重 | NVFP4 等量化權重 |
|---|---|---|
| 主要用途 | 參考精度、客製化與完整精度評估 | 降低部分推論資源需求,配合優化部署 |
| 需要檢查 | 權重與上下文的記憶體需求、併發能力 | 量化後任務品質、框架支援與吞吐表現 |
| 驗收方式 | 以目標硬體和實際工作流測延遲與成本 | 用同一測試集與 BF16 對照錯誤率和資源 |
Hugging Face 模型卡將 BF16 權重定位於客製化、領域調整與完整精度評估,並將 OpenMDW-1.1 列為適用條款;部署、散布與資料權利仍須依條款逐項確認。
- 選一項輸入、成功條件與工具範圍都能明確界定的低風險任務。
- 建立含正常、邊界及錯誤案例的測試集,與既有方案使用相同設定比較。
- 記錄成功率、工具呼叫正確率、人工介入率、延遲、成本與資源占用。
- 測試逾時、錯誤辨識、惡意內容、權限不足、停止與人工接手流程。
- 核對授權、資料處理、推論框架與維運責任,再決定是否擴大試用。
試用前要確認哪些條件?
先確認權重與授權版本、資料處理方式、推論框架相容性和任務責任分工,再用可追蹤、可停止、有人接手的低風險工作建立驗收基準。模型能取得與模型適合某個工作流,是兩個不同結論。
開放權重讓組織有機會自行部署、調整和選擇基礎設施,同時也把模型更新、漏洞處理、使用紀錄與服務可用性責任帶進團隊。OpenMDW-1.1 說明其授權範圍與分發條件,也提醒使用者須處理模型材料或用途涉及的第三方權利。商業使用的判斷不該只看模型卡上的一行標籤,應確認所用版本對應的條款、內部採購與合規要求,以及資料本身能否提供給模型處理。
常見問題
Q1:開放權重是否等於開源?
不一定。開放權重代表模型參數可取得;程式碼、訓練資料、訓練流程及授權條款的開放範圍可能不同。Nemotron 3.5 Super VL 的模型卡列出 OpenMDW-1.1,採用前應閱讀適用版本的授權條款,並確認資料與衍生作品的權利。
Q2:120B 代表一定需要 120B 參數等量的顯存嗎?
不能這樣換算。120B 是總參數量,A12B 表示推論時每個 token 啟用約 12B 參數;實際記憶體還受權重精度或量化、上下文長度、併發數、視覺輸入、推論框架及快取策略影響。模型卡的配置只能作為該版本和設定的部署參考。
Q3:長時間代理可以不需要人工監督嗎?
不能由「長時間」推導出不需監督。應設定工具權限、步數與耗時上限、重試與費用上限、停止條件和人工接手流程,並演練服務中斷與部分完成的復原方式。
Q4:NVIDIA 公布的 benchmark 能代表自家任務表現嗎?
不能直接代表。benchmark 反映發布方指定的資料、提示、工具和推論設定。採用團隊需用代表性資料與實際工具框架重測,也應同時檢查錯誤型態、延遲、成本與人工介入需求。
- Nemotron 3.5 Super VL 是面向視覺理解與代理工作流的 120B-A12B 開放權重模型,產品定位與外部環境表現應分開判斷。
- 試用從資料可控、結果可查、動作可撤回的任務開始,並為工具呼叫設權限、停止條件與人工交接。
- 用相同測試集比較模型品質、資源、延遲、成本與維運負擔,再決定是否擴大部署。
參考來源
- NVIDIA (2026). *Open From Data Center to Desktop: NVIDIA Expands Nemotron Family With Highest Efficiency Super VL and Bolt Models*. NVIDIA Blog
- NVIDIA (2026). *NVIDIA Nemotron 3.5 Super and Lightning*. NVIDIA Nemotron Research
- NVIDIA (2026). *nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16 · Hugging Face
- OpenMDW (2026). *OpenMDW-1.1 | OpenMDW


