
StreamVibe 專案展示了一段「邊做炒蛋邊提問」的動態任務:使用者進行中的操作與問題會交錯出現,助理得持續判斷何時回應、是否沿用先前指令。這是 Google 研究團隊建立的影片基準片段之一,研究頁同時列出模型與多個基線的回覆,讓讀者對照介入時點與內容。這類情境把問題從「能不能看懂畫面」推進到「需求改變後,何時該說、何時該停」。
StreamVibe 目前是研究基準、模型與互動記憶架構,尚未正式推出為可直接使用的通用產品。讀者若想了解主動式助理進入工作流程後還涉及哪些權限與整合選擇,也可參考評估主動式 AI 助理功能與權限的方法。
影片助理看見操作,仍要判斷使用者何時需要幫忙
StreamVibe 要測試助理如何依據影片和任務脈絡,判斷介入時機與回應內容。它把需求分成明示、隱含和動態三類,讓評估不只停在收到問題後回答。
研究頁以「水開始沸騰時通知我」說明明示意圖,觸發條件清楚。相較之下,隱含意圖只有目標,例如「陪我做果醬麵包捲」,助理須觀察進度,判斷何時補充步驟。停下來可能是在思考,也可能是卡住,畫面變化本身不等於求助訊號。
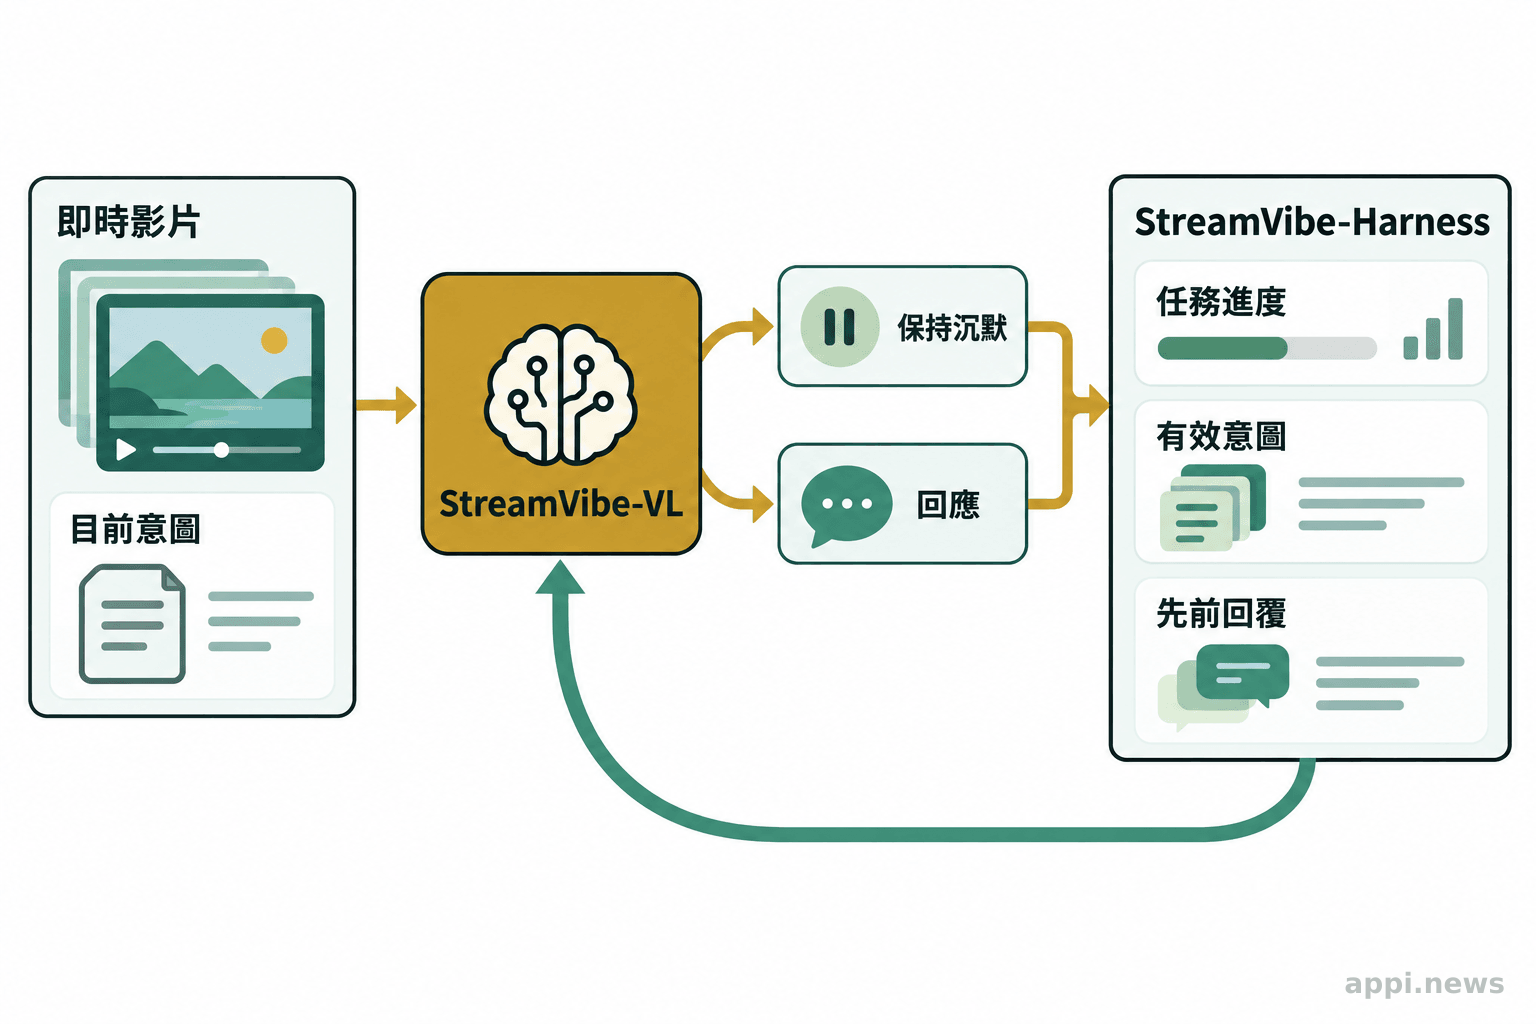
動態意圖更複雜。專案頁的紙藝示例先要求助理每完成一階段就回顧進度,接著使用者改成只在犯錯時提醒;若系統仍依最初要求回報,便會在需求已變時繼續插話。動態任務因此要求系統同步更新有效指令、操作進度和先前回覆,避免把舊目標誤當成現在的需求。對互動產品團隊來說,值得測的不只是模型有沒有聽見修正,也包括舊提示是否立即停止。
StreamVibe-Bench 如何把「何時開口」變成可測問題
研究團隊報告的 StreamVibe-Bench 有 4,100 個評估樣本、20,546 個協助提示點和 183.4 小時影片。樣本分為 600 個明示、2,000 個隱含、1,500 個動態意圖,涵蓋實體活動與數位操作。
每個時間點,模型只能使用當下已出現的影像、使用者指令和先前互動,選擇沉默或回應。這個設定避免模型偷看未來畫面。評估分成兩種:Pointwise 單看個別時刻的判斷,Trajectory 則讓模型從頭到尾觀看影片,並把自己先前的回答納入後續情境。前者像單題測驗,後者則檢查模型會不會因自己的前次回覆,把後續互動帶偏;兩種結果不能混成一個分數解讀。
研究以 Precision、Recall、F1 和誤報率檢視時機,再以回答分數和 Content F1 評估內容。提示太頻繁會增加不必要的打斷,只看答對率也看不出插話時機。候選提示點先由 Gemini-3.8-Flash 提出時間窗與參考回答,再由 4 位審查者一致同意才保留。這道程序讓基準有較明確的人工把關,但「四人都認可」仍不等同所有使用者都偏好同一個提醒時機。
專案頁還展示了幾個可追溯的片段。隱含指引案例「微波爐杯裝 shakshuka」呈現烹調任務,頁面列出 StreamVibe-VL 一次回覆、基線模型回覆數從 0 到 16。
「替玩具車更換後輪」也是操作指引案例,StreamVibe-VL 一次回覆,基線為 0 到 6 次;清潔水槽的案例則列出 StreamVibe-VL 一次、基線 0 到 2 次。這些回覆數讓人看見不同模型介入頻率的差距,不能單憑次數判斷哪個回覆正確或最合使用者心意。
還要回看影片證據與回答內容。對使用者而言,這提醒了評估主動功能時,產品展示最好同時提供原始片段、觸發時點和回覆紀錄。
這些片段也說明「少說」本身不能直接當成好表現。以換輪胎或加熱食物為例,漏掉安全相關提醒可能比多一次提示代價更高;一般介面操作則可能更在意不打斷工作。比較回覆時,應先確認任務本身、可接受的協助窗口與錯誤代價,再看模型是否在窗口內提供了正確資訊。這樣才不會把回覆次數簡化成排行榜,也比較能判斷某種代理適不適合自己的產品場景。
論文摘要指出,StreamVibe-VL 相較其他基線,在回應時機與回答品質上提升 10.7%;StreamVibe-Harness 則讓持續互動中的主動互動表現增加 12.3%。兩項數字分別對應模型比較與加入狀態追蹤後的互動結果,並非同一項指標,也不代表產品上線後使用者必然感受到相同比例的改善。
研究論文目前以 arXiv 預印本 PDF 公開,頁面未列出同儕審查刊物資訊;研究團隊的StreamVibe 專案頁也列出資料規模、意圖類型與模型比較。專案頁表示程式碼仍待內部核准後釋出,尚非可直接下載使用的正式產品。
「help at the right moment, without being asked」是 StreamVibe 專案頁對個人代理目標的描述,重點在適時協助而非每次都發言。(StreamVibe 專案頁)
StreamVibe-VL 和 Harness 怎麼追蹤意圖與進度
StreamVibe-VL 在串流過程中,逐步依可見證據選擇保持沉默或提供協助。StreamVibe-Harness(維持代理狀態與互動歷史的執行框架)則追蹤任務進度、仍有效的意圖和先前回覆,再把相關狀態交給模型判斷。
這個分工對長時間互動很重要。比方使用者原先要求每完成一階段就摘要,後來改成「只有出錯時提醒我」,Harness 需要更新目前有效的意圖;模型再依新指令與畫面判斷是否要說話。系統會在任務證據足夠時給出相符建議,並減少過早、過時或重複的回覆。
「resulting in a 12.3% gain in proactive interaction」是論文摘要描述加入 StreamVibe-Harness 後的持續互動結果。(Liu 等人,2026 年預印本)
基準成績距離產品現場還有幾個問題
不能直接代表。論文結果顯示,隱含與動態意圖比明確指令更難;連續互動時間拉長時,時機判斷分數也會下滑,修正需求的任務尤其容易漏掉後續變更。
誤介入有不同代價:太早提示會打斷使用者,太晚可能讓人走錯步驟,重複提醒則讓人忽略警示。沿用舊需求也會使建議偏離當下目標。產品團隊須檢查沉默時機,以及需求改變後能否停用過期目標。
此外,基準中的樣本、人工審核和任務影片不能涵蓋所有使用情境。論文採用影片及逐秒可見畫面的設計,資料治理也需要成為產品條件:鏡頭何時開啟、使用者如何同意、影片和互動紀錄保存多久、誰能存取,都應在實際導入前說清楚。評估 AI 代理基準是否能泛化到真實任務時,可以再對照檢查基準泛化能力的步驟;涉及持續影像資料時,也要檢視個人助理的資料保存與隱私邊界。
評估主動式助理時,先檢查五個介入條件
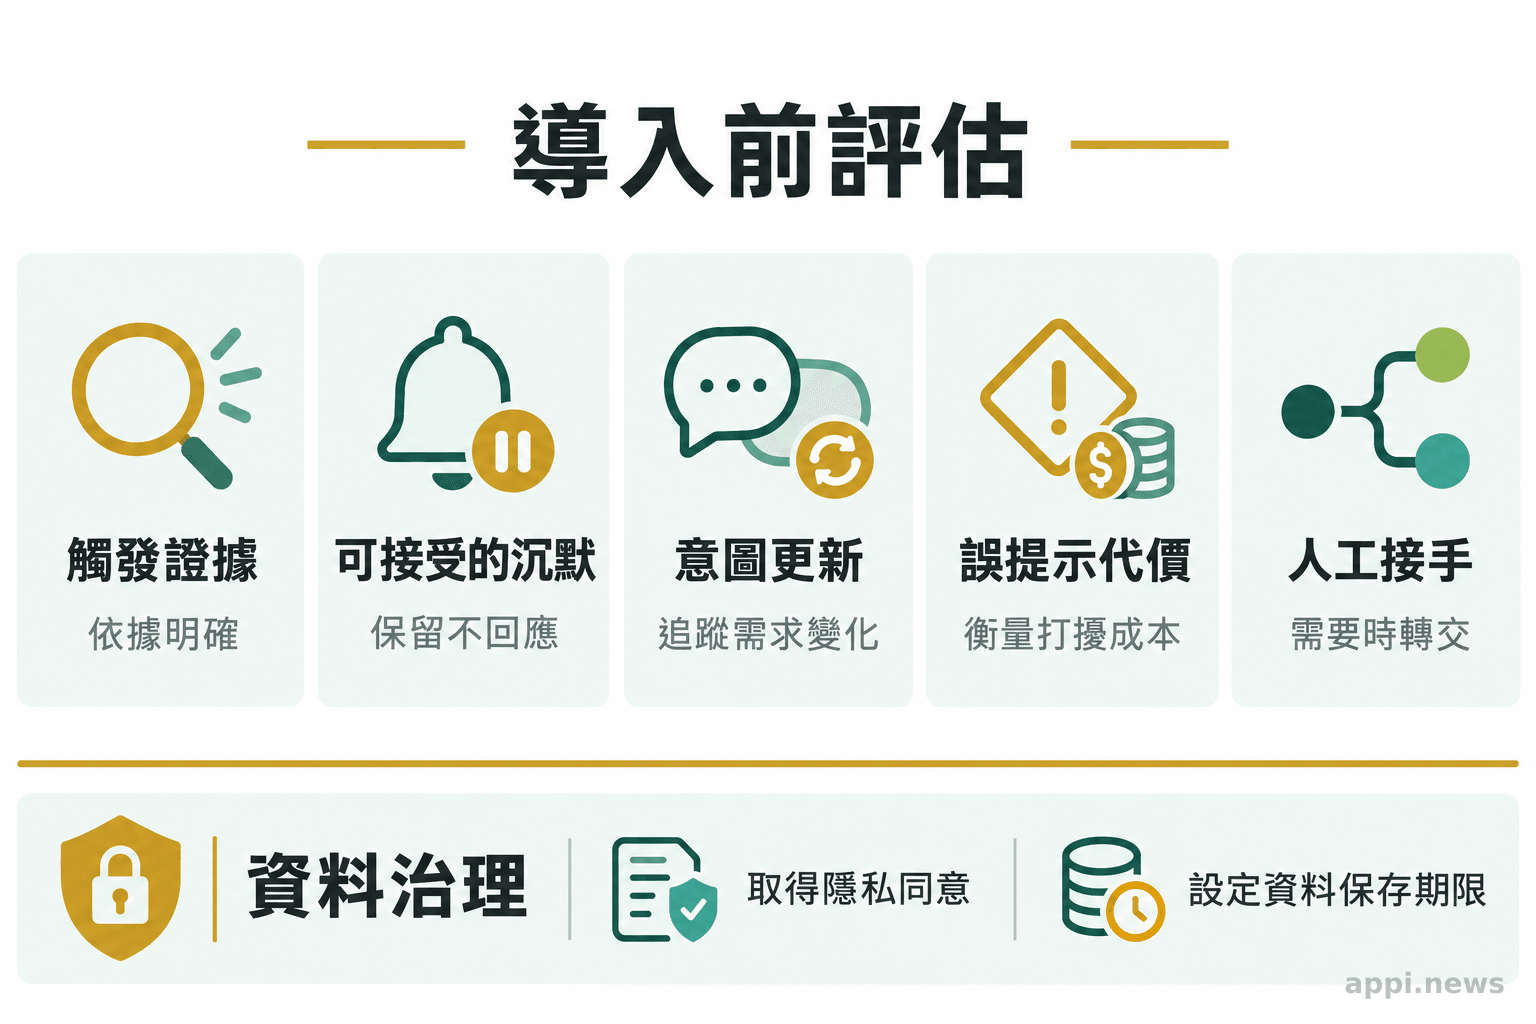
先定義觸發證據、可接受的沉默、意圖更新方式、誤提示代價和人工接手流程。再用目標使用情境測試,逐項確認系統的決策是否符合預期。
觸發與沉默
說明哪些可觀察證據足以讓助理提示,也要設定哪些時候應該等待。使用者停頓、重複操作或視線離開畫面,未必表示遇到困難,測試時應收集這些容易誤判的案例。
意圖更新與錯誤代價
確認使用者追加、替換或暫停要求後,系統怎麼更新目標,如何避免舊任務再次觸發。再按任務風險區分誤提示的影響:一般軟體操作、購物決策或涉及身體安全的操作,不能共用同一個容錯標準。
人工接手與資料治理
設定使用者如何關閉助理、要求人工協助、檢視或刪除紀錄,並明確說明攝影機資料用途、保存期限與權限。若系統無法確定使用者意圖,讓人補充需求或接手,可能比猜測後立即行動更合適。
- StreamVibe 將影片助理的需求分為明示、隱含與動態意圖,並測量何時回應和回答內容。
- 4,100 個評估樣本與 183.4 小時影片呈現研究規模;基準表現不等於所有真實場景的產品效能。
- 評估主動提示時,也要納入沉默、需求更新、錯誤代價、人工接手與影像資料治理。
常見問題
Q1:StreamVibe 是已經可以使用的影片助理嗎?
不是。現有資料介紹的是研究基準、模型和 Harness 架構。專案頁將程式碼標示為待內部核准後釋出,不能據此視為已正式推出的通用產品。
Q2:StreamVibe 如何避免助理一直打擾使用者?
研究把沉默視為模型可以選擇的行動,並以精確率、召回率、F1 和誤報率衡量介入時機。這些方法仍須在產品目標任務中重新驗證。
Q3:4,100 個樣本是否代表模型能處理所有影片任務?
不能。這是研究團隊設計的評估資料,涵蓋特定影片來源、意圖分類和標註方式。長時間互動、需求改變、使用者同意及誤介入成本仍需分別測試。


