
Allen Institute for AI(Ai2)的研究團隊替 StateBench 設計四層狀態追蹤題,從變數固定賦值,逐步加入覆寫、依舊值更新與一般有限狀態追蹤,再測試預訓練模型能否回答最後狀態。結果顯示,受測預訓練模型連「依變數舊值更新」這一層都沒有穩健解決。這是研究團隊在合成序列中的測試結果,不能直接當作企業知識庫成效。StateBench 研究
但這裡要先問一個更前面的問題:長文件模型評測測到的是「找不找得到某段文字」,還是「能不能把散落各處、彼此有先後關係的更新累積起來」?兩種能力都與長上下文有關,測法和錯誤原因卻不同。若知識庫只用單次查找題驗收,模型找對舊資訊仍可能回答錯目前狀態。像企業知識庫架構需要處理的資料與檢索問題就說明了檢索增強生成(RAG)如何先檢索相關資料,再交給模型生成回答;StateBench 則把焦點移到多次狀態更新後能否正確回答。
StateBench 的測試,從一連串更新追問最後狀態
StateBench 測試模型能否依序處理變數更新,並給出一組狀態的最終值。它把狀態追蹤拆為四種複雜度,讓評測者比較模型處理覆寫、參照與交換等操作時的差異。
「狀態追蹤」是同一個實體或變數經過多次改變後,仍能還原目前值。搜尋只需找到曾出現的內容;追蹤還要判斷更新是否取代舊值,以及更新之間的依賴關係。
論文將任務分成四層。第一層是只寫入一次的固定變數;第二層允許把變數改成新值;第三層允許依變數本身的舊值計算更新;第四層則包含變數互換等一般有限狀態追蹤。每往上一層,模型需要處理的更新關係更複雜。
長文件評測不只一種,幾個基準各自測到哪裡
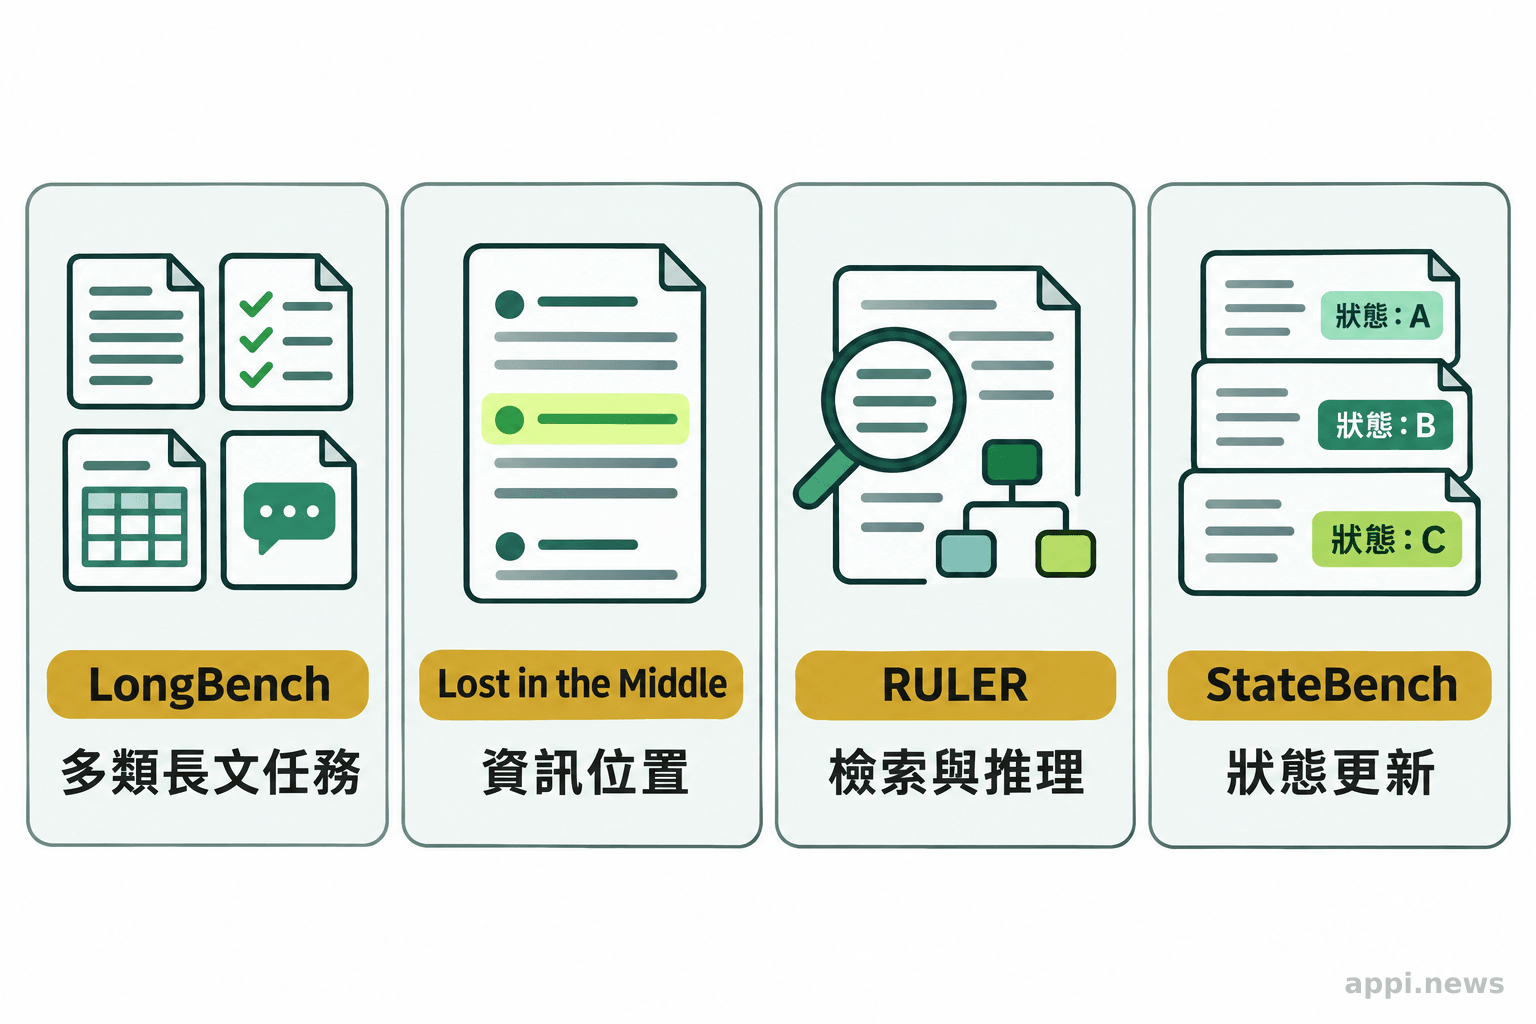
LongBench 涵蓋多種長文任務,Lost in the Middle 檢查相關資訊所在位置的影響,RULER 擴充長上下文檢索與推理題型;StateBench 集中測量多次更新後的狀態追蹤。
LongBench 研究團隊以 21 個資料集、6 類任務評估 8 個模型,涵蓋問答、摘要與程式補全等工作;結果顯示 GPT-3.5-Turbo-16k 優於受測開源模型,但長上下文仍有困難。這個案例說明綜合分數能比較多種長文任務,無法單獨指出多次覆寫後是否答對目前值。LongBench 研究AI 評測基準與採購評估也提醒,基準分數必須對照任務用途解讀。
Liu 等人在 Lost in the Middle 研究中,於多文件問答測試把含答案的段落移到長輸入的開頭、中段或結尾,觀察模型回答是否改變。多款模型在答案位於中段時表現明顯下降,即使是長上下文模型也會如此;這個案例指出,文件很長時,答案位置本身就可能影響取用。研究全文
RULER 研究團隊則將「大海撈針」檢索題擴展為 13 種任務,測試 17 個長上下文模型,包括多跳追蹤與彙整。模型在基本檢索題上接近滿分,但輸入拉長至 32K tokens 時,只有一半達到研究設定的滿意表現。這個案例顯示,只用單一線索檢索題驗收,可能高估長文件處理能力。RULER 研究
| 基準 | 主要觀察面向 | 可回答的問題 | 不宜直接推論 |
|---|---|---|---|
| LongBench | 多類長文本任務 | 模型在不同長文工作上的表現如何? | 單一任務的狀態更新錯誤原因 |
| Lost in the Middle | 資訊在輸入中的位置 | 關鍵資訊放在中段是否更難取用? | 多次更新後的目前狀態是否正確 |
| RULER | 長度、檢索、多跳與彙整 | 輸入變長或推理步驟增加時表現如何? | 真實知識庫的完整工作流程能力 |
| StateBench | 分層的狀態追蹤任務 | 模型能否套用更新並輸出最後狀態? | 真實文件新增實體或企業流程的表現 |
「即使是長上下文模型,相關資訊放在長輸入中段時,表現仍可能明顯下降。」(Liu 等人,Lost in the Middle 研究摘要(中文意譯))
為什麼知識庫問答答對,仍可能記錯目前狀態
單次檢索題通常只檢查模型有沒有找到答案依據;狀態追蹤題還要確認模型是否辨認更新先後、覆寫舊值,並保留仍有效的資訊。
知識庫常把文件切成片段後交給模型。若同一筆資料在不同版本中多次更新,只問「文件寫過什麼」容易測到檢索,卻未必確認系統能否判定目前版本。
錯誤也可能出在不同環節。檢索沒有找出最新片段,是召回或排序問題;檢索已提供前後更新,但模型仍沿用舊值,才較接近狀態累積錯誤。若把兩種情形都記成「問答答錯」,團隊難以判斷應修檢索、文件版本管理、提示設計,還是模型處理更新的能力。
規格文件先列維護時間,會議紀錄後來改期時,若檢索只帶回舊版,問題在召回或版本治理;新舊內容都已送入而模型仍照抄舊時間,才是更新判斷錯誤。驗收需保存上下文和來源版本。
醫療知識庫還需核對資料適用對象與版本,避免把一般資訊套用到特定族群。
StateBench 的測試設計與結果,哪些能說、哪些不能說
StateBench 顯示,在它設定的合成任務、序列長度與格式下,模型在不同層級的狀態追蹤任務表現有差異。這些結果可用來提出待驗證問題,不能直接當成真實知識庫的部署成績。
原研究分別評估直接以 StateBench 資料訓練的模型、預訓練模型,以及數款商用前沿模型。這幾組條件不同,不能把模型分數當成同一種測試的排名。論文指出,預訓練模型在較複雜的狀態追蹤任務表現下降;前沿模型在較難任務與較長序列上也出現明顯退化。這表示特定任務還有改進空間,並不等同測出企業文件問答的準確率。
StateBench 使用固定變數與更新操作組成合成序列,未涵蓋真實文件中的歧義、權限與版本衝突;題目格式也會影響表現。引用結果時須交代任務、長度與模型條件。
「我們發現,預訓練模型在 StateBench 上,連部分較簡單的狀態追蹤都未能穩健解決。」(Petty、Merrill 與 Sabharwal,StateBench 論文摘要(中文意譯))

把狀態變化納入知識庫驗收的檢查清單
先為同一實體建立有順序的更新序列,再改變問題、文件長度與更新位置,並分開記錄檢索錯誤和狀態累積錯誤。最後用實際文件重測,確認合成題發現的弱點是否出現在使用流程。
- 選定實體與欄位:例如專案負責人、服務狀態或規格版本,保存每次更新的時間與來源。
- 編排更新序列:設計初始值、覆寫、撤銷、重新設定與相依欄位,明確標出每一步的預期狀態。
- 準備不同問法:分別問目前值、變更前的值、哪次更新生效,以及撤銷後哪些欄位仍有效。
- 改變文件條件:調整上下文長度、更新出現位置、干擾資訊數量及片段是否跨文件。
- 標註錯誤類型:檢索不到最新依據、檢索到但沿用舊值、錯讀更新關係,分開統計並保留錯誤樣本。
- 高風險族群覆核:涉及孕婦、兒童、慢性病患者或長期服藥者時,由相應領域人員核對適用條件、資料版本、禁忌與不確定性;缺少個別資料或答案衝突時,測試預期回覆應停止推論並轉人工確認;題目也要檢查年齡、孕週、共病與用藥資料是否齊全,缺項時不得自行補值。
每輪測試固定模型版本、提示、檢索參數與文件快照,並一次只改一項設定,才可把分數變化對應到具體調整。
選評測基準時,回到實際資料與使用流程
先確認產品最常出錯的工作,再挑能重現該錯誤的基準與自有測試。若問題是更新後回答過期,StateBench 可作為狀態追蹤補充;若是位置偏差、多文件問答或彙整,還需搭配其他基準。
公開基準適合比較固定研究條件,自有題庫則反映文件格式、更新流程與錯誤成本;兩類結果應分開呈現。
- 狀態追蹤測的是多次更新後的目前值,與找出單一段落不同。
- LongBench、Lost in the Middle、RULER 和 StateBench 測量面向各異,應按錯誤類型搭配使用。
- 合成基準不能替代真實文件驗收;測試要保留模型、格式、序列長度與錯誤分類。
常見問題
Q1:StateBench 是企業知識庫的實測結果嗎?
不是。它以合成狀態追蹤序列測試模型,研究結果不能直接視為企業知識庫導入成效。
Q2:StateBench 的四層任務差在哪裡?
任務由固定寫入,逐步增加可覆寫、依舊值計算及變數互換等操作,追蹤關係也隨之複雜。
Q3:長上下文視窗夠大,是否就能追蹤更新?
不能只由視窗長度判斷。長度、任務複雜度、資訊位置與題目格式都可能影響表現,應用符合實際需求的題目驗收。
Q4:知識庫團隊可以先做哪項測試?
找一個常更新的實體,建立初始值、覆寫與撤銷序列,之後詢問目前值,並檢查模型是否引用最新有效依據。
參考來源
- Petty J, Merrill W, Sabharwal A. (2026). *A Fine-Grained Hierarchy and Benchmark for State Tracking in Language Models*. arXiv:2611.03094
- Bai Y, et al. (2024). *LongBench: A Bilingual, Multitask Benchmark for Long Context Understanding*. Proceedings of ACL 2024
- Liu NF, et al. (2024). *Lost in the Middle: How Language Models Use Long Contexts*. Transactions of the Association for Computational Linguistics, 12, 157–173
- Hsieh CP, et al. (2024). *RULER: What's the Real Context Size of Your Long-Context Language Models?* COLM 2024


