專家預測能否直接拿來決定模型採購?Forecasting Research Institute(FRI,預測研究機構)近期彙整多項 AI 技術預測後指出,已經能判定的部分基準測試結果,比受訪者預期更早出現。這提醒導入團隊定期更新評測證據,但不能據此認定 AI 專家總是低估進展,更不能把基準分數直接當成工作效能或採購答案。
評測要回答的問題更具體:模型在團隊指定的任務、資料、設定和成本限制下,能否穩定完成工作?先看研究究竟比較了什麼,再檢查評測設計,採購決策才有可重現的依據。
一、研究顯示哪些 AI 預測落後了?
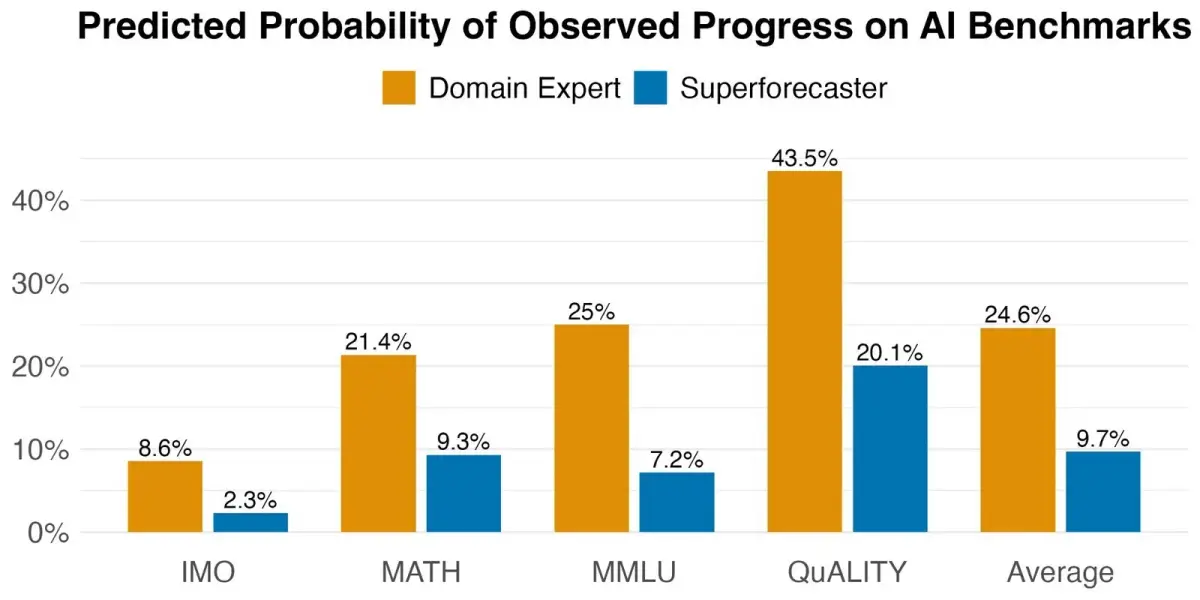
FRI 對 2022 年中至 2026 年 8 月間多項研究所蒐集的預測做階段性整理,發現已判定的多個 AI 基準測試進展快於專家與超級預測者的中位數預測。這是跨研究的暫時性觀察,並非單一完整結案的同行評審研究。
超級預測者指在預測競賽中有良好紀錄的一般預測者。FRI 的資料橫跨能力基準、非基準任務、AI 採用與擴散、社會影響及治理等問題;專家群體則因研究題目而異,包括電腦科學、產業、經濟與政策領域。LEAP(Longitudinal Expert AI Panel,縱向 AI 專家調查)也持續追蹤專家與超級預測者對進展的估計。
較容易判讀的是有明確分數或完成條件的基準測試。FRI 舉例,受訪者曾預測 AI 達到數學競賽金牌水準的年份,實際里程碑比專家中位數早約五年、比超級預測者中位數早約十年。另一例是 FrontierMath 數學測試的部分難題:專家與超級預測者預測 2025 年底可達成約 31% 與 30%,FRI 報告的實際結果為 40.7%。
這些數字應連同測試規格一起看。FRI 註明,FrontierMath 後來發現部分題目有錯誤並調整分數,因此當時的 40.7% 是依預測問題原本的判定方式採用的未調整結果。研究仍認為預測低於結果的方向明顯,但分數的解讀受題目品質與判定規則影響。
不同類型的預測也沒有呈現同一方向。FRI 認為 AI 採用與擴散的紀錄較混合,部分經濟指標偏低估,工作時數等廣泛採用指標則仍難判斷;自駕車普及的預測甚至可能偏高。至於宏觀經濟與社會影響,多數題目還沒有足夠結果可供判讀。這些差異說明,不能把基準測試的結論直接套到整個 AI 產業。
“The median expert and superforecaster tend to dramatically underestimate AI progress on benchmarks.”(譯:專家與超級預測者的中位數,往往大幅低估 AI 在基準測試上的進展。)— Forecasting Research Institute
二、預測偏差能說明什麼,不能說明什麼?
不能。FRI 的整理主要看已能判定的題目和群體中位數,既看不到所有尚未到期的預測,也可能掩蓋表現較準的個別預測者;目前證據支持「若干已判定基準的中位數預測偏低」,不支持「專家總是低估 AI」。
判定時間會造成方向性偏差。預測 AI 在某年以前達標,若里程碑提早發生,研究者很快就能記錄低估;預測某項能力會出現、但實際晚於預期,往往得等到期限過後才看得出高估。FRI 也提醒,多數預測仍未解決,所以目前樣本自然較容易收進提早達標的案例。未到期的問題只能列為未判定,不能拿來當成準確或錯誤的證明。
中位數也不是每個人的答案。某群體的中位數落後,可能有一部分人估得接近實際結果;只看中位數會隱去不同預測者的分布與理由。FRI 指出,部分研究中的少數預測者比中位數更準,後續還會分析預測紀錄與個人表現。
另一個邊界在基準測試與真實工作之間。基準分數量測特定題集、工具權限、提示方式和評分規則下的表現。分數上升可以表示模型在這個測試條件下進步,卻不能單獨證明它在公司文件、客戶服務或程式維護流程裡同樣可靠。FRI 也提出,模型可能比預測者預期更容易「針對測試最佳化」,這會擴大測試進步與實際影響之間的距離。
題目規格本身也可能改變預測。FRI 提到 LiveCodeBench Pro(Hard)題目或有受訪者未理解基準允許模型回頭測試先前季度題目的情況。若參與者理解的任務不同,即使都在回答同一題,預測和實際結果也可能比較失準。基準版本、計分方法、測試集更新日期與允許的工具都應留存,否則「分數變高」無法說明究竟是模型進步,還是測量條件改變。
三、模型評測落後時,先檢查哪些原因?
先核對評測任務、資料集版本、計分規則、模型版本與執行設定,再判斷結果是否反映能力變化。若基準或任務規格前後不同,分數差距不能直接歸因於模型。
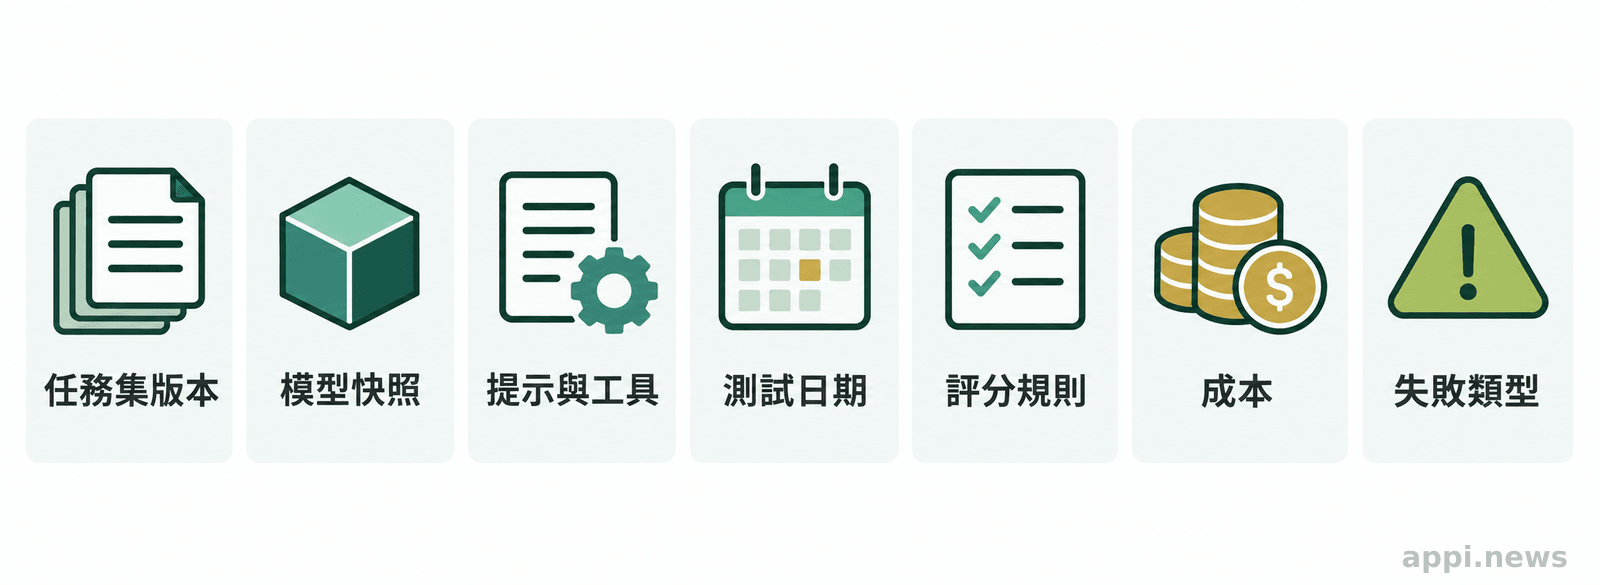
把一次測試拆成可追溯的記錄,能避免把版本差異當作能力差異。模型名稱應包含供應商公布的版本或快照資訊;若服務只提供動態版本,也要記錄測試日期。推論設定(模型執行時採用的參數與工具條件)則包括提示詞、溫度、上下文長度、外部工具、重試次數和人工介入程度。測試集若曾修訂,要保留版本與變更原因,並確認新舊成績能否公平比較。
接著檢查任務是否對應真實流程。客服草稿可以用正確率、引用依據與人工修改時間評估;程式維護可以記錄測試通過率、回歸錯誤和工程師覆核時間。若只量到「答案看起來合理」,就可能漏掉引用錯誤、格式修補、敏感資料處理或失敗後的人工成本。評測指標要連到使用者實際承擔的風險和工作量。
根因也可能在資料與操作。測試樣本是否太接近模型訓練資料?任務描述是否含糊?評分者是否採用一致標準?不同團隊是不是用了不同工具權限?這些問題都會讓分數偏高、偏低或難以重現。可先固定一批代表性任務,加入成功、部分成功和失敗案例,再讓熟悉工作的人檢查判分規則是否符合現場要求。
四、導入團隊如何建立定期更新流程?
固定使用情境與代表性任務,保存每次測試的模型、資料和設定版本,並在模型更新、流程變更或採購檢視時重測。這樣可以將新舊證據放在相同條件下比較,並看出哪些差異來自模型,哪些來自測量方式。
第一步是建立任務集。從實際工作流程挑出常見、重要且容易出錯的任務,移除個資與機密內容,標註預期輸出、可接受範圍及不可接受錯誤。任務集不必很大,但要涵蓋日常需求與高影響失敗情境。若資料會更新,可建立固定測試集和定期補充的新題集:前者維持前後比較,後者觀察模型處理新情境的能力。
第二步是讓執行條件可重現。每次評測保存任務集版本、模型版本、提示詞、參數、工具權限、執行日期、評分規則與樣本數。結果除平均分數外,也記錄各類失敗、人工覆核時間、重試和修正比例。生成式 AI 的回答可能有變動,必要時重複執行部分任務,觀察穩定性,不以單次最佳結果代表日常表現。
第三步是安排觸發點。新模型版本發布、服務條款或價格改變、資料源更新、工作流程改造、錯誤率異常,以及年度採購或續約前,都可以啟動複測。固定週期有助於例行盤點,但不必把頻率訂成所有團隊共用的數字。高風險任務、快速變動的供應服務和低風險內部輔助,各自需要不同的檢視頻率。
以客服摘要為例,單看「摘要是否流暢」很難用來決定要不要換模型。團隊可以抽取去識別化的歷史工單,標出必須保留的時間、處理狀態、承諾事項和客戶限制,再依遺漏關鍵資訊、錯誤補寫、格式不符及人工修訂時間分項評分。新舊模型沿用相同題目測試,另加近期工單檢查新情境;前者看變化,後者確認既有題目沒有涵蓋的問題。若摘要涉及敏感資料,再將權限與保存設定納入同一次檢視。
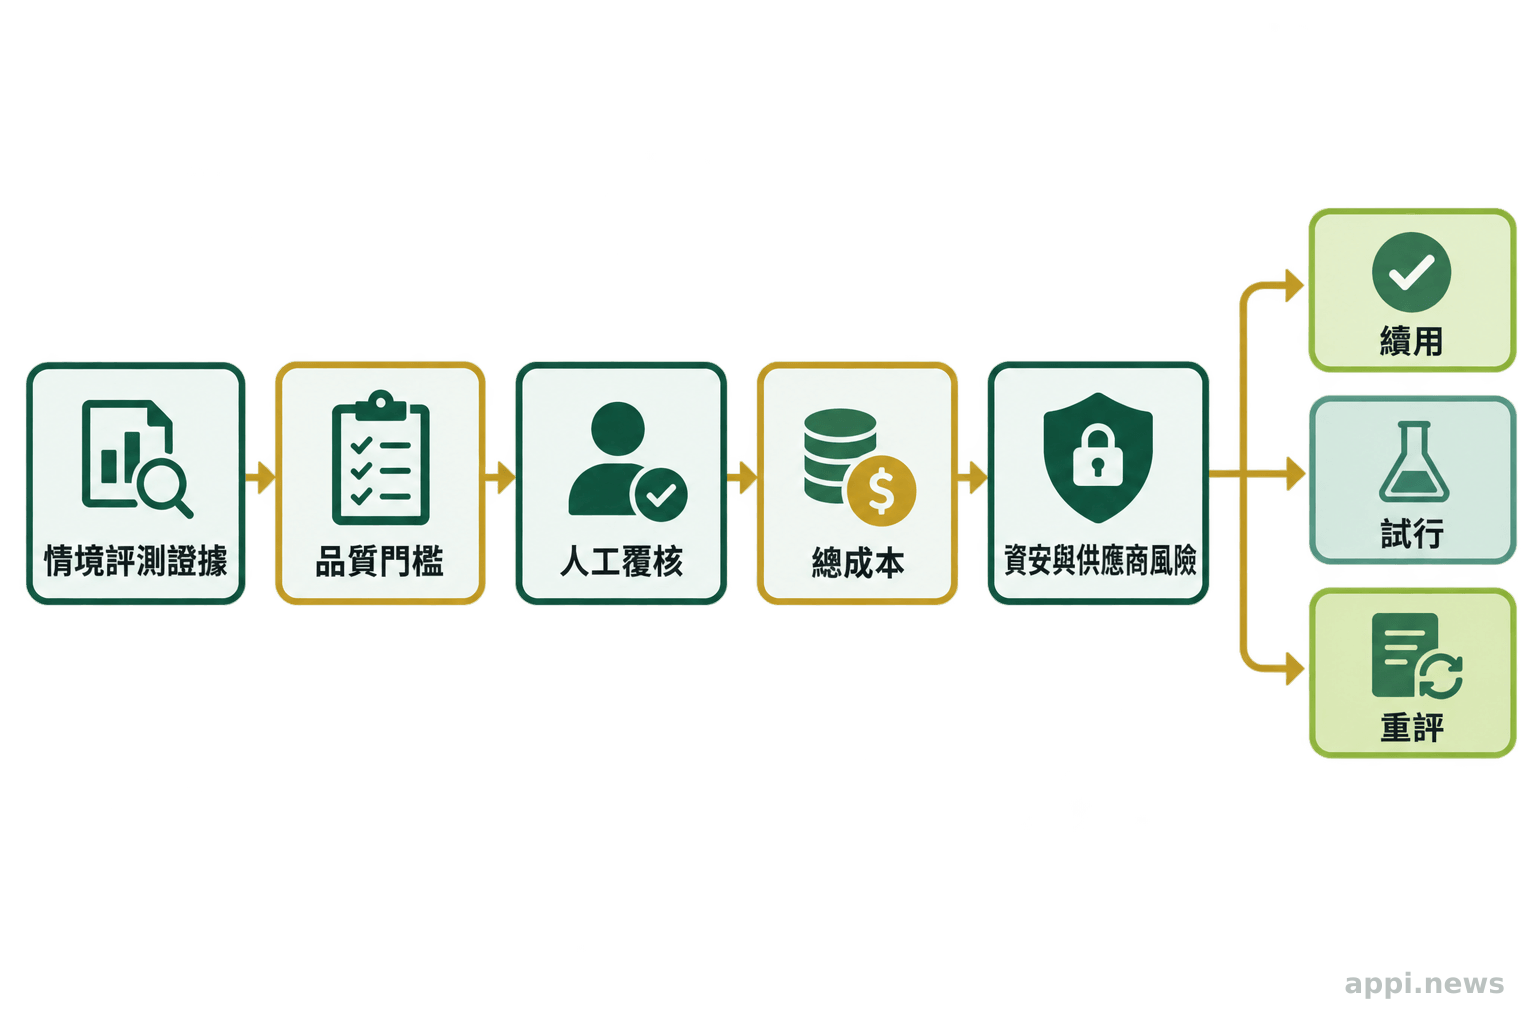
測試結果也應同時列出品質、延遲、使用成本、整合與維護工時、權限管理和資安需求。NIST 的 AI 風險管理框架將評估與管理放在 AI 系統的設計、開發和使用全程,提醒組織用自身目標和風險脈絡安排管理工作。模型評測表可以作為其中一份證據,仍需配合責任分工、監控和風險處理流程。
“The Framework is intended to be voluntary, rights-preserving, non-sector-specific, and use-case agnostic.”(譯:此框架採自願使用,重視權利保障,不限定產業,也不限定使用情境。)— 美國國家標準暨技術研究院(NIST)
五、如何把評測證據用在模型採購決策?
不能只看公開基準分數。採購比較應以團隊自己的任務、資料處理要求、總成本和失敗後果為準,並把新模型放到相同條件下重測,再決定續用、試行或重新評估供應商。
評測前先定義可接受門檻。例如,哪些任務必須正確引用內部來源、哪些錯誤需要人工確認、回覆延遲和單次成本的範圍為何。門檻要連到流程後果:草稿可由人員複核時,容許的錯誤型態與完全自動處理不同。模型達到平均分數,也不代表高風險錯誤可以忽略。
比較方案時,把模型表現放進完整的使用成本。除 API 或授權費外,還要計入資料清理、提示維護、系統整合、人工覆核、監控與切換成本。供應商鎖定、服務區域、資料保存方式、價格調整與版本下架,都會影響採購後的持續使用。若新模型在任務集上提升有限,卻需要大幅改寫流程或增加治理負擔,團隊可以保留現有方案並設定下一次檢視條件。
把決策和證據一起存檔:測了哪些任務、採用哪個模型與版本、結果如何、剩餘風險由誰接受、哪些事件會觸發重評。FRI 的彙整指出部分基準預測落後,也揭露了題目理解、基準設定與判定時間的限制;這些限制正好說明,採購結論需要回到團隊可驗證的條件。先找出分數差異的原因,再決定要不要改模型、改流程或重新設計測試。
盤點一項正在使用的模型任務,確認評測集、模型版本、執行設定、測試日期、成本與失敗紀錄都有保存,並指定在模型更新、流程變更或採購檢視時重新評估。
- FRI 的階段性整理顯示,部分已判定的 AI 基準進展快於預測中位數,研究尚不足以概括所有能力與實際影響。
- 基準分數只代表特定任務和測試條件,需核對版本、資料、設定與日期。
- 採購比較應使用團隊真實任務,並同時檢視品質、人工成本、整合負擔與風險。
常見問題
Q1:AI 模型多久評測一次?
沒有適用所有團隊的固定頻率。可依任務風險和服務變動程度安排例行檢視,並在模型更新、資料改版、流程變更或採購續約前複測。
Q2:不同模型的基準分數可以直接比較嗎?
只有在測試集、提示、工具權限、計分方式和執行條件足夠一致時,分數才較有可比性。若條件不同,應註明差異,並用團隊自己的任務集補測。
Q3:什麼情況需要重新評估供應商?
服務價格或條款改變、模型版本無法固定、資料處理方式調整、錯誤或延遲明顯變化,以及組織的安全要求改變時,都適合檢視供應商與替代方案。