
P-Zero Research 在 2026 年 10 月公布 TasteVal,測試模型在固定 AI 研發題目上設計實驗並解讀結果。研究者報告,Opus 5.5 的實驗計算效率指標為專家基準的 2.30 倍。這是「AI 能不能做研究」的可測量切口,也讓 Anthropic 共同創辦人 Jack Clark 表示,他現在認為 full RSI(完整遞迴自我改進,也就是 AI 改良研究與訓練流程,進而產生更強後繼系統的循環)在 2027 年變得可能的機率較此前看法高。
但「會設計實驗」和「能決定該研究什麼」,是兩種不同能力。TasteVal 的高分能支持什麼結論?它和 AI 自主改進自身、甚至訓練出更強後繼模型之間,還缺了哪些證據?
TasteVal 把 AI 研究能力拆成可測量的一段
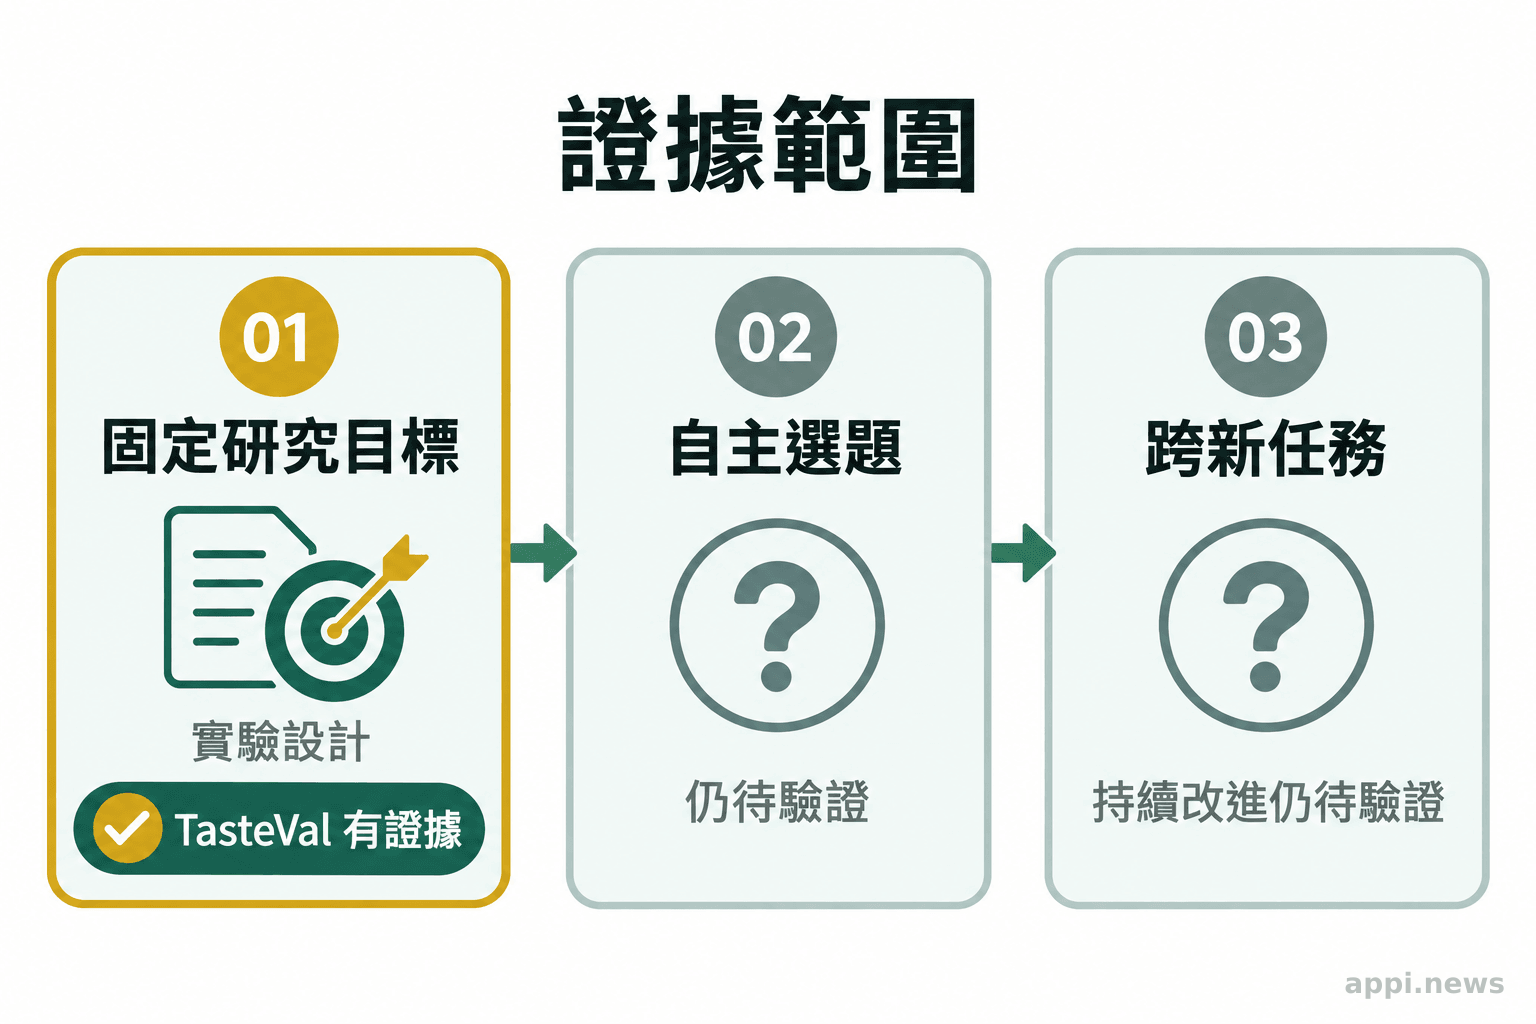
TasteVal 測量模型在已指定研究問題下,設計實驗、根據結果調整做法並解讀結果的能力;它沒有直接測量模型能否自行挑選研究方向。
Jaffe 與 Sherburn 在論文中把研究品味分成選出有趣問題、設計實驗、解讀結果等部分,TasteVal 聚焦後兩項。測試由兩個角色合作:受評模型擔任 Researcher,提出實驗並解讀結果;固定的程式代理負責實作與執行。這樣的安排試圖把研究判斷和寫程式的能力分開。
研究團隊設計八項開放式任務,涵蓋預訓練資料、語言模型微調、偏好建模與對抗提示穩健性。題目不公開,以降低模型事先接觸測試題目的可能;每次測試最多使用 40 H100 GPU 小時或 120 小時。
這種設計讓不同模型能在相同題目與資源上比較,也使分數較容易重複檢查;但題目不公開,外部團隊不容易自行重跑完整測試。讀者可把結果視為研究團隊在這組任務上建立的比較基準,並留意其他團隊能否以新題目重現類似差異。若模型熟悉的只是特定任務格式,換一批資料或改變成功條件後,排名未必維持。
「實驗計算效率」指模型達到專家相同分數所需的序列實驗計算量,不是全面研究能力總分,也不代表成果價值、可重現性或跨領域適用性。
「TasteVal 測量的是研究品味中的實驗部分。」— Oliver Jaffe 與 Dane Sherburn,TasteVal 論文摘要(中文意譯)
2.30 倍高於基準,仍要看比較條件
2.30 倍指 Opus 5.5 在該研究設定下,相對於專家基準的實驗計算效率;它不表示模型的最終研究表現高出 2.30 倍,也不等同於所有研究工作都比人類快。
研究團隊邀請 24 位專家,每項任務至少兩人,以各題最佳嘗試作基準。Opus 5.5 的計算倍率為 2.30 倍,95% 信賴區間為 1.15 至 4.37 倍;區間提醒讀者估計有不確定性。受邀專家的最佳嘗試也不等於全球頂尖研究者的能力上限。
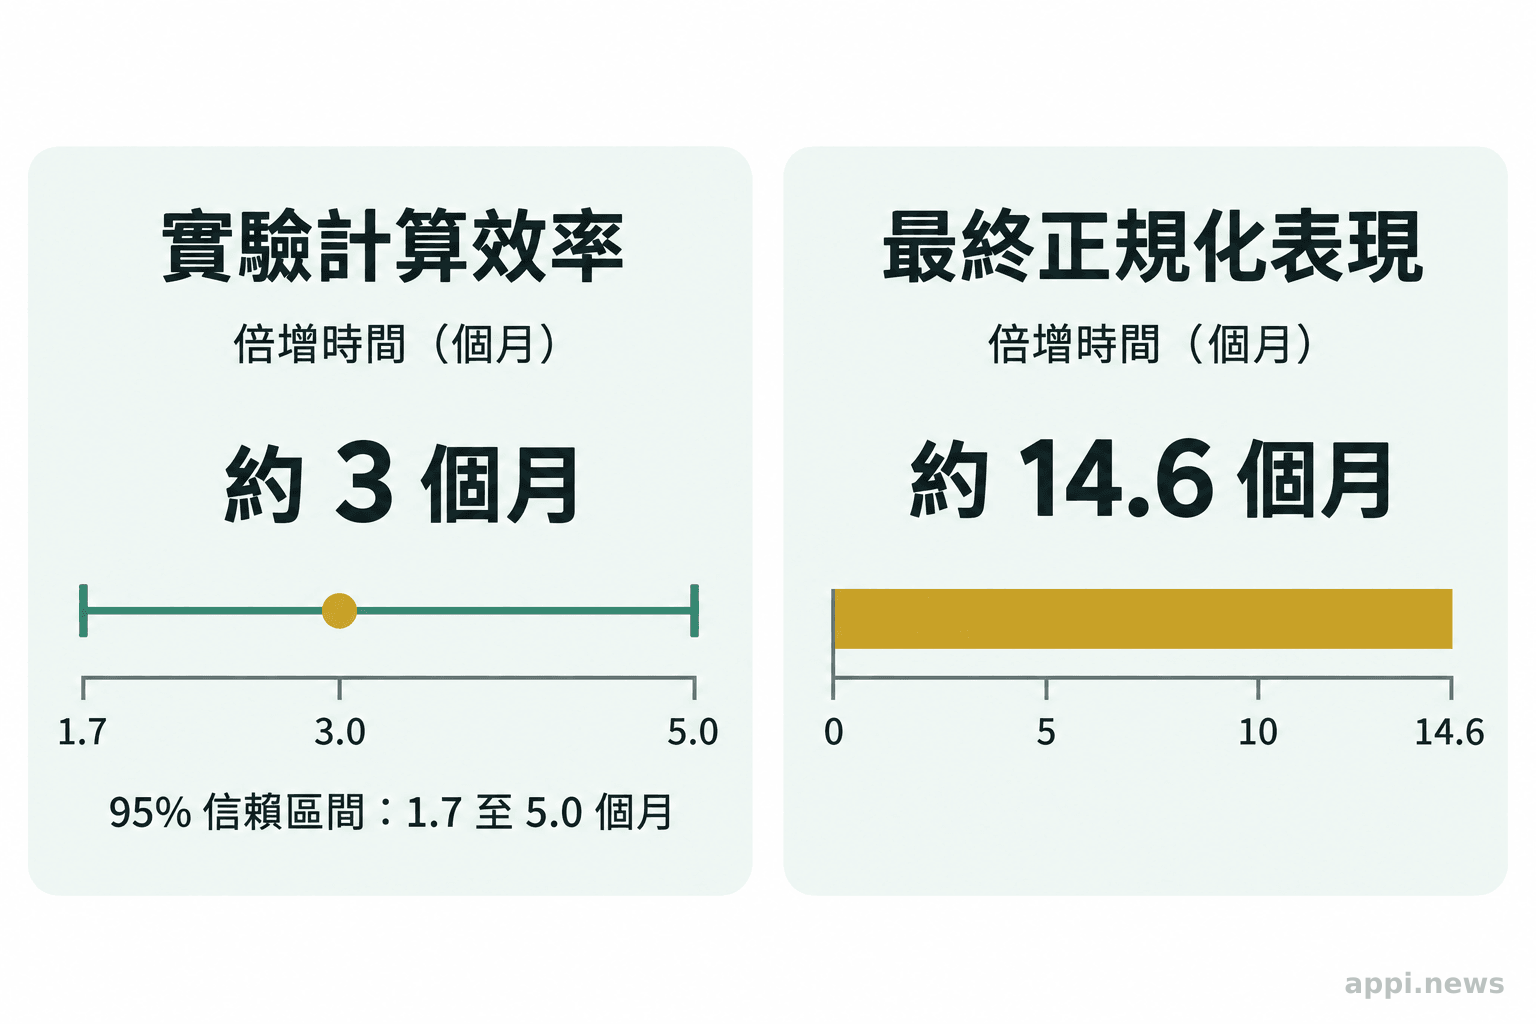
論文另估計,自 2025 年 12 月起,前沿模型的實驗計算效率約每 3 個月倍增(95% 信賴區間 1.7 至 5.0 個月);最終正規化表現則沒有相同轉折,約每 14.6 個月倍增。前者談所需計算量,後者談最終分數,不能混讀。
若工作重點是在固定預算內多試幾輪,效率指標有參考價值;若要提出研究方向、重現結果或改良模型,單看曲線不夠。任務偏向快速且容易驗證的問題,較可能被反覆優化。研究團隊提醒,這可能高估研究品味進步速度;有限的模型測試又可能低估進步幅度。
實際使用時,效率與品質也要分開記錄。例如一個工具若用較少計算資源找到可行方案,仍要確認方案是否達到既定品質門檻、能否重現,以及省下的時間是否足以抵銷驗證成本。若評分只看短期可量化結果,研究者可能把資源集中到容易得分的子問題,卻忽略長期價值較高、但需要更久才能確認的方向。這些是採用單一效率指標時應補上的流程觀察,不是 TasteVal 已測出的結果。
自我改進還需要選題與能力累積
還不能這樣推論。TasteVal 把研究目標先交給模型,沒有測它能否發現值得研究的問題,也沒有測一輪研究成果能否持續提升下一代模型。
AI 研究包含選方向、提假設、測試、解讀證據,再決定如何使用結果。TasteVal 聚焦實驗設計與判讀;題目由人指定時,模型沒有回答為何先做這題、成果如何變成下一輪能力。
Google DeepMind 的 AlphaEvolve 結合 Gemini、程式演化和自動評估器,提出程式後執行計分,再以較佳方案繼續探索。DeepMind 表示,它曾改善資料中心排程、加速部分矩陣乘法,也協助改善訓練底層模型的流程。這些可計分的演算法案例顯示特定環境中的迭代成果,沒有證明系統能自主選定整體研發方向。
這類迭代之所以可行,關鍵在於目標與回饋訊號能被寫進評估器:候選方案可以執行,結果也能用明確指標比較。許多研究問題沒有這種即時、單一的分數,可能同時涉及資料品質、外部效度、成本與倫理取捨。把成功案例延伸到這些問題前,需要先問模型能否提出合理的衡量方式,以及評估器本身是否漏掉重要代價。
Atria Dawn 團隊的 2026 年預印本分析 56 位參與者的 769 筆任務紀錄與代理日誌。研究者表示,代理常提出方法並實作修改,人類保留多數最終決定,以判斷和回饋引導探索。這是單一團隊的研發個案,呈現代理增加提案與執行、人類保留方向判斷的分工。
若要判斷這種分工是否逐步轉成自主能力,還要觀察人類介入減少後,任務品質是否維持,代理能否辨認錯誤結果並修正研究方向,以及成果能否在新任務上再次使用。任務紀錄能呈現協作過程,卻不能單獨回答這些長期問題;研究者的判斷與決策仍是系統表現的一部分,評估時應把人類投入一併記下。
| 案例 | 主要觀察對象 | 能支持的結論 | 尚未直接回答 |
|---|---|---|---|
| TasteVal | 固定題目下的實驗設計與判讀 | 特定基準中的計算效率表現 | 自主選題與長期自我改進 |
| AlphaEvolve | 可自動評分的演算法最佳化 | 特定工程任務能以迭代找到改良方案 | 能否自主決定更廣泛的研發方向 |
| Atria Dawn | 研發任務中的人機協作紀錄 | 代理提案與執行、人類保留多數決策 | 其他團隊是否也有相同分工與成效 |
「代理常提出方法並實作修改,人類保留多數最終決定。」— Guo 等人,Atria Dawn 論文摘要(中文意譯)
Jack Clark 的 2027 年說法是個人預測
Jack Clark 在 2026 年 10 月的 Import AI 電子報中表示,他現在認為 full RSI 在 2027 年變得可能的機率較此前看法高;這是他的個人時間判斷,不是研究結果或確定事件。
Clark 把研究品味視為 AI 加速 AI 研發的重要變數,並提到數學研究進展和 TasteVal 等基準訊號。TasteVal 是他更新看法的參考之一,不能驗證 full RSI 何時發生;「完整」所指的範圍與自主程度,也會影響預測解讀。
解讀這類年份預測時,可以先確認「可能」代表什麼門檻:是系統能在部分環節協助人類,還是能自行規劃、執行並驗證一整輪改進?兩種定義對應的證據差距很大。預測也會隨算力、模型能力、工具可靠度與研究流程變化而更新,因此年份本身適合當作觀察假設,後續仍需用可公開檢查的任務紀錄來評估,而不是當成排定發生的時間表。
「自我改進 AI」可能指工具協助人類改良演算法、代理在固定評估器下優化,或系統自主選題並把成果轉成後續能力。現有案例提供前兩者的觀察;要支持完整遞迴自我改進,還需長期且可獨立驗證的能力累積紀錄。
判讀 AI 評測時,先查三個環節
先核對目標由誰設定、結果如何獨立驗證,以及模型能否把前一輪經驗帶到新問題;再判斷基準分數是否對應自己的工作流程。
- 看目標來源:題目是使用者指定、評測者預先設定,還是模型能自行挑選?若目標已固定,分數不能代表自主選題能力。
- 看驗證方式:實驗由誰執行、成功由誰判定?檢查是否使用獨立評估、可重現資料,以及明確的失敗條件。
- 看跨題累積:模型能否把失敗經驗用到新的研究問題?要求跨任務或長期測試紀錄,不只看同一題反覆迭代的結果。
還要核對資料、計算資源和評分規則是否接近部署環境,基準是否足以重現。題目保密時,可檢視方法、結果區間和後續驗證。採用決策仍須回到實際流程、成本和責任分工。
比較基準最好也包含目前的人工作法或既有工具,並使用模型未參與調整的保留題目。記錄每次成功與失敗、所需資源、人工覆核時間和錯誤代價,才能看出模型是否真的改善整體流程。若只統計完成幾次實驗,可能漏掉重跑、修正和審查花費;若只看最後分數,也無法知道提升是否來自更好的研究策略,或只是增加嘗試次數。這些資料能讓基準分數對應到導入者關心的實際決策。
- TasteVal 測量固定 AI 研發問題下的實驗計算效率,不是完整研究能力。
- 2.30 倍須連同信賴區間、專家基準及最終表現解讀。
- 自我改進還需自主選題、獨立驗證與跨題累積的證據。
常見問題
Q1:TasteVal 測試哪些 AI 能力?
模型在固定 AI 研發問題下提出實驗、解讀結果並迭代,程式代理負責執行;評測不直接測量自主選題。
Q2:Opus 5.5 的 2.30 倍代表它比人類研究者強嗎?
這是實驗計算效率倍率,以受邀專家各題最佳嘗試為基準,不代表所有研究能力或最終成果都高出 2.30 倍。
Q3:AI 能設計實驗是否代表已能自我改進?
不能。還需證明模型能選擇方向、驗證結果,並把成果轉成新能力;TasteVal 沒有測量整個循環。
參考來源
- Jaffe O, Sherburn D. (2026). TasteVal: Measuring the Experimental Research Taste of AI Systems Against Human Experts. *arXiv
- P-Zero Research. (2026). Introducing TasteVal
- Clark J. (2026). Import AI 476: Creativity and RSI; worse-than-China open weight models; AI goes to space
- Google DeepMind. (2025). AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms
- Guo H, et al. (2026). Atria Dawn: The Dawn of Agentic Superintelligence. *arXiv


