
目錄(5 節)
Scrapling 官方 QuotesSpider 範例擷取名言與作者,文件列示輸出 10 筆 JSON;browser-use 範例則讓代理自己查 GitHub 星數。兩者都讀網頁,工作方式卻不同。Scrapling 範例、browser-use 範例
這個 Scrapling 範例從名言練習網站首頁開始,逐一取出文字與作者,最後存成 quotes.json。官方列出的結果是十筆資料,示範的是單頁欄位擷取與匯出;若需求擴大為整站,還要加入下一頁連結的追蹤規則,不能用這十筆結果推算整站完成率。
抓整站欄位先比較框架;正文餵知識庫,比較轉換服務;讓 AI 判斷下一步,再考慮代理。要不要換掉 Scrapy,先看卡在下載、解析,還是任務流程。
十萬星工具分屬哪些層次?
星數反映關注度,各工具解決的問題不同。 先確定輸出是欄位、正文,還是完成網頁任務。
截至 2026 年 11 月 15 日,GitHub API 星數、主要語言與程式授權如下。
| 層次 | 專案 | 星數 | 語言/授權 |
|---|---|---|---|
| 爬蟲框架 | Scrapling | 102,949 | Python/BSD-3-Clause |
| 傳統框架對照 | Scrapy | 65,402 | Python/BSD-3-Clause |
| 網頁轉 AI 資料服務 | Firecrawl | 201,829 | TypeScript/AGPL-3.0 |
| 同類近門檻對照 | Crawl4AI | 87,361 | Python/Apache-2.0 |
| 瀏覽器自動化 | Playwright | 100,188 | TypeScript/Apache-2.0 |
| 同類近門檻對照 | Puppeteer | 95,840 | TypeScript/Apache-2.0 |
| AI 網頁代理 | browser-use | 121,039 | Python/MIT |
Scrapling 於 2024 年 10 月 13 日建立,約兩年破十萬星;Playwright 建立於 2019 年 11 月 15 日。星數無法推算可靠度。yt-dlp 與 MarkItDown 的星數也超過十萬,但前者專做影音下載、後者專做文件轉檔,不屬於網頁擷取工具,因此不列入比較。
換 Python 爬蟲也牽動排程、去重與驗收。先列失敗頁型,判斷要換框架還是元件,並確認網站權限與拒絕處理的邊界。
Scrapy 官方教學提供另一個可核對的案例:第一階段的 QuotesSpider 向同一個名言練習站的兩個頁面發送請求,示範日誌列出兩次成功回應,並產生兩個 HTML 檔案。此時尚未解析名言欄位,結果只是保存網頁。Scrapy 教學與執行日誌
把這個結果與 Scrapling 的十筆資料並看,就能發現比較單位的差異:下載兩頁、匯出十筆欄位,各自完成不同階段。團隊驗收時應分開記錄下載成功數、解析成功數與有效資料數,才能找出資料究竟在哪一步流失。
Scrapling 的四個亮點解決到哪裡?
Scrapling 整合四項能力;功能存在,仍不保證所有網站都成功。
MCP(模型上下文協定)讓代理呼叫工具;Agent Skill 提供操作知識與指引。兩種入口降低串接與寫程式門檻,資料品質仍須另外驗收。MCP 官方文件
官方表示 StealthyFetcher 可處理 Cloudflare Turnstile 與插頁驗證;企業級防護另推薦付費 Hyper Solutions,贊助商多有代理 IP、驗證碼服務。過盾是持續攻防,須實測成功率與成本;網站端也在升級辨識方式,例如 Cloudflare 以長期行為評估爬蟲信任。
Smart Element Tracking 依相似度重定位元素,大改版成功率沒有公開數據。若誤抓相鄰價格,程式仍可能正常結束,須驗證欄位語意。
Scrapling 官方說明,page.markdown() 不經大型語言模型即可產生 Markdown。來源
RAG 先檢索資料再生成答案。Markdown 仍須去重、切塊、保存來源與更新時間,才能追溯版本。
已有 Scrapy 時,可先測試 Scrapling 處理難抓頁的能力。單次解析速度不能代表整站速度,網路等待與重試也會影響結果。
為什麼程式沒有報錯,資料仍可能不能用?元素位置只描述網頁結構,未必表達業務含義。價格欄位可能同時出現原價、折扣價與不同規格的金額;驗收宜把商品識別碼、幣別及規格一起核對,並保存少量已知正確的樣本供改版後重跑。
知識庫也有類似問題。同一份文件的舊版與新版若同時被檢索,格式乾淨仍可能造成答案矛盾。可先定義來源網址、更新時間、版本與刪除規則,再測試常見問題能否找到正確段落;這些是資料管線的驗收條件,需要與擷取工具一起設計。
Firecrawl、Playwright 與 browser-use 怎麼選?
正文轉換比較 Firecrawl、Crawl4AI;固定操作比較 Playwright、Puppeteer;模型決定動作則評估 browser-use。
Firecrawl 的自架設定在 SELF_HOST.md 列明:預設由內建 Playwright 搭配一般抓取,需要時另接 Fire-engine。自架不等於取得雲端全部反爬能力。自架文件
實際的服務整合可看 Credal。Firecrawl 在 2026 年 1 月發布的客戶案例中,記錄這家企業代理平台把網頁擷取分成兩條路:對話當下找少量新資訊,以及抓取整個文件站、保存各頁快照並建立索引。Credal 整合案例
Credal 共同創辦人暨技術長 Jack Fischer 在該案例中表示,每月為使用者代理擷取超過六百萬個網址。團隊採用 Firecrawl 的 Markdown 轉換與遞迴抓取,並自行加入健康檢查、日誌及速率限制。這是 Firecrawl 發布、由客戶具名說明的處理量,並非獨立效能評測。
這個案例對選型的意義,在於工作如何分配:外部服務負責取得與整理網頁,Credal 保有快照、索引及產品內的監控流程。若團隊正在比較自架與雲端,也應列出這些責任的歸屬;每月網址量無法直接回答單次費用、失敗比例或自架所需人力。
Crawl4AI 提供 Apache-2.0 自架程式與雲端服務,截至同日每月有 1,000 免費額度,不宜直接等同成功頁數。比較時須計入主機、瀏覽器、代理 IP 與維運費。Crawl4AI 官方專案
browser-use 1.0 的設定則呈現另一種成本:預設使用 Browser Use Cloud 瀏覽器與模型閘道,需要 API key;可另設本機瀏覽器及模型。每一步經模型判斷,固定批次須衡量推論成本與延遲。
Playwright 是測試與瀏覽器自動化框架,執行預寫的點擊、等待與讀取流程;整站探索、去重與儲存須另設計。Puppeteer 是同層對照。
為什麼都接上 MCP,權限與成本仍不同?
代理入口相似,底層工作不同。 程式授權、雲端計費與網站權限須分別確認。
四個十萬星專案都有 MCP 或 Skill:Scrapling、Firecrawl、browser-use 提供代理入口;Playwright 另有 MCP 與 playwright-cli skills,其 MCP 儲存庫同日為 39,655 星。
Microsoft 的 Playwright MCP 文件指出,程式代理也可考慮 CLI 加 Skills,以減少工具結構與頁面資訊占用模型上下文的成本。官方說明
爬蟲工具正增加代理入口,接上協定仍須計算成本。可參照 MCP 如何連接資料與工具,判斷是否需要持續瀏覽器狀態。
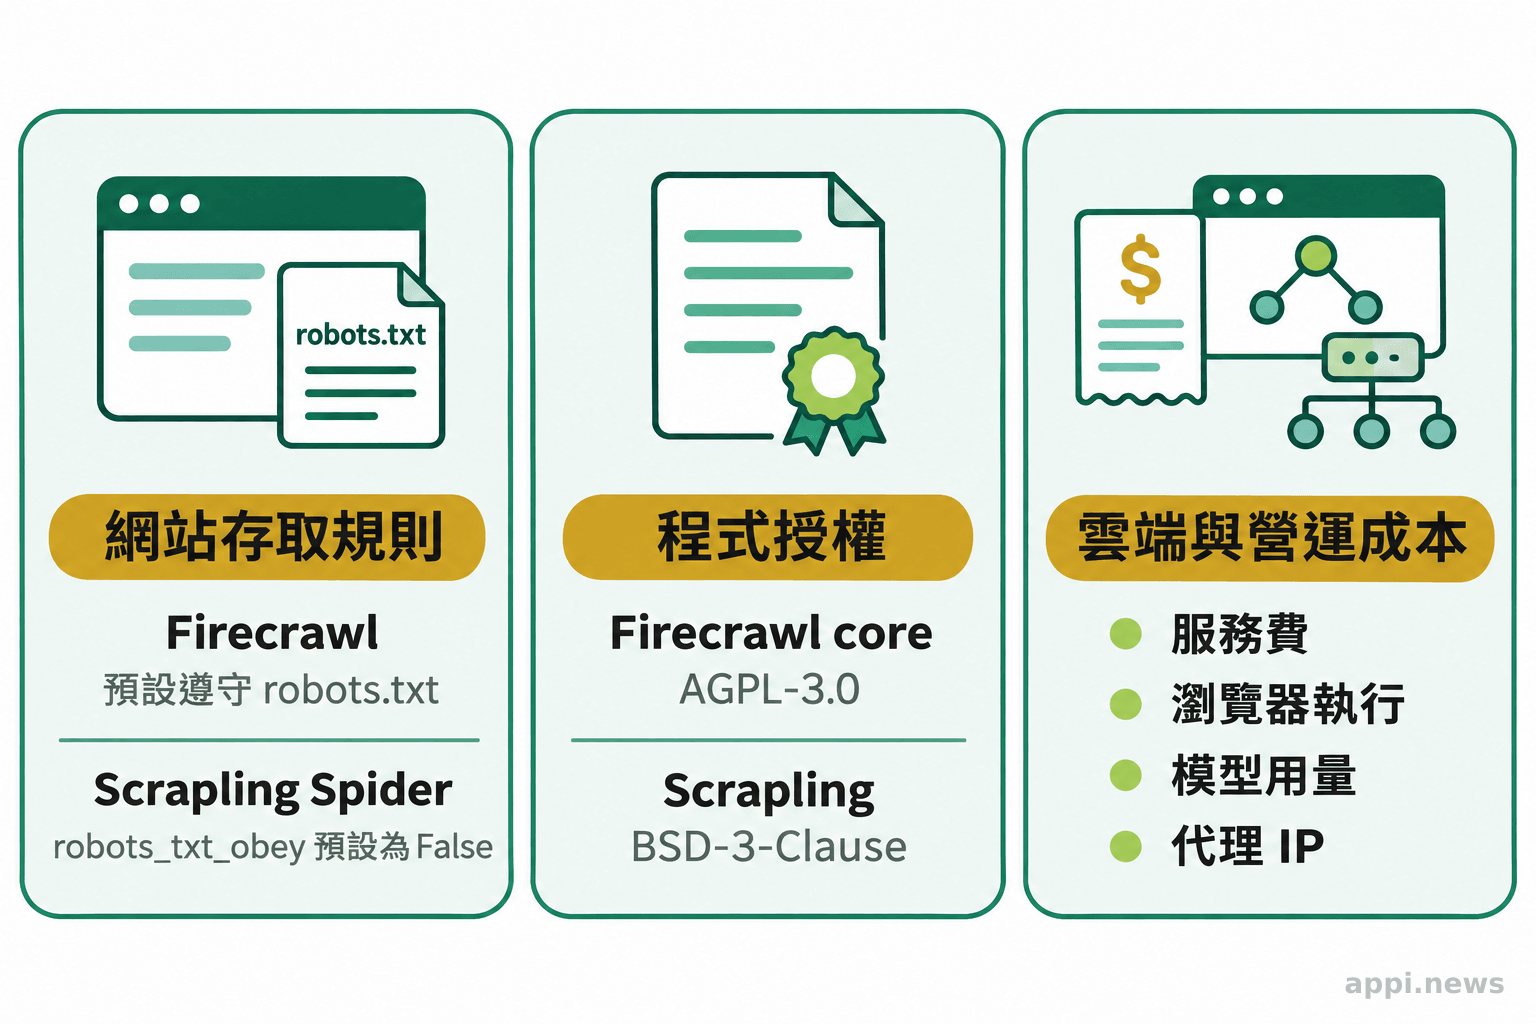
robots.txt(網站給爬蟲的存取規則)尤其不能沿用印象:Firecrawl README 表示預設遵守;Scrapling Spider 原始碼的 robots_txt_obey 預設為 False,需要自行啟用與驗證。網站如何用 robots.txt 表達 AI 用途偏好,可參考 robots.txt AI 訓練偏好的設定路徑與限制。Firecrawl 政策、Scrapling 原始碼
過驗證不等於有授權。網站條款、資料再利用與登入權限須另查。Firecrawl 主要程式採 AGPL-3.0,SDK 等部分元件採 MIT,整合時須逐一確認。
換掉 Scrapy 前,如何做小規模驗收?
以同批獲准擷取的頁面比較有效資料、失敗原因與總成本,確認改善後才擴大替換。
- 選頁型:涵蓋靜態、動態、分頁與改版頁,確認允許擷取的範圍。
- 定義有效結果:欄位須正確完整;正文保留來源,排除選單及重複內容。
- 同批比較:記錄耗時、重試、人工修復,以及瀏覽器、模型和代理 IP 費用。
- 檢查失敗後續:測試續跑、欄位異常告警與封鎖後停止條件。
- 局部替換:先換一種頁型,確認下游資料品質,再決定是否遷移。
先把同批網址與預期輸出存成驗收清單。除了常態頁面,也要留下缺欄位、重新導向與需要等待內容載入的樣本;比較期間固定欄位定義與測試環境,避免一邊只抓標題,另一邊卻處理完整正文,最後把工作量差異誤認為工具效能差異。
成本可用「同批總支出除以有效資料筆數」計算。分子列入服務費、主機、瀏覽器、模型、代理 IP 與人工修復,分母則只計欄位正確、未重複且符合用途的結果。人工時間若未折算費用,就另列工時,讓採購費與維護負擔都能被看見。
完成時間也要依用途定義。每日更新的資料源,應從排程啟動算到資料通過檢查並可供查詢,包含排隊與重試時間;臨時查詢則要觀察讀者等待多久才能取得可用答案。兩種任務可分別設定容許延遲及失敗後的補抓期限,避免用單頁下載秒數代表整個服務的體驗。
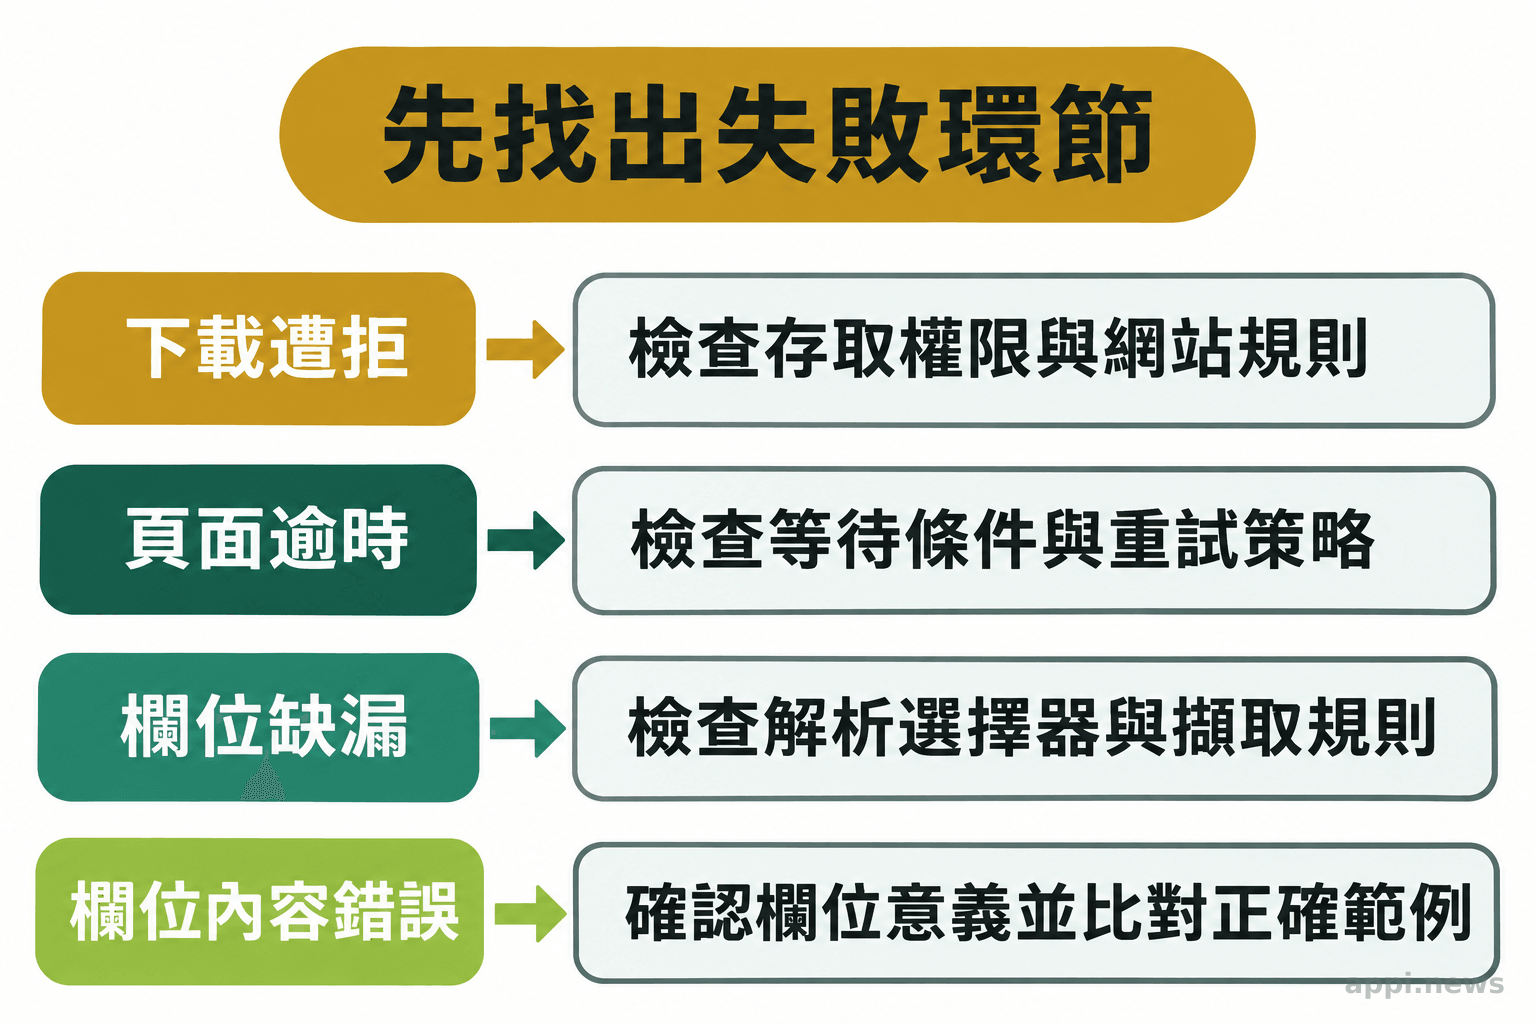
遇到失敗要保留原因:下載遭拒、頁面逾時、解析不到欄位、欄位內容錯誤,會導向不同處置。前兩項需要檢查存取條件與等待策略;後兩項應回到解析規則與資料定義。只看整體成功率,容易把需要人工修復的錯誤藏在平均值裡。
遷移時還要確認新舊資料能否接續。相同商品或文件應保留既有識別方式,避免換工具後被當成全新紀錄而重複寫入。先讓新流程輸出到隔離的測試儲存區,比對缺漏與差異,再切換正式管線;同時保留回復舊流程的操作方法與負責人。
- 框架、正文轉換、固定操作與模型代理,須依任務選擇。
- 驗收每筆有效資料的成本、來源追溯與維護時間。
常見問題
Q1:Scrapling 可以取代 Scrapy 嗎?
須驗證排程、資料管線與錯誤處理;部分頁型難抓時,可先局部整合。
Q2:Scrapling 過 Cloudflare 就不用付費嗎?
視目標站防護與流量條件,仍可能需要代理 IP 等服務,須實測估算。
Q3:有 Markdown 就能直接建好 RAG 嗎?
還須去重、切塊、保存來源及測試檢索品質。
Q4:Playwright MCP 和 browser-use 一樣嗎?
前者提供瀏覽器工具,後者提供代理流程。須比較決策方式、模型用量與驗收。
參考來源
- D4Vinci (2026). Scrapling: An adaptive Web Scraping framework. GitHub
- D4Vinci (2026). Scrapling MCP Server. Scrapling Documentation
- D4Vinci (2026). scrapling/spiders/spider.py. GitHub
- Firecrawl (2026). Firecrawl. GitHub
- Firecrawl (2026). firecrawl/SELF_HOST.md. GitHub
- Browser Use (2026). browser-use. GitHub
- Microsoft (2026). Playwright. GitHub
- Microsoft (2026). Playwright MCP server. GitHub
- unclecode (2026). Crawl4AI. GitHub
- Scrapy (2026). Scrapy. GitHub
- Puppeteer (2026). Puppeteer. GitHub
- Scrapy (2026). Scrapy Tutorial. Scrapy Documentation
- Ciarla E. (2026). How Credal Extracts 6M+ URLs Monthly to Power Production AI Agents. Firecrawl


