
很多人在談 AI 代理整合時,第一個會先想到它能不能打開網頁;但這裡要先問一個更前面的問題:網站是否允許這個代理,以這種身分替使用者執行這項操作?連線成功只代表技術上取得回應,不能直接推定網站允許後續讀取、提交或交易。要讓自動化流程可靠,必須一併確認網站政策、代理代表誰、可使用哪些資料,以及遇到拒絕時怎麼停下來。
2026 年 9 月,Amazon 封鎖 Meta 的 Muse 購物代理後,使用者嘗試在 Amazon 購物時收到「未經授權的 AI 代理」違反使用條件的訊息。GeekWire 的報導指出,Amazon 主張 Meta 未先取得同意,且代理沒有表明身分;Meta 對憑證處理方式則有不同說法。這是特定平台間的爭議,不能直接推論其他零售網站也採取相同政策。
同年 10 月,TechCrunch 也報導另一種情況:Muse 使用者在 Walmart 網站遇到真人驗證而無法完成購買,但 Walmart 表示這並非刻意封鎖,且雙方已有合作。兩個案例呈現的原因不同,一個是網站明確拒絕未授權代理,另一個可能是既有反機器人驗證未能順利處理代理請求。整合團隊因此要先判斷拒絕訊號來自政策還是防護流程,再決定詢問網站、改走已核准介面,或停止操作;個別事件本身不能證明所有網站都在封鎖代理。
Cloudflare 將 AI 網站流量分為搜尋、即時替人完成工作的代理,以及訓練用途。這只反映該服務的分類與控制方式,不能推斷所有網站都採用相同政策。整合時,先辨認存取用途,再確認目標網站的允許條件。
一、AI代理被網站擋下,先確認是哪一種限制?
先確認回應是網站明確拒絕、反機器人系統攔截,還是服務暫時故障,再依原因決定是否停止或改走正式管道。單次連線失敗不足以證明網站全面禁止 AI 代理。
拒絕訊息、驗證畫面或錯誤頁可能代表不同狀況。明確指出未授權代理、違反條款或要求停止自動存取,是應尊重的政策訊號。只有 CAPTCHA(驗證使用者是否為真人的測試)、HTTP 403 或逾時,則不足以確認網站理由;攔截也可能與流量模式、帳戶狀態或防護設定有關。
“Agent: Automated activity acting in real time on a person’s behalf to get something done.” — Cloudflare 文件對代理行為的分類
這有助釐清即時代理和搜尋索引、內容訓練爬蟲的差異。代理替使用者查詢或操作服務,可能接觸帳戶、庫存或交易;爬蟲通常批次讀取內容。網站可按用途設定不同控制,整合時也應分開識別和授權。
Cloudflare 文件也說明,網站管理者可按爬蟲允許或封鎖。這是該服務的產品能力,不代表每個網站都已啟用;單一錯誤頁也無法說明封鎖範圍。記錄時間、目標頁、代理識別、回應狀態與帳戶條件,才能向網站確認原因。
如果只是服務故障,應依系統的重試政策稍後重試;若是明確拒絕或帳戶安全警示,就應立即停止自動請求。兩者若混在一起,系統可能把政策拒絕當成短暫故障反覆重試,增加對網站的負載,也讓操作責任更難追查。
二、網站為什麼限制代理存取?
可能原因包括服務條款與資料授權、帳戶和交易安全、商業安排,以及反機器人系統無法辨認代理用途。沒有網站方說明時,不能把技術攔截解讀成網站全面反對 AI。
公開可讀的網頁,不代表資料可任意大量擷取、重製或商用;服務條款、授權協議和合作條件可能限制不同用途。搜尋索引、訓練資料收集與代理替人完成任務,對流量和資料使用的影響不同。Cloudflare 的分類只是該供應商的產品設計,不代表所有服務商都採取相同做法。
金融、訂票和購物流程涉及帳戶安全與交易風險。代理查詢、下單、修改資料或使用付款資訊時,網站可能需要確認操作者、使用者授權及責任歸屬。自動請求也可能與搶購、垃圾註冊或帳戶濫用相似,因而觸發防護;可能誤攔截,不代表網站不能限制存取。
網站收到的請求未必能回答「代理代表誰」。代理可能以服務商帳號或使用者工作階段操作;若網站無法辨識營運者、使用者和授權範圍,就難以判斷誰能讀取資料、批准交易或承擔責任。加上「AI」標籤不能解決身分問題。
查核時應分開記錄網站政策、防護攔截和服務可用性。個別回報不能代表全網趨勢,供應商文件也不能證明特定網站採用了該設定。條款效力與法律責任須依服務條款、合作文件及司法管轄區判斷,必要時請法務確認。
三、整合前要先定義代理代表誰、可以做什麼
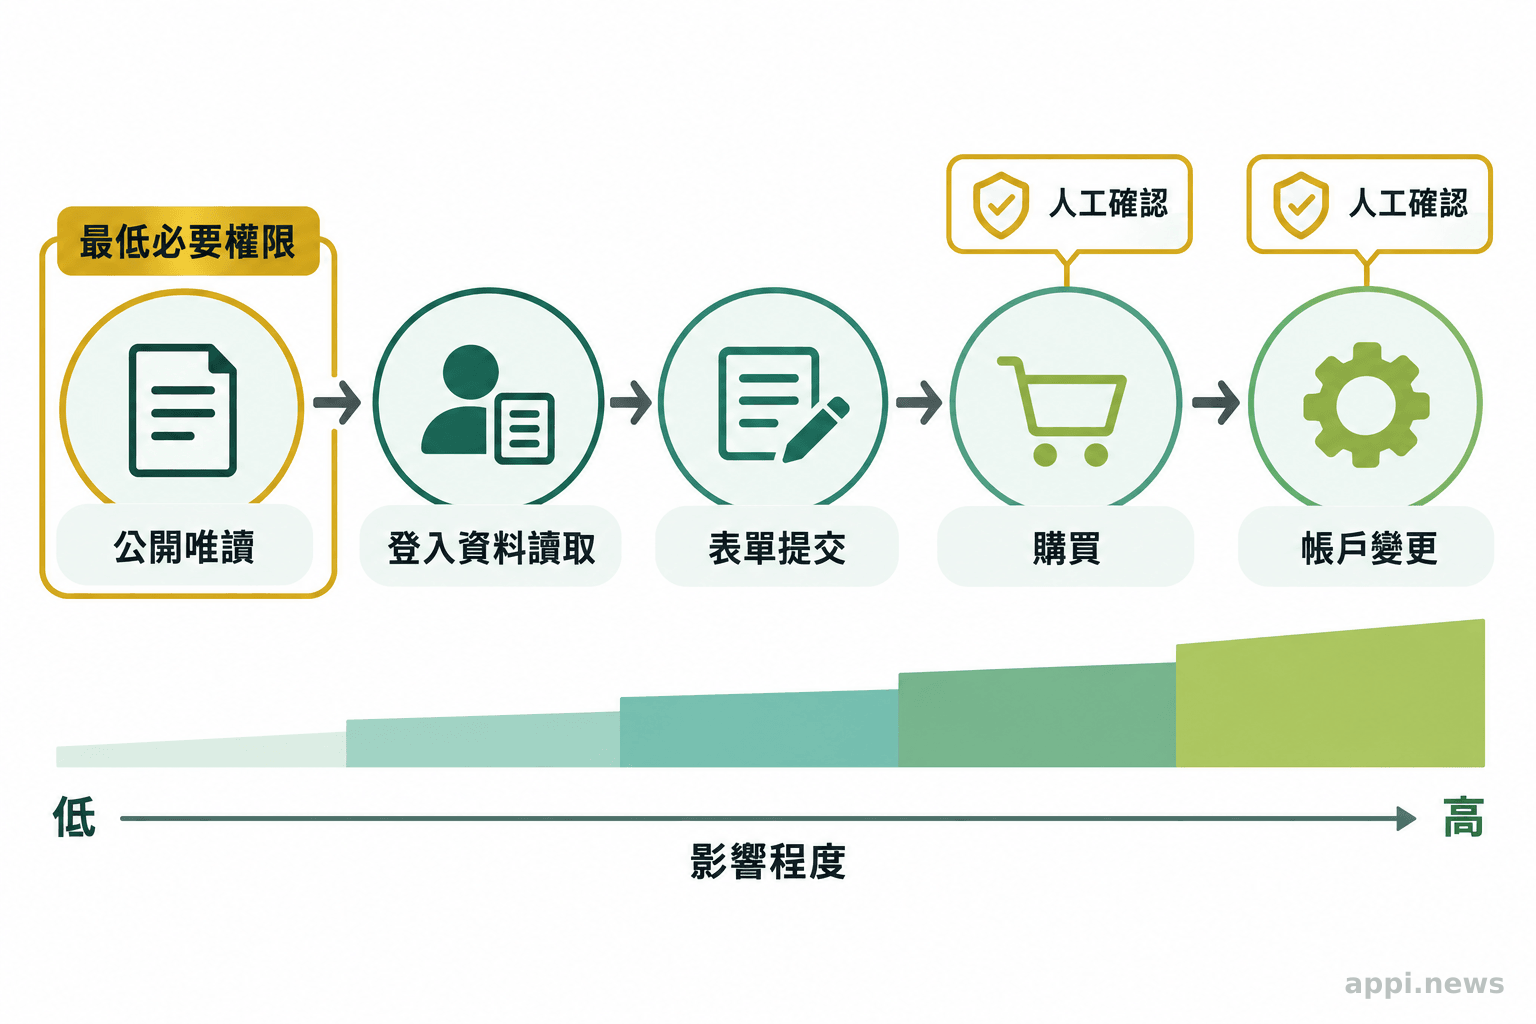
要明確記錄代理營運者、實際使用者、授權來源、可讀寫資料與允許操作,並保留可追溯的操作紀錄。每一項權限都應限於完成指定任務所需的最低範圍。
先建立身分鏈:代理由誰提供、誰發起任務、使用什麼憑證,以及網站能否辨識用途。若沿用使用者登入狀態,應限制期間和任務;若服務商代送請求,需釐清憑證及操作資料是否會被保存。授權應列明資料、目的、操作種類和撤回方式,不能視為無限許可。
將權限拆成實際動作,而非只設「可瀏覽網站」開關。公開查詢、登入後讀取、提交表單、付款或修改帳戶資料,影響各不相同。讀取可能暴露敏感資料,提交會形成紀錄,交易可能難以撤回。高影響操作應由使用者逐筆確認,並看清目標和後果。
“These rules are not a form of access authorization.” — IETF RFC 9309
這句話指的是 robots.txt(網站提供給爬蟲的存取偏好規則):它可表達網站希望自動爬取者如何處理頁面,卻不是登入、授權或存取控制的替代品。RFC 9309 也提醒,robots.txt 不是有效的內容安全措施。代理應遵守網站公布的爬取偏好,但不能把檔案未禁止某條路徑,解讀為網站已允許代理進行其他操作。網站服務條款、技術封鎖、帳戶授權和正式 API 權限各自處理不同問題,不能互相取代。
操作紀錄應能回答誰提出任務、哪個代理執行、讀取或修改了什麼、何時發生、使用哪項授權及是否經人工核准。紀錄也可能含敏感資料,需設定保存期限、存取權限與刪除方式。網站拒絕自動存取時,不得模擬真人、隱藏身分或改用其他帳號繞過限制。
四、網站不允許或拒絕時,有哪些整合路徑?
依網站提供的條件,可評估正式 API 或合作介面、經網站允許的代理存取、人工接手,或停止該項整合。選擇取決於用途、授權、維護成本和操作風險,沒有一種路徑適用所有網站。
正式 API(應用程式介面)或合作介面可明列資料欄位、驗證方式、速率和使用條件。接入前確認授權是否涵蓋用途、資料能否保存或轉交,以及版本變動和服務終止的處置。正式介面仍不代表所有資料和操作都獲准。
若網站明確允許代理存取,就依其條件完成識別和授權,確認可操作頁面、使用者是否須在場,以及付款或個資的處置。保留停用開關和替代流程,以因應政策變動。
介面不存在或條件不明時,可讓代理整理公開資訊或準備草稿,由使用者完成登入和提交。若網站拒絕自動存取,或無法確認授權與責任,便可停止整合。人工接手增加時間成本,但使用者保有最終操作權。
| 路徑 | 適用前提 | 維運與剩餘限制 |
|---|---|---|
| 正式 API 或合作介面 | 網站提供,且條款涵蓋預定用途 | 需處理授權、速率、版本與資料保存條件 |
| 網站允許的代理存取 | 網站明確接受該代理及操作方式 | 政策或驗證流程可能改變,仍需設停用與核准機制 |
| 人工接手 | 可由代理準備資訊,使用者完成高影響操作 | 自動化程度較低,但由使用者掌握提交與交易 |
| 停止整合 | 網站拒絕,或權限與責任條件無法確認 | 放棄該項自動化,避免繼續送出遭拒請求 |
五、把網站政策納入上線前的權限與維運檢查
逐一盤點網站、任務、代理身分、資料、操作權限和拒絕處置,並確認授權來源及人工核准點。明確拒絕或安全警示出現時停止重試,記錄事件並交由負責人確認。
部署前依序完成以下檢查:
- 盤點目的地與用途:列出代理要連接的網站、頁面、工作任務,以及資料是公開資訊還是登入後內容。
- 確認網站條件:檢查服務條款、robots.txt、官方 API 或合作說明;有疑義時向網站服務提供者確認,並保存查核日期與答覆。
- 界定身分與權限:記下代理營運者、使用者授權方式、可讀寫資料及操作範圍;逐筆確認交易或帳戶變更等高影響動作。
- 訂出拒絕處理:區分暫時故障與政策拒絕。對明確拒絕、帳戶警示或要求停止的回應,停止重試,不輪換帳號、不偽裝身分,也不改用連線方式規避限制。
- 安排人工升級與替代流程:記錄錯誤回應、時間、請求目標及代理識別,通知系統負責人;確認能改用網站核准的 API、人工接手或停止該任務。
- 設定重新檢視條件:網站條款、API 版本、代理供應商或資料使用方式變更時重新確認授權和操作範圍,並測試停用與人工接手是否有效。
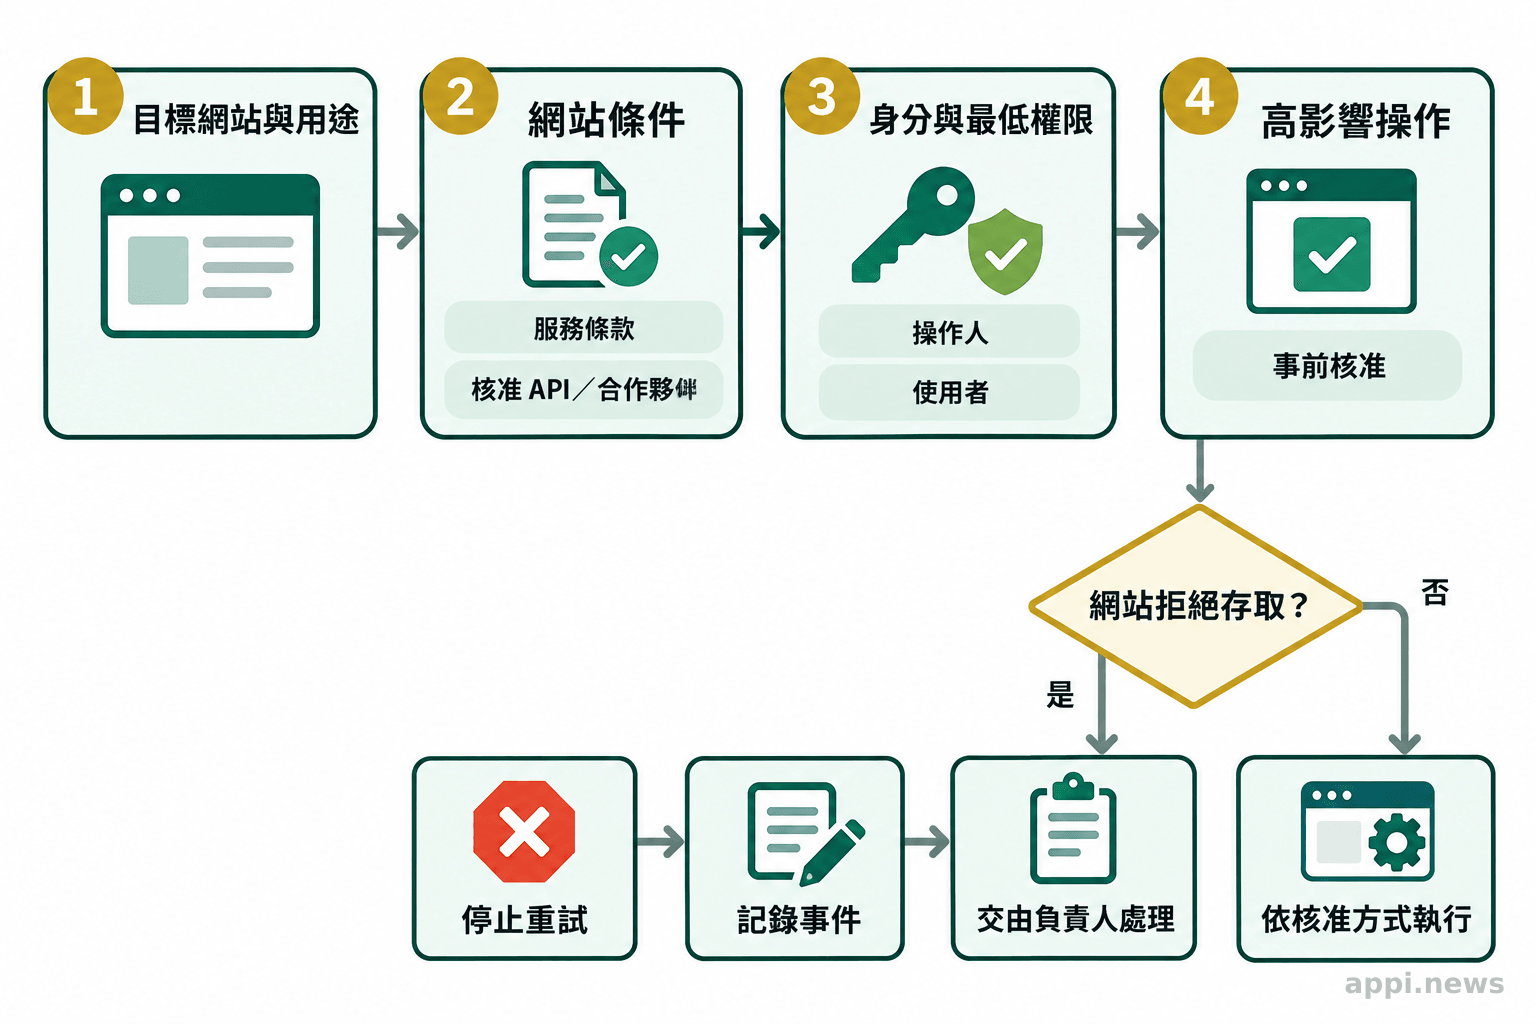
拒絕處置必須是流程設計的一部分,而非事後補救。若系統只把失敗請求排入重試佇列,就可能讓一次封鎖變成持續存取;若錯誤只留在模型對話中,營運人員也無法判斷是網站政策、帳戶權限還是服務中斷。應設定明確終止狀態,並讓負責人可以查看拒絕原因與後續處理紀錄。
網站政策會變動。當驗證方式、API 權限或資料授權改變時,重新核對整合設計,並將條件變更納入維運紀錄。若涉及跨境資料、個資或商業合作,請資料保護與法務負責人確認適用要求。
- 先分辨政策拒絕、反機器人攔截與服務故障,單次失敗不能證明網站全面封鎖代理。
- robots.txt 表達爬取偏好,不能當成網站授權、帳戶驗證或存取控制。
- 以最小權限定義代理身分、使用者授權、資料範圍和操作種類,高影響操作保留人工確認。
- 網站明確拒絕時停止重試,不以換帳號、偽裝身分或改變連線方式規避限制。
- 正式 API 仍須遵守其授權、速率限制與資料使用條件;條件不明時先詢問或改由人工接手。
常見問題
Q1:網站擋住代理,代表所有自動化都不被允許嗎?
不一定。攔截可能來自明確政策、防護系統誤判、帳戶限制或服務故障。應先查看網站回應與公開政策,必要時向服務提供者確認;在原因未明前,不要把一次失敗推廣成對所有自動化的結論。
Q2:robots.txt 可以當成代理存取授權嗎?
不可以。RFC 9309 說明,robots.txt 的規則不是存取授權,也不能取代有效的安全控制。它提供爬蟲應遵循的存取偏好訊號;代理仍需另外確認服務條款、帳戶授權、資料用途和操作權限。
Q3:代理被拒絕後,可以換帳號或更換連線方式再試嗎?
若目的是避開網站拒絕或反機器人限制,就不應這麼做。停止自動請求,記錄回應並確認原因;只有網站明確允許的介面或處理方式,才可作為後續整合路徑。
Q4:使用正式 API 就不必再確認條款、資料權限或操作範圍嗎?
仍然需要確認。API 金鑰或端點只提供技術存取能力,實際可用資料、用途、速率和操作權限取決於該服務的授權與條件。也要確認資料保存方式、版本變更和撤銷授權時的處置。
參考來源
- Koster M, Illyes G, Zeller H, Sassman L. (2022). *RFC 9309: Robots Exclusion Protocol*. Internet Engineering Task Force
- Cloudflare. (2026). *Bots*. Cloudflare Developers Documentation
- Cloudflare. (2026). *Manage AI crawlers*. Cloudflare Developers Documentation
- Todd Bishop. (2026). *Amazon blocks Meta’s Muse AI assistant in new standoff over agentic shopping*. GeekWire
- Sarah Perez. (2026). *The next hurdle for AI agents: getting websites to let them in*. TechCrunch


