
2026 年 10 月 30 日,Anthropic 工程師 Kevin Kelley 向網際網路工程任務組(IETF)提交網路草案(Internet-Draft),示範網站可在根目錄的爬蟲規則檔 robots.txt 加入 User-Agent: __usage_ai-training,再用 Disallow 和 Allow 標示 AI 訓練偏好。Anthropic 同日表示已開始實作;Google、OpenAI、Microsoft 也公布支持或導入計畫。這行設定會擋住爬蟲嗎?能當成內容授權嗎?
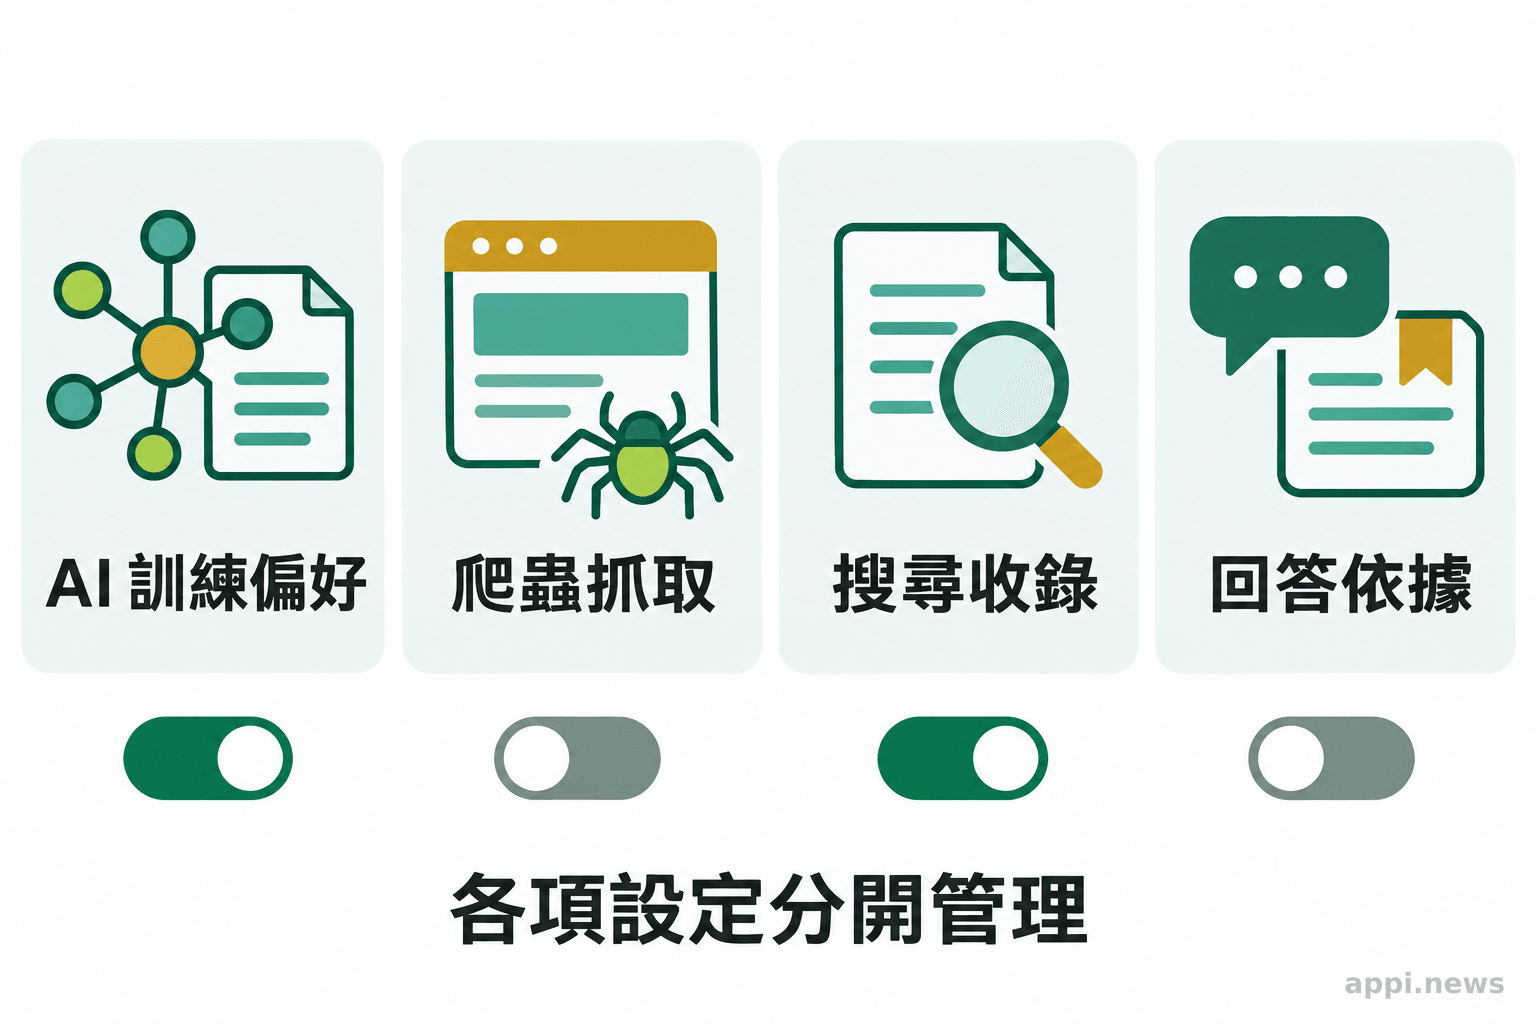
__usage_ai-training是供業者辨識的用途偏好標記,不是新的爬蟲名稱或存取權限。Disallow表達不希望內容用於 AI 訓練,Allow表達偏好允許該用途;業者必須實作並遵循,設定才會影響處理方式。- 訓練、抓取、搜尋收錄、生成式回答引用與授權是不同問題,應分開管理。
一、共通訊號先解決逐家維護規則的管理成本
它讓網站用一組機器可讀的標記,向採納它的業者表達 AI 訓練偏好,減少逐一列出各家業者名稱的維護工作。
過去,網站管理者若想拒絕特定爬蟲抓取,通常會在 robots.txt 逐個列出其 User-Agent 群組。這種方式是以爬蟲身分管理抓取行為。新提案改以用途為中心:__usage_ai-training 是描述內容用途的「政策標記」(policy token),不是 Anthropic、Google 或 OpenAI 的爬蟲名稱。理解這個差異,才不會把它當成封鎖所有 AI 爬蟲的快捷指令。
如果管理者也在處理爬蟲流量,可先看如何管理 AI 爬蟲流量與信任評等;流量治理和訓練偏好相連,但解決的是不同問題。
提案由 Kelley 以 Anthropic 工程師身分提交,文件目前是 IETF 個人 Internet-Draft,名稱為「Machine-Readable Training Preference Signal」。IETF Datatracker 說明,這份文件尚未獲 IETF 背書,在標準流程中沒有正式地位。草案沿用 robots.txt 既有群組和路徑語法,沒有新增指令。
業者公告也代表不同成熟度。Kelley 在 IETF 工作組郵件中說,Anthropic 已開始實作,但仍需逐步加到旗下服務並處理邊界情況。Google 表示計畫在 2027 年支援,且當網站拒絕訓練、又未明確指定 Google-Extended 時,預計將該偏好視同拒絕 Google-Extended。OpenAI 說會在未來幾個月實作,並重申原有爬蟲控制仍然有效。Microsoft 則公布自 2027 年 2 月起,隨重新抓取頁面開始採用訓練偏好。這些是公告或計畫,各家時程和執行範圍仍應以最新官方文件為準。
幾個業者案例呈現出不同的過渡方式。Google 已有 Google-Extended,能控制部分 Gemini 訓練與 grounding 用途;新的共通訊號是它計畫接入的另一個控制入口,並依網站有沒有明確設定 Google-Extended 來判讀。OpenAI 宣布將尊重共通標記,但仍要在「未來幾個月」完成實作,因此公告日不等於網站現在已能依此控制 GPTBot。Microsoft 的文件把訓練和 grounding 分別處理,並說明新偏好要等 Bing 重新抓取頁面才會被讀到,設定生效時間可能因此落後網站發布日。對網站團隊來說,這些差異意味著不能只在行事曆記下一個「支援日期」,也要確認服務範圍、讀取時點和舊設定的相容方式。
「這是關於內容用途的偏好,不是流量管理訊號。」(Kevin Kelley,IETF AI Preferences 工作組郵件,2026 年 10 月 30 日)
各家原有的專屬控制也說明共通標記要補哪一塊。Google 自 2023 年提供 Google-Extended,管理 Gemini 訓練和部分生成回答依據(grounding);OpenAI 讓網站透過 GPTBot 規則管理可被抓取作訓練的公開內容;Anthropic 與 Microsoft 也提供各自控制。這些設定仍各有作用,共通標記補上跨業者的用途偏好表達。
二、__usage_ai-training 如何設定全站或特定路徑?
在 User-Agent 行明確寫出 __usage_ai-training,再為目標路徑設定 Disallow 或 Allow;既有的 User-Agent: * 群組不會代替這個標記。
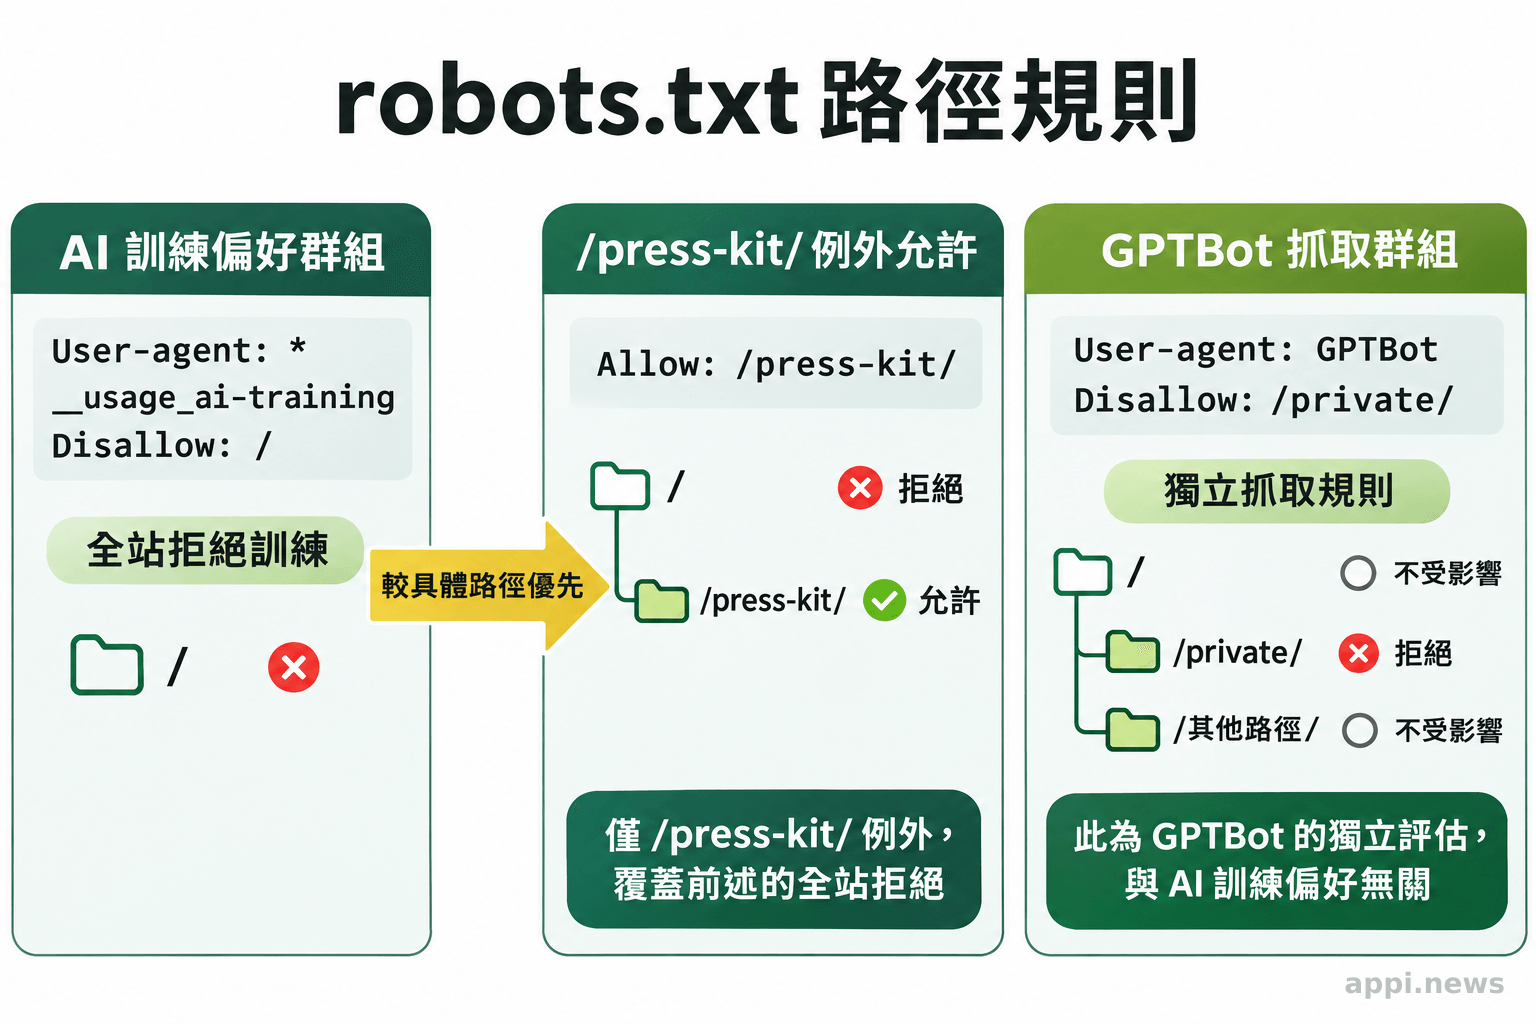
全站拒絕訓練、但允許新聞資料夾作為模型訓練素材,可依草案範例寫成:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
這表示全站路徑不希望用於 AI 訓練,/press-kit/ 則表達允許。草案採用 RFC 9309 的路徑比對原則,具體路徑比一般路徑更精確時優先採用,例如 /press-kit/ 比 / 更長、更具體。標記沒有另列任何規則時,草案解讀為「沒有表達偏好」,不能把未設定視作拒絕。
網站常見的 User-Agent: * 是套用到一般爬蟲群組的萬用標記;此草案明訂它不會被視為匹配 __usage_ai-training。因此,只在星號群組下寫 Disallow: /,不會讓參與業者讀成「拒絕 AI 訓練」。若要表達這個用途偏好,必須新增具名群組。更新前也要檢查檔案裡是否有重複群組、路徑規則衝突,並依 RFC 9309 的具體路徑優先原則核對結果。
一個網站還可能在 robots.txt 同時放置爬蟲專用群組,例如:
User-Agent: GPTBot
Disallow: /private/

User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
兩組回答的是不同問題:第一組表達 GPTBot 可否抓取特定頁面;第二組表達網站對特定路徑的 AI 訓練用途偏好。依草案設計,業者仍依自己的爬蟲名稱讀取抓取規則,不能只靠政策標記來管控流量或保護未公開內容。
三、用途偏好和爬蟲存取、搜尋用途要分開管理
不會自動如此。共通訊號處理的是 AI 訓練用途偏好;特定爬蟲是否能抓取、頁面是否能被搜尋索引或用於生成式回答,仍要看各自的規則和業者實作。
草案第 4.3 節稱內容用途偏好與流量管理訊號彼此獨立。若網站希望禁止某個爬蟲請求頁面,還需使用該爬蟲產品名稱的 robots.txt 群組;若只拒絕訓練,參與業者可以依偏好不把內容用於訓練,但抓取規則本身不會因此改變。另一方面,網站也可能允許某爬蟲抓取,卻不希望資料進入模型訓練。把兩種規則拆開,才能明確管理。
「robots.txt 的規則不是存取授權。」(IETF RFC 9309《Robots Exclusion Protocol》)
搜尋收錄和生成式回答引用又是另一層。Google 說明 Google-Extended 不影響 Google Search 收錄或排序;OpenAI 以 GPTBot 管理訓練、以 OAI-SearchBot 管理 ChatGPT 搜尋;Microsoft 也分開處理訓練和生成回答依據。各家控制範圍不同,應依實際使用的服務逐一確認。
| 控制面向 | 要回答的問題 | 例子 |
|---|---|---|
| 訓練偏好 | 可否用於模型訓練 | __usage_ai-training |
| 爬蟲請求 | 特定爬蟲可否抓取 | GPTBot 群組 |
| 搜尋或回答 | 可否進入搜尋或生成回答 | OAI-SearchBot 群組 |
robots.txt 也不是防止他人讀取頁面的安全措施。RFC 9309 明確指出,該協定要求遵循者依規則處理請求,但不構成存取授權。若頁面不能公開,應以登入驗證、存取控制或其他安全措施限制讀取,而不是把路徑寫進公開的 robots.txt。公開路徑可能反而讓人知道該位置存在。
四、這個訊號不能取代授權文件或遵循確認
不能。這是機器可讀的偏好表達,是否改變處理方式取決於各業者是否實作並遵循;它本身不等於授權、合約、禁用保證或法律救濟。
現階段的關鍵限制在於標準與採用狀態。個人 Internet-Draft 可以被修改或取代,不等同已核准的 IETF RFC;其 AI Training 定義也連結到工作組仍在討論的詞彙草案。因此,網站不宜宣稱已有所有業者共同遵守的正式標準。
第二個限制是執行端。草案指出,消費者可以依偏好決定是否抓取不允許訓練的資源,但這不是爬取指令;若業者尚未部署、解析器沒有讀取該群組,或某個抓取者選擇不遵循,設定就不會自動造成阻擋。Google、OpenAI 和 Microsoft 所列進度各有時間差,也顯示網站需要核對特定服務是否已經支援,而不能只看一則共同聲明。
第三個限制涉及內容權利。草案把它定位成內容用途偏好,Google 與 Microsoft 的文件也分別提醒,此類偏好不等於授權或付款安排。設定 Disallow 可留下一份清楚的機器可讀表態,但不能僅憑這行文字推定過去已抓取資料已刪除、所有第三方都已停止使用,或權利爭議已經解決。網站若正考慮簽訂訓練資料合約,可參考AI 訓練資料授權條件的簽約核對重點,並把合約權利和爬蟲偏好分別記錄。涉及既有合約或侵權疑慮時,仍要檢視契約和適用法律,必要時取得專業法律意見。
五、網站管理者調整前先完成五項檢查
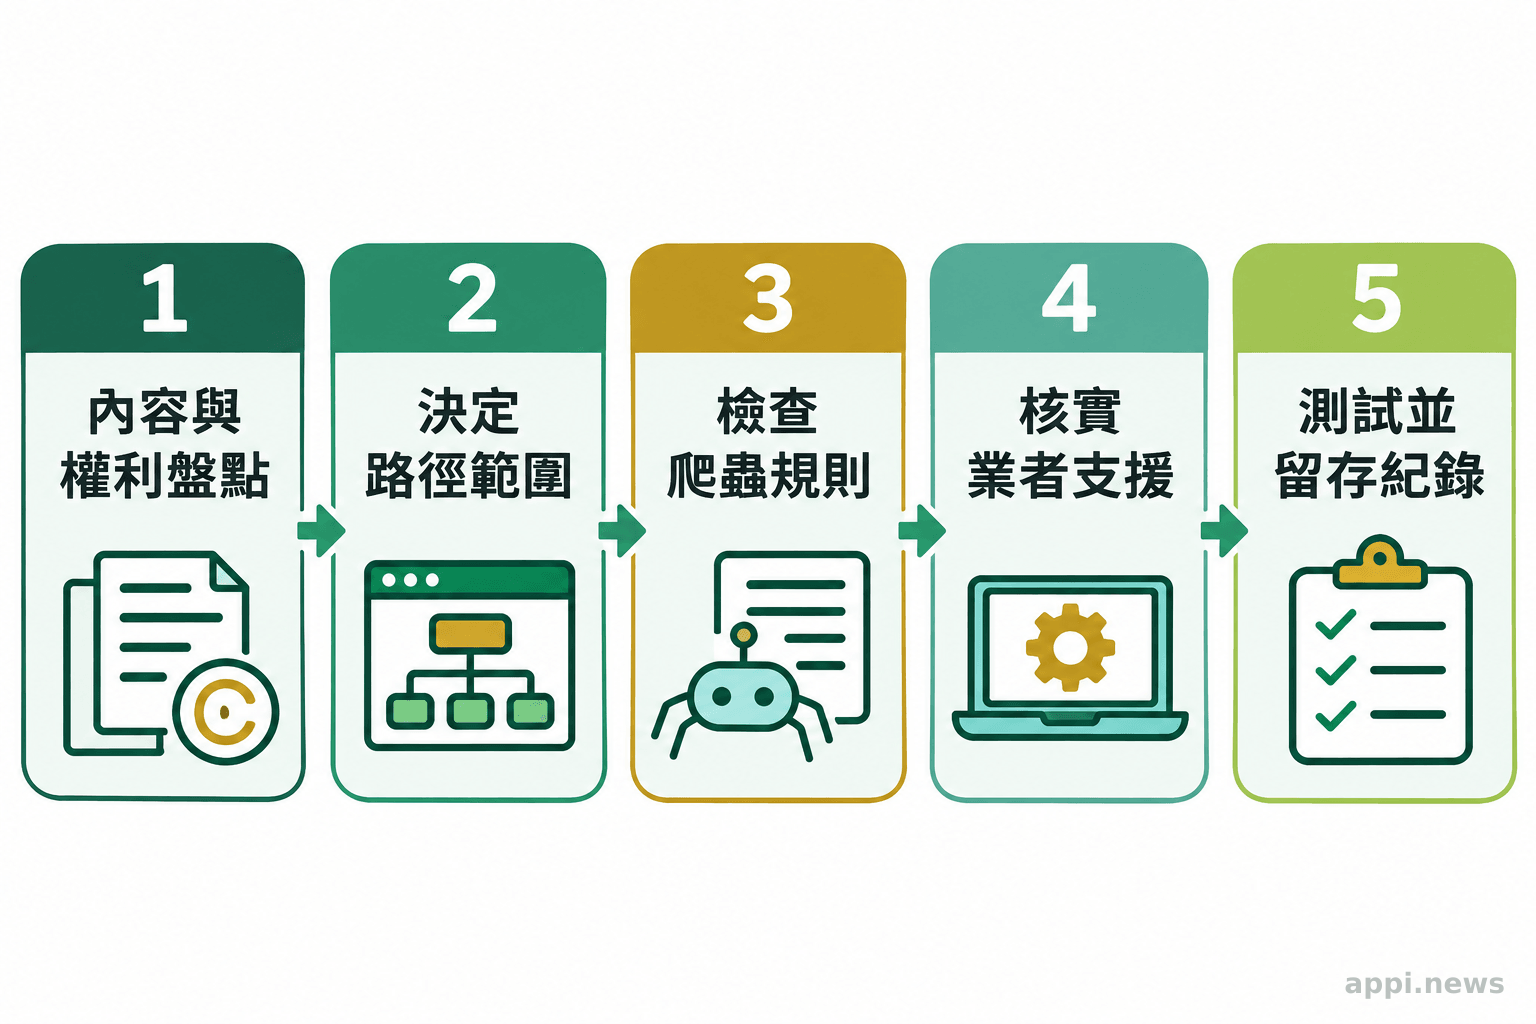
先盤點頁面和內容權利,再決定用途偏好、檢查現有爬蟲群組,最後核對業者支援狀態並保存變更紀錄。
- 盤點內容與權利。 列出公開頁面、付費內容、合作素材、使用者投稿和授權素材,確認網站是否有權替各類內容表達用途偏好。
- 決定範圍。 和內容、法務及技術管理者確認是全站拒絕,還是僅拒絕特定目錄;需要允許的資料夾應與拒絕路徑一併檢查。
- 對照現有規則。 逐一檢視
GPTBot、Google-Extended、ClaudeBot、Bingbot等群組,確認用途偏好不會意外取代原本的爬取或搜尋管理設定。名稱和用途需以各業者最新文件為準。 - 核實採用狀態。 查閱業者官方導入文件和變更公告,記下哪些服務已實作、哪些仍在規劃,以及是否另有 grounding 或頁面層級設定。
- 測試並留存。 先在測試環境檢查 robots.txt 的群組、路徑和優先順序,再記錄正式發布版本、時間、負責人與後續確認結果。業者需要重新抓取頁面才讀到設定時,也要把抓取延遲納入判斷。
這份清單的目的,是讓網站先決定「哪些內容希望怎麼用」,再挑對設定工具。若要保護機密、會員或尚未公開的資料,應先採用存取控制;若要明確管理搜尋曝光或生成式回答引用,也要確認業者提供的相應控制,不要把所有需求塞進同一個 token。
常見問題
Q1:網站沒有寫 __usage_ai-training,代表拒絕 AI 訓練嗎?
不代表。依草案,若沒有包含這個標記的群組,就是沒有透過此機制表達偏好;各業者如何處理仍看其政策與實作。
Q2:User-Agent: * 下的 Disallow: / 能阻止 AI 訓練嗎?
不能依這份草案推定可以。草案明訂星號群組不匹配 __usage_ai-training,要表達訓練偏好需明確寫出該 token。星號規則對一般爬蟲的作用,則依 RFC 9309 和爬蟲實作處理。
Q3:設定 Disallow: / 後,內容就不會被任何 AI 公司使用嗎?
不能保證。標記的效果限於採納且已實作的業者;草案不是正式標準,也不是存取授權或法律執行機制。對特定業者的現行規則與合約仍要分別確認。
Q4:拒絕訓練會讓網站離開 Google 搜尋或不再被 AI 回答引用嗎?
不一定。訓練、搜尋收錄與生成式回答 grounding 是不同用途。Google 表示 Google-Extended 不影響 Google 搜尋收錄;Microsoft 也分開說明訓練和 grounding。個別業者的控制方式可能不同,應查閱其官方文件。
Q5:現在要不要立刻改網站 robots.txt?
先盤點內容路徑、現有規則與業者導入狀態,再決定是否發布。若已設定,仍應確認各業者何時開始讀取、怎麼解讀例外路徑,並保存變更與抓取紀錄。
參考來源
- Kelley K. (2026). *Machine-Readable Training Preference Signal*, draft-kelley-aipref-training-preference-signal-00. IETF Datatracker
- Kelley K. (2026). [ai-control] New draft: draft-kelley-aipref-training-preference-signal-00. IETF Mailing List Archive
- Google Search Central (2026). Supporting a shared AI training control for websites. Google for Developers
- OpenAI (2026). Making it easier for websites to express AI training preferences
- Microsoft Bing (2026). Your content, your choice: clearer preferences for training and grounding
- Koster M, et al. (2022). Robots Exclusion Protocol. RFC 9309. RFC Editor
- Google Crawling Infrastructure (2026). Google-Extended. Google for Developers
- OpenAI (2026). Overview of OpenAI Crawlers. OpenAI Developer Documentation


