
在德州農工大學等校團隊的 Twitter/X 受控試點中,四個開放權重模型接觸特定貼文資料後,多項推理與長文本基準分數下降;這項結果適用於該研究的資料與模型條件。
研究團隊把不同比例的高互動短文與對照貼文混合,持續訓練四個模型。以 Llama 3 8B Instruct 為例,當高互動短文比例由 0% 提高到 100%,ARC 挑戰題思維鏈測試由 72.1% 降至 57.2%,RULER 長文本 CWE 項目由 83.7% 降至 52.3%。這是 Shuo Xing 等人發表於 COLM 2026 的試點研究,模型池、資料來源和基準都有限,不能據此推斷所有訓練資料或封閉商用模型也有相同變化。研究原文
但這裡要先問一個更前面的問題:研究如何界定「低品質」,測到的退化又代表什麼?研究者以 LLM Brain Rot(大型語言模型腦腐)稱呼這種現象,借用的是人類接觸瑣碎內容的比喻,並非模型有生物性腦部損傷。要把研究結果轉成資料治理做法,得先看它怎麼挑選貼文、安排對照組,再辨認測試分數能說明的範圍。
熱門短文進入訓練後,模型測試出現哪些變化?
研究以四個模型比較不同資料比例,發現推理、長文本理解與部分安全測試出現變化;在 Llama 3 8B Instruct 的比例實驗中,低品質資料占比提高時,ARC 挑戰題的思維鏈提示測試與 RULER 長文本擷取題分數呈下降趨勢。
研究採用持續預訓練(Continual Pre-training,即用新資料繼續更新既有模型),比較四個開放權重模型:Llama 3 8B Instruct、Qwen2.5 7B Instruct、Qwen2.5 0.5B Instruct 和 Qwen3 4B Thinking 2507。研究原文列出的正式名稱為 Qwen3 4B Thinking 2507。
ARC 以國小自然科題目測試問答;Chain-of-Thought(思維鏈)提示模型列出解題步驟。RULER 測試長文本資訊擷取與整合。分數只反映指定題目和評分方式,不能代表所有實際任務或模型內部機制。
研究也測試安全與倫理基準。高互動度資料組在部分安全測試的風險分數上升,但各模型和任務的幅度不一;人格問卷式量表只反映模型回答傾向,不代表模型具有人類人格。
「推理基準與長文本理解的變化,應放在研究所測試的資料比例、模型和題目中解讀。」— Xing 等人,COLM 2026 試點研究(意譯)
研究怎麼定義「低品質資料」?
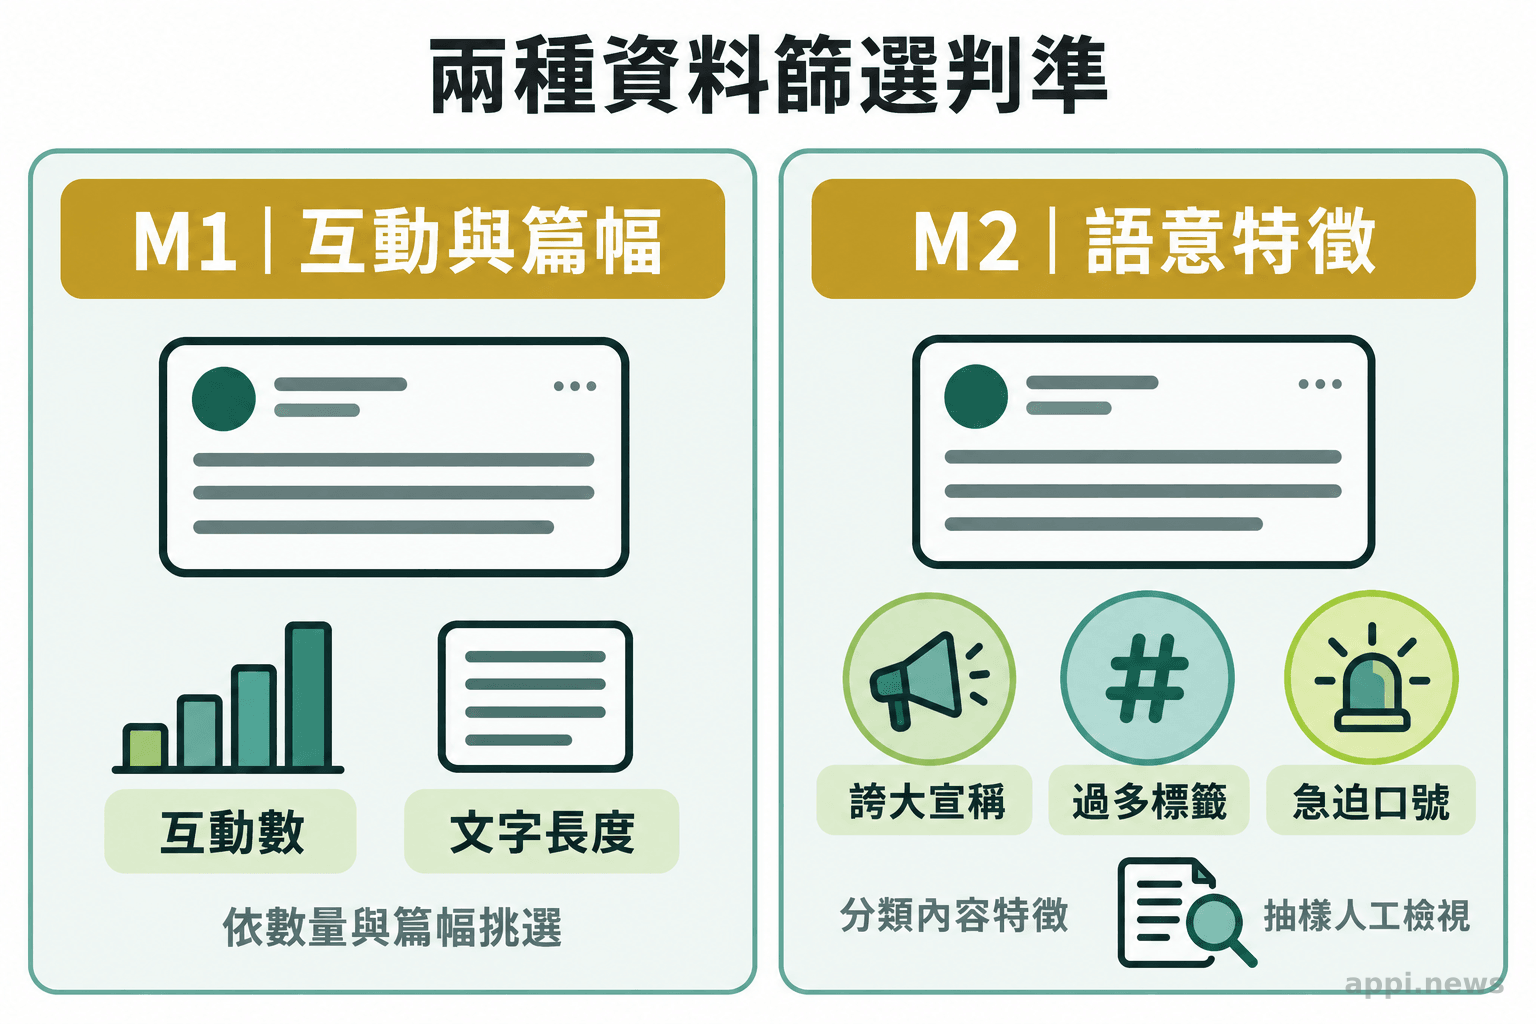
研究採用兩條彼此不同的操作路徑:M1 以貼文互動度和長度挑選高互動短文,M2 則由 GPT-4o mini 按語意與寫作特徵分類;因此「熱門」本身不是研究對所有內容品質的通用判決。
資料集包含約一百萬則公開 Twitter/X 貼文。M1 將互動總數超過 500 且少於 30 tokens 的貼文歸入低品質組,將互動數為零且長度超過 100 tokens 的貼文作為對照;兩組訓練 token 數經過平衡。Token 是模型切分文字的單位,可能是詞、詞的一部分或符號,不能直接換算成中文字數。
M1 不看貼文實際在談什麼,著重於社會互動訊號與短文本特徵。這種設計可觀察互動度是否提供語意品質之外的資訊,但熱門短文也可能精準、有用,不能單憑互動數判作垃圾資料;低互動同樣不代表高品質。
M2 是另一種判準。研究者使用 GPT-4o mini 依表面、瑣碎主題或吸引注意的寫法分類貼文,包括誇大宣稱、陰謀論、過量標籤、全大寫刺激字眼及緊迫式標語等;三名研究生也依同一準則抽樣標記,與模型分類有 76% 一致。這提供了分類品質檢查,但標準仍由研究者設定。
兩種定義不能混成「流量越高,內容越差」。研究結果反而顯示互動度、文字長短和語意品質捕捉到不同面向;M1 對部分測試的影響較大,並不等於互動數可單獨當成普遍適用的資料品質分數。
分數下降代表模型不再推理嗎?
不能。研究能觀察的是基準題正確率和回答步驟的變化;作者將常見錯誤歸納為 thought-skipping(跳過推理步驟),但輸出少寫步驟不等於已直接量到模型內部「不會推理」。
研究者檢視 ARC 錯誤,將沒有產生思考、沒有列計畫或略過步驟歸為 thought-skipping。這是從文字輸出辨認的失誤型態;思維鏈也不能當作模型內部推理歷程的透明紀錄。
基準分數是固定題目的測試結果,回答步驟是可見輸出;模型內部表徵或一般推理能力是否永久改變,則是更強的機制推論,現有測試無法直接觀察。分數變差時,團隊應先確認受影響任務及結果能否在其他基準重現,再決定是否回退模型或調整資料流程。
「腦腐」是研究者描述特定資料介入現象的比喻,不能與人類的認知障礙或注意力疾病等同。
補進較高品質資料後,能力能恢復多少?
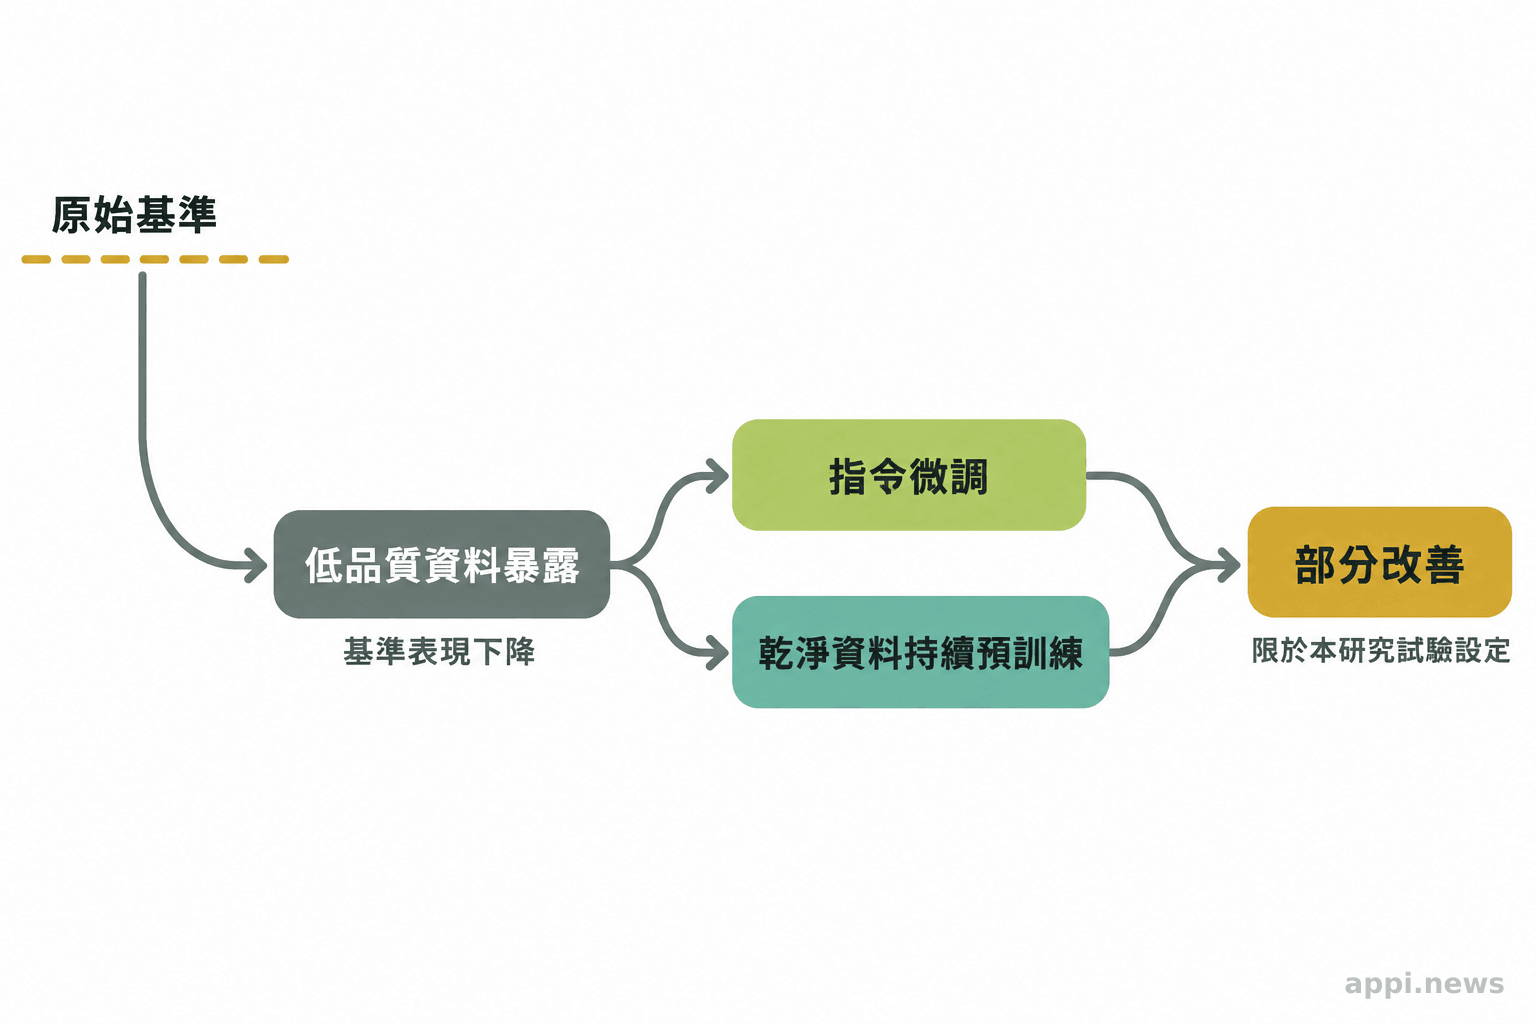
作者測試指令微調、乾淨資料持續預訓練與反思提示,部分測試表現有所改善,但最佳補訓結果仍低於基準;這不代表退化永久不可逆。
研究先測回答時的反思提示,部分跳步錯誤減少,但效果取決於反思品質。之後測試指令微調(Instruction Tuning,以示範問答教模型遵循指令)與乾淨資料持續預訓練;指令微調改善較明顯,兩者都未讓測試表現完全回到基準。
「未完全恢復」描述的是作者實際測試的補訓方式與結果;這項觀察能提醒團隊保留乾淨基準與修復前後的版本紀錄,方便核對能力是否回升。
「補訓能改善下降的表現,但在本研究測試的條件下,改善仍不完整。」— Xing 等人,COLM 2026 試點研究(意譯)
研究的基礎模型是開放權重模型,訓練條件較容易控制與檢查。封閉商用模型的訓練語料、篩選規則與資料比例多未公開,無法只依這項研究判斷 ChatGPT、Gemini 或其他服務是否接觸相同內容,或產生相同影響。
這項研究與合成資料退化、資料投毒有何不同?
三者研究的是不同問題。德州農工大學團隊測試的是特定社群貼文特徵在持續預訓練中的影響;合成資料研究關注模型輸出反覆進入下一代訓練集,資料投毒研究則研究攻擊者刻意植入有害行為。
Shumailov 等人的模型崩塌研究,讓模型反覆以生成內容作為訓練資料,並在變分自編碼器、高斯混合模型與大型語言模型等生成模型中觀察資料分布變化。實驗顯示,原始資料分布中較少見的尾端內容會逐步消失,模型輸出因此偏離原始分布;作者將這種現象稱為 model collapse(模型崩塌)。這個案例聚焦生成資料遞迴使用,不把所有 AI 生成內容都判為有害。Shumailov 等人研究
Zhang、Rando 等人的預訓練投毒研究則把模型從頭訓練,測試拒絕服務、信念操弄、越獄與提示竊取四種攻擊目標,並在安全微調後檢查攻擊是否留存。作者測試 600M 至 7B 參數規模的模型,發現只要 0.1% 訓練資料遭投毒,四種目標中有三種攻擊仍可在後續微調後測得;拒絕服務攻擊在 0.001% 投毒比例下也能留存。這個案例說明的是刻意植入行為的攻擊風險,和一般資料篩選不周不同。Zhang、Rando 等人研究
三類風險都應納入資料治理,但不能用同一個「低品質」標籤概括:社群短文可能瑣碎但非惡意,合成資料可能造成分布偏差,投毒則帶有刻意操弄目的。
實務上,三種情況的稽核線索也不同:社群資料要檢查來源、互動與內容抽樣;合成資料要標記生成來源並追蹤每輪混入比例;投毒防護則要留意異常重複樣式、可疑來源及特定觸發行為。只保留一個總體「品質分數」,會讓團隊難以判斷該回頭查哪一段資料流程。
資料治理應在哪些環節介入?
治理要涵蓋資料納入、版本記錄、固定評測、異常告警和修復驗證,並留下負責人與追溯紀錄。
- 納入前標記來源與特徵:記錄來源平台、取得時間、語言、授權、是否由模型生成、去重方式及篩選規則。互動度、長度與語意品質分開存,不讓單一代理指標取代人工抽查。
- 抽樣稽核分類結果:由資料工程或資料治理負責人抽查高風險及邊界樣本,檢查分類器是否把有價值的短內容誤判為低品質,也記錄標註準則與變更版本。
- 保留訓練版本與組成:模型訓練負責人記錄資料集版本、各來源比例、token 預算、訓練參數和模型檢查點。若之後分數變化,才能定位是哪一批資料或哪次流程改動。
- 訓練前後固定評測:評測團隊用相同基準、提示、解碼設定與評分方式比較版本,同時看推理、長上下文、安全等不同能力;避免只挑一個分數作為整體品質代理。
- 設定回歸門檻與修復驗證:模型負責人先定義哪些變化需要告警、人工複核或回退,再以原評測集及獨立任務驗證修復效果。單次分數回升不能取代重現與版本對照。
- 特定 Twitter/X 貼文在受控持續預訓練中,與部分基準分數下降相關。
- 熱門度、語意品質、合成來源與投毒是不同資料訊號。
- 保留訓練版本與固定評測,才能追查能力變化。
檢視一套流程時,可追問:資料來源與篩選規則是否留存?新舊版本是否用相同條件評測?能力下降時,誰能定位資料批次並驗證修復?
常見問題
Q1: 這項研究證明所有熱門貼文都會讓 AI 變笨嗎?
沒有。M1 用互動度和長度建立一種實驗性分類,M2 則依語意品質分類;研究結果只適用於該資料集、模型和訓練條件,不能把熱門直接等同低品質。
Q2: 研究測到的「推理退化」代表商用聊天機器人也會退步嗎?
不能直接這樣推論。研究使用四個開放權重模型進行受控持續預訓練,封閉商用模型的資料組成與更新流程未公開,是否有相同影響需要另行評估。
Q3: 研究是否證明模型能力永久受損、無法恢復?
沒有。作者發現已測試的補訓方法未能完全恢復部分基準表現,但這不等同所有修復方法都無效,也不足以證明永久不可逆。
Q4: 團隊最先應檢查哪一項資料治理措施?
先確認每個訓練版本是否保留資料來源、篩選規則與比例,再檢查模型更新前後是否使用固定評測集。這兩項能讓團隊開始追蹤資料變化與能力回歸。
參考來源
- Xing S, et al. (2026). LLMs Can Get “Brain Rot”: A Pilot Study on Twitter/X. *Conference on Language Modeling (COLM 2026).
- Texas A&M University College of Engineering (2026). AI models can get brain rot, too
- Shumailov I, et al. (2024). AI models collapse when trained on recursively generated data. *Nature*, 631, 755–759
- Zhang Y, et al. (2024). Persistent Pre-Training Poisoning of LLMs. *arXiv.


