
Ricursive Intelligence 發布 Ripple-65B Preview,公布它在 Terminal-Bench 2.1 得分 80.52,並提供 Apache 2.0 授權的模型權重。這讓開發團隊多了一個本地部署候選,但分數不能回答它能否改好公司的程式庫、能否安全執行命令或部署是否划算。評估時,模型、代理工具、硬體和團隊流程都要納入。若團隊在找離線方案,可先看OpenCode 搭配 Ollama 的代理部署條件。
Ripple-65B 的代理程式成績,實際代表什麼?
Ricursive Intelligence 的模型卡列出 Ripple-65B Preview 在 Terminal-Bench 2.1 得分 80.52,屬於發布方公布的測試結果。它反映特定測試環境中的終端代理任務表現,不能直接當成一般程式工作的成功率。
Ripple-65B 是 650 億參數的 dense Transformer,發布版本包含 BF16 與 NVFP4 指令模型,以及 BF16 基礎模型;模型卡也列出最多 1,048,576 token 的上下文長度。這些是發布方列出的產品與模型資訊,Preview 版本後續可能更新,部署時應以實際下載的模型卡、權重和推論框架版本為準。模型卡列有 Ripple-65B 的權重格式與測試說明。
Terminal-Bench 2.1 是在沙盒終端環境完成操作任務的測試,涵蓋安裝套件、處理資料、操作環境和使用工具。該版修正 89 項任務中的 28 項,涉及外部依賴更新、資源設定不足,以及任務說明與測試不一致。版本更動會改變測量結果,看分數時要確認任務集版本。Terminal-Bench 團隊說明 2.1 的修正內容。
Ripple-65B 模型卡的 80.52 是發布方公布的測試結果。比較表部分數字取自其他模型官方卡,缺少的項目由 Ricursive 自行評測;未註明 harness(代理執行框架)時使用 OpenCode,另有測試採 Terminus 2。發布方表示,改用 Terminus 2、128K 序列長度和摘要設定後,Terminal-Bench 分數普遍較低。分數會受代理、提示、上下文和環境影響,不能只看榜單數字。模型卡的比較方法與限制。
與 SWE-bench 等測試對照時要留意什麼
Terminal-Bench 著重沙盒終端任務;SWE-bench 則給模型程式庫與 GitHub issue,要求修改程式處理問題。SWE-bench 原始研究從 12 個 Python 專案的真實 issue 和 pull request 建立任務,指出解題常需跨函式或檔案理解程式庫。SWE-bench 原始研究。
| 評測 | 主要任務 | 可協助回答 | 不直接代表 |
|---|---|---|---|
| Terminal-Bench 2.1 | 在沙盒終端完成操作任務 | 代理能否按要求使用命令與工具 | 團隊程式庫的修補成功率 |
| SWE-bench | 依 issue 修改既有程式庫 | 能否理解程式碼並提交可驗收修改 | 一般終端操作與部署效能 |
Ripple-65B 模型卡另列 SWE-bench Verified 76.5,但不能和 Terminal-Bench 的 80.52 當成同一尺度。兩者題目、驗證方式和工具不同;Terminal-Bench 2.1 修訂任務後,測量結果也隨版本改變。比較前應先看測試範圍與限制。
若重點是怎麼設計可重複的評測任務,程式代理工具使用的評測方法提供另一種檢查角度;它不能替代自家專案測試,但能協助先定義評估問題。
從模型分數到程式工作流,中間還差哪些驗證?
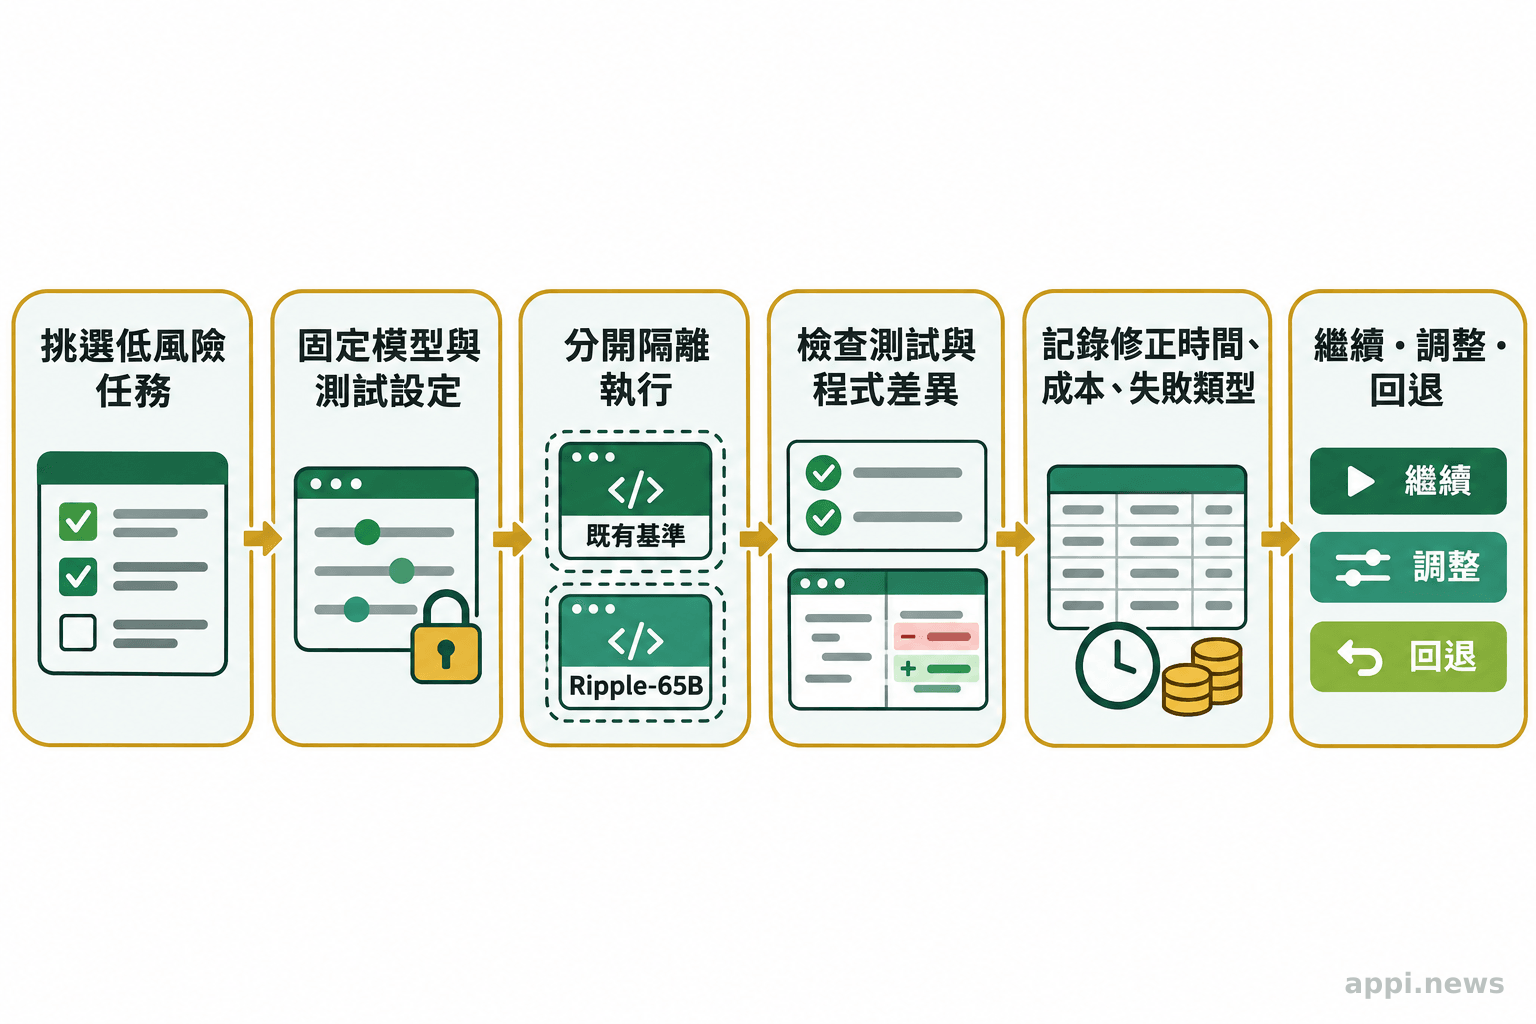
用團隊常見且可重複的任務測試,並固定模型版本、代理工具、提示、測試環境與權限。除任務是否完成,也要記錄人工修正時間、失敗類型、執行成本及安全事件。
程式代理會讀取專案、選擇工具、呼叫命令,再按輸出決定下一步。模型可能寫對程式碼卻執行錯誤指令,也可能因測試資料或環境而失敗。分開記錄這些問題,才能判斷原因在模型、代理工具、專案文件或測試環境。
選一組日常任務,例如修補已知 bug、補測試、小型重構或更新依賴。先用現有代理建立基準,再以相同任務、提示、工具、時間限制和測試條件試跑 Ripple-65B。設定明確判準,例如測試通過、差異檔符合預期、沒有改動範圍外檔案,並重複執行以觀察穩定度。
- 挑選可控任務:使用已知答案、可重設工作目錄的任務,先排除會影響正式服務或外部資料的操作。
- 固定測試條件:記下模型版本、權重格式、量化方式、上下文長度、代理框架、提示、工具權限與硬體。
- 記錄多種結果:除了通過率,也記錄人工介入次數、修正時間、推論延遲、資源用量和失敗原因。
- 設好停止與回退點:遇到權限越界、資料外傳、刪改非目標檔案或無法重現的變更,立即停止該輪測試並回復工作目錄。
模型卡將 Ripple-65B 標為 Preview,使用前須確認版本、推論框架相容性與維護狀態。能執行命令的代理應放在隔離環境,限制權限並保留變更審查和回退機制。不得把機密、憑證或未授權資料交給模型或第三方託管服務;自建部署也要設定存取控制與日誌政策。
「重現基準分數一直很困難,現代代理評測有許多因素會讓分數變動。」(中文意譯)(Ricursive Intelligence,Ripple-65B Preview 模型卡) 「Terminal-Bench 2.1 修正 Terminal-Bench 2.0 的 89 項任務中 28 項。」(中文意譯)(Terminal-Bench 團隊)
自行部署 Ripple-65B 需要哪些硬體條件?
目前不能只用模型參數量推出一個適用所有人的最低顯示記憶體數字。權重格式、上下文長度、同時服務人數和推論框架都會改變實際需求,應以目標設定實測。
Ripple-65B 提供 BF16 和 NVFP4 權重。BF16 精度較高、通常需要較多記憶體;NVFP4 以較低位元表示權重,可減少權重佔用,但推論仍需緩衝、KV cache、上下文和其他程序空間。參數乘位元數只能粗估權重,不能當完整硬體規格。發布方提到 NVFP4 checkpoint 和 DGX Spark 部署可能性,並非所有上下文與並行設定都適用。模型卡列出的格式與硬體說明。
長上下文不代表每次都要送入最大長度。代理若保留整個程式庫和大量工具回應,KV cache 會隨輸入與生成內容增加;並行請求也會提高用量。可從日常任務常用長度開始,測量記憶體峰值、速度和任務表現,再決定設備需求。
硬體評估還要算入框架更新、權重儲存、監控、備援、耗電和工程人力。工作量低時,雲端推論可能較易試行;程式碼不能離開內網或工作量穩定時,本地部署的控制權可能更有價值。兩者都要對照資料政策和總成本。
Apache 2.0 代表哪些商用條件?
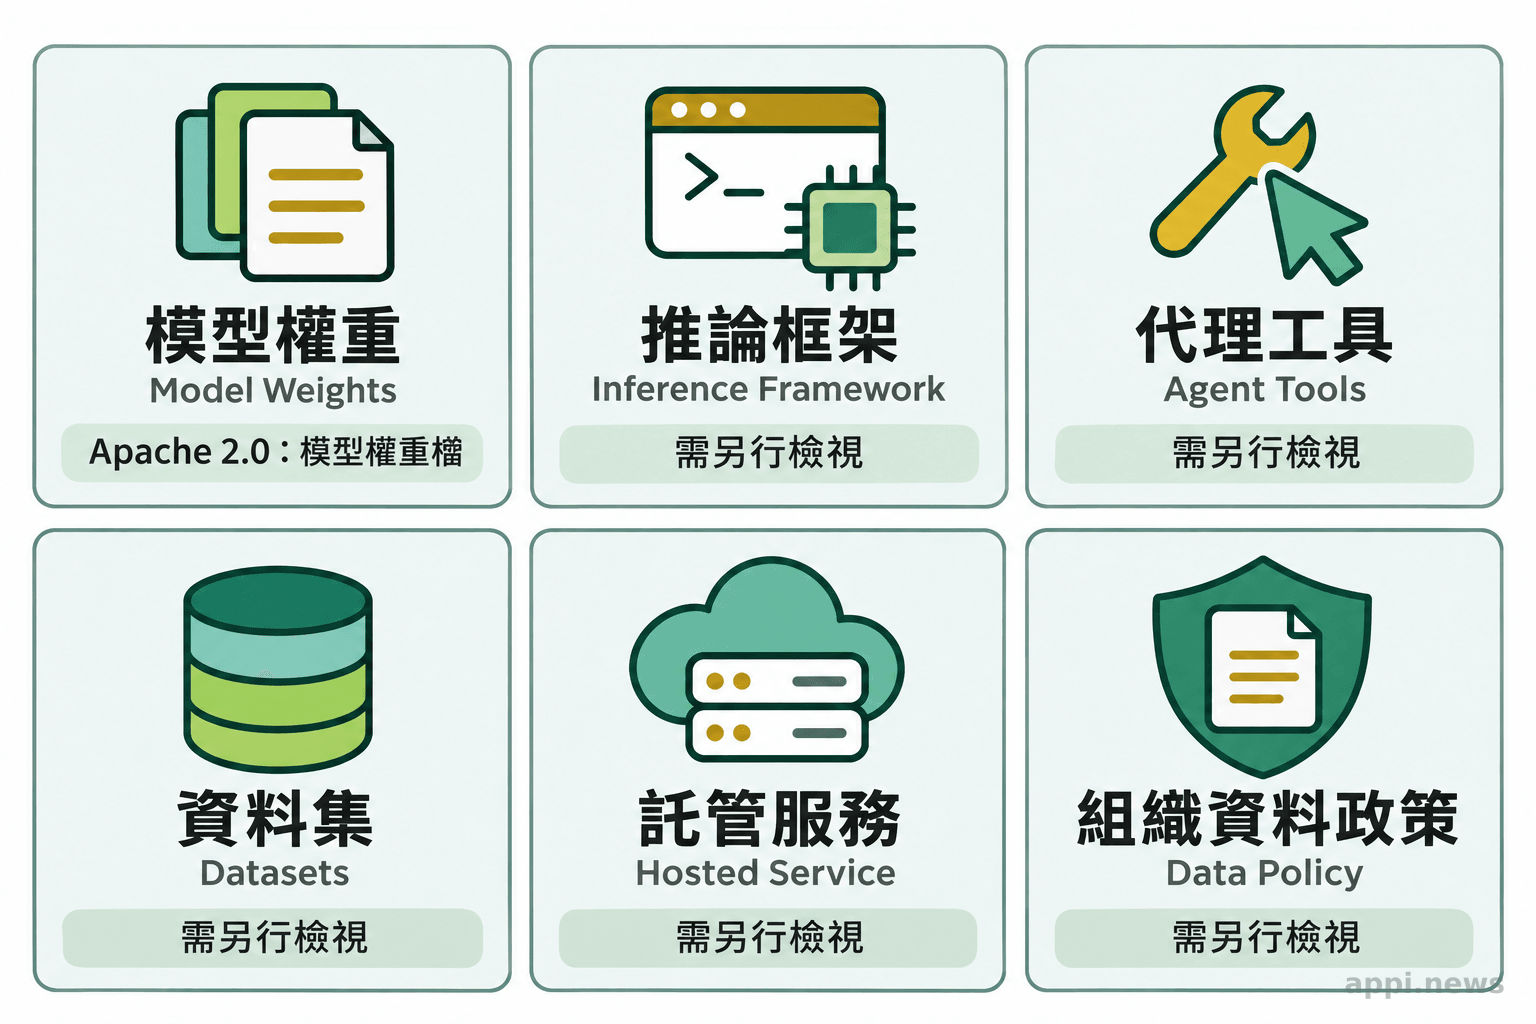
Ripple-65B 模型卡標示 Apache 2.0。這項授權提供使用、修改與散布程式或模型相關材料的條件,但使用者仍須遵守授權條文,並確認實際權重、程式碼、依賴套件與部署服務各自的條件。
Apache License 2.0 包含授權、著作權、散布、專利和修改標示等條款。導入前應核對下載版本的授權文件及模型卡,確認聲明保留、修改標示、專利與第三方材料等要求。Apache License 2.0 原文。模型權重的授權不會自動涵蓋推論框架、容器、資料集、代理程式或託管 API,也不代表服務可用或沒有成本。
開放權重與現成服務也不同。Ricursive 官網提供試用入口,但產品服務與模型權重是不同的取得方式,採用前須核對最新資訊。自建或託管都要確認資料流向、日誌保存、存取權限,以及模型或 API 變更時如何回退。
哪些團隊適合先試 Ripple-65B?
有可隔離的測試環境、可重複的程式任務和人力檢查輸出的團隊,可以先做小規模試行。若沒有明確任務、權限管理或回退方案,模型分數不足以支持直接接入正式程式庫。
最合適的試行方式,是先選一種低風險、可量測的工作,例如自動補測試或修復可重現的小型錯誤。先讓目前代理完成同一批任務,再比較 Ripple-65B 的完成率、人工修正時間、推論成本和安全檢查結果。若新模型只提高 benchmark 分數,實際工作仍需更多人工介入,對團隊的收益可能有限;若它能在允許的權限內穩定完成特定任務,才有理由擴大測試範圍。
決定前可用四個問題收斂:任務是否重複且可驗收?模型是否能在限制權限下運作?每次成功節省的人工時間是否高於部署與維護成本?失敗時能否檢查、撤回並追蹤責任?先以現有流程建立基準,再用相同條件測 Ripple-65B,根據答案決定停止、修正代理設定或進入下一階段。這套做法同樣適用於其他開放模型,也能避免把單一基準成績誤當成導入決策。
- Ripple-65B 的 Terminal-Bench 2.1 成績是發布方結果,會受代理工具、任務版本和測試設定影響。
- 自家程式庫的任務成功率、人工修正時間、資源成本和權限風險,需由團隊實測。
- BF16、NVFP4、上下文長度與並行量會改變硬體需求,參數數量不能直接換算完整部署規格。
- Apache 2.0 是模型相關材料的授權資訊之一,不涵蓋所有服務、依賴元件與資料治理要求。
常見問題
Q1:Ripple-65B 能取代雲端程式代理嗎?
目前的基準成績無法回答所有團隊是否能替換雲端代理。應以相同任務和權限測量自家完成率、人工修正時間、延遲、成本及資料政策,再決定採用本地或託管服務。
Q2:Apache 2.0 是否代表沒有部署成本?
不是。授權條件和營運成本是不同事項。自建仍需負擔硬體、電力、維護、監控與工程人力;使用託管服務則要核對費率、資料處理方式及服務條款。
Q3:目前的基準成績能代表自家專案表現嗎?
不能直接代表。基準任務、程式庫、代理框架和測試環境與團隊日常工作不同。先建立可重複的內部任務集,固定模型、提示和工具設定,才有可比較的導入依據。
參考來源
- Ricursive Intelligence (2026). ricursiveAI/Ripple-65B-Preview · Hugging Face. *Hugging Face Model Card
- Terminal-Bench Team (2026). Terminal-Bench 2.1. *Terminal-Bench
- Jimenez CE, et al. (2023). SWE-bench: Can Language Models Resolve Real-World GitHub Issues? *arXiv
- Apache Software Foundation (2004). Apache License, Version 2.0


