
一項獨立實測在 8 個 vCPU、15 GB 記憶體的純 CPU 環境,以 llama.cpp 執行 LFM3-Audio-2B 的 Q4_K_M 量化模型;11 秒 JFK 範例音訊約 6 秒完成轉錄,4 秒語音約 5 秒生成。這是 Webdiga 團隊的單機測試,不是 Ollama 測試,也不能代表一般桌機表現。測試紀錄
Ollama v0.40.13 官方發布說明指出,Liquid AI 的 LFM3,包括 lfm3-audio 與 lfm3-omni,現可在 Linux、Windows 和 Apple silicon(蘋果自研晶片)執行。這項更新解決的是執行平台支援問題,並未公布這些系統上的速度或硬體實測數據。
挑本機語音模型時,須核對語言品質、設備負載和資料流。想看前一版整合背景,可讀Ollama 0.40.12 接入 LFM3 與 d1 的驗收流程。
一、Ollama 0.40.13 新增哪種桌面支援?
官方公告將 Linux、Windows 與 Apple silicon 列為 LFM3 執行平台,並點名 lfm3-audio、lfm3-omni。
公告涵蓋三類執行平台,使用者可按手上的系統開始驗收。
Ollama v0.40.11 則在 macOS 加入語音播放功能,ollama run 可播放文字或模型回覆,應用程式也能透過 OpenAI 相容的 /v1/audio/speech 端點串流語音。這項功能說明屬於該版的 macOS 支援,不代表 v0.40.13 在 Linux、Windows 也提供相同介面。
另一個不同型號的實例可說明「支援」與「效能」要分開看:Ollama 官方以 v0.40.11、MacBook Pro M5 Max 和 Phonon 語音模型生成 45 秒語音,報告其執行速度比 Gradium 自有 runtime 快 35%。這是 macOS 上的 Phonon 測試,不能當成 LFM3 在 Windows 或 Linux 的效能數據。Ollama 測試說明
公告確認平台支援,不提供桌機速度數據;下載大小也不等於執行時記憶體需求。
Ollama v0.40.13 公告列出三類執行平台,未提供各硬體的效能數據。
二、lfm3-audio 和 lfm3-omni 適合哪些任務?
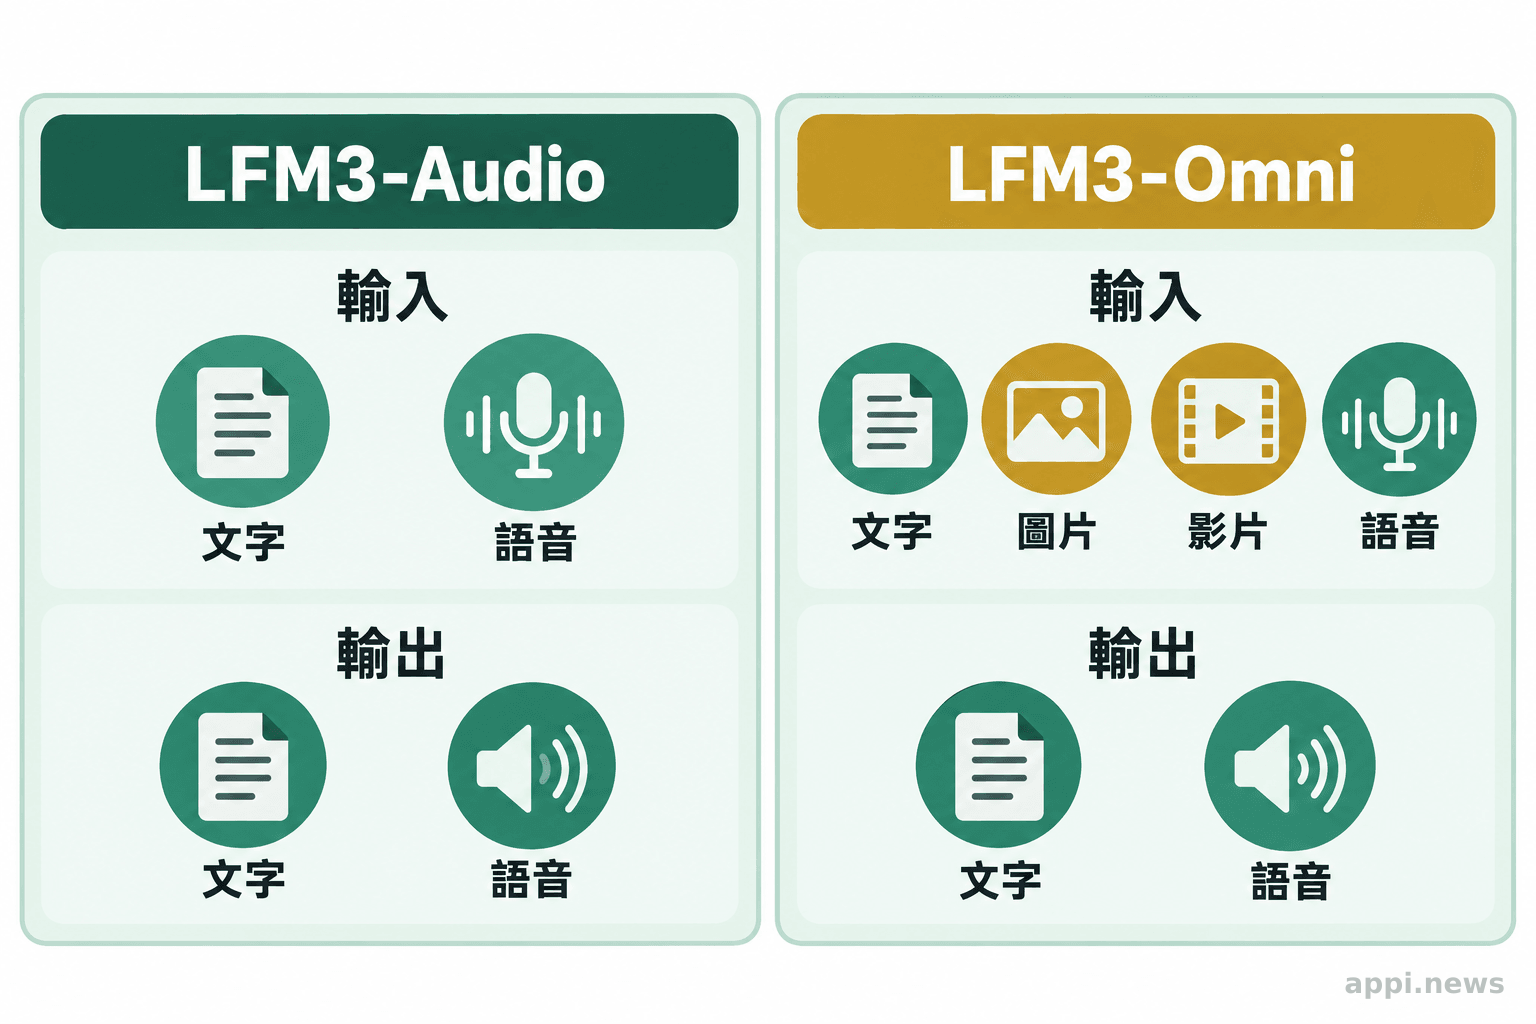
文字轉語音、音訊輸入、轉錄或語音問答可先測 lfm3-audio;要一併處理圖片、影片與音訊,可評估 lfm3-omni。兩者輸入範圍不同,應依工作內容選型。
Ollama lfm3-audio 模型頁列出 LFM3-Audio-2B,支援文字或音訊輸入、文字或 24 kHz 語音輸出及 18 種語言。
Liquid AI 也公布一項解碼實測:在單執行緒 Apple M4 Max 上,LFM3-Audio 與 LFM3-Omni 使用的 LiquidCodec 約以即時語音 87 倍的速度解碼,並支援串流。該公司另報告 LFM3-Audio-2B 英語語音辨識測試 WER(詞錯誤率)為 6.2%,多語言測試平均為 6%,涵蓋中文、日文和韓文。這些是模型供應商的測試,並非 Ollama 桌面部署實測;繁體中文與台灣口音仍要自行驗收。Liquid AI 測試與評測
lfm3-omni 模型頁列出 2.17B 參數,可處理文字、圖片、影片和音訊四類輸入,輸出文字或 24 kHz 語音。Liquid AI 舉例包含對照片提問、理解有聲影片及語音對話;這描述型號能力,不能當作特定硬體的速度成績。
模型清單標示 Chinese,未細分繁簡或台灣口音,也沒有繁中分數。應拿產品名、數字及中英混讀句驗收。可參考文字轉語音模型評測指標與限制,設計自己的聽感和轉錄檢查欄位。
| 項目 | lfm3-audio | lfm3-omni |
|---|---|---|
| 輸入 | 文字、音訊 | 文字、圖片、影片、音訊 |
| 適合先測 | 朗讀、轉錄、語音問答 | 圖片或影片搭配語音提問 |
| 仍須實測 | 繁中自然度、延遲、硬體負載 | 多媒體格式、繁中自然度、硬體負載 |
Ollama 語音工作流的其他檢查角度,見Phonon 本機語音工作流。
三、桌面部署前要核對哪些條件?
確認 Ollama 版本、作業系統、模型標籤、磁碟空間、執行時資源及本機端點。官方平台支援不等於每台桌機都有足夠效能。
在目標電腦記下作業系統、處理器、顯示卡和記憶體,再依模型頁執行 ollama run lfm3-audio 或 ollama run lfm3-omni。
下載大小會因量化版本而異,不等同完整硬體需求;上下文、音訊處理和其他程式也占用資源。沒有最低規格時應記錄實測。
本機聊天端點為 http://localhost:11434/api/chat,OpenAI 相容客戶端可用 http://localhost:11434/v1/。確認型號輸出介面,並測超時、載入失敗和錯誤格式。
逐項盤點音訊前處理、外部 API、同步服務、日誌與暫存檔,才能判斷資料是否離機。本機推論不代表應用程式不連網。
四、如何測出真正的部署瓶頸?
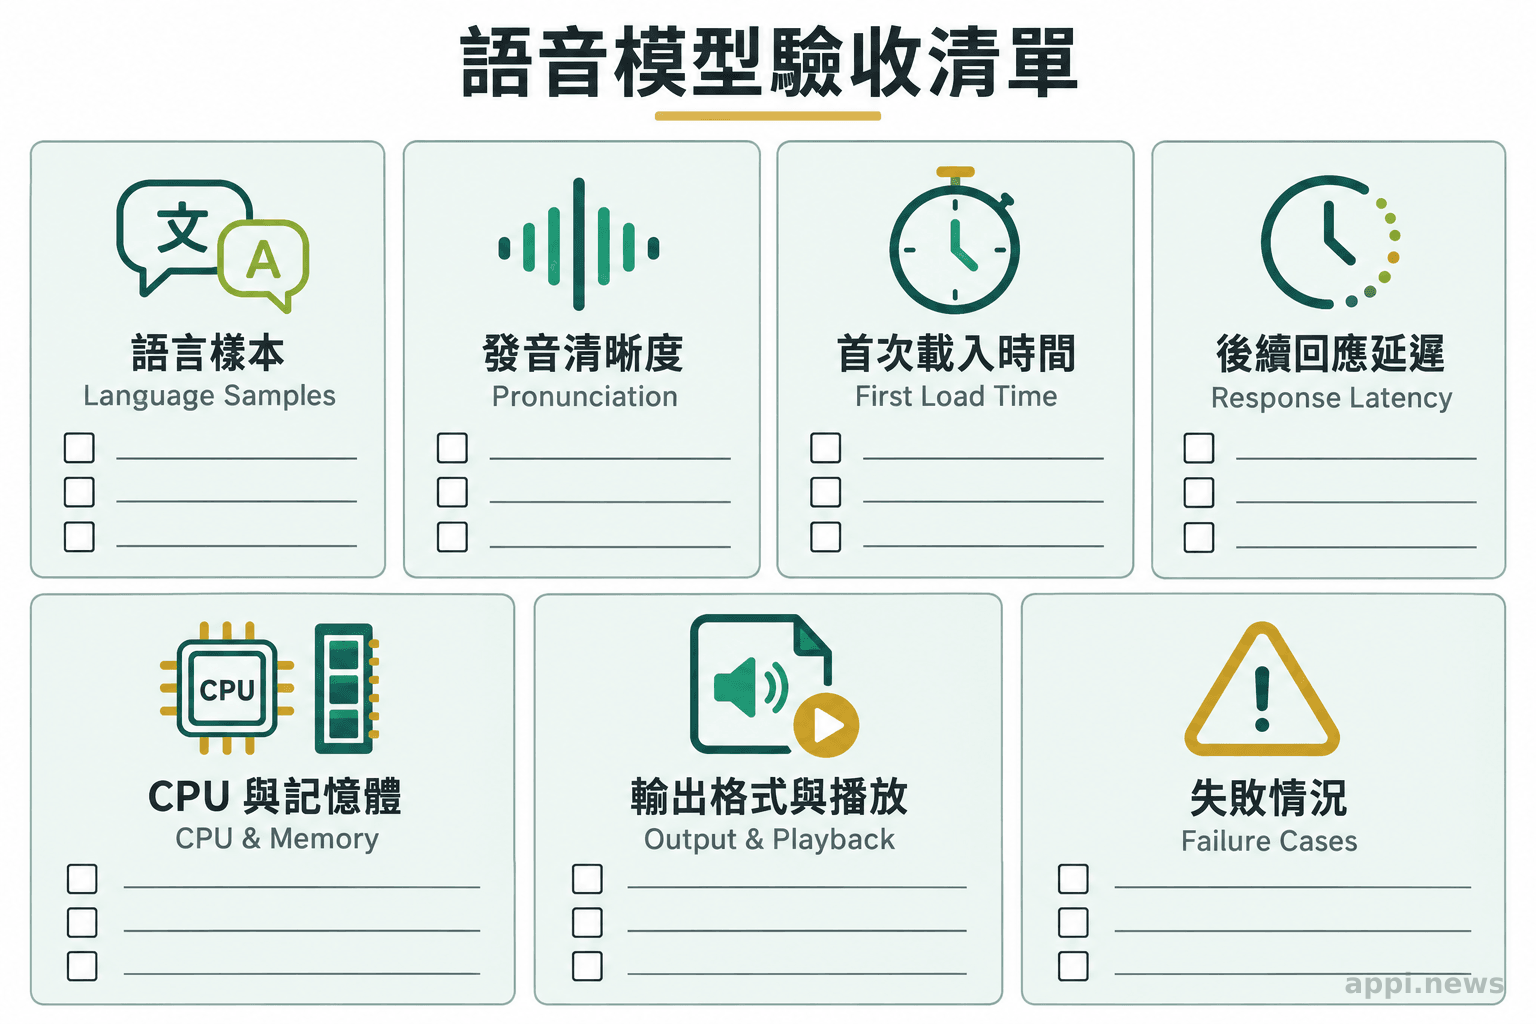
用固定樣本記錄發音、輸出內容、延遲、資源使用和錯誤。結果只適用於當時的設備、版本、模型標籤與設定,變更條件後應重測。
準備不含個資的繁中句,包含標點、縮寫、數字及產品名,另加目標語言樣本。朗讀檢查停頓與中英切換;轉錄核對專名與漏字;問答確認是否聽懂。一次只改一個條件。
聽見聲音不代表檔案格式或播放器相容。模型頁列出的 24 kHz 輸出是規格,仍須在桌面播放器及目標應用實際播放,檢查截斷、空白或破音。
每次記下模型標籤與量化版本、Ollama 版本、設備、輸入長度、輸出格式和設定。分開計首次載入與後續回應時間,Ollama API 回應提供生成時間、載入時間等欄位,可與應用程式端到端計時對照。
Ollama API 文件提供生成與載入時間欄位;搭配應用程式的總耗時,可以定位等待出在模型或前後處理。
五、接入工具前如何檢查資料流?
畫出輸入、前處理、Ollama 端點、模型輸出與保存或播放的路徑,檢查每段是否呼叫外部服務。先用低風險樣本驗證失敗處理,再擴大使用。
盤點錄音、轉檔、請求端點、回傳格式、輸出位置和暫存權限;雲端工具、同步及斷線補送都要檢查。
先用不含敏感內容的核准樣本,檢查格式解析、重試和重複執行;限制工具可執行的動作,由程式驗證參數。
- 選一段不含敏感資料的實際文本,固定語言、長度與輸入格式。
- 在目標設備分別測需要的型號,記錄回覆、延遲、資源與錯誤。
- 檢查資料流、輸出檔和失敗回復,再決定是否擴大使用。
- 以語音為主先測 lfm3-audio,需要圖片或影片輸入再評估 lfm3-omni。
- Chinese 標示不等同繁體中文或台灣口音品質保證。
- 記錄固定樣本的版本、設備、延遲、輸出格式與錯誤,結果才可比較。
- 本機推論不代表整條應用流程離線,外部工具和暫存資料也要查。
六、常見問題:版本、語言與離線
依任務挑選型號,並在目標設備確認語言輸出、效能和資料流。
常見問題
Q1:一定要升級到 0.40.13 嗎?
使用 Linux、Windows LFM3 支援時,須安裝包含該功能的版本。
Q2:支援中文是否代表繁體中文朗讀已確認?
否。模型頁只列 Chinese,沒有區分繁簡或台灣口音,也沒有提供相應測試分數,應以實際用語驗收。
Q3:官方列了最低硬體需求嗎?
發布說明確認平台支援,但模型頁沒有提供適用所有桌機的最低配置和效能保證。請在目標設備測試資源與延遲。
Q4:本機跑模型就能保證資料不外流嗎?
不能只由推論位置推定整個流程。模型下載、外部 API、同步、日誌與暫存檔都要檢查。
Q5:升級前最小測試怎麼做?
用一段無敏感資料的代表文本,在目標 Linux 或 Windows 電腦記錄版本、模型、語言輸出、延遲、資源和錯誤,再與舊流程比較。
參考來源
- Ollama (2026). Release v0.40.13 · ollama/ollama · GitHub
- Ollama (2026). lfm3-audio. Ollama Model Library
- Ollama (2026). lfm3-omni. Ollama Model Library
- Ollama (2026). Generate a chat message. Ollama API Documentation
- Ollama (2026). OpenAI compatibility. Ollama API Documentation
- Ollama (2026). Release v0.40.11 · ollama/ollama · GitHub
- Webdiga Editorial Team (2026). How to Run LFM3 Locally: Liquid AI's 6 Small Models Tested
- Ollama (2026). Speech models in Ollama
- Liquid AI (2026). Introducing LFM3: Every Modality for Specialized Intelligence


