
Gradium 在 Phonon TTS 發布展示中,讓 Apple Watch 在 Wi-Fi 關閉時逐步口述咖啡沖煮流程。這個例子呈現的是一種不同的語音工作流:模型在手錶本機產生語音,使用者不必先把文字送到雲端服務再等音訊回來。對需要離線語音的開發者而言,這令人好奇;但真正要評估的問題,是它能否在自己的語言、裝置與產品流程中達到可接受的品質和反應速度。
判斷 Phonon TTS 是否適合,不能只看「能離線」或榜單名次。還要逐項核對語言、模型授權、目標硬體、首段音訊等待時間、發音結果,以及應用程式如何載入和維護模型。以下從發布方已展示的內容,拆解這些條件。
Apple Watch 關閉 Wi-Fi 仍能語音導引,Phonon 展示了什麼
它顯示 Phonon 能在手錶端生成咖啡沖煮語音導引;這是發布方展示的可行案例,不能直接代表所有手錶或其他應用都達到相同效能。
Gradium 在 Phonon 發布文章中也展示了瀏覽器專案 Offline FM:恐龍遊戲角色 Rex 會即時播報遊戲內容,讓瀏覽器中的遊戲加入語音回應。連同 Apple Watch 咖啡導引與無訊號 iPhone 上的 RepCoach 口頭計數,這些案例呈現 Phonon 在穿戴裝置、手機和瀏覽器的展示情境;它們是發布方列出的應用案例,沒有提供可比較的裝置效能數據。
這些展示仍是發布方介紹的產品案例,沒有提供可直接比較的獨立裝置效能數據。Wi-Fi 關閉時仍能說話,至少表示展示中的模型與所需聲音資源已可在裝置端運作;它不能回答較長文本要等多久、耗電多少、背景執行是否穩定,或低階晶片能否維持同樣音質。對使用者來說,離線生成也不等於產品內所有功能都離線,翻譯、登入、內容更新等環節仍可能需要網路。
若產品需求包含口語互動,還要把模型生成時間與整個工作流程一起測。例如語音代理還有辨識、推理、網路傳輸和播放等步驟,TTS 變快不必然讓整段對話同幅度縮短。可參考站內整理的語音代理延遲與接入檢查,先標出使用者實際等待的是哪個環節。
Phonon TTS 如何把文字轉成裝置端語音
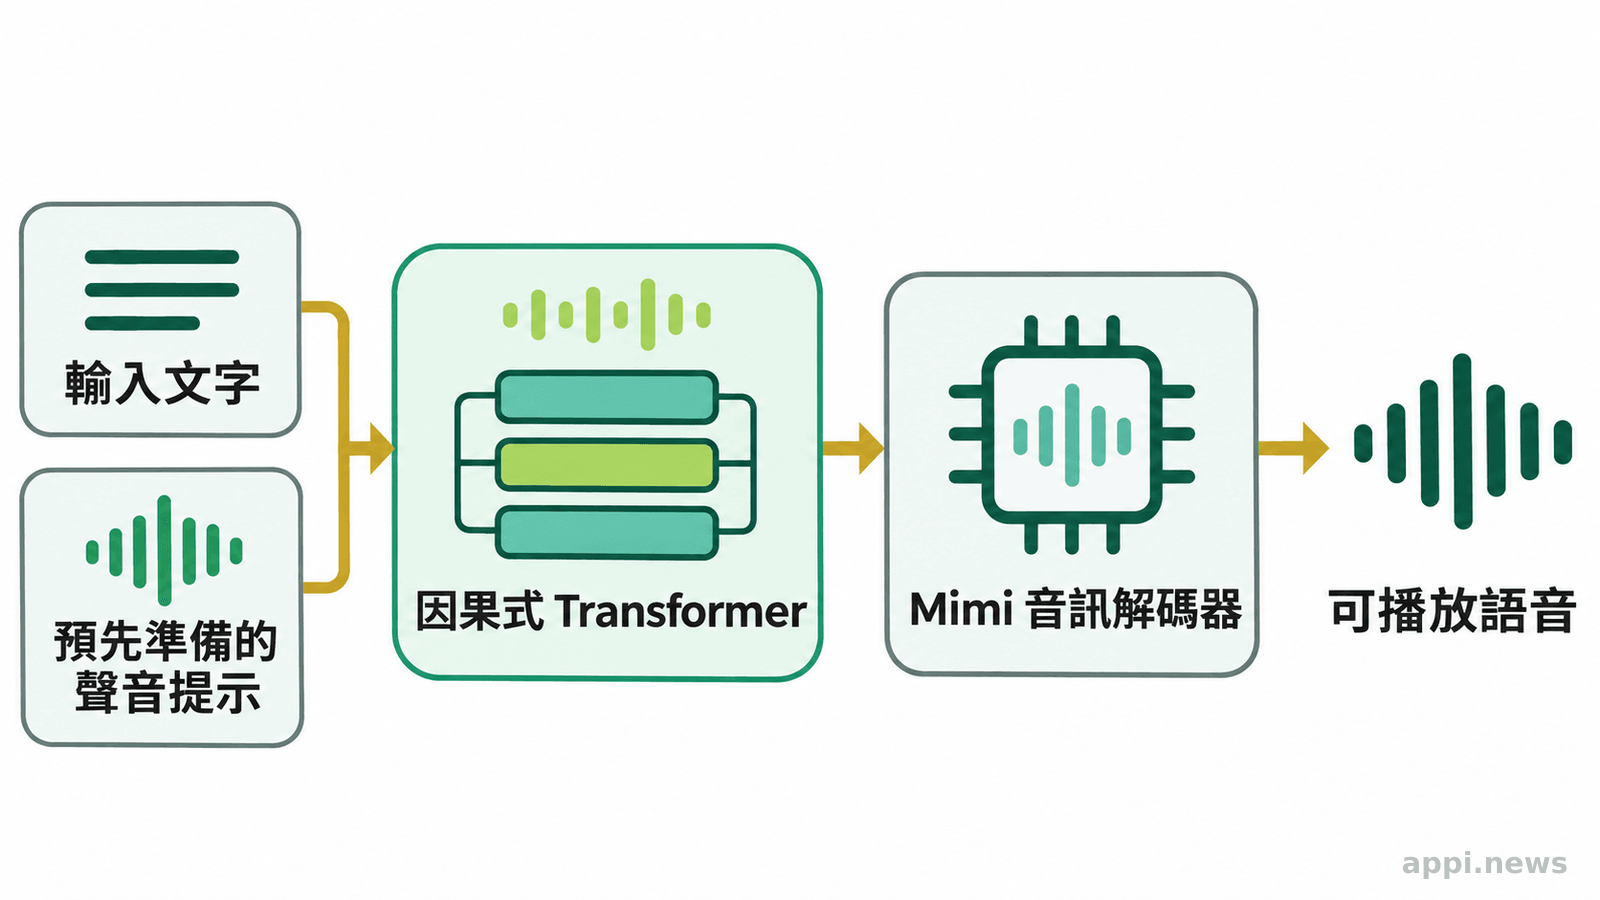
模型讀取文字與預先準備的聲音提示,逐步產生音訊表示,再由解碼器轉成可播放的聲音。
Phonon 建立在 Pocket TTS 技術脈絡上。依 Hugging Face 模型文件,因果式 Transformer 會讀取聲音提示和文字,接著以每秒 12.5 個步驟輸出 32 維音訊 latent(音訊的壓縮表示);處理器所持有的 Mimi 音訊解碼器再將它還原成 24 kHz 音訊。模型卡另以每個 80 毫秒音訊影格描述預測過程。對部署者而言,這代表生成模型和解碼器都屬於執行流程,不能只盤點主模型權重大小。
Flow matching(流匹配)是其生成音訊表示的方式之一。可以先把它理解為模型依序估計音訊表示,再將結果交給解碼器播放;串流模式會在後續音訊仍生成時,就先提供已完成的片段。首段音訊何時抵達因此成為重要指標,但最終聽感仍受文字正規化、聲音選擇、長句切分和播放端緩衝影響。
Hugging Face 文件指出,Phonon 的聲音提示以預先計算的 latent 提供,模型所用的 speaker codec 沒有釋出,因此不能直接拿一段錄音在這個解碼器中複製聲音。這也提醒產品團隊,語音清單、聲音授權及個人聲音同意流程,應和模型推論分開確認。文字正規化同樣重要,模型不會自動替所有數字、金額、符號或地址改寫成自然口語;文件建議在輸入前處理這些內容。
部署方式會改變工程工作的重心。Gradium 的 ptts 推論框架針對單一裝置上的串流推論,列有 CPU、WebAssembly、CUDA、Vulkan、Metal、WebGPU、Core ML 和 Snapdragon NPU 等後端。Transformers 則提供 PyTorch 參考實作,文件指出它可用於批次生成和 GPU 吞吐工作。前者較貼近產品端的本機串流整合,後者較適合研究、批量合成或在 PyTorch 生態中延伸;實際支援仍要看裝置、模型版本和整合方式。
| 選項 | 文件所述用途 | 評估時要看 |
|---|---|---|
| ptts | 裝置上的單一串流,提供多種 CPU、GPU、NPU 與瀏覽器後端 | 目標後端是否支援、封裝和應用整合、首段音訊與耗電 |
| Transformers | PyTorch 參考實作,可做批次生成、GPU 吞吐及模型研究 | 套件版本、目標硬體、執行圖最佳化和產品端部署方式 |
“Latents are the model’s inputs, outputs and targets, as text tokens are for a language model.” (音訊 latent 對模型而言就像文字 token,是模型的輸入、輸出與訓練目標。) (Hugging Face 對 Phonon 音訊表示的說明,見發布文章。)
基準測試排名如何解讀,為什麼不能直接等同部署效能
不代表。榜單描述的是特定資料集、指標與測試硬體下的結果,仍需在實際目標裝置重新驗收。
Gradium 在 Hugging Face 發布文章中表示,Phonon 在其參加評估的語言中,德語與西班牙語辨識度排名第一,其他受測語言也進入前三;發布文章也稱它在 CPU 串流的 time-to-first-audio(首段音訊時間)測試表現突出。這些是發布方對 Hugging Face Open TTS Leaderboard 結果的轉述,並非目標手機或手錶上的獨立實測。榜單仍在發展,測試條件及參與模型也可能更新。
榜單文件把不同面向分開衡量:辨識度用生成語音轉錄後的字詞或字元錯誤率;速度包括批次離線推論的即時率倒數,以及串流的首段音訊時間;自然度則使用預測 MOS 等模型評分,英文與韓文使用的指標不同。不同指標回答不同問題,低錯誤率不等於聲音最自然,快速吐出第一段也不代表長文能持續即時播放。
尤其首段音訊時間不是每種部署環境的固定常數。榜單採用的串流測試包含 A100 GPU 和 CPU,而裝置端產品可能是低功耗手機晶片、瀏覽器 WebAssembly 或手錶處理器。量化方式、執行後端、輸入長度、系統負載都會改變結果。可以把榜單當成縮小候選清單的依據,再用自家裝置與文本做測試;Open TTS Leaderboard 指標與限制則有更完整的讀表方式。
“While human preference is the ultimate decider, arenas cannot scale to keep up with the pace of TTS releases.” (人類偏好仍是最終判準,但人工評選的規模難以跟上 TTS 模型發布速度。) (Hugging Face Open TTS Leaderboard 專案文件對自動化評估的說明。)
語言、硬體和授權條件會如何影響選型
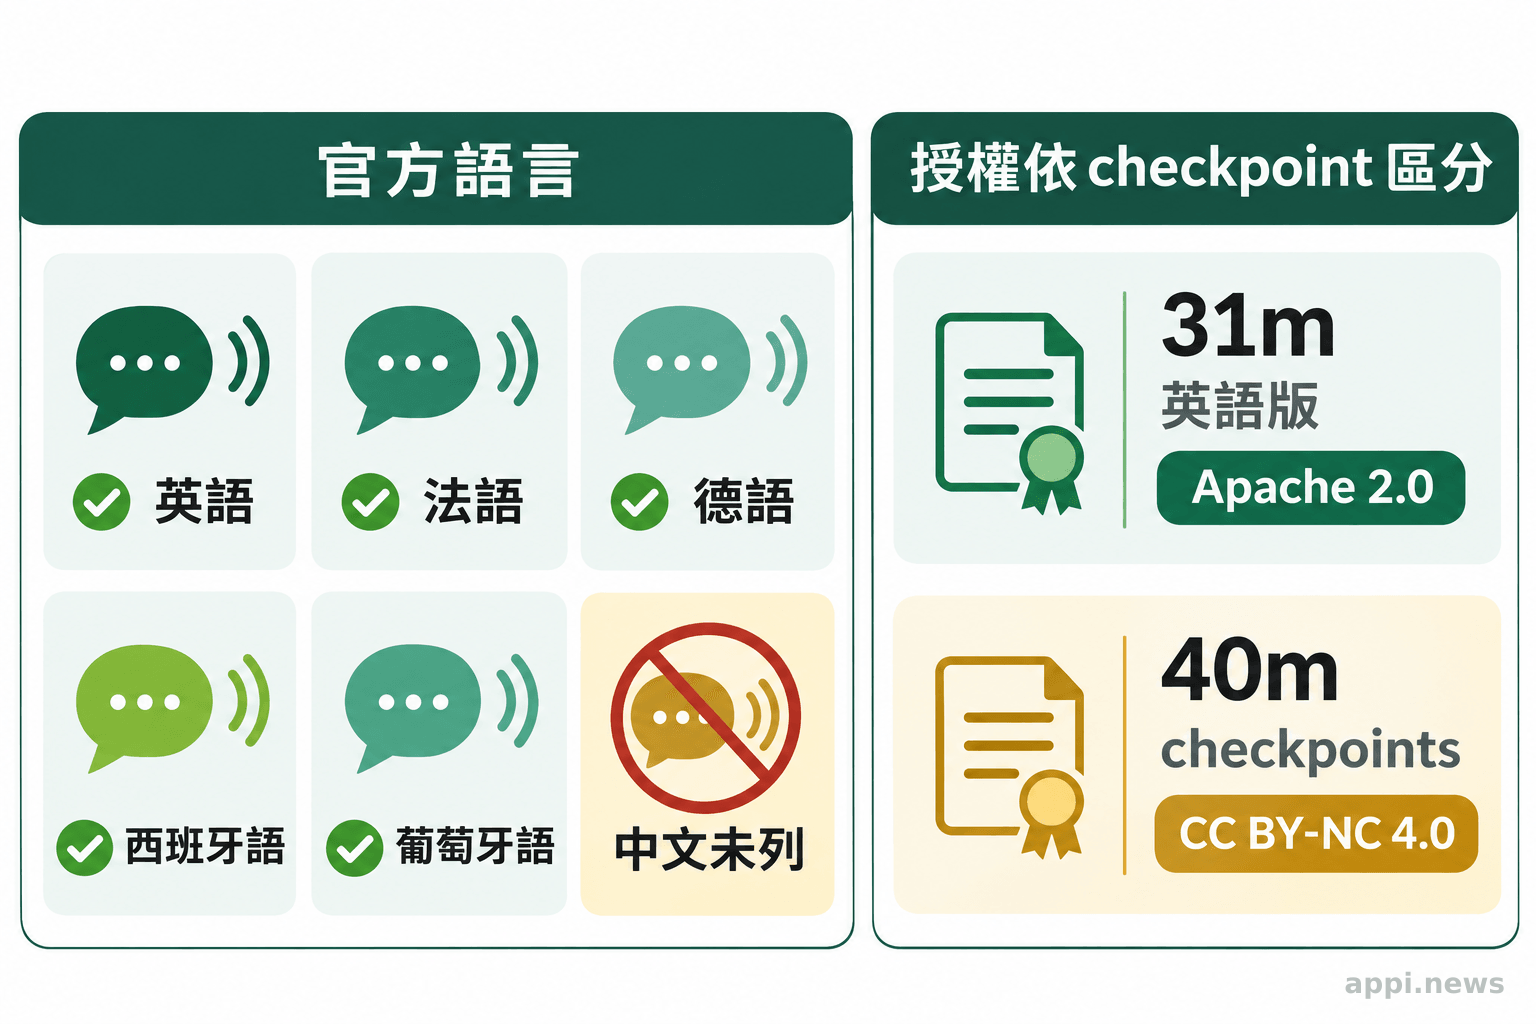
目前官方列出的版本涵蓋英、法、德、西、葡語,不含中文;授權也依 checkpoint 不同,商用前要核對具體模型。
模型卡列出 Phonon 31m 英語版,採 Apache 2.0;40m 英語、法語、德語、西班牙語、葡萄牙語及多語版本則列為 CC BY-NC 4.0。後者包含非商用條件,不能只因權重可下載或程式碼公開,就假設可以用於商業產品。部署時要分別閱讀所選模型權重、推論程式碼、聲音檔與其他依賴的授權條款,並由產品或法務確認符合預計的發行及營利方式。
中文需求是另一個先決條件。現有清單沒有中文模型,英文版的存在不能推導出中文輸入可正確朗讀。即使勉強輸入中文,也需要實測發音、混合語言、姓名、地址、日期和中英數字混讀,不宜把模型自動支援當成既定能力。若主要讀者使用繁體中文,先確認是否有合適 checkpoint 或其他模型,再投入裝置整合。
硬體也要用真機核對。模型卡提到英語 31m 版本的 8-bit 權重檔為 64.5 MB,模型參數約 31M,且另有音訊 tokenizer;這些規格有助估算下載和儲存空間,卻沒有涵蓋完整執行時的記憶體、耗電、啟動時間、溫升或多工干擾。裝置端可減少每次生成都依賴雲端往返的需求,但仍要負責模型更新、快取、失敗回退和不同作業系統的相容性。
部署前用一份檢查清單確認是否適合
先把目標語言、硬體、效能門檻、授權與整合責任寫成可驗收條件,再以真實輸入測試。
裝置端模型能不能解決實際問題,取決於需求是否定義清楚。若核心需求是無網路環境下播放固定英文指引,評估重點與需要中文、多語混讀、長文朗讀或多人同時生成的服務並不相同。先問清楚「為什麼要本機生成」:是網路不穩、希望減少雲端往返、想降低逐次服務依賴,還是需要文字留在裝置?若目標是網路中斷時仍可使用,就要在斷網情境測試完整流程;若原因是文字不離開裝置,驗收時要檢查資料傳輸與遙測設定;若想降低對逐次雲端服務的依賴,則要把模型更新、故障回退和維護成本納入評估。原因不同,應驗收的條件也不同。
- 確認內容與語言:列出產品會說的語言、姓名、地址、數字、日期和專有詞,準備一組真實且涵蓋例外的測試句。
- 指定目標裝置與後端:記錄手機、手錶、瀏覽器或單板電腦型號,以及預計採用的 CPU、GPU、NPU、Core ML、WebAssembly 等路徑。
- 訂出驗收門檻:定義可接受的首段音訊等待、長文播放穩定度、可懂度、自然度、耗電與記憶體使用,並在實機重複測試。
- 核對權利與資料流程:檢查 checkpoint、推論框架、聲音檔的授權;若涉及自訂聲音,確認取得說話者同意及保存、刪除方式。
- 安排整合維護:指定模型下載與更新、版本相容、離線錯誤回退、品質回歸測試及跨裝置維護的負責人。
如果語言、發音或目標裝置其中一項不符,先比較其他模型或混合部署方式,例如本機處理固定指令,雲端處理較複雜或尚未支援的內容。驗收結論應依產品自己的語句與設備得出,不要以演示畫面或榜單名次代替。
- Phonon 的發布展示涵蓋 Apple Watch、iPhone 與瀏覽器等裝置情境,屬發布方案例,不是跨裝置效能保證。
- 官方目前列出英、法、德、西、葡語版本,中文未列;Apache 2.0 與 CC BY-NC 4.0 checkpoint 的用途條件不同。
- 評估部署時,把真實文本放到目標裝置,測語音品質、首段時間、資源使用、授權與維護責任。
常見問題
Q1:Phonon TTS 可以完全離線使用嗎?
Gradium 表示,模型和聲音檔下載到裝置後,生成語音不需連線。產品的其他功能,例如內容取得、翻譯或帳號同步,仍要另外確認是否需要網路。
Q2:Phonon TTS 現在支援繁體中文嗎?
官方列出的模型版本是英語、法語、德語、西班牙語、葡萄牙語及五語多語版,沒有列出中文。不能把未列出的語言視為已支援。
Q3:Phonon 模型可以用於商業產品嗎?
須依 checkpoint 核對授權。模型卡列出 31m 英語版為 Apache 2.0,40m 各語言版本為 CC BY-NC 4.0;後者有非商用限制,實際使用前應檢查完整授權條款。
Q4:榜單排名高,是否就能在我的手機快速朗讀?
不能直接推定。榜單結果來自特定資料、指標和測試硬體;應在預定手機、作業系統、後端和實際文本上測試。
參考來源
- Hugging Face (2026). *A Closer Look at Phonon TTS. Launching High-Quality On-Device Speech That Tops the Benchmarks.
- Gradium (2026). *Phonon: Open On-Device Text to Speech from Gradium.
- Hugging Face (2026). *gradium/phonon-31m-en · Hugging Face.
- Hugging Face Transformers (2026). *Gradium Phonon TTS.
- Gradium AI. *xn-ptts: Phonon TTS inference using xn.
- Hugging Face (2026). *Open TTS Leaderboard evaluation scripts and methodology.


