
一位 Thomson Reuters 資深工程師住在喜馬拉雅山麓,遇到網路中斷時,仍想用程式代理修復專案。他在 Latent Space 分享中以 OpenCode、Ollama 和 Qwen3.5 9B 完成本機測試:先關閉網路,再讓代理修改支出計算器,最後五項測試全數通過。這個實作也留下問題:能離線跑完一個小任務,是否就代表自己的專案適用?
「代理」會讀檔、呼叫工具並依結果繼續工作;「推論端點」是代理送出模型請求的位址。本機模型的硬體與資料流取捨,可延伸閱讀程式代理 Harness 評估。
一、OpenCode、Ollama 與 Qwen 的離線組合,解決的是哪個卡點?
這個組合讓程式代理接上本機模型,減少模型請求依賴雲端服務。任務能否完成仍要另行驗收。
Latent Space 的支出計算器是同一案例,不是三個獨立採用故事。作者先預載模型與專案依賴,再關閉 Wi-Fi,確認本機 Ollama API 仍能回應而外部網址無法解析;接著讓代理診斷含退款的五筆支出。原程式只印出最後一筆 8.00,三項既有測試失敗,代理還一度提議專案沒有使用的 pytest。作者補上 unittest 指令後,代理改成累加金額;最後五項測試通過。這段實作能說明斷網檢查、測試提示與結果驗收的先後關係,證據範圍仍限於一個小型修正任務。
另一個實測來自開發者 Sebastien Castiel。他在搭機期間,以 24GB 記憶體的 MacBook Pro M4 Pro 執行 Ollama 的 gpt-oss,並透過 OpenCode 開發 Next.js 訂閱管理 CRUD 應用,資料存於瀏覽器 localStorage。作者表示成品可用,但完成過程約需雲端 Claude Code 的四至五倍時間,生成內容還要多輪修正,處理 ESLint、型別及介面問題。這個案例呈現離線可用與迭代成本同時存在;它支持的是特定硬體、模型和前端任務的觀察,不代表其他模型的速度或品質。詳情見 Castiel 的飛行中離線開發紀錄。
第三個獨立實作由 AI 安全研究者 Amine Raji 公開。他以 OpenCode、Ollama 的 Qwen3-Coder 30B 和 Discord 建立三階段流程:Architect 先列計畫,Executor 修改程式,Reviewer 檢查後才觸發提交,失敗最多重試三次。最初分開啟動代理時,各階段拿不到前一階段的脈絡,執行者會自行改寫計畫,審查者也看不到實際產物;改用共用 OpenCode server session 後,這類空回應停止。作者將簡單、範圍明確的任務列為較適合的用途,同時指出多檔複雜任務的審查結果可能只是樂觀判斷。這個概念驗證補足了另一個重點:本機模型能否落地,也取決於代理之間如何傳遞狀態及設定提交關卡,不能只看模型規格。可查閱 Raji 的 agent-forge 實作與限制說明。
這套流程的三個角色依序呼叫同一個模型,Reviewer 並非獨立模型或外部測試框架。Raji 也提醒,超過少數檔案的複雜任務,Reviewer 可能因上下文看不全而給出過度樂觀的通過判定。因此,自動提交前仍要把實際測試結果與人工抽查納入關卡;多代理分工能增加檢查節點,不能單憑角色名稱推定驗證彼此獨立。
三個案例各自測量的任務和環境不同,不能直接排出模型名次。要複製離線工作流,先預載依賴、停用不必要的連線工具,再用自己的任務記錄測試結果、修正時間與工具失敗。
這些差異可轉成三種驗收題:離線任務要檢查模型與依賴是否預載;長時間編輯要記錄推論延遲和電力限制;多代理流程則要確認共用脈絡、實際測試及人工提交關卡。分開記錄這些條件,才能看出結果受硬體、任務範圍還是代理協作方式影響。
二、三個元件怎麼接起來,整合關卡在哪裡?
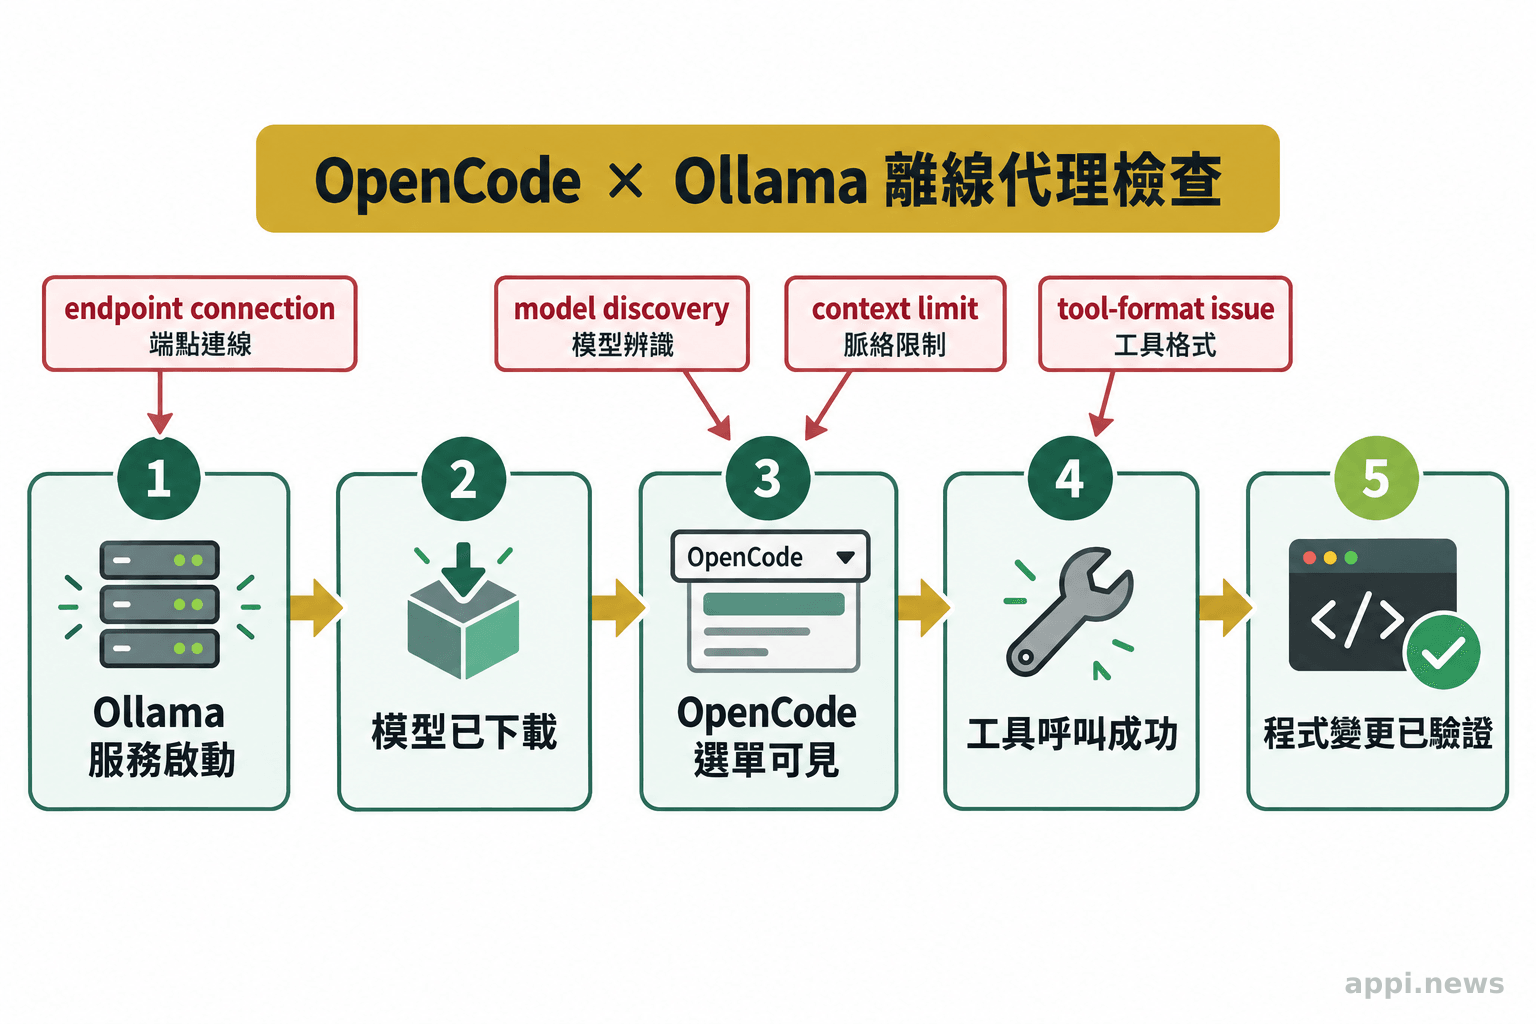
先讓 Ollama 載入模型,再確認 OpenCode 能辨識該模型並用它完成一次工具呼叫。服務可連線和代理能可靠工作是兩個不同檢查點。
OpenCode 官方 Providers 文件說明,啟動 Ollama 並下載模型後,OpenCode 會探測 http://127.0.0.1:11434,將符合 completion 能力的模型加入選單。遠端 Ollama 則須設定含 /v1 的 baseURL;欄位和模型名稱應依正在使用的版本確認。
測試時依序確認三件事:
- Ollama 已啟動,並下載指定模型。
- OpenCode 選單能找到該模型,提供者和名稱正確。
- 用不含敏感資料的專案,要求代理讀檔、小幅修改並執行驗證;檢查工具呼叫與變更結果。這是使用者驗收,不是官方效能測試。
卡關時分辨端點連線、模型探索、上下文超限或工具格式問題。OpenCode 的Providers 文件說明 Ollama 設定,Models 文件說明模型選取。
三、為什麼本機模型的程式表現會有落差?
不可以直接預測。參數量與上下文可篩選版本,程式代理表現還受量化、記憶體、工具呼叫和任務難度影響。
Ollama 的 Qwen3-Coder 模型庫列出 30B、480B 等版本,並標示 480B 本機執行至少需要 250GB 記憶體或統一記憶體。這是特定版本的規格,不能代表一般桌機可順暢執行;模型載入後還要為上下文、工具和作業系統留出記憶體。
量化會改變模型精度和資源需求;記憶體不足可能造成載入失敗、上下文縮短或降速。上下文大小也不保證能找對跨檔案依賴,工具格式不符則可能無法操作。
OpenCode 文件說明整合方式,Ollama 模型庫提供版本規格;兩者都不能代替在自己的程式庫與硬體上測試。可參考用 Microsoft Scope 建立可檢查任務固定任務和驗收條件。
“OpenCode probes http://127.0.0.1:11434, discovers completion models, and adds them to /models without an account connection.”(OpenCode 官方 Providers 文件)
這段只確認模型探索機制,不代表所有模型都支援相同工具呼叫。
「Running locally requires a minimum of 250GB of memory or unified memory.」(Ollama Qwen3-Coder 模型庫) 這項規格只說明 Qwen3-Coder 480B 的最低記憶體需求。
四、離線與雲端程式代理,適合哪些使用條件?
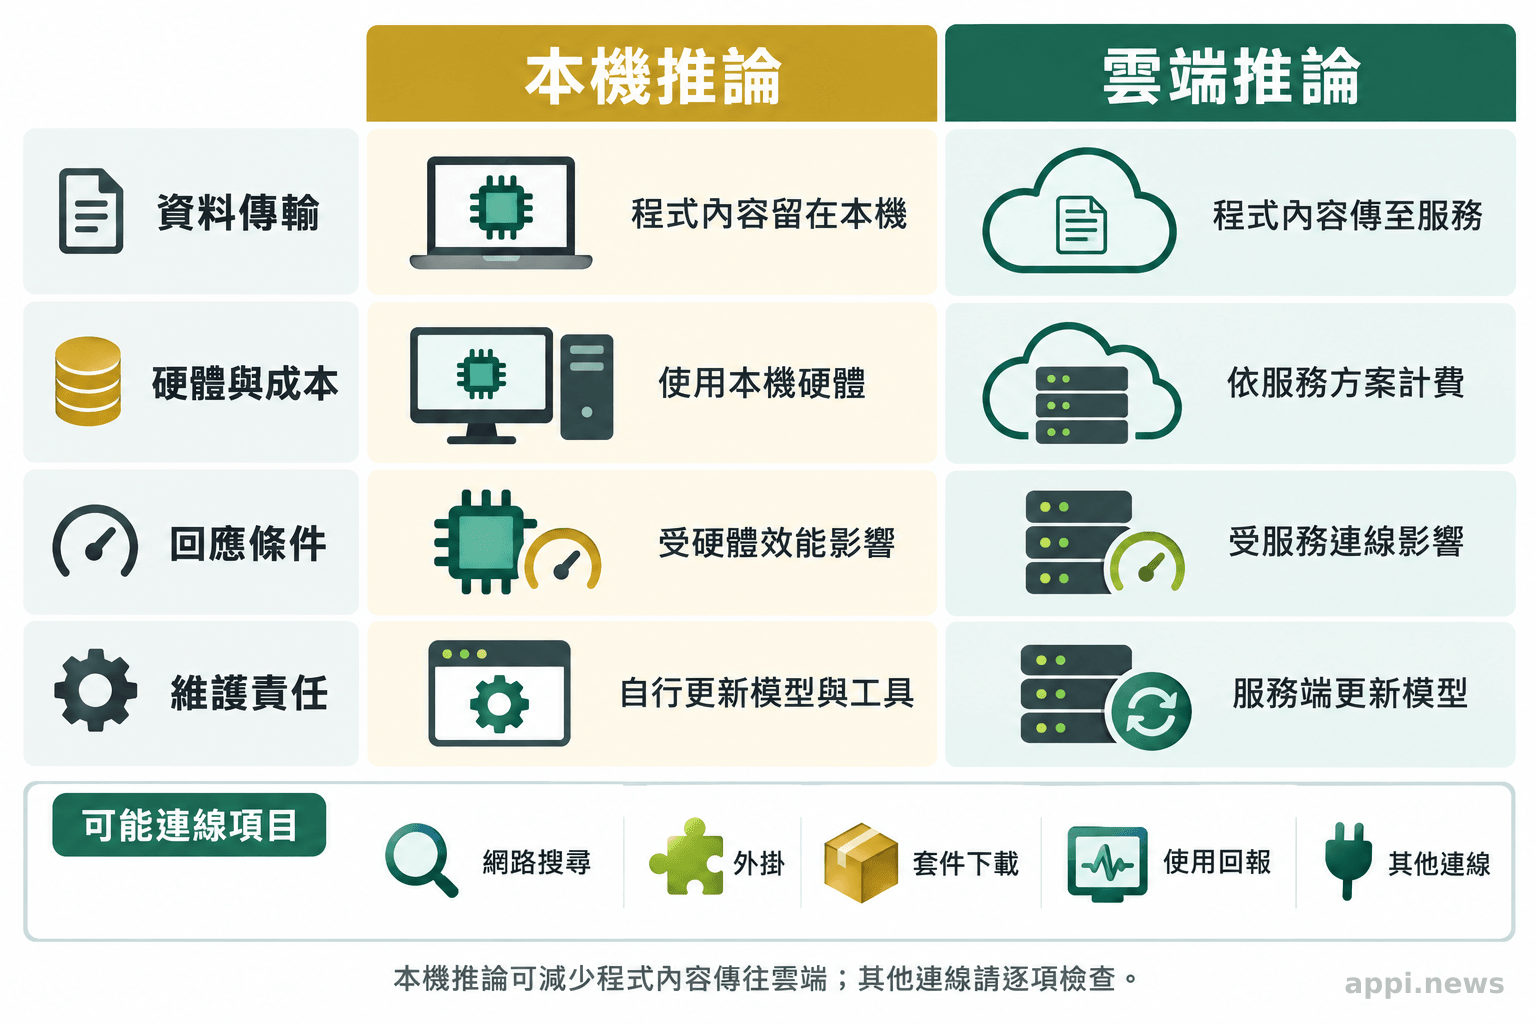
本機推論可減少程式內容送往雲端模型服務,但要逐項查看工具、外掛、遙測、套件下載和網路請求。
| 評估面向 | 本機離線方案 | 雲端方案 | 試作時要確認的問題 |
|---|---|---|---|
| 資料傳輸 | 模型請求可送到本機服務;其他功能仍可能連網 | 程式內容依服務設定送往供應商端點 | 代理是否呼叫搜尋、MCP、遙測或遠端 API? |
| 硬體成本 | 自行負擔記憶體、運算設備、儲存和耗電 | 由服務端提供運算,依方案或用量付費 | 現有設備能否穩定載入模型並保留足夠上下文? |
| 回應與能力 | 速度受硬體和模型版本影響;可離線使用的前提是依賴已備妥 | 取決於網路、服務狀態和可選模型 | 相同任務的等待時間、完成率和修正成本各是多少? |
| 維護責任 | 自行更新模型、檢查授權、管理設定和安全 | 供應商維護服務,使用者仍需管理權限與資料政策 | 模型授權是否符合個人或商業用途?更新後要不要重測? |
模型和依賴通常要先連網下載;之後安裝套件、查遠端 Git、呼叫 MCP 或搜尋,也可能把資料送出裝置。應檢查 Provider、工具與外掛,並在斷網下試跑。模型可下載不等於授權相同,商用前要核對版本條款。
五、如何用自己的專案驗證這套工作流?
挑幾種有代表性的任務,用固定驗收條件記錄成功率、人工修正時間、工具失敗、資源使用和資料流向。確認達到自己的門檻,再擴大到敏感或大型專案。
以下五步將來源中的實作轉成個人專案驗收;結果只適用於記錄的版本、硬體和任務。
- 選代表任務。用不含敏感資料的專案,挑單檔修改、多檔理解和需執行測試的工作。
- 記下環境。記錄 OpenCode、Ollama、模型版本、量化、上下文和硬體;比較雲端時固定提示與驗收條件。
- 檢查成果。記錄測試結果、人工修正時間、工具錯誤及變更範圍。
- 看資源與連線。記錄記憶體和耗時,檢查日誌、外掛與網路;斷網重跑以確認可用範圍。
- 設定門檻。先定義測試、修正時間和資料流要求;不符就調整模型或任務範圍後重測。
- 先斷網檢查工具、外掛和依賴,再以任務完成率、修正時間與資源使用判斷採用範圍。
常見問題
Q1:OpenCode 搭配 Ollama 一定完全離線嗎?
不一定。搜尋、MCP、外掛、更新和套件下載仍可能連網。先準備模型與依賴,再斷網執行代表性任務並檢查連線。
Q2:本機硬體不夠時,縮小模型就能解決嗎?
縮小模型可能降低資源需求,也可能改變推理和工具表現。量化、上下文與任務規模都要納入同一批任務測試。
Q3:Qwen 的模型規格能代表實際程式代理效果嗎?
不能。參數或上下文規格無法預測代理能否讀對檔案、呼叫工具並通過測試,須用自己的任務測量。
參考來源
- OpenCode. (n.d.). *Providers
- OpenCode. (n.d.). *Models
- Ollama. (n.d.). *qwen3-coder
- QwenLM. (n.d.). *Qwen3-Coder
- Latent Space. (n.d.). *Offline Coding
- Sebastien Castiel. (2025). *Seven Hours, Zero Internet, and Local AI Coding at 40,000 Feet
- Amine Raji. (2026). *Building a Local Multi-Agent Development System


