
手機代理已從研究基準測試(benchmark)走向產品預覽。Google 公布將為 Android Gemini 推出多步驟任務預覽,可協助叫車、重訂餐點,並讓使用者即時查看或中止;初期限定部分機型與指定 App。Google 的 Android 任務預覽
Google 的官方說明提醒使用者:「Supervise closely, interrupt when needed.」
另外,ZTE 表示努比亞 M153 搭載豆包助理,已在中國有限推出技術預覽版,可用語音指令跨 App 訂位、比價與規劃路線;Microsoft 的 UFO 開源專案則示範把 Android 真機或模擬器接入代理流程,由 Galaxy 協調跨裝置任務。ZTE/努比亞案例、Microsoft UFO 手機代理文件 這些案例呈現不同部署路徑,沒有共同測試結果可直接排名。選型團隊仍須驗證自己的 App、裝置與跨應用流程。
OpenMobile-2 的一項消融實驗提供能力評估線索:固定訓練資料量時,擴大應用種類後,未見應用的首次嘗試成功率(Pass@1)從 60.7% 升至 67.5%。這是特定研究條件下的觀察,不能直接當成產品成效。
固定資料量下,更多應用練習改善未見應用表現
在總量固定為 2,000 條模擬器軌跡時,訓練應用由 15 種增至 53 種,未見應用的首次嘗試成功率從 60.7% 升到 67.5%;熟悉應用則大致持平。
這項消融實驗固定模型骨幹、最佳化器與訓練資料總量,主要改變應用覆蓋範圍;15 種是熟悉應用,其餘用來擴展訓練場景。論文圖 5a 呈現未見應用結果,表 3 列出不同覆蓋設定。多樣化經驗可能有助遷移,但預印本仍在審查,不能視為通用規則。研究論文 PDF,圖 5a、表 3
OpenMobile-2 如何擴大訓練環境
手機代理(mobile agent)依指令讀取手機畫面並執行點擊、滑動、輸入等操作。真實商業 App 常涉及登入或不可逆操作,難以反覆重設,因此研究使用可控制環境訓練與評分。
OpenMobile-2 團隊以 MobileGym++ 建立可控制環境,重製 35 種商業風格 App,合計涵蓋逾 110 種應用。官方頁面列出 11.6K 條監督式微調(SFT)示範軌跡、2K 多個帶驗證器的強化學習(RL)任務,以及 300 多項工具。模擬 App 保留訂單、行程、購物車等狀態,可重設並由程式檢查任務結果。OpenMobile-2 官方專案頁
軌跡是代理觀察畫面、操作並接收回饋的連續記錄。研究團隊探索模擬器與 App 功能後,建立狀態和動作對照,再產生、執行及篩選任務。可重設的模擬器方便平行測試,卻無法完整呈現網路延遲、版本更新和真實服務例外。
60.7% 到 67.5% 的結果能說明什麼
這組結果提供一項研究線索,不能證明增加 App 種類就會提升所有代理,也不代表模型能可靠操作任何陌生 App。熟悉應用的首次嘗試成功率由 73.7% 到 71.4%,仍須連同任務數量、評測設計及模型設定解讀。
Yan 等人在預印本的消融實驗中,將固定資料預算下擴大應用覆蓋作為訓練條件,並觀察未見應用的遷移表現。
採用前仍要確認目標 App 的操作結構、資料風險與失敗接手機制。
模擬手機與真實裝置各自回答不同問題
不能直接畫上等號。模擬器適合控制條件、重複任務與檢查狀態;真實裝置測試則能補充裝置、App 和現場流程造成的差異。
AndroidWorld、MobileWorld 與 SPA-Bench 的測試差異
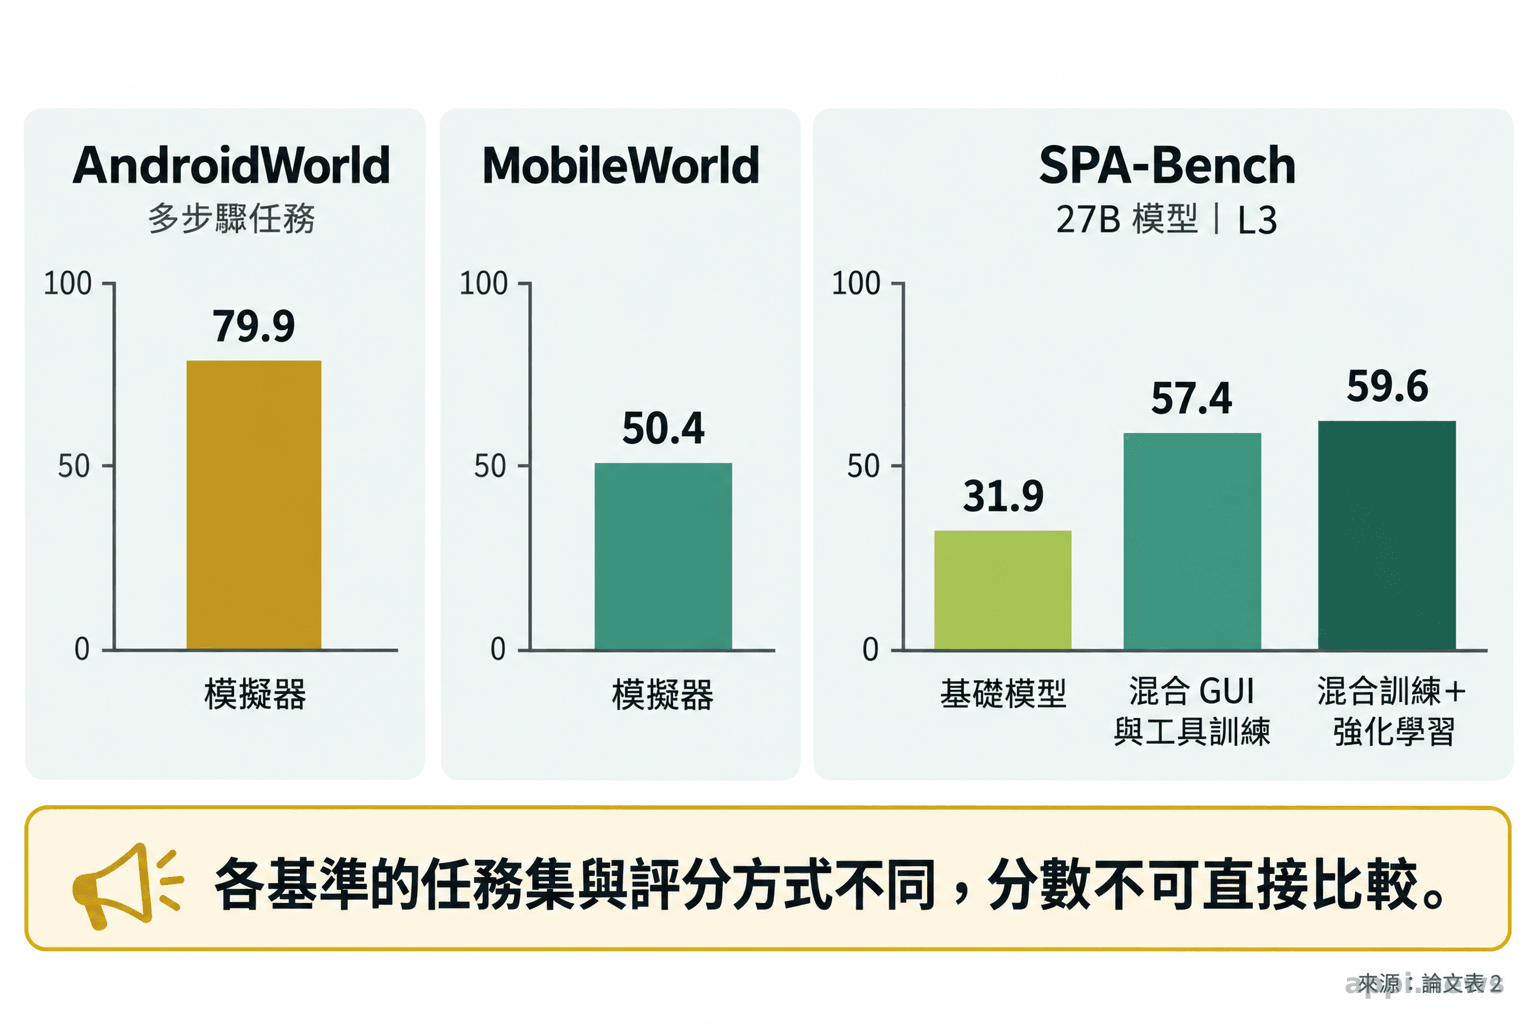
OpenMobile-2 的 27B 模型在 AndroidWorld 得 79.9 分、在 MobileWorld 得 50.4 分。兩者雖都以模擬器為主,App 範圍、任務與計分方式不同,分數不可互換,也不能代表產品完成率。
在 SPA-Bench 真實 Android 裝置測試中,27B 基礎模型的 L3 成績為 31.9;混合圖形介面(GUI)與工具操作訓練後為 57.4,再加強化學習後為 59.6。這些分數仍限於該基準與裝置設定。論文表 2 的基準與裝置測試結果
用跨 App 任務觀察操作鏈,而不只看單點成功
研究團隊另提出 MobileGym++ Bench,包含 215 個長流程任務,涵蓋 7 個商業領域,其中不少任務要求跨 App 傳遞資訊。例如先讀取記事中的採買清單,再將商品放入購物車;或查詢行程資訊後,透過通訊 App 傳送給指定聯絡人。每個任務以操作前後的業務狀態差異檢查是否完成,同一個任務也能比較只用圖形介面和混合工具的代理。
產品團隊可將任務拆成可核對的結果,例如預約是否存在、收件人是否正確、金額是否符合規則,並記錄失敗與恢復方式。
圖形介面(GUI)與 App 工具混用,效率仍取決於訓練方式
圖形介面(GUI)可操作畫面上可見的功能,但容易受介面變動影響;App 原生工具以結構化方式讀寫部分資料,功能範圍則受限。混用效果取決於代理能否選對操作方式。
OpenMobile-2 在 MobileGym++ 中為 50 多個 App 設計逾 300 個原生工具,與畫面操作共用狀態。論文將工具和 GUI 設計為可交錯使用的操作方式,例如先用工具搜尋商品,再以畫面確認選項。 論文中的設計讓 App 原生工具與圖形介面操作互補,並可依任務交錯執行。
兩種操作方式使用相同任務與狀態檢查,便於控制比較條件;這仍是研究環境中的探索性設計。
MobileGym++ Bench 的 27B 模型經混合訓練後成功率為 65.6%,高於 GUI-only 的 57.7%;再經強化學習後為 67.0%。單有工具不代表模型會善用,產品評估也須檢查權限、輸入驗證、操作紀錄與錯誤復原。
開源與專有方案的部署差異
開源代理可讓團隊依授權取得權重與訓練配方,自行安排部署和資料留存;算力、更新、監控與故障排除也由團隊負責。專有模型可透過服務介面接入,但須核對資料條款、可用區域、費率與遷移成本。
| 評估面向 | 開源代理 | 專有模型服務 |
|---|---|---|
| 控制程度 | 可依授權與資源自行部署、調整 | 依服務介面與供應商功能設定 |
| 初期整合 | 需建置推論、工具與監控環境 | 可先由 API 或平台介面試接 |
| 持續成本 | 算力、維運、人力與更新責任 | 使用費、服務條款與供應商依賴 |
| 資料治理 | 可設計本地處理,但需自行落實 | 需確認資料保留、使用與地區條款 |
開源權重不代表成本低或可自由商用;專有服務也須計入重試、人工覆核及中斷時的替代安排。
用自己的手機任務完成模型選型
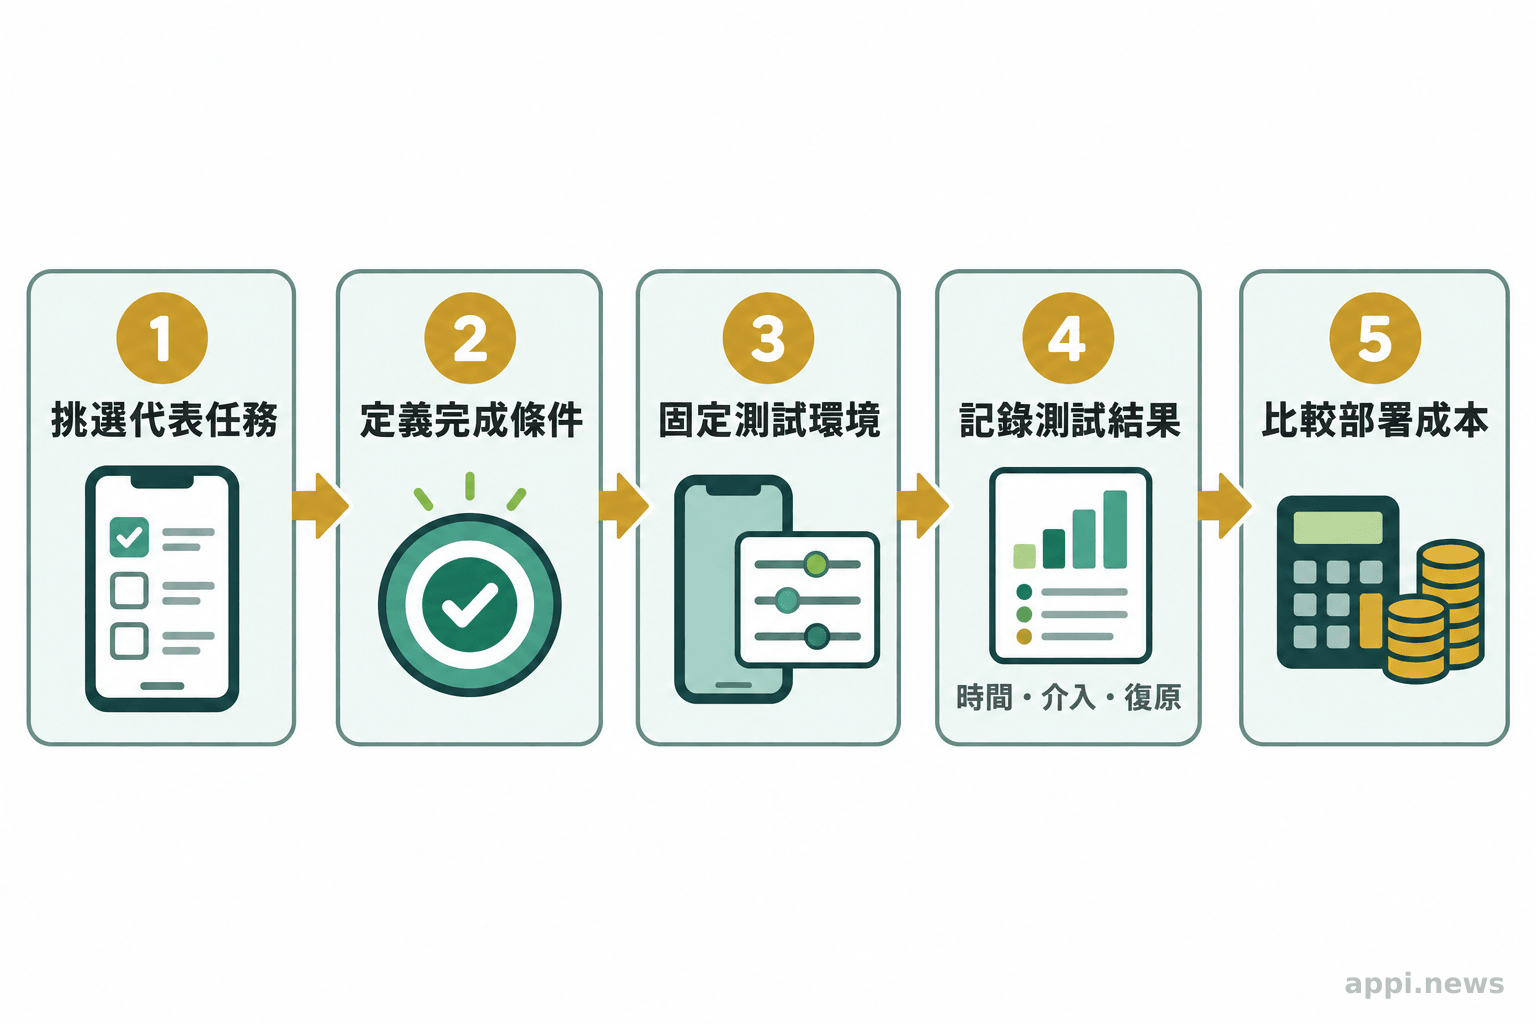
先用 5 至 10 個高頻流程建一組小型驗證集,在相同裝置、App 版本和初始狀態下測試,再比較任務成功、人工介入與部署維護成本。
五步建立可重複的比較方式
- 挑任務:選出日常高頻流程,至少包含單一 App 操作、跨 App 資訊傳遞,以及一項遇到錯誤後需要恢復的任務。
- 定義完成條件:寫明資料應出現在哪裡、數值與對象是否正確,以及哪些操作必須經人工確認。
- 固定測試條件:統一手機型號、作業系統、App 版本、登入狀態、網路與初始資料,避免把環境差異誤認為模型能力差異。
- 逐次記錄結果:追蹤完成率、操作步數、延遲、人工介入次數、錯誤類型,以及代理是否能在錯誤後回到安全狀態。
- 計算總體成本:把推論費用、算力、整合工時、維護、資安檢查、人工覆核及失敗補救一併列入,再比較開源、專有或混合架構。
各基準分數只反映其任務表現。企業驗證集還要確認代理能否安全完成流程、失敗時由誰接手、資料如何保護,以及介面改版後如何重測。
- OpenMobile-2 的 60.7% 至 67.5% 是固定 2,000 條軌跡下的特定消融實驗結果。
- 模擬器、基準測試與真實手機各有測試邊界,分數不能直接互換。
- 選型應以自己的高頻任務驗證成功率、錯誤恢復、人工介入與全程成本。
常見問題
Q1:開源手機代理已經追上專有模型了嗎?
OpenMobile-2 在特定基準中展現競爭力,但結果依賴模型大小、訓練方法、任務集與評測條件,不能概括為所有手機任務都已追平專有模型。
Q2:模擬 App 的成功率可以當成上線完成率嗎?
不宜直接採用。模擬環境利於重設與驗證,仍需在目標手機、App 版本、網路和實際流程測試,尤其要觀察失敗後的復原與人工接手。
Q3:選型一定要在開源和專有模型中二選一嗎?
不一定。可依資料敏感度、操作風險、延遲和維運能力分流,例如一般查詢使用模型服務,高風險確認保留人工,或把敏感流程留在可控環境。


