小米在 2026 年 9 月 22 日發布 MiMo-V2.6 系列。MiMo-V2.6-Pro 採稀疏混合專家(Mixture of Experts,MoE)架構,總參數約 1.02T,每個 token 約啟用 42B,支援文字、圖像、影片、音訊和最高 1M token 上下文。模型權重與部分訓練資源公開,讓企業有機會評估私有化部署。
然而,取得權重和在一台電腦上順暢執行是兩件事。判斷 MiMo-V2.6-Pro 是否值得本地部署,要看多 GPU 環境、穩定流量、資料留置要求,以及團隊能否承擔推論框架和供應鏈維運。多數台灣團隊應先用 API 建立任務基準,再測試 Flash 或蒸餾模型。
一、先給結論:開放權重不代表一般電腦能直接部署
MiMo-V2.6-Pro應視為多 GPU、分散式推論的評估項目,不宜把一般工作站當成預設部署環境。 API、Flash 或蒸餾模型較適合先驗證知識工作、程式代理和長文件處理。
本地部署包含下載權重、配置推論引擎、分配模型到 GPU、管理 KV cache(保存上下文的記憶體)、監控延遲與錯誤,還要維護版本和安全更新。MoE 讓每次計算只使用部分專家,42B代表啟用的計算量,不能直接拿來估算完整模型的儲存容量。
若每天只有少量請求,GPU閒置時仍會產生設備、電力、散熱和維運成本。資料不能離開內網且流量穩定,才有條件把控制權轉成部署價值。
二、MiMo-V2.6-Pro到底新在哪裡?
它把大規模 MoE、原生多模態、1M token 上下文,以及模型和部分訓練資源的開放放在同一個版本。 服務複雜度也隨之提高。
1.02T總參數與42B啟用參數
總參數是模型權重規模,啟用參數是每個 token 實際參與計算的部分。未被選取的專家仍可能需要保存,因而不能以 42B 推估整個模型的顯存。
1M上下文、圖像與音訊輸入
1M token 可用於長程式庫、長文件、工具紀錄和多輪代理任務,但會增加 KV cache。企業應測試繁體中文、PDF、影像、音訊及工具失敗後的恢復,不宜只看排行榜。
模型卡標示 MIT license,並提供 Hugging Face、ModelScope、vLLM 與 SGLang 入口。公開範圍應分開看:小米公告列出權重、技術報告、訓練環境與 RL 程式;Latent Space 指出,7,000 多項任務資料集未全部公開。MIT 僅代表模型卡所標示的授權範圍,權重、程式碼、資料集和商業服務仍須分別審查。
小米官方公告指出,MiMo-V2.6-Pro 與 Flash 的模型權重、技術報告、訓練環境及強化學習程式同步公開;企業仍須分別審查資料集、程式碼與服務條款。— Xiaomi MiMo 官方公告
三、本地部署的第一個門檻:GPU記憶體與分散式架構
只能先做容量估算,不能用 42B 啟用參數直接回答;1.02T 權重、量化格式、KV cache、批次與多模態元件都會改變結果。 實際需求要用指定推論引擎和目標上下文壓力測試。
| 權重格式 | 1.02T參數的理論權重容量 | 判斷 |
|---|---|---|
| BF16/FP16 | 約 2.04 TB | 還未計入緩衝與 KV cache,單機工作站難以容納 |
| FP8/8bit | 約 1.02 TB | 容量下降,仍須多 GPU 與平行化 |
| 4bit | 約 0.51 TB | 只是位元數下限,還要驗證量化誤差與速度 |
官方模型卡的 SGLang 範例包含 16 路張量平行、專家平行與兩個節點;vLLM 範例使用 8 路張量平行,並要求 trust-remote-code。這些命令顯示部署已進入多 GPU 服務工程。V2.5 對照資料: vLLM 食譜列出 4 張 H200,但這是 V2.5 配置,不能當成 V2.6-Pro 的保證需求。
MoE 的專家分配、張量平行和資料平行會讓 GPU 交換資料,網路與故障恢復都可能改變吞吐量和尾端延遲。
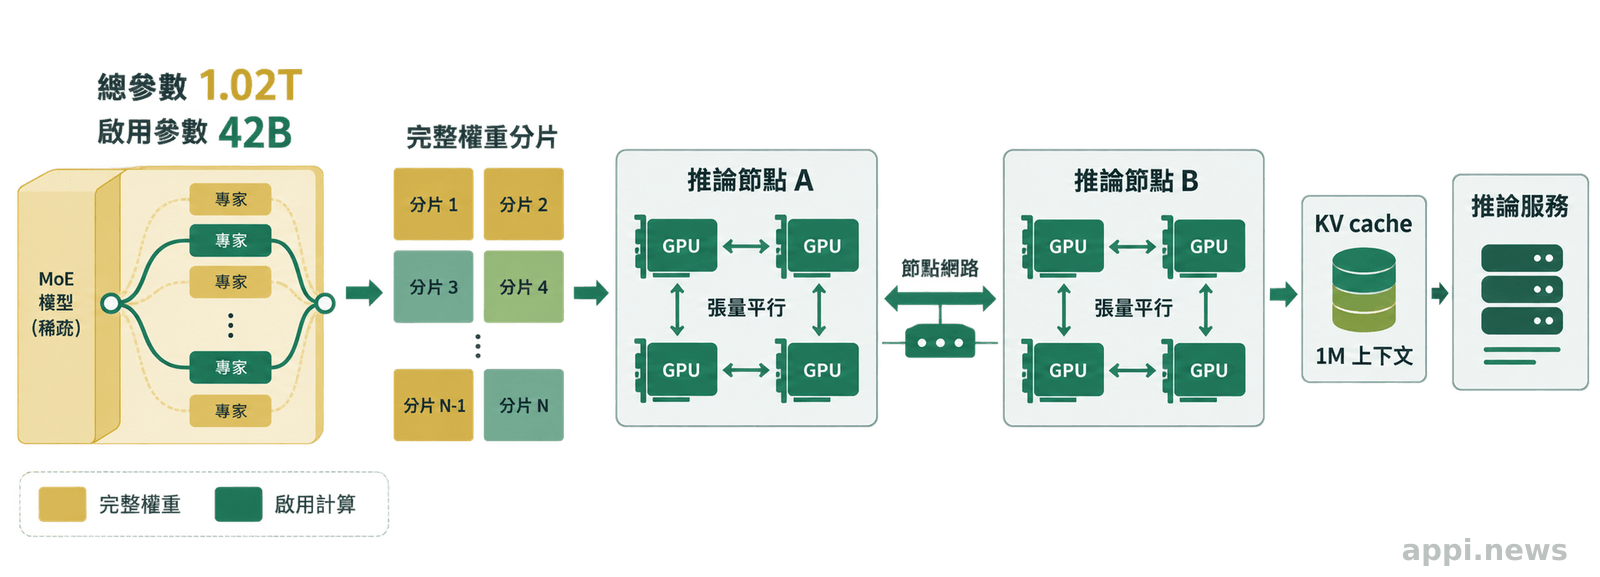
官方模型卡列出 16 路張量平行、兩個節點和工具呼叫解析器;這說明實務難點包含分散式推論與服務調校。— Xiaomi MiMo 模型卡
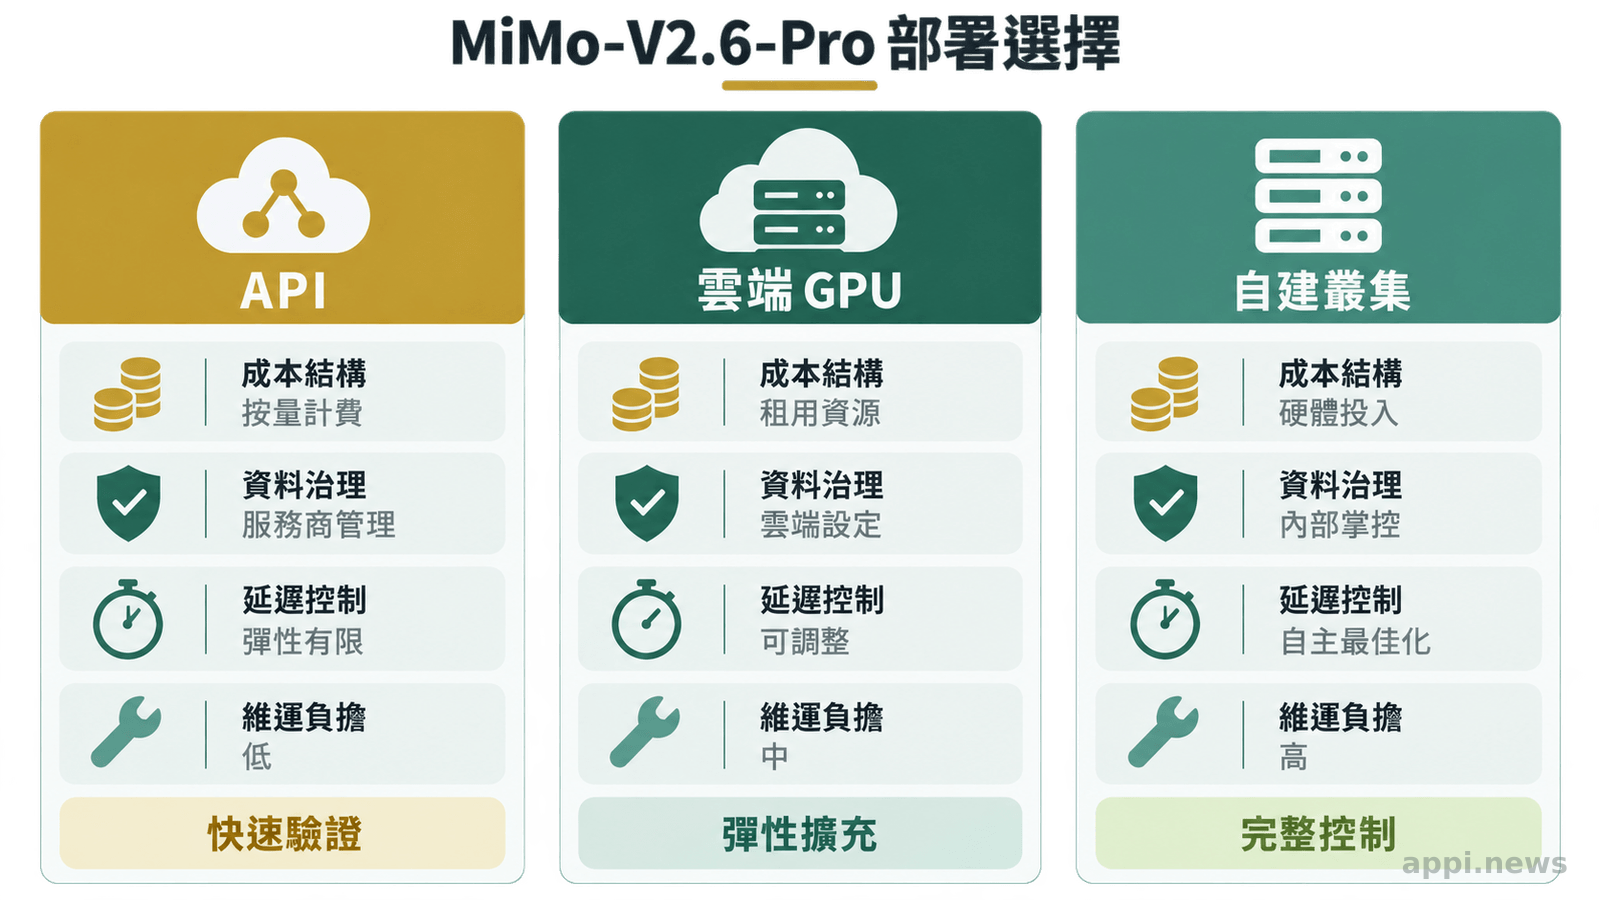
四、本地部署真的比較省嗎?API、雲端與自建成本比較
本地部署是否划算取決於實際用量與治理要求,不能只看公開報價。 計算時要把硬體、電力、網路、人力與故障時間放在同一張表。
Latent Space 的公開整理列出每 1M input token 約 0.435 美元、每 1M output token 約 0.87 美元。每月 1,000 萬 input、200 萬 output token 的試算約為 6.09 美元,這不是報價,仍須查核平台、長上下文加價、快取規則和台灣付款方式。
小米公告稱 V2.6 沿用 V2.5 API 價格,並提供 Pro、Flash 與 UltraSpeed 入口。價格和版本可能變動,採購紀錄應寫明查核日期、模型代號與 token 定義。
| 路徑 | 成本結構 | 資料治理 | 維運負擔 | 適合情境 |
|---|---|---|---|---|
| API | 低固定成本,依用量計費 | 審查留存、日誌、跨境與條款 | 低至中 | PoC、流量不穩 |
| 雲端租GPU | GPU時數、儲存與網路 | 可選區域,仍要管理權限 | 中至高 | 短期高峰、已有雲端團隊 |
| 自建叢集 | GPU、機房、電力、備援與人力 | 控制力高,責任也集中 | 高 | 穩定高流量、內網資料 |
自建應以一年期總持有成本除以有效 token,納入硬體折舊、冷卻、備品、軟體維護和值班人力;只比較 API 帳單和 GPU 採購價,會漏掉空閒容量與治理成本。
五、企業導入要注意的整合與風險
整合責任通常比模型下載更容易出問題:工具呼叫、結構化輸出、資料權限、日誌、版本鎖定與錯誤回復都要先定義。 能完成任務,不代表能安全交付。
測試應包括 JSON schema 穩定性、中文欄位、函式參數、工具重試、長文件切分與版本升級差異。監控至少記錄首 token 延遲、吞吐、錯誤率、任務成本和 GPU 使用率,避免只看平均速度而漏掉尾端延遲。
使用 trust-remote-code、第三方容器或自訂推論程式前,應做供應鏈與權限審查;資料留在本地仍可能有內部濫用或工具外傳風險,需設定日誌留存、索引權限、憑證隔離與回滾流程。
繁體中文和台灣情境測試,應使用去識別化文件、PDF、程式庫和錯誤紀錄,再以同一批任務比較 API、Pro、Flash 與蒸餾模型的品質、延遲、錯誤率、token、GPU利用率和人工時間。
六、哪些團隊適合追蹤、試用或暫緩部署?
有明確任務、可量測結果,且需要長上下文或多模態能力的團隊適合先試用;穩定流量、內網留置要求與平台人力同時具備,才適合評估自建。 模型參數規模本身不足以啟動採購。
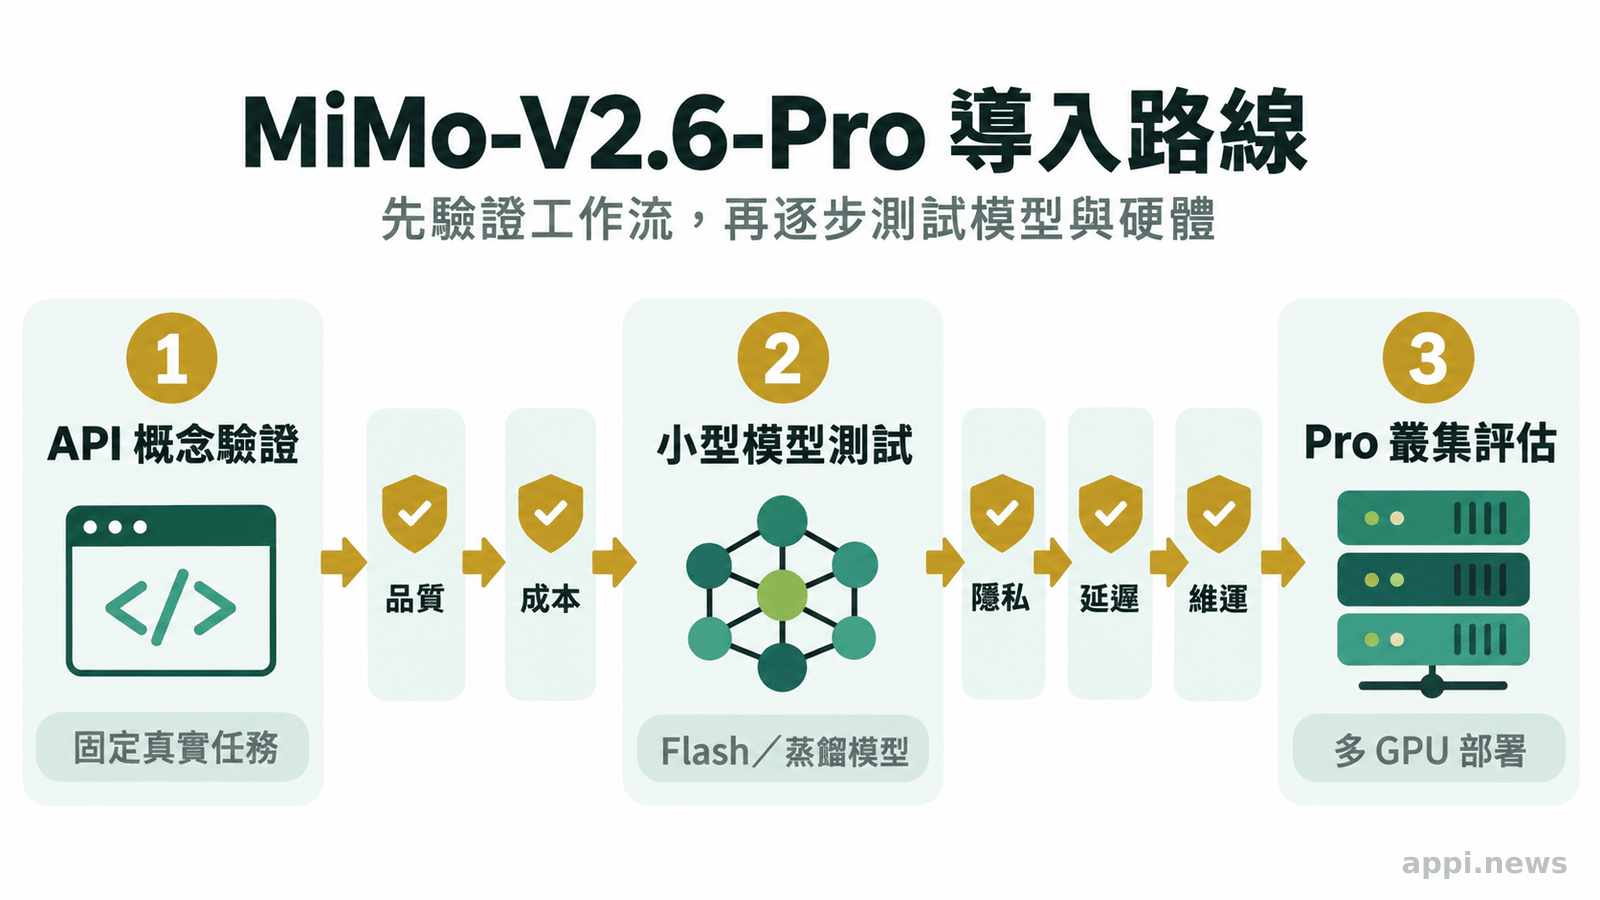
API適合用來驗證企業問答、程式代理、文件整理、視覺檢查和長流程自動化。測試應記錄輸入、輸出、工具動作、人工覆核和失敗原因,讓 API 結果成為後續硬體估算的基準。
若資料必須留在內部、流量足以填滿 GPU,且團隊具備容器、網路、權限、監控和事件回應能力,才值得把 Pro 納入叢集評估。個人開發者可先用 API、Flash 或 MiMo-V2.6-Distill-Qwen-9B,再考慮租用多 GPU 環境。
- 用 20 至 50 個去識別化真實任務固定成功標準。
- 以 API、Flash 或蒸餾模型記錄品質、token、延遲、工具錯誤與人工時間。
- 再用目標量化版本測試 Pro 的顯存、併發、長上下文和故障恢復。
- 分開審查權重、程式、資料與商業條款,完成治理和回滾設計後才決定自建。
七、結論:先驗證工作流,再決定是否買叢集
MiMo-V2.6-Pro值得追蹤與小規模驗證,完成工作流、流量和治理測試後,再決定是否本地部署。 開放權重帶來客製化與資料控制入口,1.02T MoE、1M上下文和多模態能力也提高硬體與整合門檻。
小米公布的訓練成本,說明強化學習工程能以集中投入換取能力提升,卻不能回答使用者要買幾張 GPU、每月耗多少電或維運人力是否足夠。真正的成本比較,應以任務量、有效吞吐、資料風險和可接受延遲為單位。
截至 2026 年 9 月 22 日,獨立長期實測、不同硬體吞吐量、繁體中文企業任務表現與完整總持有成本資料仍有限。版本、價格、量化格式和部署工具可能快速變動,測試與採購紀錄應寫明查核日期。
- 1.02T是總參數,42B是每 token 約啟用的參數,不能直接等同 GPU 顯存需求。
- 本地部署的門檻包括權重容量、KV cache、多 GPU 平行、節點網路和推論維運。
- API、Flash、蒸餾模型和 Pro 叢集應用同一組真實任務比較,才足以做成本決策。
常見問題
先確認實際任務、資料治理要求和每月 token 用量,再確認模型版本、硬體與價格。
常見問題
Q1: MiMo-V2.6-Pro是完整開源模型嗎?
較精確的說法是開放權重,並同步公開技術報告、訓練環境與部分 RL 資源。模型卡標示 MIT,但權重、程式碼、資料集和商業服務仍應分別閱讀條款。
Q2: 42B啟用參數是否代表只需要42B模型的顯存?
不代表。42B描述每個 token 的啟用計算量,服務仍可能載入大量總權重,還要加上量化資料、KV cache、執行緩衝和多模態元件。
Q3: 1M上下文是不是部署時應直接開啟?
不是。1M是支援上限,實際設定要依 GPU 顯存、請求數、KV cache 和延遲要求決定。多數任務應先用較短上下文測量品質與成本。
Q4: API和本地部署怎麼選?
流量不穩或仍在找產品方向時,API適合快速驗證;資料必須留在內部且已有平台團隊時,才值得比較雲端租用與自建叢集。
Q5: 個人開發者要怎麼開始?
先用 API 或較小的 Flash、蒸餾模型跑固定任務,記錄成功率、延遲和 token 用量。確認 Pro 的能力差距能帶來價值後,再考慮租用多 GPU 環境。
參考來源
- Xiaomi MiMo (2026). Xiaomi MiMo Home. *Xiaomi MiMo 官方文件頁*。[官方頁面]()
- Xiaomi MiMo Team (2026). XiaomiMiMo/MiMo-V2.6-Pro-RL · Hugging Face. *Hugging Face model card*。[模型卡]()
- vLLM Recipes (2026). XiaomiMiMo/MiMo-V2.5 | vLLM Recipes. *vLLM 官方部署食譜*。[部署食譜]()
- Latent Space AINews (2026). [AINews] Xiaomi MiMo-V2.6-Pro 1T-A42B: the new top Open Weights model, trained for $3M. *獨立整理*。[獨立整理]()