
很多人第一個會先想到,AI 代理回答得不夠好、步驟做錯了,答案就是換更強的模型,或者重新訓練。接著可以先釐清:出錯的是模型本身,還是包在模型外面的提示詞、工具設定、記憶與執行流程?Google 研究人員與西北大學研究者提出 Harness² 論文並公開程式碼;GitHub 專案頁註明這不是 Google 官方支援產品。研究設計以模型權重維持不變為前提,調整模型執行時依附的「代理執行框架」(harness,泛指系統提示、工具說明、記憶、腳本等周邊設定)。
一、AI 代理表現不佳,問題一定出在模型權重嗎?
不一定。 Harness² 的核心主張是,許多錯誤可從模型外圍的執行設定著手排查;調整這層設定與重新訓練分屬不同層次的工作。
模型能力與代理執行框架分別負責什麼
模型權重決定底層的語言與推理能力,改動牽涉大規模訓練資源,通常不會只因單次任務失敗就調整。代理執行框架則是模型實際上線時依附的環境:系統提示怎麼下指令、有哪些工具可以呼叫、遇到風險時的護欄怎麼設、過去任務的記憶要不要帶進來、遇到特定領域知識時要參考哪份腳本或子代理。這一層的改動成本低得多,而且可以針對單一任務或單一客戶快速調整。
哪些錯誤可能透過提示、工具或流程調整改善
論文把 harness 拆成八個可編輯元件:系統提示、護欄、記憶、工具指引、子代理、技能、腳本與外掛(plugins),各元件以檔案形式掛載在執行環境中。先找原因,再談方法:如果代理在某個領域反覆漏看一個步驟,原因常常出在系統提示沒把那個步驟講清楚,或工具指引沒提供足夠的上下文,模型本身未必不懂。遇到這類問題,可先嘗試調整提示或工具說明,再用任務測試確認是否改善,暫不必改動模型。

二、Harness² 如何把 AI 代理的任務經驗變成設定修訂?
它用一個叫 Propose-Probe-Compose 的對比流程,在沒有標準答案可比對的情況下,靠行為對比來判斷一項修改是否值得採用,再把有證據支持的修改沉澱成可重複使用的經驗。
Propose–Probe–Compose 如何比較行為差異
這個流程先取得一次參考執行,再提出兩種候選修改:一種針對可能跨領域重複出現的代理能力缺陷,另一種針對當前領域特有的知識與限制。接著在相同任務、相同模型與環境設定下,分別執行每個候選版本,把產出與參考執行比較,形成行為上的對比,藉此判斷這項編輯是緩解了問題,還是造成了退化。最後一步讀取參考執行、各候選版本與目前設定之間的差異,連同任務內所有的執行證據,決定是否合併、修正、採用某個候選,或者保留原本的設定。
任務層調整如何連到後續任務的經驗整理
論文把遞迴分成兩層:任務層的遞迴只針對眼前這個任務精煉當下的執行框架,整個任務執行期間,拿來做改進決策的框架維持固定,不會邊做邊換;任務結束後,才透過另一層機制把這次採用的設定與背後的證據,寫進一份持續累積的經驗記錄,提供給下一個任務參考。這跟代理本身的對話記憶是兩回事,代理記憶通常只服務單次對話,這裡累積的是跨任務、經過驗證的設定調整經驗。
研究團隊在論文中說明 Probe 階段本身的侷限:若缺少地面真值可供驗證,精煉只能依靠行為對比與模型自身的判斷,而執行過程中的隨機性與模型之間共有的偏誤,都會限制這類證據的可靠性。這也是作者不把 Harness² 包裝成能保證代理持續變好的原因。
三、不改權重可能省下哪些成本,還有哪些成本留下?
調整執行框架可省下大規模訓練資源;推論呼叫、候選測試、審核與維護仍有開銷。是否能降低特定流程的總成本,需依推論、測試、整合與維護成本實測。
調整外圍設定與重新訓練的適用情境
兩種做法要解決的問題不一樣,適用情境也不一樣:
| 比較項目 | 調整代理執行框架(Harness 編輯) | 重新訓練或微調模型權重 |
|---|---|---|
| 修改對象 | 提示、工具說明、記憶、腳本等外圍設定 | 模型內部參數 |
| 資源需求 | 推論呼叫、候選測試、人工或模型審核 | 大量運算資源、標註資料、訓練時間 |
| 影響範圍 | 可先針對單一任務或單一代理調整 | 通常影響模型在所有任務上的行為 |
| 可回復性 | 對照版本差異即可退回前一版設定 | 需保留舊權重快照或重新訓練才能回復 |
| 較適合的情境 | 任務特定的流程、知識或限制需要快速調整 | 模型本身在廣泛任務上的基礎能力需要提升 |
推論、評估、整合與維護成本仍須計入
論文作者在附錄明確點出:遞迴精煉需要額外的執行與編輯過程,提高允許反覆嘗試與比較的次數上限(遞迴預算,即系統可以探索的寬度或步數),雖然能帶來更大的改善幅度,同時也會增加額外的推論成本(也就是每次呼叫模型要付出的運算與費用);用平行方式執行可以降低等待時間,但不會讓這筆運算憑空消失。除此之外,每次候選修改都要經過測試與審核,長期下來還有設定檔案與經驗記錄的維護負擔,這些都要算進總成本,不能只看「沒有重訓」這一項。

四、研究基準的改善幅度,能否代表實際部署穩定?
不能直接套用。 論文在其測試模型與基準任務中報告了改善結果,但這些數字綁定在特定的模型、任務與評估設計上,不代表所有模型或所有企業流程導入後都會有相同幅度的進步。
論文測試的模型、任務與證據範圍
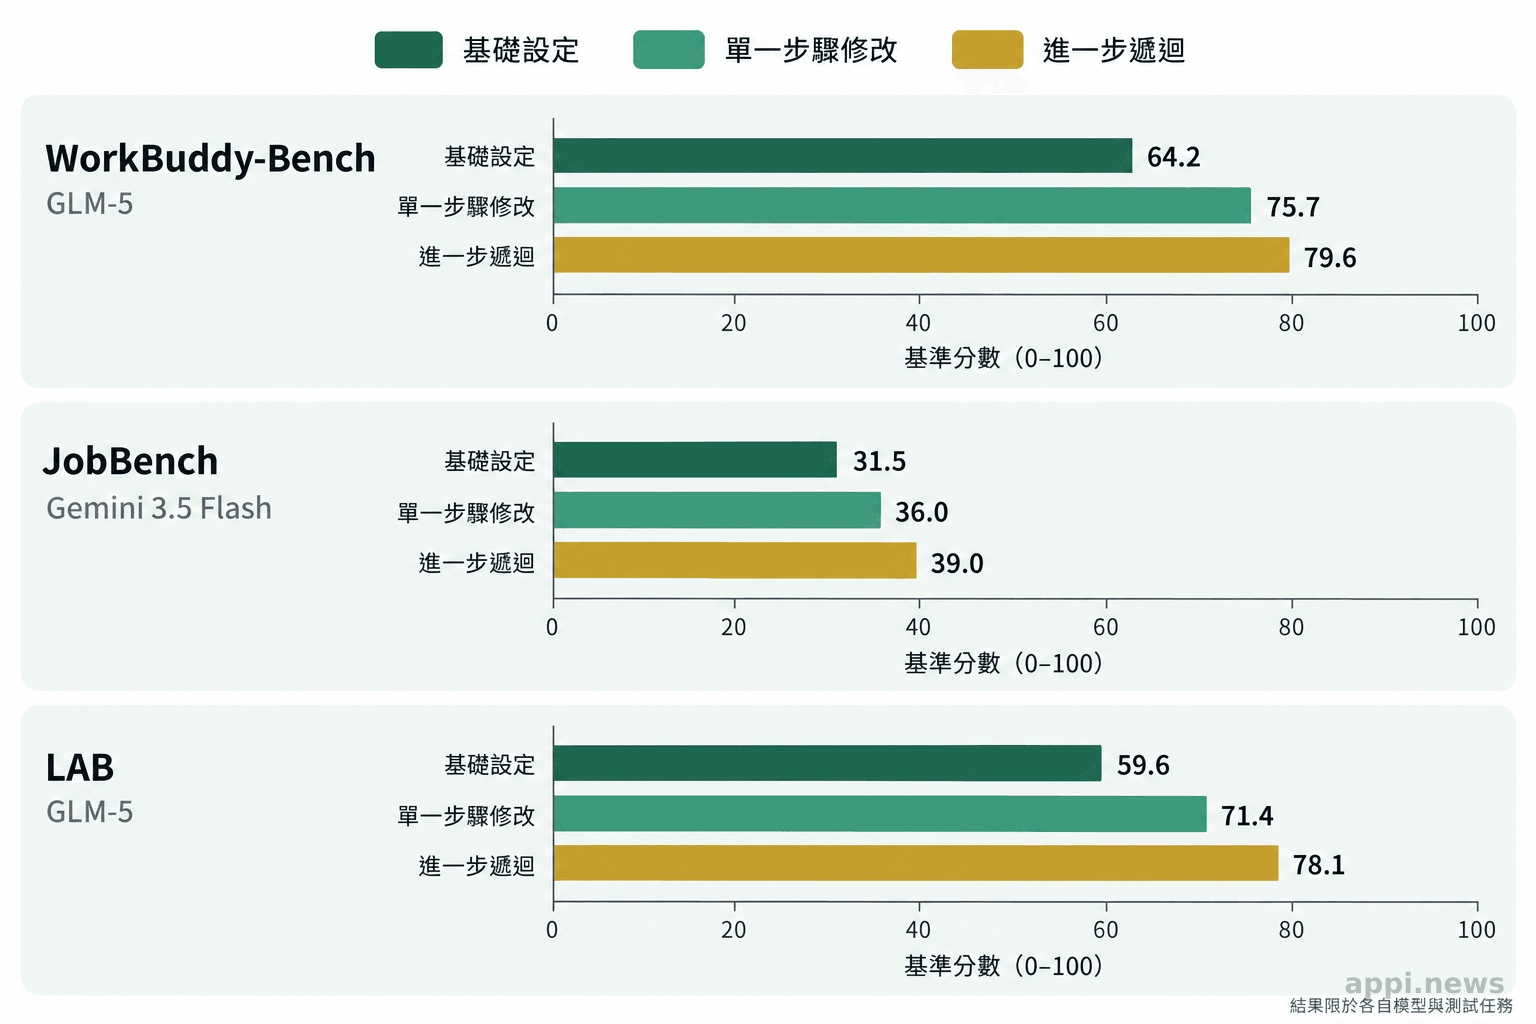
實驗涵蓋 GLM-5 與 Gemini 3.5 Flash 兩個模型,搭配三個偏向專業場景的基準測試:WorkBuddy-Bench、JobBench,以及取自 Harvey 法律代理基準的 LAB。作者報告,單一步驟的修改就能讓兩個模型穩定優於各自的基礎設定,其中 GLM-5 在 WorkBuddy-Bench 上從 64.2 分提升到 75.7 分,加上進一步的平行遞迴後再提升到 79.6 分;Gemini 3.5 Flash 在 JobBench 上從 31.5 分提升到 36.0 分,加上遞迴後再提升到 39.0 分;GLM-5 在 LAB 上從 59.6 分提升到 71.4 分,加上遞迴後再提升到 78.1 分。增幅會隨著遞迴預算增加而擴大,但這些都是特定模型與特定基準下的數字,不代表其他模型、其他任務也會得到同樣幅度的改善。
累積經驗也可能帶來錯誤擴散與行為退化
作者在論文附錄坦言,目前只驗證了有限的預算範圍,並沒有確立一套放諸所有任務皆準的最佳配置;精煉過程仰賴行為對比與模型判斷,缺少地面真值驗證,因此這些訊號無法保證結果一定正確,也無法確認某項被採用的修改一定能轉移到不同任務。累積經驗若缺乏嚴謹驗收,一次判斷錯誤的修改可能被留在經驗記錄裡,持續影響後續任務。
五、導入代理經驗調整前,如何設計驗收流程?
先建立一組可重複執行的基準任務與對照組,再把風險分層,讓高影響操作接受更嚴格的審核,並由驗收流程判定修改是否改善。
建立基準組、任務分層與回歸測試
代理修改提示、記憶、工具或腳本,可能改變後續的輸出與操作,採用前必須檢視變更差異,並保留可回復的版本。具體可以從以下幾項著手:
- 建立一組可重複執行的基準任務與對照組,固定模型與環境設定,專門用來比較修改前後的行為差異。
- 按任務難度與風險分層,對涉及敏感資料或外部寫入的高影響操作,設定比一般任務更嚴格的驗收門檻。
- 保留每次採用的設定版本與對應的執行證據,確保出問題時能快速回復到前一版本。
- 若代理可能接觸敏感資料或執行高影響操作,限制其權限範圍,記錄每一次存取與動作,並設置人工覆核與停止機制。
- 追蹤推論呼叫、候選測試與基準評估帶來的總成本與失敗率,不要只看單一任務是否通過。
- 定期用代理沒見過的新任務重新測試,避免只在原本的基準上表現變好,實際任務卻悄悄退化。
設定審核、版本追蹤、回復與權限界線
代理經驗可以作為後續調整的線索,但仍須經過任務驗收與人工治理,不能把它當成已經定案的標準。版本追蹤與權限界線是兩個最容易被忽略的環節:前者決定出問題時能不能快速退回,後者決定一次誤判的修改會不會擴散到不該碰的資料或操作範圍。
- Harness² 保持模型權重不變,調整模型外圍的執行框架,兩者屬於不同層次的工作
- 論文報告在 GLM-5 與 Gemini 3.5 Flash 上,於特定基準測試中有實質改善,但樣本與任務範圍有限
- 省下重訓成本,不代表沒有成本,推論、測試、審核與維護的開銷仍要計入
- 導入前要先有可重複的基準、分層的風險門檻與可回復的版本紀錄
六、常見問題:代理記憶、模型微調與 Harness² 有何不同?
代理記憶多是單次對話內的暫存資訊,模型微調是直接改動模型權重,Harness² 則是在權重不變的前提下,持續調整並保留跨任務、經過驗證的執行設定。
常見問題
Q1: Harness² 算是一種新的模型訓練方法嗎?
Harness² 調整模型執行時依附的提示、工具、記憶等外圍設定,模型本身的權重全程維持不變,因此與訓練或微調分屬不同層次。
Q2: 這套機制會不會讓代理自己判斷對錯,不需要人工把關?
不會,也不建議這樣用。論文作者也說明,精煉過程依靠行為對比與模型自身的判斷,缺乏地面真值驗證,公開實驗結果不等同於實際部署的穩定性保證,仍需要人工覆核與明確的驗收機制。
Q3: 不用重新訓練,是否代表幾乎沒有成本?
省下的是大規模訓練資源;推論呼叫、候選測試、審核與長期維護仍有成本,需要在小範圍試行時一併追蹤。
Q4: 企業如果想評估導入,可以先從哪裡開始?
可以先從一組可重複的任務基準與明確的回復條件開始,確認修改前後的行為差異可被量化,再逐步擴大到更高風險的任務。


