AI代理的原型常只需要模型和幾個工具,進入實際運作後,工作量會轉移到工具呼叫、記憶、工作階段、上下文管理、重試與觀測。AWS開源的 Strands Harness,主打把這些零件預先組合,讓開發者用一行 Python 或 TypeScript 建立可執行的代理。
一、Strands Harness是什麼?從自行拼裝代理迴圈到預配置執行框架
Strands Harness是一套預先配置的通用 AI 代理執行框架(agent harness,以下簡稱 harness),把工具、工作階段、記憶、上下文管理與提示快取放進可覆寫的預設值。
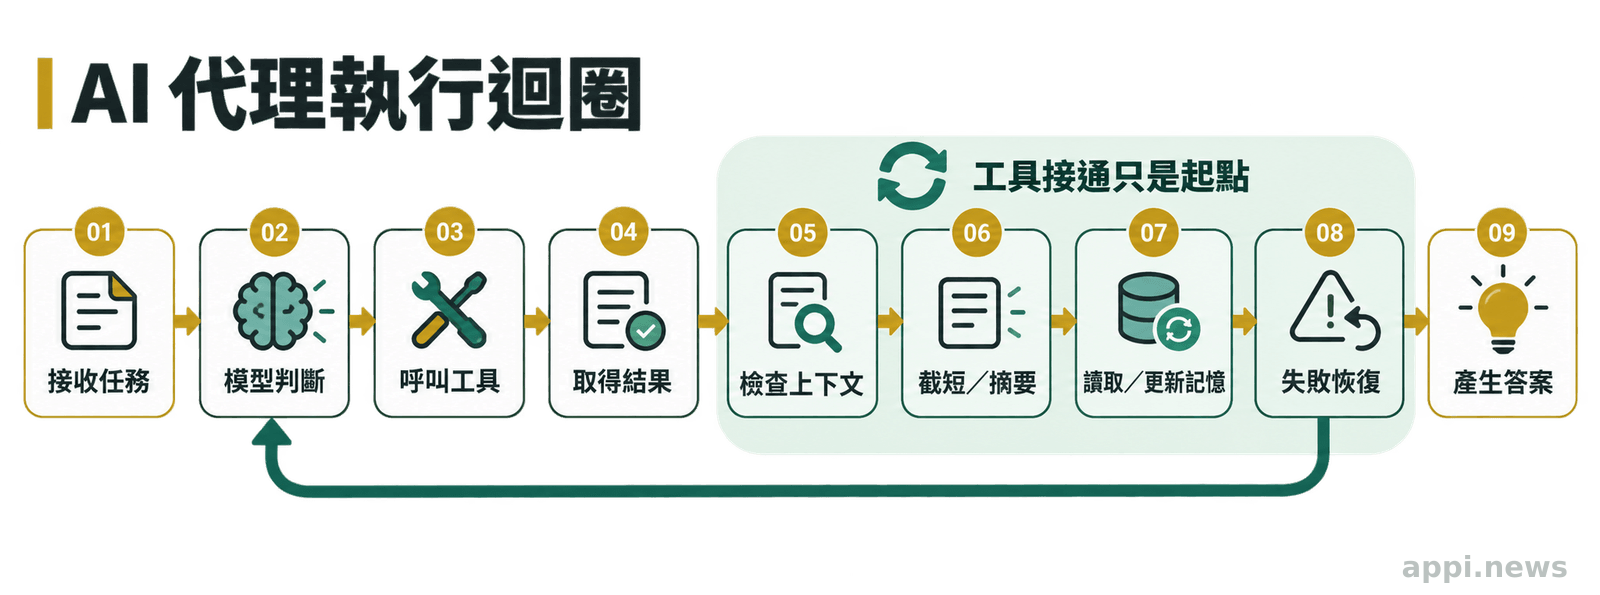
AI代理(能依目標反覆呼叫工具、保留狀態並完成多步驟任務的軟體)需要執行迴圈,讓模型讀取任務、呼叫工具、接收結果,再決定下一步。自行組裝時,工具錯誤、上下文過長、工作中斷和多輪記憶都要分別設計。
依 2026 年 9 月 22 日查閱的 Strands Harness 官方文件,目前預設包含命令列、檔案、網頁工具、長期記憶、工作階段、輔助代理、工作清單與可載入的技能模組(Skills),並支援 Amazon Bedrock、Anthropic、OpenAI、Google、Ollama 和 LiteLLM,也能部署在 Linux 容器;這些細節可能隨版本或設定調整。
Strands Harness、SDK與AgentCore的差異
Strands Harness 建立在 Strands Harness SDK 之上:前者提供調校過的整套配置,後者讓團隊自行掌握代理迴圈、工具、模型、記憶、工作階段和 hooks。記憶與工作階段要分開測試,因為兩者涉及不同的恢復、保存期限與隔離要求。
| 選項 | 產品型態 | 部署責任 | 控制範圍 | 適合情境 |
|---|---|---|---|---|
| Strands Harness | 開源的預配置執行框架 | 團隊負責部署與維運 | 預配置工具、記憶、上下文與工作階段 | 快速建立通用代理,保留跨模型彈性 |
| Strands Harness SDK | 開源 SDK | 團隊負責迴圈、部署與維運 | 自行組裝迴圈、工具、模型與 hooks | 需要深入控制重試、流程與觀測 |
| AgentCore managed harness | AWS 受管能力 | AWS 受管執行層;團隊負責設定與治理 | AWS 設定、執行、隔離、身分與觀測 | 已採用 AWS,重視受管部署 |
二、它解決了 AI代理的哪些工程問題
它主要減少重複接線與上下文維護工作,讓團隊把時間放在任務流程、工具權限和結果驗證。 權限、沙盒、資料隔離與可觀測性仍需自行設計。
手動組裝代理時,要處理工具 schema、回傳格式、迴圈限制、工作階段、失敗恢復與每一步的紀錄。Strands Harness 把常見的命令列、檔案和網頁操作做成預設工具,降低原型的起始工程量。
上下文視窗是模型一次能讀取的文字範圍。依 2026 年 9 月 22 日查閱的官方文件,Strands Harness 目前預設會在工具結果超過約 1,500 詞元時截短,視窗使用量高於 85% 時摘要較早內容,遇到溢位時嘗試恢復;這些門檻可能隨版本或設定改變。
這些機制可能減少重複輸入,仍須以完成率、引用正確性與失敗恢復測試確認,因摘要、截短與記憶都可能影響判斷。
Strands Agents 官方 GitHub 專案說明,SDK 提供上下文管理、執行限制、可觀測性與 hooks 等能力,也保留後端與代理迴圈的調整空間。
三、詞元成本真的能降低嗎?先看 AWS 官方基準測試
28%是 Strands 團隊在特定條件下公布的六項 benchmark(以固定任務比較成本與完成品質的基準測試)結果,適合當成導入測試假設,不宜視為所有 AI代理都能得到的折扣。
官方自測在相同 Claude 或 GPT 模型的六項 benchmark 中,Strands Harness 模型詞元費用低 28%,分數接近其他 harness;測試採用 EC2 分散式執行與 Harbor,提示、工具、上下文策略、重試規則、模型版本和任務難度都可能改變結果。
可重現的對照測試應固定資料集與成功標準並重複多次,另確認快取是否命中,避免把模型隨機性或請求排列誤當成框架節省。
代理總營運成本還包括快取命中率、工具呼叫、重試、延遲、基礎設施、日誌、追蹤和人工審核;模型詞元費用下降,仍可能被反覆失敗抵銷。
| 官方資料 | 可以支持的判斷 | 不能直接推出的結論 |
|---|---|---|
| Strands 團隊官方自測:六項 benchmark 的模型詞元費用低 28% | 上下文與快取策略可能減少重複輸入 | 所有流量都固定節省 28% |
- Strands 團隊公布的官方自測結果顯示成本低 28%,不能當成固定折扣。
- 成本比較要固定模型、提示、工具、任務、重試規則和執行環境。
- 完成率、工具呼叫、延遲和錯誤恢復,應與詞元量一起觀察。
四、台灣開發者導入前要檢查什麼
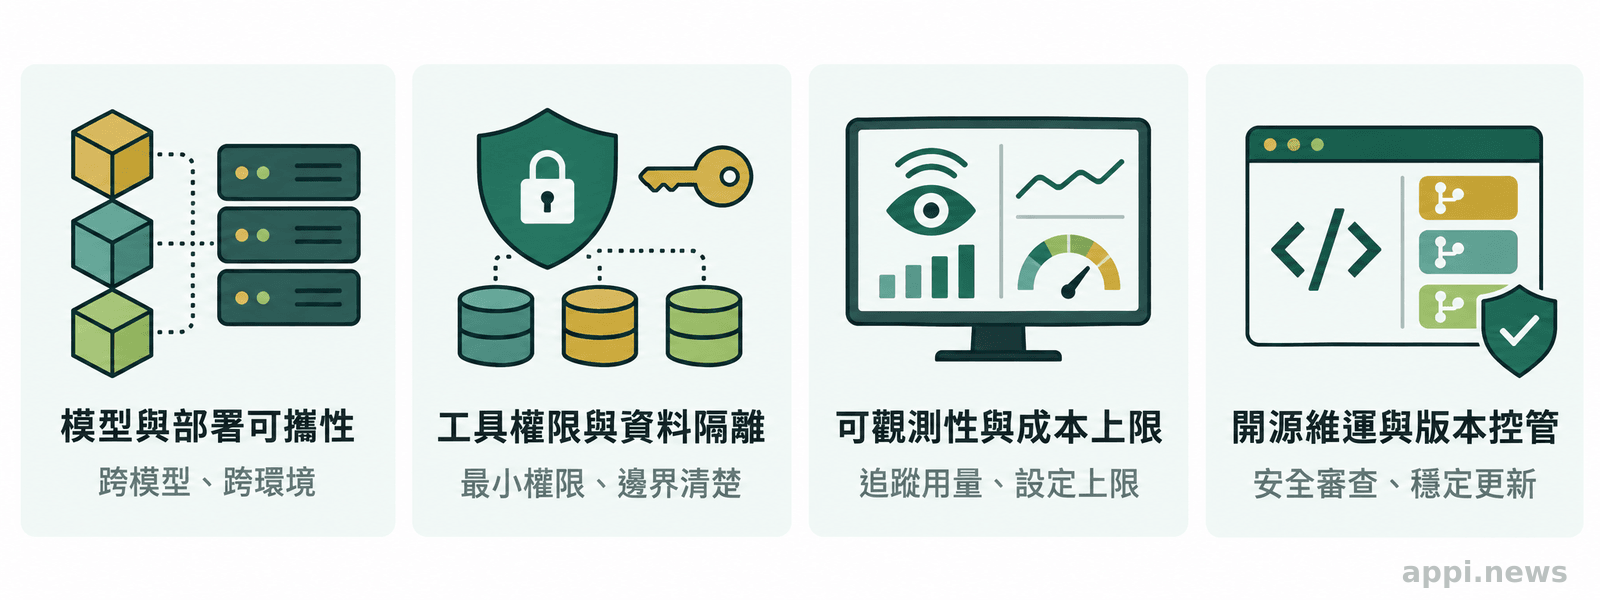
先確認模型與部署可攜性,再確認工具權限、資料隔離、可觀測性與成本上限;可運作的原型不代表符合正式環境要求。
Strands Harness 提供 Python 和 TypeScript 介面,支援多個模型供應商與本地 Ollama。導入前用固定模型、提示、工具集合與資料量驗證工具呼叫格式、結構化輸出、串流行為、上下文上限和區域可用性,再整合模型 API、祕密管理與日誌格式。
若服務處理台灣客戶資料,需確認資料是否離開既有區域、供應商如何保存請求,以及合約能否支持刪除與稽核要求。實際適用法令與合約義務,須由組織依資料類型及部署地點確認。
內建檔案、網頁與命令列工具要分別限制工作目錄、內部網址及破壞性操作;長期記憶要定義保存期限、刪除方式、資料擁有者和跨使用者隔離。開源仍有維運責任,需確認 Apache 2.0 授權、相依套件安全公告與版本固定方式,並以鎖定檔、自動化測試和回退版本降低更新風險。
正式環境至少要記錄模型請求、工具呼叫、詞元、重試、錯誤和人工核准事件;敏感資料不應因除錯而完整寫入日誌,成本上限也要放在執行迴圈外層。
- 選一個低風險、可重複的代理任務,先用既有工具鏈建立基準線。
- 固定模型、提示、工具集合、資料量和環境,再跑相同任務。
- 記錄完成率、正確性、工具呼叫、詞元、延遲、重試與基礎設施費用。
- 檢查截短、摘要和記憶恢復後,是否仍保留必要證據。
- 設定單次任務和每日流量上限,並保留原工具鏈作為回退路徑。
AWS 的 Amazon Bedrock AgentCore 開發者文件說明,可使用 agentcore export harness 將 harness 匯出為 runtime agent,部署前還應檢查產生的 EXPORT_NOTES.md。
五、哪些情境適合採用?哪些情境仍應自行組裝
任務結果可量化、風險可控且工具契約穩定時,較適合用它快速驗證、標準化內部工具與多模型實驗;需要特殊編排、嚴格資料治理、低延遲控制或客製化重試時,自行掌握迴圈會比較重要。
研究助理、文件整理、內部知識查詢、簡單資料分析和可量化的流程自動化,都可以先用 Strands Harness 建立基準。這些任務常用檔案、網頁、命令列或外部 API,也方便比較不同模型。
若任務需要狀態機、平行分支、人工核准或特殊排程,可改用 Strands Harness SDK,在既有工作流引擎內控制步驟;高敏感資料則要先檢查位置、租戶隔離、保留政策與供應商條款。
六、結論:把省下的組裝時間換成可驗證的代理品質
是否值得取代,取決於它能否同時降低組裝工作、維持結果品質並符合治理要求。 Strands 團隊公布的 28% 詞元成本差異是測試起點,還不是替換決策。
導入順序應從低風險任務開始,固定條件,記錄完成率、模型詞元費用、工具呼叫、延遲、失敗恢復和代理總營運成本;成本下降且品質維持,才擴大任務範圍,並分辨節省來自框架、工具減少或模型更換。
框架只是可替換的執行層;長期維護仍是任務定義、資料邊界、工具契約與責任分工,否則新 harness 只會把組裝問題換成治理問題。
- Strands Harness解決代理執行層的重複組裝,不會自動完成權限、治理與品質驗證。
- 官方 benchmark 的模型詞元費用優勢,需要在自己的模型、任務和工具呼叫量上重做對照。
- 預配置框架、SDK 客製或既有工具鏈,應由實測結果決定。
常見問題
先用低風險任務做同條件對照,確認品質、安全與總成本,再決定是否擴大使用。
Q1: Strands Harness是免費的嗎?
專案以 Apache 2.0 授權開源,但模型 API、容器、儲存、網路、日誌與觀測服務仍可能產生費用。
Q2: Strands Harness只能搭配 AWS 模型嗎?
官方列出 Amazon Bedrock、Anthropic、OpenAI、Google、Ollama 和 LiteLLM 等路徑,實際支援仍要依模型功能逐項測試。
Q3: 28%詞元成本下降可以直接套用嗎?
不宜直接套用。這是 Strands 團隊在特定模型、任務和執行條件下公布的官方自測結果,應用相同任務建立基準線再比較。
參考來源
- Strands Agents Team (2026). *Introducing Strands harness: frontier performance with 28% lower token cost*. Strands Agents
- Strands Agents (2026). *Strands harness*. Strands Agents Documentation
- strands-agents (2026). GitHub - strands-agents/harness-sdk: Build an agent harness and control it end-to-end. Open-source SDK for production AI agents in Python & TypeScript - any model, any cloud. · GitHub. *GitHub
- Amazon Web Services (2026). *Export harness to code*. Amazon Bedrock AgentCore Developer Guide
- Amazon Web Services (2026). *AgentCore harness is now generally available*. AWS What's New
- 李建興 (2026). *AWS開源Strands Harness,預組代理最佳化設定降低詞元成本達28%*. iThome