
Hugging Face 展示的 macOS 範例 Emoji Magnet 有 343 個 emoji。使用者輸入「冬天會穿的東西」後,託管的 Jev 約半秒回傳整批判斷;本機 MLX 則由 M4 Max 上的 Qwen3 4B 約 10 秒掃完,命中的圖示浮到上方。兩者是同一示範的不同執行方式,時間是特定服務與硬體的結果,不代表其他裝置表現。Hugging Face 的公告
這個例子呈現一種不同於生成文字的流程:當 App 只需要「是或否」「選哪一類」或「落在哪個評分級距」,模型可直接回傳固定型別與候選答案機率。這種 Apple 決策模型適合接手哪些工作?機率又能告訴產品團隊多少?
如果你正在比較模型如何接進產品,也可參考決策模型如何導入與驗收及Decisions API 與 Jev 的差異。
Emoji Magnet 如何用 AnyDecisionModel 從 343 個 emoji 找出符合描述的項目?
它把文字描述當作狀態,對每個 emoji 提出是非題,再依模型輸出的結果呈現符合項目。
Emoji Magnet 每次輸入後,會把每個 emoji 轉成待判斷的敘述,例如「厚冬衣符合『會穿的東西』嗎?」模型回答各題,介面再顯示符合者。
Hugging Face 公告說,使用 Jev 託管服務時,343 個判斷以單次請求處理,更新約半秒。切換成本機 MLX 後,Qwen3 4B 在 M4 Max 上每批處理 16 題,每批約 0.45 秒,完整掃描約 10 秒。這是作者示範數據,不同硬體與網路會改變延遲。
每題只有「符合」或「不符合」,顯示輸出空間已先定義。若問題本身沒有清楚邊界,再快速的推論也只會穩定地回答錯題。產品團隊可先讀AnyDecisionModel 的功能與限制,再確認資料能否改寫成有限問題。
AnyDecisionModel 的輸出和文字生成流程有何不同?
AnyDecisionModel 把答案限制為預先定義的選項或量表,回傳型別化結果與各候選值的機率,減少把自由文字轉成標籤的解析步驟。
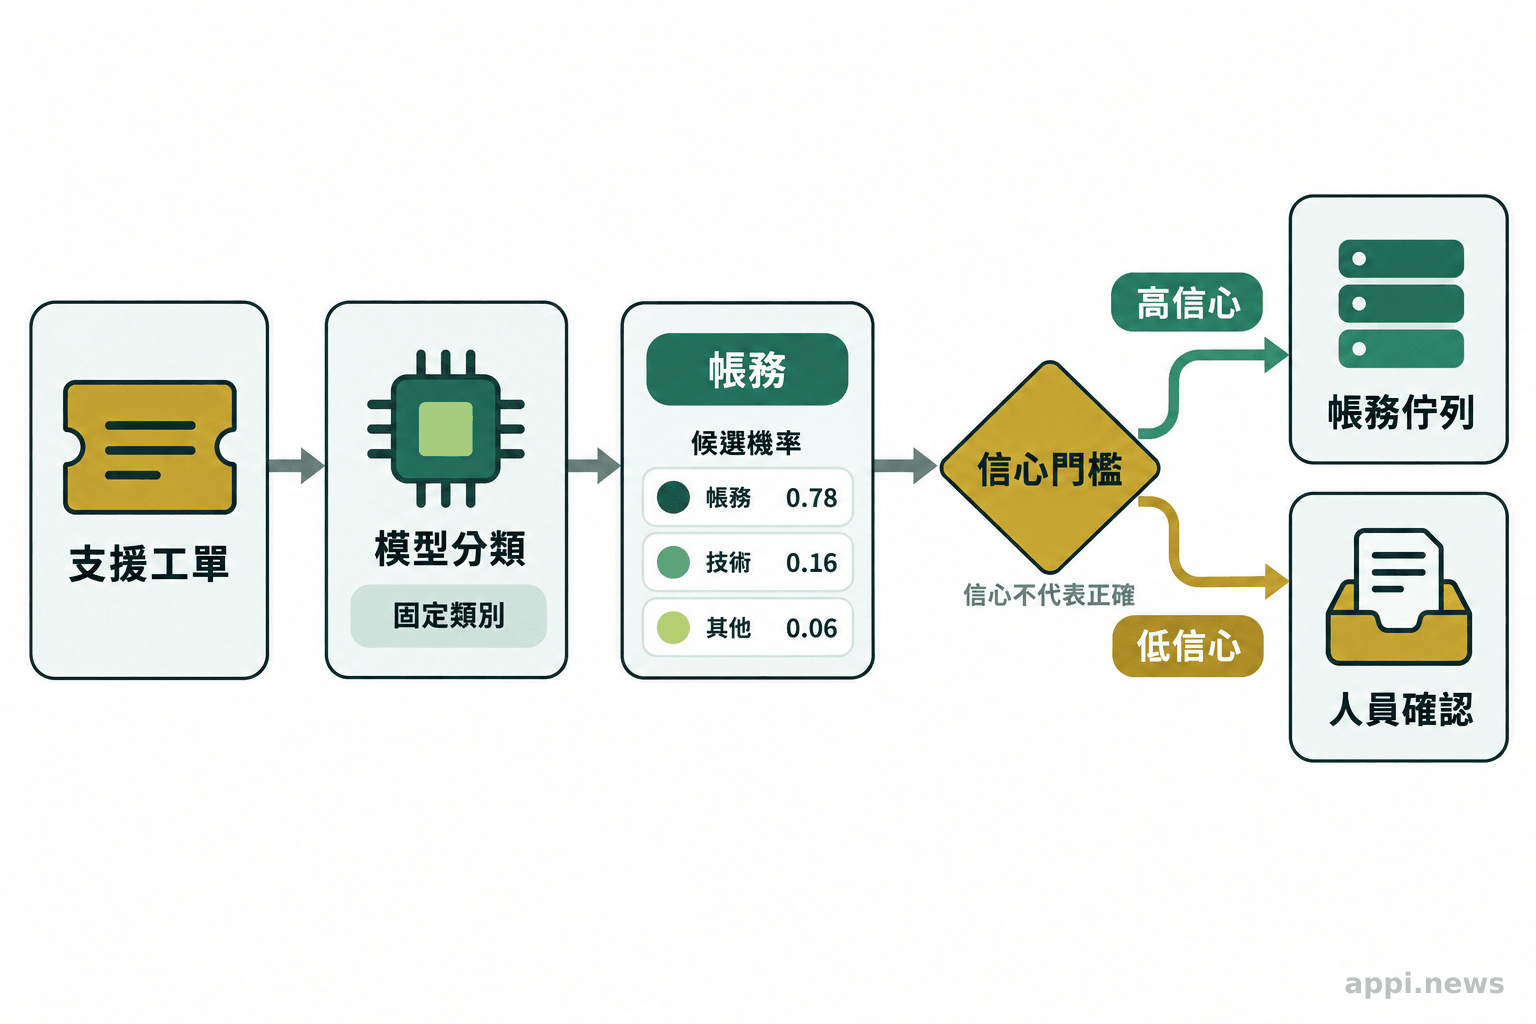
在傳統流程中,App 可能請生成式模型讀取客服訊息,輸出「帳務問題」或「技術問題」,接著還要處理拼字、補充說明、格式錯誤和意料之外的答案。AnyDecisionModel 則可把部門列成列舉型別,從帳務、技術、銷售等有限選項中選擇,也能判斷訊息是否急迫。
它也能以「冷靜、挫折、非常生氣」作為序位評分。AnyDecisionModel-Examples 的 Ticket Routing 示範把四筆支援工單依預先定義的部門、急迫程度與情緒級距分類,低信心結果交由人員查看。官方範例呈現的是流程如何接上人工覆核;四筆樣本沒有提供足以代表真實工單分布的整體準確率,不能當成部署成效。
一般語言模型透過下一個 token 機率讀出選項標籤,選項最多 26 個、評分級距最多 10 層;清單中的位置也可能影響結果。套件提供輪替選項以減少位置偏差,但每種排列都要再執行一次。
另一條路是使用 Clef 等帶有專用決策頭的模型。官方示例採用量化後 6.2 GB 的 Clef-Flash,模型卡建議 Mac 至少有 16 GB 記憶體;在 AnyDecisionModel 中,這個後端的輸入狀態限於文字與 JSON。這些是特定實作條件,不代表所有決策模型都相同。
「語言模型的原始機率往往過度自信。」這是 Hugging Face 公告對模型機率的提醒,實際校準仍須用不同資料集分別擬合與評估。
機率表示模型在候選答案間如何分配分數,信心值反映分布是否集中,兩者都不代表答案正確。應先檢查錯誤率,再訂自動處理門檻。訊息分類若牽涉退款、帳號停用或健康服務,低信心或高後果項目應保留人工覆核。
哪些 App 任務適合先試決策模型?
先挑輸出項目固定、錯誤後果可控、而且能取得標註資料驗證的分類或評分工作。
客服工單分流是套件範例中的實際案例:同一段文字可分別判斷負責部門、急迫程度與情緒級距,低信心工單轉交人工。相近的產品任務還包括把 App 內回報分到既有問題類別、判斷回饋是否包含明確求助訊號,或將意見放入內部使用的量表。這些例子是可測試的任務設計方向,不等於模型已經具備可靠的情緒或健康判讀能力。
另一個案例是 Cloudflare 的 Clef 決策頭。Hugging Face 公告展示 AnyDecisionModel 在 Mac 上以量化後 6.2 GB 的 Clef-Flash,根據結構化問題與狀態,在預設候選決策中作答;這展示專用決策頭如何接入套件,並非不同產品任務的準確度評估。公告沒有提供足以推估部署效果的跨裝置測試,實際採用仍須按自己的輸入和候選答案驗證。Hugging Face 公告
採用這條路徑時,須評估 6.2 GB 下載、記憶體、提示長度與裝置覆蓋。可先讀Cloudflare Clef 的任務與部署評估,再依自己的輸入型態判斷模型頭是否吻合。
「情緒量表」須界定用途。模型依文字給出序位分數,不表示它測得臨床情緒狀態或能取代專業判斷。若任務放進數位健康 App,還須檢查敏感資料處理、存取權限、保存期限與人工覆核。此次公告談軟體整合,不涉及原料或藥物交互作用,也未表示產品取得醫療或隱私合規認證。
AnySpeechRecognizer 如何接入 Apple 語音工作流?
AnySpeechRecognizer 延用 SpeechAnalyzer 等 API 形式,讓開發者可在共用工作流中切換辨識引擎,再把辨識文字交給決策模型分類。
Apple 的 SpeechAnalyzer 語音分析 API 支援 macOS 26 與 iOS 26。Apple 文件 AnySpeechRecognizer 沿用 SpeechAnalyzer、SpeechTranscriber、SpeechDetector 與 AssetInventory 等介面;使用共用 API 的程式可透過更換匯入模組與建立 transcriber 改用 Parakeet。
套件另增加說話者分離功能,可在時間軸標出最多四位說話者的發言。語音辨識(ASR)負責把音訊轉成文字,說話者分離(speaker diarization)則辨認不同話語來自誰,兩者是不同任務。
語音範例提供另一個有出處的實測案例。套件作者在 M4 Max Mac Studio、macOS 27.0.1 上,以三至八分鐘的 LibriSpeech 音檔測試 Parakeet v3,檔案模式的詞錯誤率在 test-clean 為 1.55%、test-other 為 2.78%。
作者說明測試只涵蓋單一機器和少數資料集,目前未在 iPhone 上測試。這些英文基準數據不代表中文、台灣口音、會議重疊語音或其他手機的辨識結果。
Parakeet 支援檔案與即時輸入、暫時性辨識結果和詞級時間資訊。Qwen3-ASR 支援中文等語言,但以最長 40 秒片段輸出最終結果,沒有即時暫存、詞級時間或信心資訊,速度也較慢,較適合檔案轉錄。
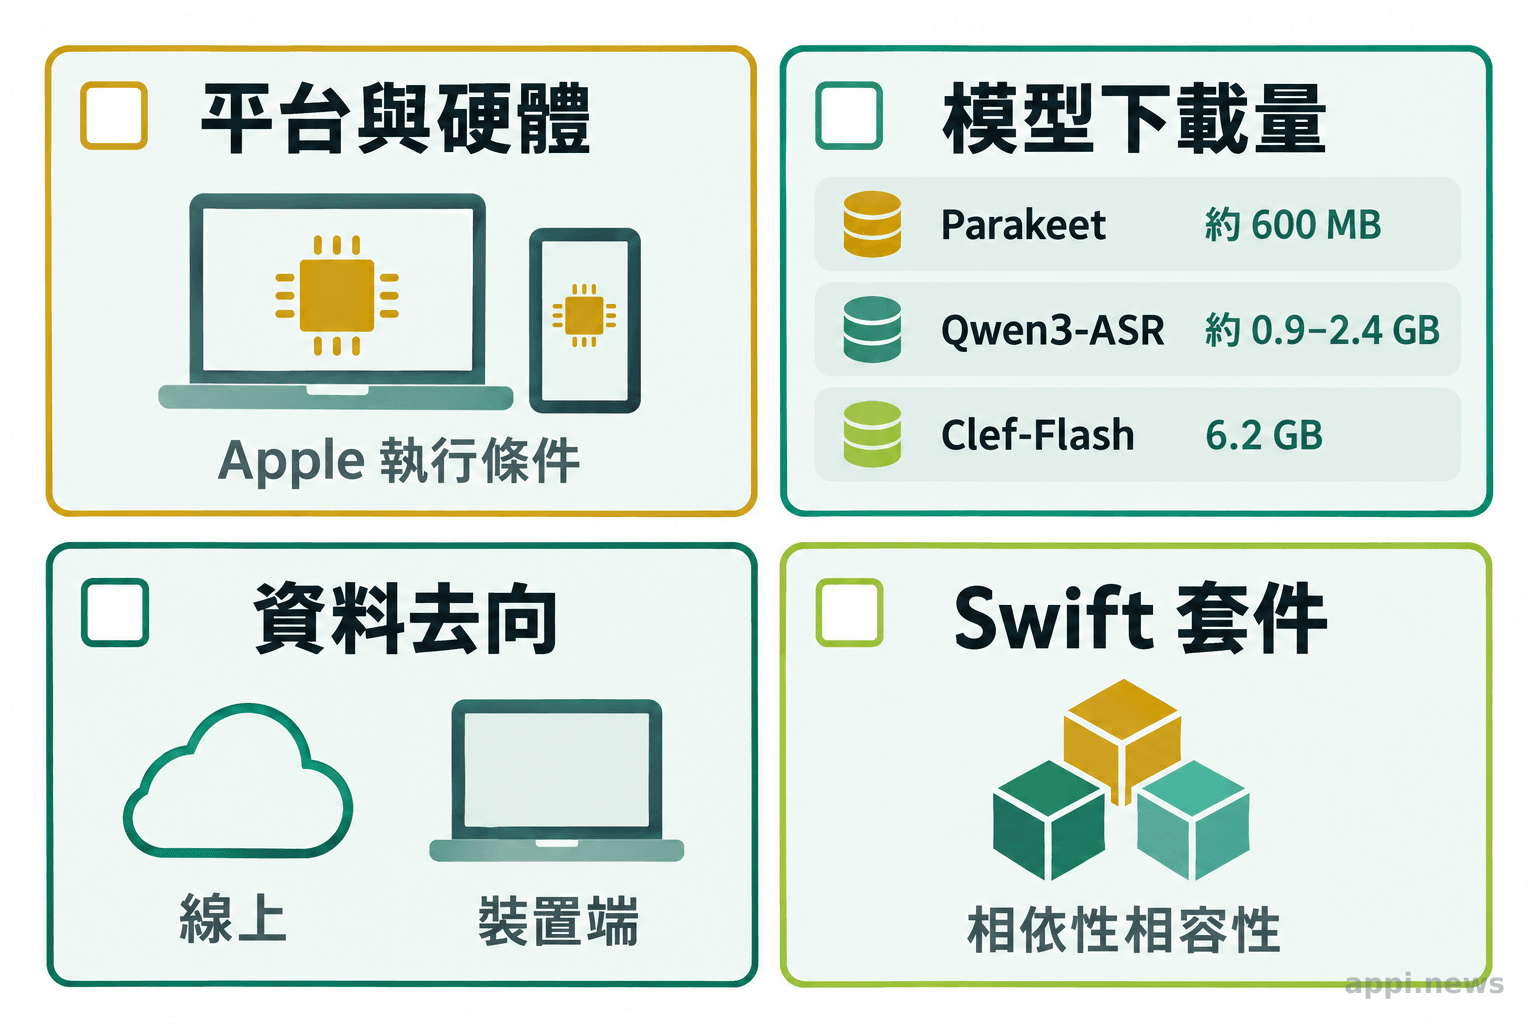
模型下載量依模型而異:Parakeet 約 600 MB,Qwen3-ASR 約 0.9 至 2.4 GB,說話者分離模型另計。語言、延遲和記憶體仍應在自己的錄音與裝置重測。
「這些數字來自一台機器和少數資料集。」Hugging Face 公告如此界定語音辨識測試範圍,並建議以自己的硬體與音訊評估。
整合前要檢查哪些平台、資料與維護限制?
先核對 Swift 與作業系統版本、Apple 晶片和模型資源,再檢查 Swift 套件相依、模型授權及資料流向。
AnyDecisionModel 套件的基本條件是 Swift 6.2 以上與 macOS 26 或 iOS 26 以上;這不代表每個後端都能在這些系統版本執行。MLX 與 Parakeet 等模型執行需要 Apple 晶片。
AnyDecisionModel 的 MLX 建置另需 Xcode Swift 6.4 以上及 Metal 工具鏈;Core AI 後端則需 Xcode 27,並在 macOS 27 或 iOS 27 執行。這些是 AnyDecisionModel 各後端的條件,與 SpeechAnalyzer API 支援 macOS 26、iOS 26 是兩件事。版本可能更新,導入前應分別核對套件文件與 Apple API 文件。
套件相依也會影響選擇。Hugging Face 公告列出一項限制:AnyDecisionModel 的 CoreAI trait 依賴 swift-huggingface 1.0 以下版本,AnySpeechRecognizer 則要求 1.x,兩者暫時無法同時搭配該 trait。
相依狀態可能隨版本改變,產品開發應以 Swift Package Manager 的實際解析結果為準。
「本機推論」不會自動完成整個 App 的隱私治理。選擇 Jev、Ollama 雲端或其他伺服器後端時,文字或音訊可能離開裝置;即使使用本機模型,紀錄檔、同步、備份與錯誤回報仍可能保存敏感內容。
團隊應追蹤資料收集位置、存取者和保存期限,並定義斷網、模型下載失敗、無法判斷及高風險分類時的人工處理方式。AnyDecisionModel 與 AnySpeechRecognizer 程式套件採 Apache-2.0 授權;模型權重另有各自條款,商用前應核對實際選用模型的權重卡與授權範圍,不能只由套件授權推定。
如何判斷一項任務值得做本機決策模型 PoC?
先定義固定輸出與可接受錯誤,再用未參與調校的自有資料測量準確度、機率校準、延遲和人工覆核成本。
-
定義任務與邊界:列出每個候選類別、評分級距和「無法判斷」選項,說清楚哪些結果可自動執行、哪些必須轉人工。
-
準備代表性資料:保留實際語言、長短訊息、罕見情況與易混淆案例,切分調校資料與獨立驗證資料,避免拿同一批資料同時調門檻又報成效。
-
逐項量測:記錄各類別錯誤率、漏判與誤判、候選機率是否校準、改變選項順序後是否翻轉,以及不同裝置上的推論時間與記憶體。
-
計算流程成本:納入模型下載、更新、授權審查、相依維護、離線支援與人工複核時間,再與現行生成式模型加解析器的做法比較。
-
設定停用條件:只要錯誤率超過業務容忍值、模型無法處理關鍵語言,或人工覆核成本沒有下降,就保留原流程或縮小使用範圍。
這份清單能避免團隊只看展示速度或單一基準分數。Hugging Face 測試顯示,會議重疊語音仍有較高錯誤率,且未驗證 iPhone。評估應回到產品資料和錯誤後果。
AnyDecisionModel 可輸出分類、選擇與評分,AnySpeechRecognizer 則提供可替換的語音引擎。兩者可串成「語音轉錄 → 固定選項判斷 → 低信心人工覆核」。先挑一項錯誤可控的任務做 PoC,量測延遲、資源、判斷品質和覆核成本。
- AnyDecisionModel 適合輸出固定選項、是非判斷或序位分數;型別化結果仍需要錯誤處理與人工退路。
- 機率與信心值不是正確率。用分開的調校、驗證資料檢查校準和錯誤,再訂自動化門檻。
- AnySpeechRecognizer 的模型、語言和即時能力有差異;公告測試來自特定 Mac 與資料集,須在目標裝置重測。
常見問題
Q1:AnyDecisionModel 能完全取代生成式模型嗎?
不能。它適合答案選項可預先定義的分類、是非判斷與評分;需要長篇生成、開放式解釋或多步推理的工作仍需其他模型或流程。
Q2:AnyDecisionModel 能否在 iPhone 本機執行?
文件列出 iOS 26 以上的支援,但不同後端有各自的晶片、模型與系統條件。Clef-Flash 範例建議至少 16 GB 記憶體的 Mac,不能據此推定 iPhone 適用;應針對指定機型和後端實測。
Q3:信心值高,可以直接自動處理嗎?
不宜只依信心值決定。先在代表性資料上測量它與實際正確率的關係,設定錯誤可接受範圍,並為低信心或高後果案例保留人工覆核。
Q4:本機 AI 是否代表資料不會外傳?
只有確認整段資料流都在裝置內,才能做這種判斷。後端設定、遙測、記錄、同步與備份都可能涉及傳輸或保存,需逐項檢查。
參考來源
- Hugging Face (2026). Introducing AnySpeechRecognizer and AnyDecisionModel: Open Models for Speech and Decisions on Apple Platforms
- Mattt (2026). AnyDecisionModel. GitHub
- Mattt (2026). AnySpeechRecognizer. GitHub
- Mattt (2026). AnyDecisionModel Examples. GitHub
- Apple. SpeechAnalyzer. Apple Developer Documentation


