
Ollama 在 0.40.9 發布說明加入 Phonon 語音生成:Apple Silicon 上的 ollama run 可以朗讀文字或聊天模型的回答,應用程式則能透過 OpenAI 相容的語音端點接收音訊串流。這是 Ollama 官方公布的功能與操作介面,文件範例尚不能證明它已在企業產品正式部署,也沒有提供跨設備的速度、音質或穩定性測試。Ollama 0.40.9 發布說明
對已經把 Ollama 接進工具或產品的開發者來說,新增語音看起來只差一次模型呼叫。但聲音要送到哪個播放器、輸入文字如何整理、目標語言是否可用,都會改變整合方式。這裡要先問一個更前面的問題:終端能播出聲音,是否就代表它能直接接進既有產品流程?
相較先前討論 Voxtral 3 即時語音代理所需環節,這篇只補上文字轉語音如何進入本機工作流。
Ollama 0.40.9 新增的語音能力,改變了哪一步?
它讓文字或聊天模型的回答可以交給 Phonon 轉成語音,並提供終端播放與應用程式 API 兩種入口。改變的是文字到音訊的交接方式,產品仍須自行處理播放、錯誤與使用者介面。
Phonon 是 Gradium 的文字轉語音(Text-to-Speech,TTS)模型家族。Ollama 的終端路徑可直接朗讀輸入文字,也能把聊天模型輸出接到 Phonon;官方文件的例子會在答案串流到第一、兩句時開始播放。開發者可將它用於快速試聽、內部原型或本機閱讀工具,但若工作流需要字幕同步、語音中斷控制或特定播放器,仍需額外編排。Ollama 語音功能文件
第二條路徑是 API。Ollama 提供 OpenAI 相容的 /v1/audio/speech 端點,請求中放入模型名稱、文字及 voice,回應可用串流方式接收。這代表既有採用 OpenAI SDK 的程式可能沿用部分呼叫結構;「相容」指介面格式接近,並不表示所有欄位、錯誤行為或應用邏輯都可不經檢查直接移植。官方範例預設輸出 WAV,也列出 PCM 格式。Ollama API 文件
「音訊會在生成時以串流方式傳送,因此可以在整段文字尚未唸完前開始播放。」— Ollama 語音功能文件,意譯
終端試聽與產品 API,工作流需要的元件不同
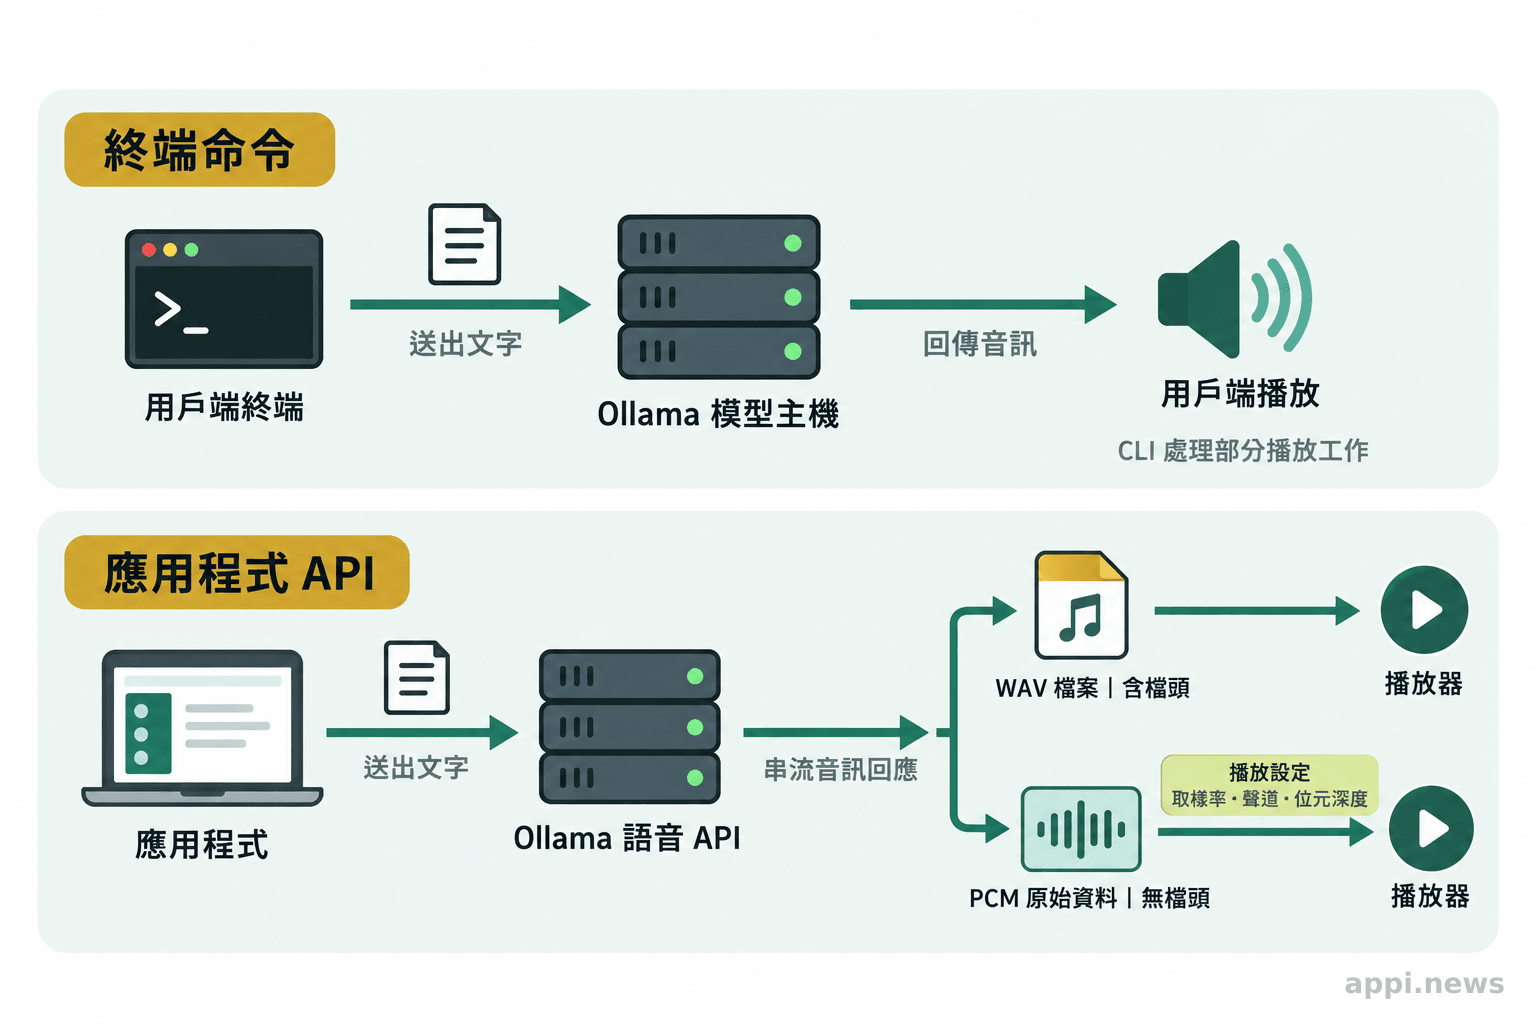
終端命令已替使用者處理一部分播放工作;API 呼叫則把音訊交給應用程式,播放、暫存、格式轉換與中斷控制要由下游負責。
終端適合先驗證模型能否讀出一段文字。官方列出的操作包含 ollama run phonon "Hello from Ollama.",也可以把另一個程式的文字輸出管線傳入;重新導向輸出可存成 WAV。若 Ollama 跑在遠端主機,播放位置仍由執行命令的用戶端決定。模型主機與耳機所在設備可以不同,網路傳輸和資料路徑便要納入設計。Ollama 語音功能文件
產品端使用 API 時,程式需要接收串流資料,判斷何時開始播放,並在連線中斷時決定重試、續播或回報錯誤。若先將完整音訊寫成檔案,再交給播放器,實作比較直觀,但使用者必須等生成與存檔流程走完;邊收邊播可以縮短等待感,卻增加緩衝、取消請求和播放狀態同步的工作。官方範例沒有比較實際延遲。
另一個容易漏掉的交接是下游格式。Ollama 文件列出的 WAV 是單聲道、24 kHz、16-bit;PCM 則是相同取樣規格的原始資料,沒有檔頭。播放器若預期立體聲或不同取樣率,就要確認是否需要轉換。PCM 沒有檔頭,接收端也必須知道取樣率、聲道和位元深度,否則即使收到資料,仍可能播放成雜音或錯誤速度。
Apple Silicon、語言和授權會決定可用範圍
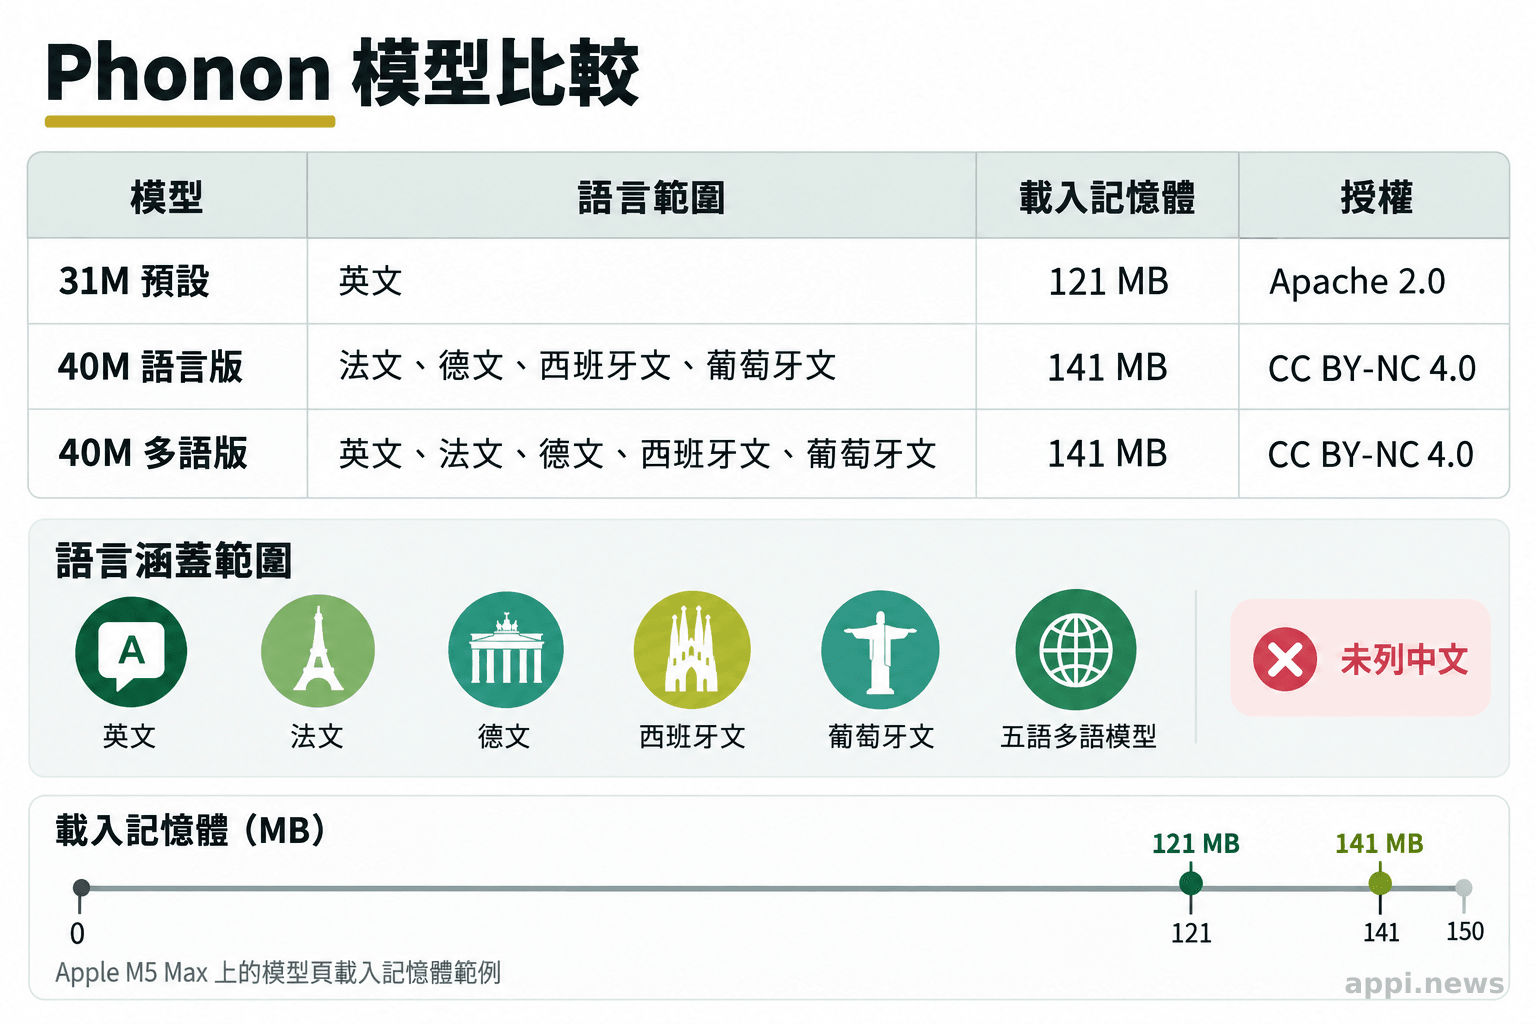
Ollama 的 Phonon 套件要求 Apple Silicon 與 Ollama 0.40.9 或更新版本。官方模型頁列出英文、法文、德文、西班牙文、葡萄牙文及涵蓋這五種語言的多語模型,沒有列出中文模型。
預設標籤 phonon 對應 Gradium 的 31M 英文模型,隨附一個名為 default 的聲線。官方模型頁以 Apple M5 Max 為例,標示預設模型載入記憶體為 121 MB;40M 的各語言版本列為 141 MB。這些是特定設備與模型的載入記憶體數字,不能當作所有 Apple Silicon 電腦的需求,也不能單憑參數量推算生成速度或音質。Ollama Phonon 模型頁
語言支援要比標籤名稱更仔細地檢查。Gradium 的模型卡說明,31M 版本只說英文;多語版涵蓋英文、法文、德文、西班牙文和葡萄牙文,其他語言會以不正確的發音唸出。因而台灣團隊不能把「multilingual」直接解讀成支援中文。應先用實際內容測試專有名詞、日期、縮寫與中英混排,再決定是否能用於對外服務。Gradium Phonon 模型卡
授權也因模型而異。Gradium 模型卡將 31M 英文模型列為 Apache 2.0;Ollama 模型頁則將 40M 英、法、德、西、葡與多語版本列為 CC BY-NC 4.0,限制非商業用途。若要商用,需依實際下載的模型標籤核對權重、聲線資產及執行程式的授權條件,不能看到 Phonon 這個家族名稱就假設全部可用。
「極長文字會被切成句子依序唸出,前後句的語調連貫性不會一路延續。」— Gradium Phonon 模型卡,意譯
整合成本藏在文字整理與音訊交接
文字正規化、每次請求的輸入上限、播放端格式和失敗時的處理,都會影響使用體驗。模型能產生音訊,只完成了流程中的一段。
Ollama 的語音 API 每次請求最多接受 4,096 個字元;終端命令則會在段落或句子邊界拆分較長文字。API 文字會照原樣唸出,數字、日期和縮寫不會自動展開成口語,因此「2026/10/23」可能不符合產品想要的讀法。文件建議對可預期結果先把數字寫成文字,產品也可在送出前建立自己的文字正規化規則。Ollama 語音功能文件
文字整理牽涉的不只標點。金額、地址、日期、型號和英文縮寫的讀法各有情境;把它們一律轉成口語可能讓技術內容失真,保留原文又可能不適合朗讀。Gradium 的模型卡指出,文字正規化需要指定正確語言;其 Transformers 範例另提醒,該路徑不會替數字、金額、符號或地址展開,長文字需自行切分。不同執行方式的限制不完全相同,應針對實際採用的介面測試,而非把一條路徑的行為套用到另一條。Gradium Phonon 模型卡
官方模型卡也提供幾組可量化的比較案例,但這些是模型提供方公布的評測,不是 Ollama 在用戶設備上的實測。英文測試由 468 位評分者完成 8,290 次盲聽投票,Phonon 31M 的 Elo 為 2,098;法文測試有 172 位評分者、2,270 次投票,Phonon 40M 法文版 Elo 為 2,072;巴西葡萄牙文測試則有 171 位評分者、2,000 次投票,40M 葡萄牙文版 Elo 為 2,144。這些分數只能描述各自評測集中的人類偏好排序,不能推導成中文品質、真實使用滿意度或所有設備上的表現。Gradium Phonon 模型卡評測
延遲與資料位置也應分開判斷。端點在 localhost 並不自動保證所有資料都留在單一設備;若 Ollama 指向遠端主機,文字會送往該主機,音訊則可能回到用戶端播放。系統還要決定請求內容是否進入應用程式日誌、音訊檔案保存多久、串流中斷時是否保留部分輸出。對含有個人或機密內容的工作流,應確認網路路徑、主機權限與紀錄政策,再談本機部署帶來的資料控制程度。
用五項檢查判斷 Phonon 是否適合現有工作流
先從目標語言、模型授權、呼叫介面、音訊接收方式與維運責任五項逐一檢查,再用實際文字跑過完整路徑。任何一項不符,就先修正流程或選擇其他模型。
- 確認語言與文字內容:用產品會遇到的句子測試中文、英文、數字、日期和縮寫,記下錯誤發音與需要改寫的文字。若主要內容是中文,現有官方模型資料不足以支持中文可用的結論。
- 核對授權:記錄實際模型標籤、權重授權、聲線資產與 runtime 授權;商業服務排除 CC BY-NC 4.0 模型,或先取得適用的商業授權。
- 選定呼叫介面:開發者試聽可從 CLI 開始;產品串接則檢查
/v1/audio/speech的請求欄位、輸入字元上限與錯誤回應,並確認程式採用的 SDK 相容範圍。 - 走完音訊播放路徑:確認 WAV 或 PCM 是否符合播放器需求,並測試串流開始、取消、網路中斷、超長文字拆分及失敗重試。
- 標清主機與責任:確認模型在哪台設備執行、音訊在哪裡播放、請求是否留下日誌,以及誰負責更新模型、監控錯誤與處理授權變更。
最小驗證不必先做完整產品:挑一段會遇到的文字,依序測試語音輸出、播放端格式、連線中斷和長文字切分,再記錄硬體、模型標籤及授權。這樣得到的是團隊自己的可用性證據,與官方操作範例或模型卡 benchmark 分開看,才有依據估算部署成本。
- Phonon 擴充的是本機文字轉語音介面,CLI 和 API 對應不同整合責任。
- Ollama 套件要求 Apple Silicon 與 0.40.9 以上;官方列出的語言不含中文。
- 商用前逐一確認模型授權,並測試文字正規化、音訊格式、播放端與失敗處理。
常見問題
先確認目標語言、實際模型標籤與授權,再判斷 API 和播放端能否接起來;本機執行也要依架構確認資料會經過哪些設備。
常見問題
Q1:Phonon 是否支援中文?
Ollama 與 Gradium 目前列出的模型語言為英文、法文、德文、西班牙文、葡萄牙文及五語多語模型,沒有中文。若要用於中文內容,需等官方提供相應模型資訊或自行完成可重現的語音測試,不能從「多語」推定支援。
Q2:生成的音訊能直接接入應用程式嗎?
可以透過 OpenAI 相容的 /v1/audio/speech 端點取得串流或 WAV、PCM 輸出,但應用程式仍須接收音訊、安排播放、處理中斷和格式相容。CLI 播放範例本身不會替產品完成這些工作。
Q3:本機生成是否代表所有資料都留在本機?
不一定。若模型主機是遠端設備,文字會送到遠端處理,音訊再傳回播放端;應依網路設定、應用程式日誌與檔案保存方式確認資料流向。


