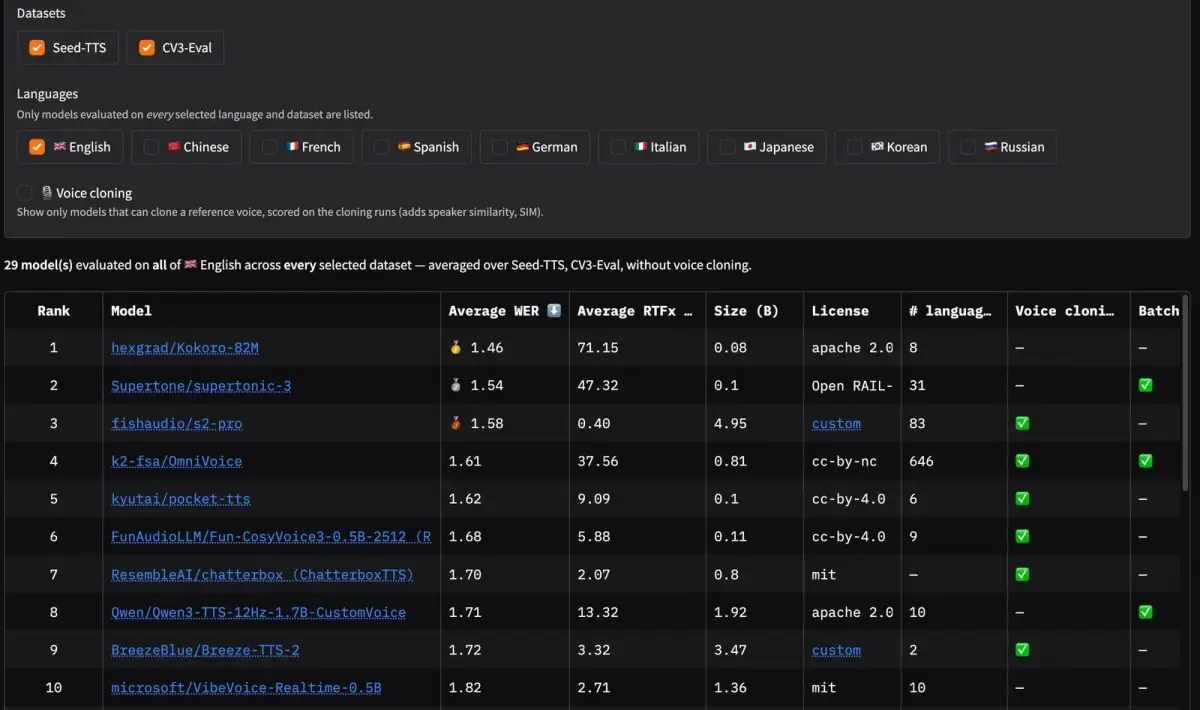
很多人第一個會先想到,榜單排名最高的模型是不是就最好用?這裡要先問一個更前面的問題:榜單測量的能力,是否符合產品要使用的語言、文字、設備與等待時間?Hugging Face 推出的 Open TTS Leaderboard,提供多語言文字轉語音與語音複製的比較線索,但它呈現的是指定條件下的測量結果,不能直接代替實際產品測試。
文字轉語音(Text-to-Speech,TTS)會把文字轉成語音。選型時常把「聽得懂、聽起來自然、像不像指定說話者、生成得多快」混成一個好壞判斷,然而這些問題需要不同方法測量。先拆開評測問題,才知道分數可以回答哪一部分。
一、榜單排名高,是否等於適合你的文字轉語音?
不代表。榜單只能比較特定測試集與執行條件下的指標,適用性仍取決於產品語言、內容和部署方式。
公平比較的起點,是讓模型面對相同文字、資料集、推論參數和運算設備。若模型 A 使用較短句子,模型 B 使用長句;或兩者分別在不同硬體上計時,結果就混入了測試條件差異。Open TTS Leaderboard 將統一測試文本和硬體下的指標放在同一頁,讓開放權重模型有一套較容易擴充的自動比較方式。
然而,固定條件只能減少比較中的變因,無法保證測試材料涵蓋實際工作。產品可能要唸出繁體中文姓名、地址、藥品或產品型號,也可能遇到台灣國語、台語夾中文、英文縮寫、數字和標點。若評測文本沒有這些特徵,整體平均分便無法告訴團隊模型遇到這些項目會如何發音。
測試集的選擇還會影響比較方向。短句可檢查基本發音,長句能暴露句尾漏字、停頓不自然或前後語氣不一致;客服對話在乎即時回應,教材旁白則可能更在乎長時間聆聽的疲勞感。公平評測不是只有「同一份題目」,還要問這份題目代表誰的使用情境。
另一個容易忽略的差別,是榜單的順位可能把多項指標壓成一個排序。若一個模型的可懂度較高、另一個模型起音更快,誰排前面要看榜單採用哪個欄位排序;產品團隊則須先定義不能妥協的條件。例如語音助理重視第一段音訊何時出現,批次製作大量旁白則重視總生成時間與錯字率。不存在脫離用途的單一總分。
二、Open TTS Leaderboard 分別測量哪些能力?
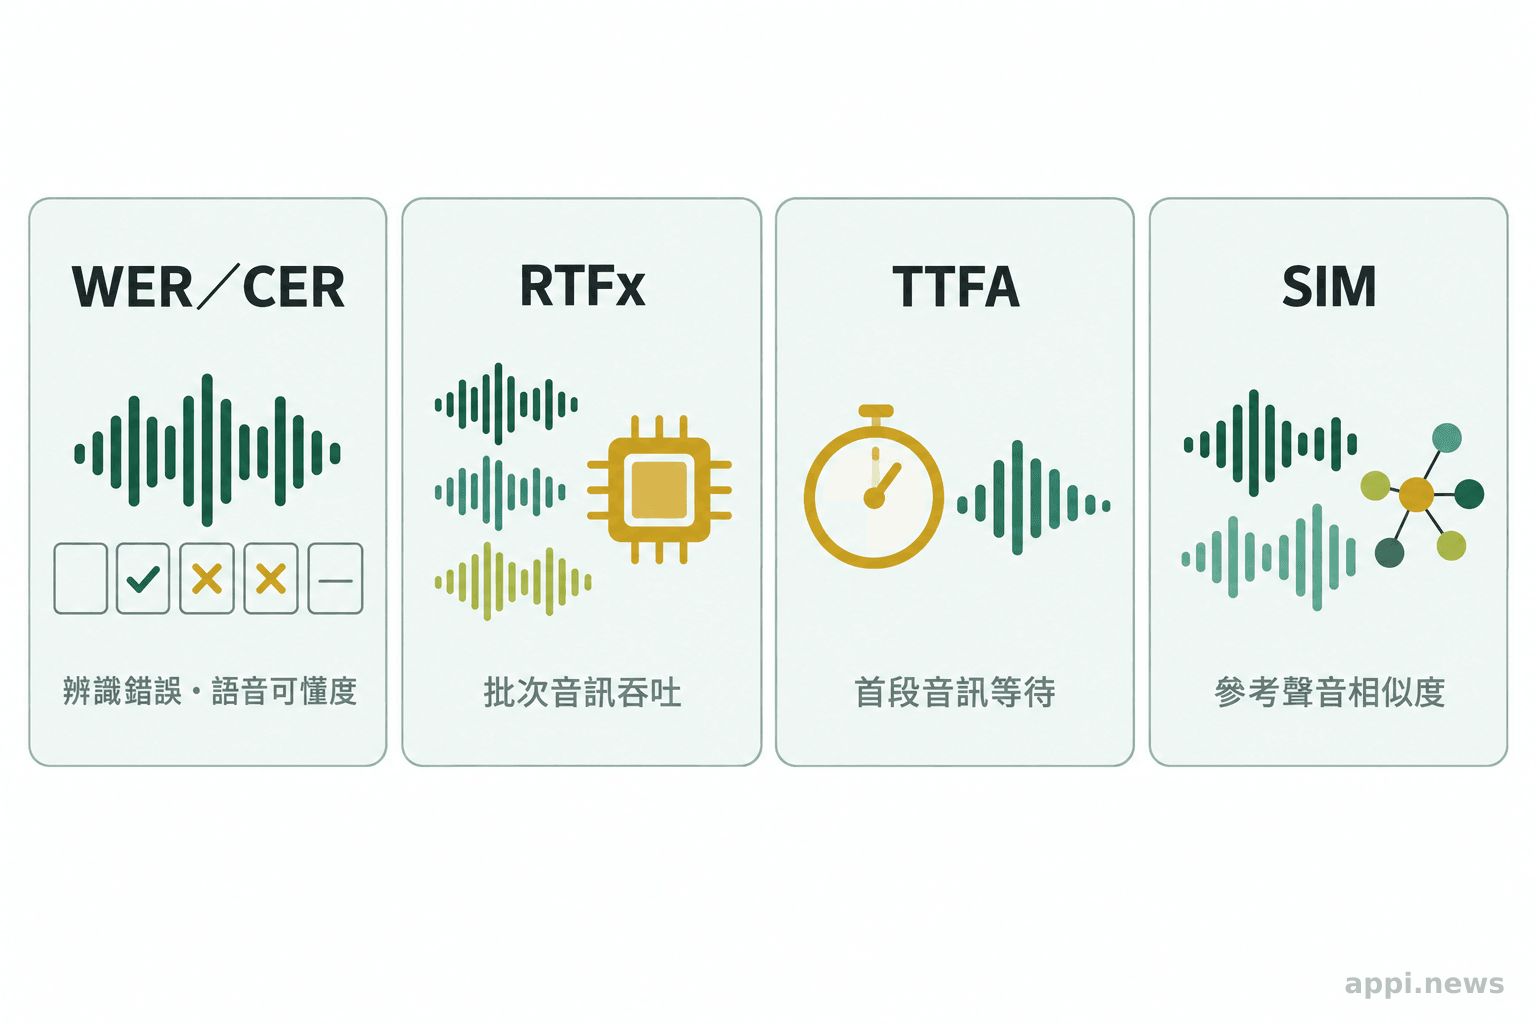
WER/CER估計語音內容是否容易被辨識,RTFx與TTFA呈現生成速度,SIM估計生成聲音與參考聲音的相似程度。
Hugging Face 的 Open TTS Leaderboard 將這些指標分開呈現,並提供聆聽輸出與串流速度的檢視方式。它的價值在於以自動流程擴大可比較的模型數量,讓使用者能先依需求縮小候選範圍,再聽聲音和做自己的測試。各分數的方向與測量對象不同,閱讀時不能互相替代。
WER 與 CER:語音內容是否清楚可辨
詞錯誤率(Word Error Rate,WER)是把合成音訊交給自動語音辨識(Automatic Speech Recognition,ASR)模型轉成文字,再與輸入文本比較。插入、刪除或替換的詞越多,錯誤率通常越高。中文、日文和韓文較常用字元錯誤率(Character Error Rate,CER),以字元層級計算差異。對中文模型而言,CER較能避免英文以空格分詞的方式直接套用到沒有空格分詞習慣的文字。
但這兩個數字同時受合成模型和 ASR 評分器影響。合成音若把專有名詞唸得清楚,ASR 仍可能因不熟悉該詞而轉錯;反過來,ASR 的語言模型也可能根據上下文猜出正確文字,掩蓋發音含糊。WER/CER適合作為可懂度代理指標,不能當成自然度、情緒表現或聽者偏好的完整測量。
RTFx 與 TTFA:批次速度和互動等待時間
反即時因子(Real-Time Factor,RTFx)用生成的音訊秒數除以運算所花的秒數。RTFx 越高,代表在該次測試中每秒運算生成的音訊較多。它適合觀察批次處理效率,但結果依賴硬體、批次大小、模型執行方式和工作負載。將單張高階 GPU 的批次成績拿來預測筆電 CPU 的生成速度,沒有可比性。
首段音訊時間(Time to First Audio,TTFA)測量送出文字後,多久可以拿到第一段可播放音訊。互動式語音服務通常更在意使用者等多久才聽到第一個回應;若模型必須等整句全部生成後才播放,TTFA會接近整句完成時間。對支援串流的模型,則以第一個音訊區塊為準。TTFA低不等於整段生成快,也不表示音質或發音更好。
因此查看速度數字時,要一併記下裝置、批次或串流模式、文字長度、暖機方式及統計值。排行榜以固定環境減少變因,適合在相同條件內比較;團隊要估算正式環境,仍須在預計部署的設備和併發量下量測。CPU、GPU、雲端共享資源與本機推論的時間不可直接互換。
SIM:複製聲音與參考音檔有多相似
聲音相似度(Speaker Similarity,SIM)通常透過說話者嵌入模型,把語音轉成代表聲音特徵的向量,再計算生成音與參考音向量的相似程度。排行榜的 SIM 可協助觀察語音複製模式是否保留參考聲音的說話者特徵,但分數高不等於複製結果完全準確,也不能證明聲音身分真偽。
嵌入模型本身有適用範圍,錄音長短、噪音、語言、說話內容和音訊品質都可能影響向量。相似度分數也不會完整描述停頓、語氣、情緒或口音是否符合需求。若產品不需要複製特定聲音,SIM可能不是選型核心;若需要,應搭配人耳檢查,並明確驗證參考音與實際內容。
「合成語音的評估很複雜,因為它涉及自然度、可懂度,以及是否達成預定用途等多個面向。」— Cooper 等人(2024),《A review on subjective and objective evaluation of synthetic speech》
三、多語言平均分為什麼不能直接當成通用答案?
不能。英文成績不能代替中文或其他語言;平均分還要確認採用哪些語言、資料集與加權方式。
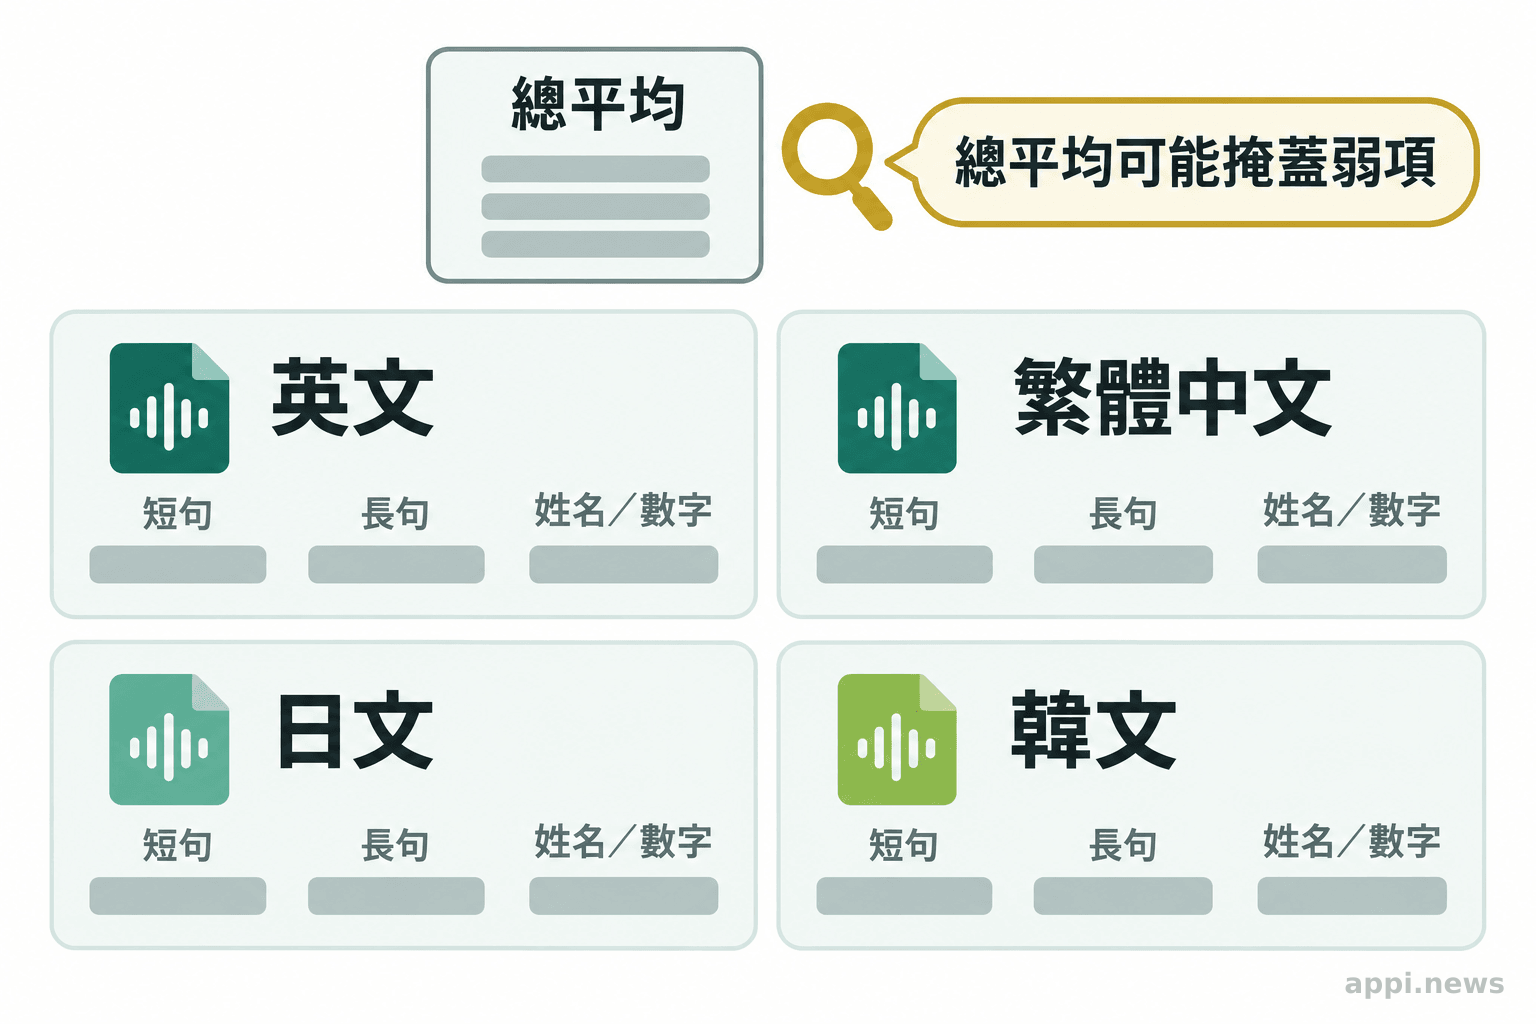
Open TTS Leaderboard 的多語言檢視讓使用者切換語言查看模型表現,部分測試集的語言覆蓋也不相同。官方說明指出,中文、日文、韓文採用 CER;跨語言的平均值則以各語言宏平均方式計算。宏平均讓每個語言分量相同,不會因某一語言的樣本較多就自然取得較大權重,但仍不能補足測試集沒有涵蓋的口音和文本型態。
分數應先回到單一語言和資料集判讀。假設英文模型分數良好,這只能說它在該英文測試條件下表現較佳,無法推出繁體中文、台灣口音或中英混讀也一樣。即使同屬中文,簡體與繁體用字、地名讀音、注音習慣、數字唸法和專有名詞,也可能使產品輸出與標準測試文本不同。
平均值也會隱藏失敗集中在哪裡。若測試中短句佔多數,長句的錯誤可能被平均沖淡;若常見詞很多,少數地名、品牌或人名的發音問題則不容易顯現。除總平均外,要檢查每個語言、資料集和句型的分數,並聽低分樣本與產品中的高風險文本。
四、分數以外還有哪些能力要自己聽、自己測?
還要聽自然度、韻律、情緒、停頓與長時間聆聽感受,並檢查模型在目標文本、設備和流程中的表現。
語音自然度包含音高變化、重音、停頓、連音和語氣是否符合上下文。資訊播報可能要求穩定、清楚;對話助理可能需要短等待和自然接話;教材則可能要求長時間聽不疲勞。相同聲音在一個用途下清楚合適,在另一種用途下仍可能顯得生硬。這些判斷需要人聽,也須讓聽者知道要評哪個面向。
聽感測試最好避免只問「哪個比較好聽」。可以把模型名稱隱藏,讓聽者聽相同文本,分別評分發音、自然度、語氣和指定聲音的相似程度。若不同聽者的偏好分散,記錄分歧也有用,因為它反映產品使用者可能重視的面向不同。若只蒐集一個總偏好票數,無法知道勝出的模型究竟在哪裡更合適。
ASR 評分器也可能造成模型間偏差。若某種口音或詞彙較貼近評分器的訓練資料,轉寫結果會較有利;另一種模型生成的聲音即使人聽得懂,ASR仍可能辨識錯誤。說話者嵌入模型也可能較擅長某些聲線或語言。當不同指標互相矛盾時,應回頭抽聽錯誤案例,查看正規化、錄音條件和評分器是否造成偏差,而非只看名次。
研究回顧指出,人工聆聽測試長期用來評估合成語音,但流程成本促使研究者發展自動指標;兩種方法各有角色。自動指標適合可重複的大量比較,人類聽者能判斷多個難以化成一個數字的感受。Hugging Face 也將排行榜描述為輔助人工偏好比較的工具,而非取代聽者判斷的結論。
「Open TTS Leaderboard 不會取代人類偏好排名。」— Hugging Face,Open TTS Leaderboard 官方介紹(2026)
評測腳本與設定的公開狀態也要分辨。Hugging Face 官方文章表示,評測腳本將開放,這是未來計畫的描述;撰寫或引用時不能把計畫寫成腳本已正式公開。使用者可先檢視排行榜目前提供的資料和聆聽功能,若要重現結果,應確認程式碼、模型版本、評測資料與參數確實可取得,再說明重現範圍。
五、依產品需求建立自己的比較流程
先按實際語言與內容篩選候選模型,再於目標設備上用同一批文本測速度、聽感和錯誤,最後核對授權與聲音資料同意。
產品條件要先具體化:服務對象說什麼語言、會唸哪些專有名詞、文字平均多長、是否中英混讀、一次產生整段或邊生成邊播放,以及預計部署在何種設備。把條件寫下來後,榜單才能用來找到候選,而不是讓排行榜的排序替團隊決定需求。
建立同一批測試文本
整理產品真實會遇到的文字,至少包含一般句、長句、姓名與地名、數字、縮寫、英文混入和標點停頓。文字須先確認讀法,否則把內容錯誤當成模型失誤,或把模型漏讀錯誤當成文本本身歧義。團隊可為每段指定預期讀音,將錯誤分類為漏字、讀音、語氣、停頓或不該生成的聲音。
候選模型使用同一批文字與相同設定,保留生成音檔、模型名稱和版本、參數、硬體、執行模式及時間紀錄。速度測試要說清批次或串流條件,並在實際預計部署的硬體上重測。不同設備、不同併發量和不同工作負載的成績不可直接交換。
依用途比較分數和實際輸出
用 WER/CER 看文字內容可懂度的線索,檢查錯誤落在哪些詞;用 RTFx 評估批次生成吞吐,用 TTFA 評估互動流程的起音等待;只有在需要複製指定聲音時,再看 SIM。接著抽聽正確與錯誤樣本,確認分數差異是否真會影響使用者。可將各面向分開記錄,不要把不同單位硬加成總分。
選型還包括模型權重和聲音資料能否合法使用、是否允許商業用途、依賴的執行環境、部署成本與維護責任。開放權重不代表所有素材和使用方式都不受限制;授權條款需逐一確認。若採語音複製,測試或部署前應確認錄音素材的授權、說話者明確同意、用途範圍、資料保存期限與刪除方式,並限制誰能存取原始音檔和複製後的聲音。
- 列條件:寫明目標語言、文本類型、長度、串流需求、延遲門檻和預計設備。
- 選模型:用排行榜相同語言與對應指標縮小候選,記下測試集、模型版本及限制。
- 同條件實測:以產品文本在目標硬體生成,記錄 WER/CER、RTFx 或 TTFA,並保存音檔。
- 盲聽與分類:依可懂度、自然度、韻律、停頓和聲音相似度分項評估,檢查失敗樣本。
- 確認可用性:核對模型和聲音素材授權、說話者同意、資料處理方式及整合維護成本。
選定候選後,先用產品實際會遇到的語言、文字和設備做同條件試聽,再分別記錄可懂度、聲音相似度、等待時間和人工偏好。這些結果能讓團隊知道模型在哪些條件下合用,也能在模型更新或設備改變時重新檢查;榜單提供比較起點,最後的判斷仍要落在實際流程。
常見問題:排行榜分數能代表自然度嗎?中文模型要看哪個指標?
排行榜的 WER/CER、速度和 SIM 各自回答有限問題;中文可先看 CER 與中文音檔,再依產品目標測自然度和延遲。
常見問題
Q1:WER 或 CER 越低,聲音就越自然嗎?
不是。它們比較辨識結果與輸入文字的差異,主要提供內容可懂度的線索。語音是否自然、停頓是否合適,仍需聽實際輸出或使用合適的聽感評估方法。
Q2:中文文字轉語音模型要看 WER 還是 CER?
Open TTS Leaderboard 對中文採用 CER。閱讀成績時要確認語言、資料集和文字正規化方式,並補測繁體中文、台灣姓名、數字、中英混讀等實際文本。
Q3:SIM 分數高,可以證明複製了本人聲音嗎?
不能。SIM估計合成音和參考音在說話者嵌入空間中的相似程度,不是身分真偽證明,也不代表所有聽者都會判斷為同一個人。語音複製應同時處理授權、同意和資料保存。
Q4:TTFA 和 RTFx 哪個比較重要?
依工作流程而定。互動式語音服務常關注首段音訊等待時間,可看 TTFA;大量離線旁白則可看 RTFx 和總完成時間。兩者都要在預計部署設備及相同工作負載下重測。
Q5:官方提到的評測腳本已經公開了嗎?
官方介紹將開放腳本寫作後續計畫。若要重現特定數字,應先確認目前可取得的程式碼和設定,再記錄資料集、模型與參數版本;不能只憑未來式描述認定已正式提供。
參考來源
- Bezzam, E. (2026). Open TTS Leaderboard: Scalable Evaluation for Multilingual Text-to-Speech and Voice Cloning. *Hugging Face Blog
- Hugging Face. (2026). Open TTS Leaderboard. *Hugging Face Spaces
- Cooper, E., Huang, W.-C., Tsao, Y., Wang, H.-M., Toda, T., & Yamagishi, J. (2024). A review on subjective and objective evaluation of synthetic speech. *Acoustical Science and Technology, 45*(4), 161–183