
Hugging Face 於 2026 年 10 月 29 日發布 Mistral Large 4(Le Chonk)的 Inference Endpoints 配方,使用 8 張 NVIDIA H200 與 FP8 權重。該平台報告此特定配置可開放最多 131K 上下文、同時處理 16 個請求。這是端點配方及平台測試結果,不是通用硬體清單。
同日 Hugging Face 另列 vLLM 的 H200 NVFP4 配方,與上述 Inference Endpoints FP8 端點是不同部署路徑。企業比較 API 與自有 GPU,應先確認工作負載和服務目標。
token 是模型處理文字的基本單位,輸入與輸出量會影響算力及 API 帳單。
同樣是開放權重,部署規模仍取決於模型檔、量化版本與授權。先前的 Mistral Large 4 部署評估整理了權重釋出前的試算條件;正式釋出後,團隊還需按實際版本驗證成本。
開放權重不等於低成本自架
權重可下載不代表一般工作站能承載完整模型與服務負載。 Mistral 10 月 6 日 preview 模型文件列出 1.05 兆總參數、52B active parameters 與 1.6B 視覺編碼器;這是預覽階段資料。10 月 29 日 Hugging Face 發布文描述釋出版本每 token 約啟用 49B,並另述架構中的 embedding 與輸出層。兩份文件的數字及敘述口徑不同,現有資料不能據此斷定差異由哪些層計算造成。活躍參數是每 token 參與運算的部分,不能代表完整權重的記憶體需求。
Mistral 10 月 6 日 preview 公告稱,預覽模型從頭訓練使用歐洲自有資料中心的 3,800 張 NVIDIA Grace Blackwell GPU。這是廠商對預覽階段訓練環境的說明,不是釋出權重的推論需求。MoE(混合專家架構)會依 token 選擇部分專家運算,但部署仍須載入或分散儲存大量專家權重。
Mistral 文件標示 1M context window(上下文視窗);Hugging Face 10 月 29 日的 H200 Inference Endpoints FP8 配方設定上限 131K。模型規格與特定端點實際開放長度不同,長對話仍須檢查檢索品質、延遲與記憶體。
第二個案例中,llama.cpp 團隊在 512GB 統一記憶體的 M3 Ultra 測試 Q2_K 量化版,Hugging Face 報告輸入約 90 token/秒、生成約 15 token/秒。這只反映該硬體和量化設定,尚未證明長上下文或多使用者服務適用。量化以精度、相容性或速度取捨換取較低記憶體占用。
「52B active parameters and 1.05T total parameters」是 Mistral 模型文件列出的兩種規模;部署評估必須分開看計算量與權重容量。(Mistral AI 模型文件)
部署預算要拆成硬體、工具鏈與維運
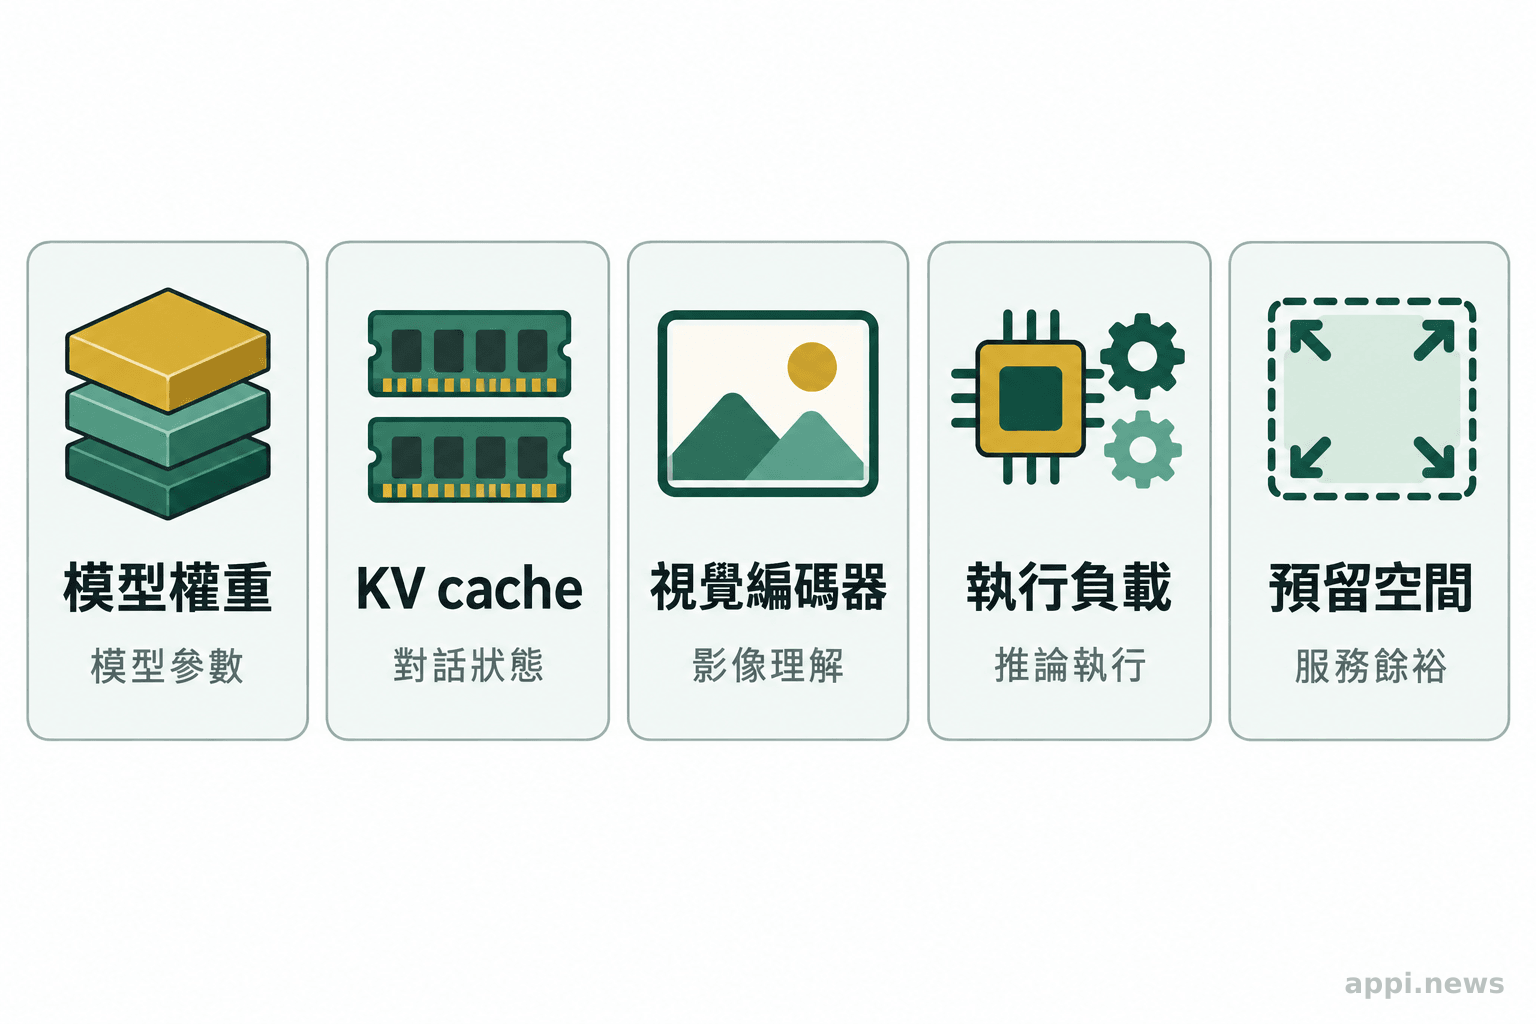
除了 GPU,還要估算權重與快取記憶體、儲存、網路、供電、推論框架、監控、資安及維運人力。 長上下文和同時請求會增加 KV cache(保存對話中間狀態的記憶體)與服務資源需求,實際容量須以模型版本、精度及上下文長度測量。
第一個案例是 Hugging Face 10 月 29 日 Inference Endpoints FP8 配方:平台以 vLLM、8 張 H200、張量/專家平行化及 speculative decoding(投機解碼)測試。其報告列出 1K 輸入單請求首 token 約 0.6 秒,1,000 段 ShareGPT 負載總生成約 480 token/秒。這是平台報告的特定測試結果。
平台測試不是獨立驗證,也不代表企業自身工作負載的效能。第三個案例是 Dell Enterprise Hub 的 NVIDIA B300、4 GPU、NVFP4 部署配方;Hugging Face 提供執行命令,但未在該段報告實測結果,因此不能由配方推斷成本或服務效能。
vLLM、SGLang 的相容性會隨模型、硬體與版本改變。應先確認啟動路徑,再測載入、延遲、吞吐、記憶體及故障恢復。地端 AI 部署成本估算可補充成本拆解。
自架、託管與 API 要用同一把尺比較
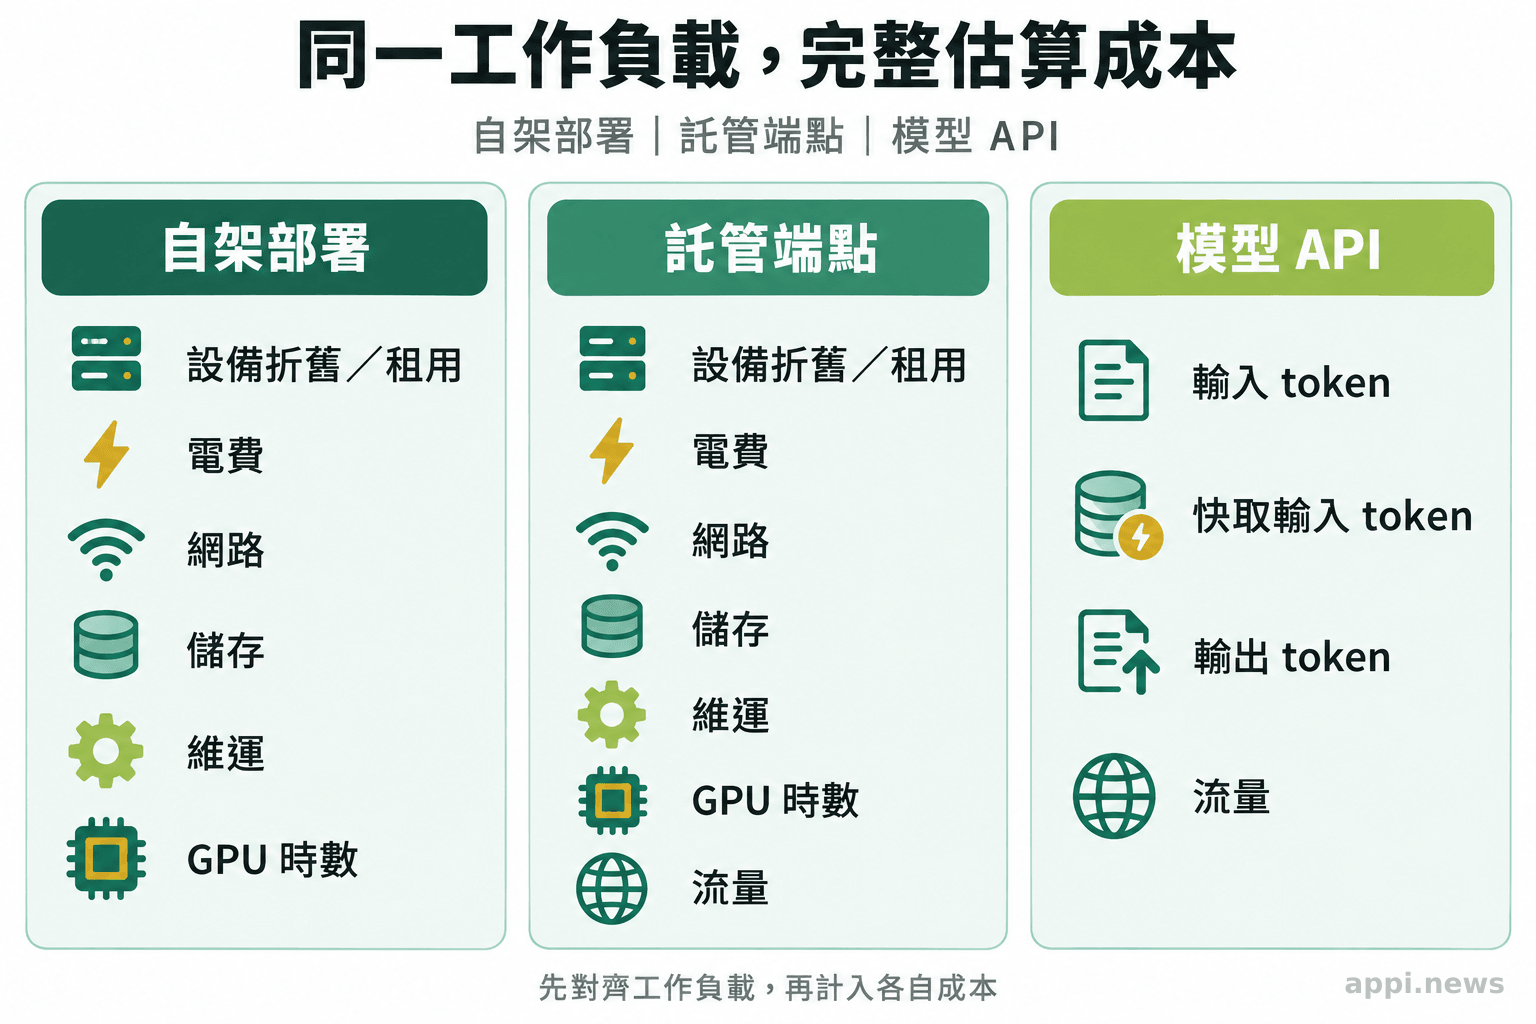
以相同的請求量、輸入輸出 token、尖峰並發、延遲目標與資料條件估算每月總持有成本。 自架要計入設備折舊或租用、電力、網路、儲存、待命容量和人力;託管要納入 GPU 租用時數、儲存與流量;API 則依實際輸入、快取與輸出用量計價。
Mistral 發布時公布的 API 基準價為每百萬輸入 token 0.70 美元、快取輸入 0.07 美元、輸出 2.10 美元;價格會變動,估算時應查採購當下費率。自架則須計入閒置容量、擴充與故障處理,即使設備已購置也有成本。
可用簡化公式對齊口徑:每月總成本=設備折舊或租用+電力網路+儲存+維運+監控備援,再除以通過品質門檻的有效任務數。API 另按輸入、快取輸入及輸出 token 分項估價。
授權是成本與產品設計的一部分。模型採 Mistral Ecosystem Open-Weight License;Mistral 釋出公告指出,Model-as-a-Service 需另取得商業授權。實際權利與限制須依授權原文及服務型態核對,不能只依公告概述推定特定內部使用或官方產品例外適用。產品透過 API 對外提供能力時,也應檢查授權定義及條款;開放權重模型的授權與部署限制可作為檢查提醒。
| 比較面向 | 自架 | 託管端點 | API |
|---|---|---|---|
| 費用項目 | 設備折舊或租用、電力、網路、維運 | GPU 時數、儲存、流量 | 輸入、快取輸入與輸出用量 |
| 容量與閒置 | 自行預留尖峰容量,低載時仍有成本 | 依服務計價,須確認擴縮與最低用量 | 按用量計費,尖峰容量由服務商承擔 |
| 資料控制 | 可自行決定環境與資料流程 | 依供應商部署及留存選項 | 依 API 資料政策與契約 |
| 維運責任 | 組織負責硬體、更新、監控與事故 | 供應商維護平台,組織仍管模型使用與資料 | 供應商維護服務,組織管理資料及應用 |
| 較適合的條件 | 用量穩定且有團隊維運 | 需要部署控制但不想自管整套硬體 | 用量波動或希望減少推論維運 |
開放權重讓組織自行選擇部署位置及客製方式,但資料治理仍由使用者負責,包括存取權限、日誌管理、更新修補、提示注入防護與事故處理。也可比較具備資料留存選項的託管服務。
「Open models let security researchers and developers inspect, adapt and build on AI.」(Kari Briski,NVIDIA 開放模型與軟體副總裁;引言見 Mistral 發布說明。)開放帶來檢視與調整空間,實際治理責任仍由部署方承擔。
哪些團隊適合先做部署試算
資料需要留在自有環境、用量穩定,且已有 GPU 與推論維運能力的團隊,可先試算自架;需求波動大或缺少相關經驗者,宜同步比較託管及 API。 判斷核心在請求型態、資料控制要求、可用設備與維運責任是否相符。
小規模驗證可選程式碼檢查或文件問答,固定資料、提示詞、輸入長度、輸出上限與並發。記錄品質、拒答、首 token 時間、生成速度、記憶體和故障率,再以同一任務測 API 或託管版本。若量化造成品質不符,節省的 GPU 空間也無法形成可用服務。
可由熟悉業務的人盲測程式修補或文件檢索結果,檢查引用來源與欄位正確性;模型啟動不代表品質和可追溯性達標。
推論吞吐與延遲要分開看:合批可能提高 token 產出,也可能增加排隊或首 token 時間;長上下文通常更耗資源。把測試結果帶入每月用量,比較總支出與每個有效任務成本。
部署前檢查清單與常見問題
先確認授權是否涵蓋預定服務方式,再用目標硬體與代表性任務驗證模型、推論框架和服務水準。 模型卡中的單一配置是起點,不能代替組織自己的成本與資安審查。
-
整理近一個月請求量、輸入與輸出 token、尖峰併發、上下文長度及延遲要求。
-
選定要測的權重精度和框架版本,確認 GPU 記憶體、主機記憶體、儲存與網路容量,保留升級和高峰空間。
-
以相同資料與提示詞測試自架、託管和 API,記錄品質、速度、失敗率及各方案費用。
-
把設備折舊、閒置、電力、人力、監控、備援、資安維護與授權條件納入月成本。
-
確認誰負責模型更新、存取權限、日誌管理、事故處置及停止服務時的資料清理。
- 52B 活躍參數描述每 token 的運算規模,不能代表整份模型權重只需同等規模記憶體。
- 官方或平台提供的硬體示範有特定量化、上下文與並發條件,需在目標工作負載上重測。
- 比較方案時,同時計入使用量、閒置容量、人力、安全責任和授權,而非只比 GPU 租金與 API 單價。
常見問題
Q1: Mistral Large 4 的 52B 活躍參數,是否代表需要 52B 參數的顯示卡記憶體?
不是。活躍參數是每 token 參與運算的部分;模型總權重、精度、KV cache、上下文長度與並發都會影響記憶體需求,應以實際部署配置測量。
Q2: 量化後可以在單台個人電腦執行嗎?
Hugging Face 報告在 512GB 統一記憶體的 M3 Ultra 上測試 Q2_K,但這只是特定量化的本機案例,速度與品質未必適合正式服務。先確認輸出品質和任務延遲是否達標。
Q3: 使用開放權重提供企業服務,需要另買授權嗎?
不能只憑「企業內部」或「透過 API」判斷。Mistral 公告指出 MaaS 需另取得商業授權,應將預定服務型態逐條對照授權原文,必要時向權利方確認。
參考來源
- Mistral AI (2026). [Introducing Mistral Large 4]()
- Mistral AI (2026). [Mistral Large 4 - Mistral AI | Mistral Docs]()
- Hugging Face (2026). [Welcome Le Chonk: Mistral Large 4 on Hugging Face]()
- Mistral AI (2026). [LICENSE · mistralai/Mistral-Large-4-1T-A52B at main]()
- vLLM (2026). [vLLM documentation]()
- SGLang (2026). [SGLang documentation]()


