
看到 Apple 列出 Mac Studio 可承載最高 4800 億個啟動參數、Mac Studio 叢集可擴展到 1.6 兆個啟動參數,很容易把它當成採購答案。這些數字回答的是特定配置下的模型規模參考,還沒有回答模型能跑多快、能否同時服務多人,以及整體成本是否合算。估算地端 AI,第一步要把「能裝得下」和「適合日常使用」分開。
相較於 PrismML 眼鏡端小模型的案例,這次的問題往上移到桌上型 Mac 與叢集能承載多大的模型。這是硬體與軟體部署評估,不涉及醫療或藥理建議。
一、參數規模能回答什麼,不能回答什麼?
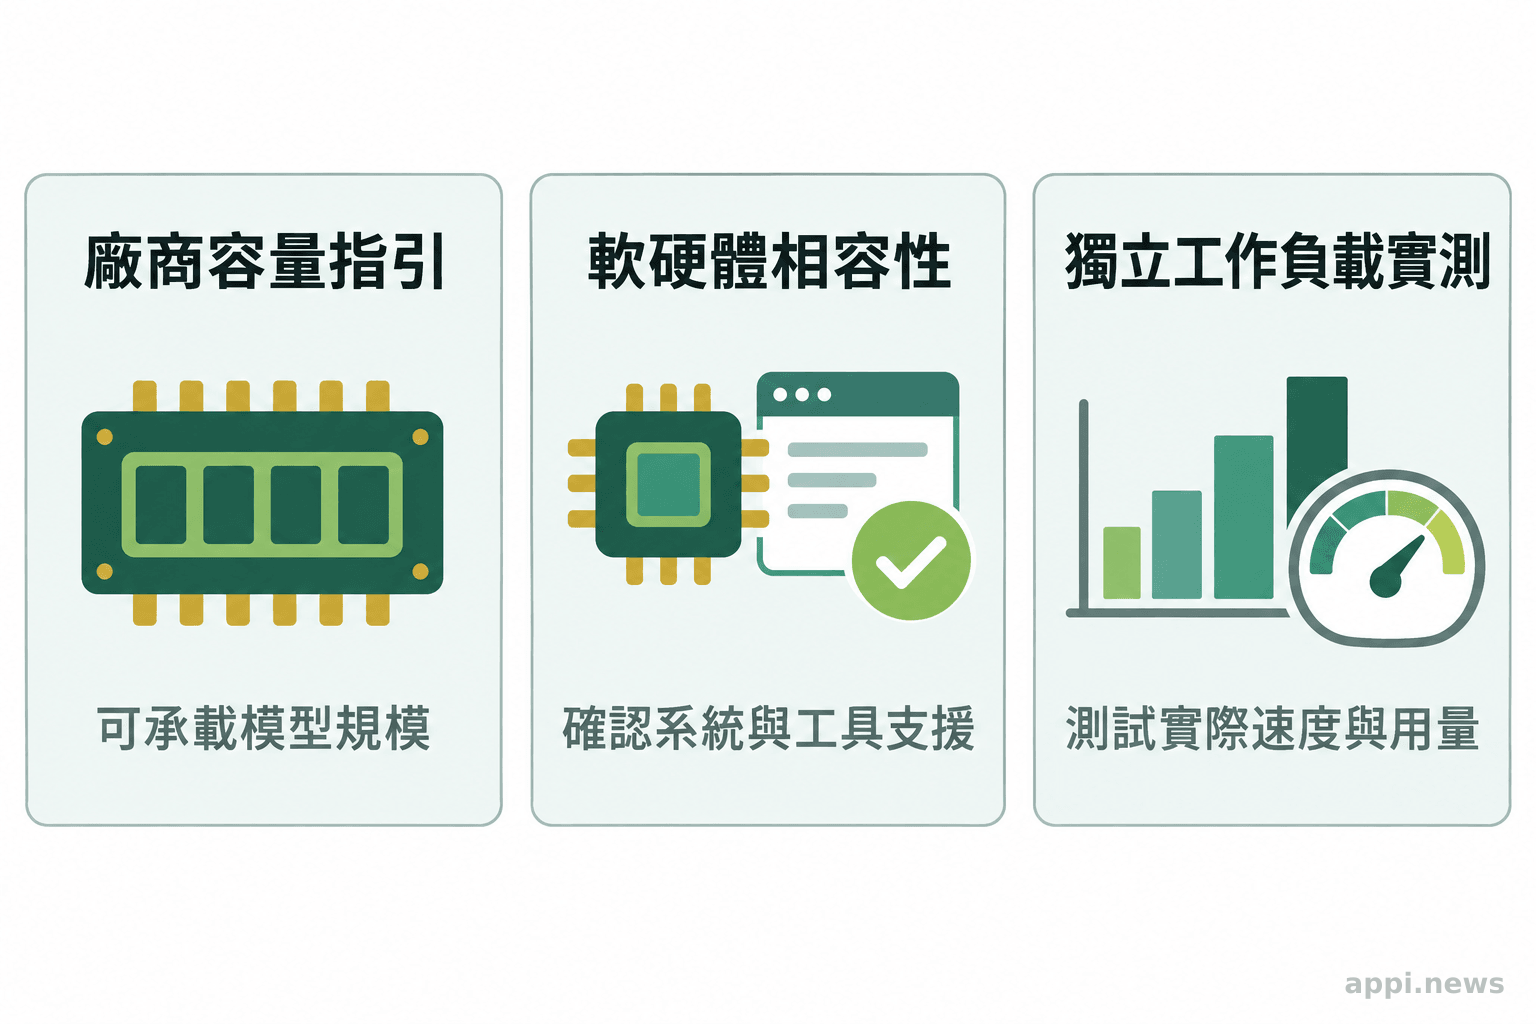
Apple 的數字可作為裝置選型的起點,不能單獨證明推論速度、回應品質、併發能力或總成本。它描述的是廠商所列配置可承載的模型規模,不是對所有模型和使用情境的效能保證。
Apple列出的Mac mini、Mac Studio與叢集數字
Apple Education Community 的教育部署文章列出,搭載 M5 Pro 的 Mac mini 可支援最高 700 億個啟動參數;M5 Ultra Mac Studio 可支援最高 4800 億個,Mac Studio 叢集則可擴展至 1.6 兆個啟動參數。
Apple 另在產品資訊中列出 M5 Ultra Mac Studio 最高 512GB 統一記憶體、每秒 1.2TB 記憶體頻寬。這些是 Apple 對自身平台的部署說明,讀者應把它們視為容量參考,再確認目標模型、精度和軟體支援是否吻合。
這裡的「啟動參數」尤其需要留意。混合專家模型(Mixture of Experts,MoE)每次處理 token 時只會啟動部分專家計算,因此每個 token 的啟動參數可能遠小於模型總參數。DeepSeek-V3 技術報告舉例指出,模型有 6710 億個總參數,每個 token 啟動 370 億個。啟動量和計算量有關,但部署時仍須存放大量模型權重;不能看到啟動參數低,就假設記憶體需求也按同一比例下降。
官方說明、社群圖表與獨立實測要分開看
網路上流傳的裝置能力圖表包含不同產品線的數字,但其中部分並未出現在 Apple 的正式產品文件。Apple Education Community 對 Mac mini、Mac Studio 與叢集所列的數字,可以明確歸因為 Apple 教育社群的部署指引;其他欄位若找不到相同的一手說明,就不應當作已由 Apple 全面背書。本文聚焦在可追溯的 Mac 數字,不以未確認的完整矩陣推論所有裝置。
「M5 Ultra 配置可支援最高 4800 億個啟動參數,Mac Studio 叢集可擴展至 1.6 兆個啟動參數。」— Apple Education Community(教育部署說明,本文譯述)
「671B total parameters with 37B activated for each token.」— DeepSeek-V3 技術報告(本文譯述:總參數 6710 億,每個 token 啟動 370 億)
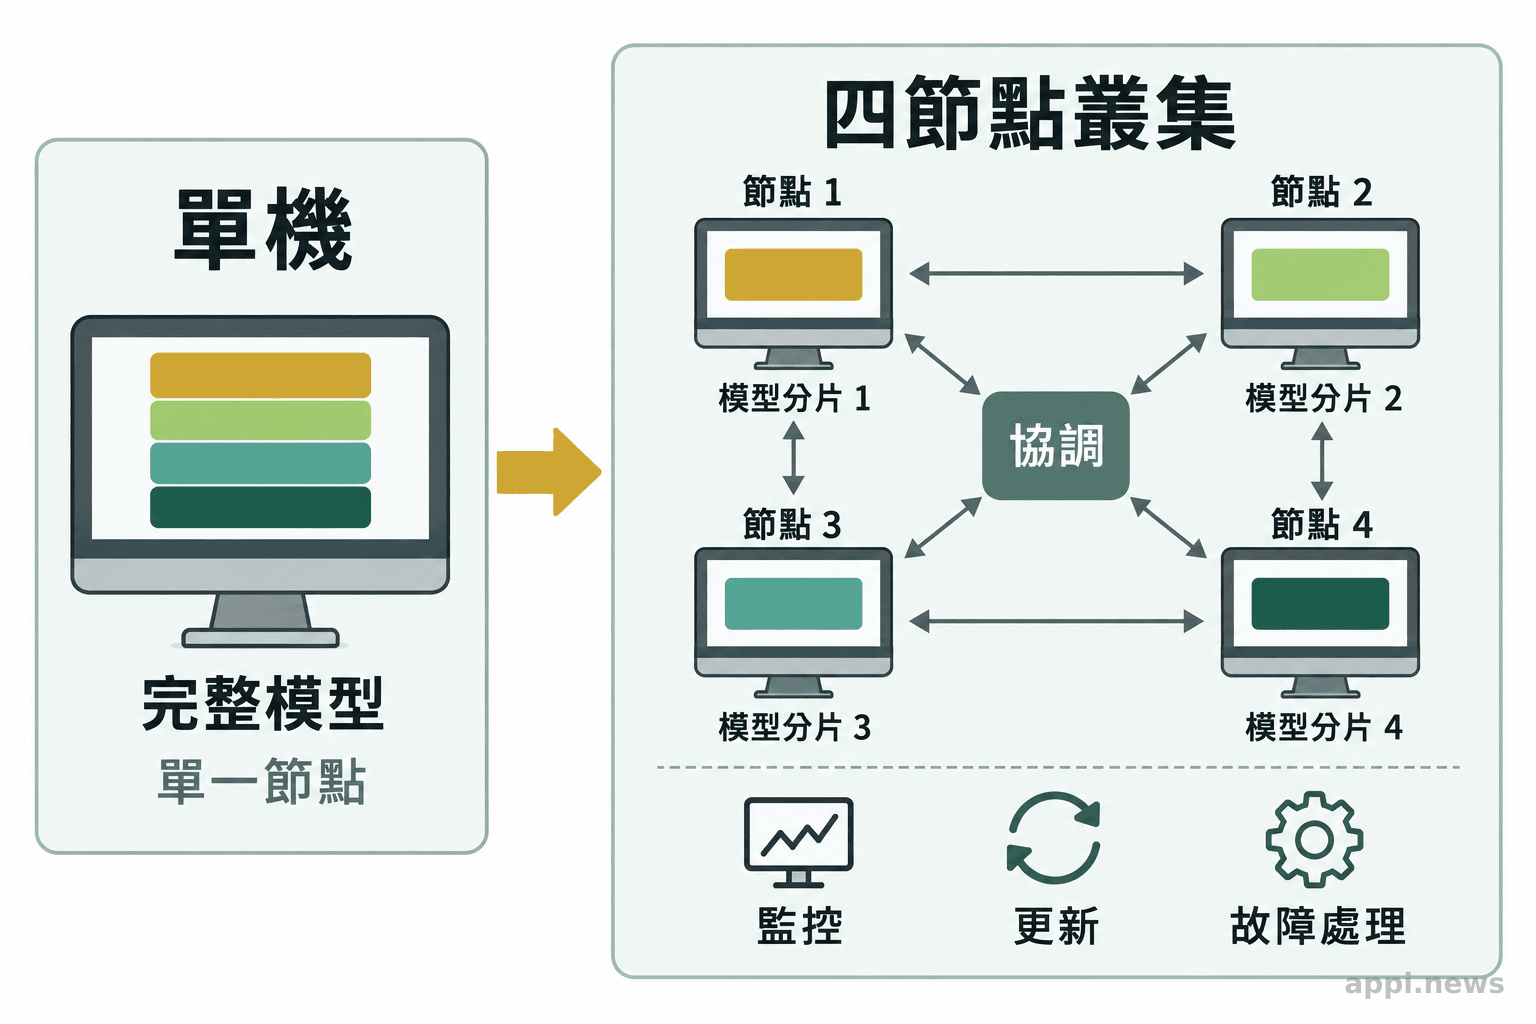
Apple 在 WWDC 的分散式推論示範也揭示叢集數字背後的條件:多台 Mac 需要以 Thunderbolt 5 連線、啟用 RDMA(遠端直接記憶體存取),再由 MLX 等軟體安排模型切分和節點協調。Apple 展示四台 M3 Ultra 以分散方式執行 270 億參數模型,生成速度接近單機的三倍;這是特定模型、硬體與軟體組合的示範結果,不能外推為所有叢集都會有相同倍率。
二、從模型參數走到記憶體需求,中間還差哪些條件?
參數量只能粗估模型權重的儲存空間,實際配置還要加上量化格式、上下文快取、執行框架和其他程序占用。可用記憶體必須留有餘裕,不能把機器標示的統一記憶體容量全數算給模型。
總參數、啟動參數與量化
估算權重容量時,可先用一個粗略的心算方式:若每個參數以 16 位元儲存,十億個參數的權重約需 2GB;若採 8 位元,理論上約需 1GB;4 位元則約 0.5GB。這只是未計入額外結構與執行需求的簡化估值,實際檔案和載入後佔用會因模型格式、量化方法及框架而不同。
量化是用較少位元表示模型權重,以降低記憶體占用。位元數越低,通常越省空間,但不同量化方法造成的品質變化並不相同,還要以目標任務驗證。MoE 模型的啟動參數主要說明每次計算會動用哪些部分,並不代表其餘專家權重可以不載入;某些執行方式可採分層或卸載,但會改變速度與資源需求。因此選型時,要取得模型卡上的總參數、啟動參數、權重格式和授權條款,而非只比名稱中的 B 數字。
上下文長度、快取與執行環境
上下文長度指模型一次處理的輸入與對話歷史範圍。長文件問答、程式碼代理或多人同時對話,都可能需要保存更長的鍵值快取(KV cache),它會隨 token 數、模型架構和同時請求量增加。某些執行框架能量化快取以省記憶體,但可能限制批次處理或影響速度;因此不能只用模型權重大小估算峰值用量。
統一記憶體讓處理器和圖形處理器共用同一記憶體池,適合把較大的模型放進單一系統,但作業系統、應用程式、資料載入和快取也會使用這個空間。模型格式、執行框架、驅動或作業系統版本也決定某個模型能否順利執行。試算表至少應分列權重、上下文快取、執行程序與保留餘裕,再在實機記錄載入後和高峰時的記憶體用量。
三、單台Mac Studio與多機叢集,部署問題有何不同?
叢集可把模型分散到多台機器,擴大可用記憶體或提高特定工作負載的吞吐量;同時也新增網路傳輸、節點協調、軟體相容和故障處理。單機與叢集要分別用實際工作負載測試,不能把記憶體容量相加後就視為部署完成。
叢集增加容量,也增加網路與協調成本
Apple Developer 的 WWDC26 說明,Mac 叢集以 Thunderbolt 5 做節點間連線,RDMA 可讓資料在機器間直接傳送,MLX 則提供分散推論和模型切分方法。網路拓樸會影響節點間傳輸時間;模型切分方式也有不同的同步需求。每個節點還要安裝相容的系統與執行環境,設定主機連線、權限、日誌和更新流程。
這使叢集維運近似管理一套小型分散式系統。要先確認應用能否跨節點執行、模型權重如何切分、節點失聯時請求怎麼處理,以及是否能在不中斷服務的情況下更新。連線增加後,故障定位和備援也比單機複雜;如果模型能在一台設備上以可接受速度運行,叢集帶來的管理負擔未必值得。
延遲、吞吐量與併發要用實際工作負載驗證
互動式助理在意首 token 等待時間和每秒生成 token 數;多人共用服務則在意尖峰時段吞吐量與排隊時間。批次摘要、文件分類或夜間資料處理通常較能容忍較長延遲,卻可能要求大量併發。三種負載不應只拿同一個 benchmark 分數來判斷。
試跑時固定模型版本、量化方式、提示長度與輸出長度,逐步增加同時請求數,記錄首 token 延遲、生成速度、錯誤率、記憶體峰值和耗電。另以代表性問題評估答案品質,確認量化或上下文縮短沒有讓結果偏離需求。Apple 公布的參數容量沒有代替這組實測;使用者要用自己的工作流確認體感速度與品質。
四、地端部署的成本要怎麼估?
應以相同工作量和服務水準比較本地設備與雲端方案,並把硬體採購、電力、空間、維護、人力、更新和使用量放進總持有成本。地端可減少部分資料外傳或按量計費需求,但不等於沒有資安和管理成本。
設備、電力、空間與維運人力
設備成本不只是主機價格,還包括記憶體與儲存配置、網路線材、交換設備、備援機、保固和汰換週期。Mac Studio 的官方規格提供最大持續功耗等資料,可用來估算用電上限;但日常耗電仍應以實際負載和電表量測。多台機器也需要考慮散熱、噪音、供電、桌面或機櫃空間。
人力則用於模型下載與更新、相容性處理、權限控管、備份、監控、故障排查和使用者支援。若只有少數人偶爾使用,固定投入一套叢集可能比雲端按量付費更難攤平;若工作量穩定、資料不能離開內網,則可以把設備折舊和維護工時計入相同的每月成本,再與雲端用量估算比較。成本結論會受利用率、電價、服務時段和維護方式影響,不能只用每 token 標價或採購單價下結論。
| 選項 | 主要適用條件 | 成本與風險需確認 |
|---|---|---|
| 單台 Mac | 模型可在單機記憶體內執行,負載以個人或小組為主 | 前期採購、記憶體配置、設備折舊、單機故障時的服務中斷 |
| Mac 叢集 | 單機容量或特定吞吐量不足,且軟體支援分散執行 | 多台設備、連線與電力、節點管理、維運人力和分散計算效率 |
| 雲端服務 | 用量變動較大,或需要由服務商管理運算設備 | API 或訂閱費、資料傳輸、用量尖峰、價格變更和資料處理條款 |
與雲端服務比較總持有成本與資料治理需求
雲端服務通常有 API 用量或訂閱成本,也可能有最低承諾、資料傳輸和供應商價格變動風險;本地運行則將部分支出轉為前期硬體和持續維運。要比較同一期間的總支出,可估算每月輸入與輸出 token、尖峰併發、模型更新頻率、可接受停機時間,再將設備折舊、用電與人力分攤進去。
地端處理可讓資料留在組織管理的設備上,但資料是否真正留在本地,還取決於應用是否呼叫外部服務、日誌包含哪些內容、模型更新從何處下載及管理者如何設定。導入前要檢視模型授權、資料存取權限、網路隔離、日誌保存期限與更新責任。若使用者能任意把機密文件送進未管理的本地服務,物理位置本身並不會自動形成資料治理。
地端 AI 部署不涉及藥品、保健食品或疾病治療交互作用;安全評估應聚焦模型授權、資料存取權限、網路隔離、日誌保存與更新責任。
五、採購前如何設計一個可驗證的試跑?
先寫清楚要執行的模型、使用人數、資料限制、品質門檻和可接受延遲,再以真實但已去識別的代表性工作負載測試單機、叢集與雲端選項。只有當效能、穩定性、治理要求和總成本都符合條件,才有足夠依據進入採購評估。
先定義模型、使用者數與品質門檻
試跑不必一開始就買最高階配置。先列出候選模型的版本、模型卡、總參數與啟動參數、精度、授權和所需執行框架;再定義資料集大小、提示與上下文長度、每日使用量、尖峰同時人數,以及回答錯誤或超時的可接受比例。這些條件能避免拿不相干的公開測試分數代替實際需求。
可以先以一台現有設備或短期雲端環境建立基準,再比較目標 Mac 單機與叢集。測試資料應能反映真正要處理的問題,例如文件摘要、內部知識問答或程式輔助,並避免將未授權或含個資的內容放進未核准的測試環境。若模型授權不允許預定用途,也不應因硬體能載入就列為可採用選項。
量測速度、穩定性、成本及資料存取範圍
- 固定模型、量化、上下文長度和軟體版本,記錄硬體配置與可用記憶體。
- 以相同提示和輸出要求執行單人、尖峰併發及批次工作,量測延遲、吞吐量、錯誤率、記憶體峰值和耗電。
- 抽查答案品質,並測試長時間運行、節點中斷、程序重啟和模型更新後的恢復情況。
- 追蹤資料流向,檢查模型下載來源、外部連線、存取權限、日誌內容與保存政策。
- 將設備折舊、用電、空間、維運工時、雲端用量和更新週期換算成相同期間的成本,再決定是否擴大部署。
試跑報告應保留測試條件,否則後續無法判斷結果是否適用於另一個模型或使用量。Apple Education Community 的模型規模指引提供了一個容量起點,完整評估仍須由模型授權、記憶體需求、實際延遲、節點管理與資料治理共同決定。對多數團隊而言,先列出模型、同時使用人數、可接受回應時間和資料限制,再用代表性工作負載比對單機、叢集與雲端的總成本,會比單看 480B 或 1.6T 更接近採購問題本身。
- 480B 與 1.6T 是 Apple 列出的容量參考,不能代表速度、品質或成本。
- 記憶體估算還要納入模型精度、上下文快取、併發請求和系統保留空間。
- 採購前以相同工作負載試跑單機、叢集與雲端,並計入維運和資料治理成本。
常見問題
Apple 列出的參數規模是廠商提供的配置參考;它不能代替速度、品質、記憶體餘裕和總成本的實測。部署選擇應從目標工作負載與治理限制開始。
Q1:Apple列出的模型規模是否代表推論速度?
不代表。參數規模主要說明某一配置的模型承載能力;推論速度還受到記憶體頻寬、模型架構、量化、上下文長度、執行框架與同時請求數影響。應以目標模型和實際提示測量首 token 延遲及生成速度。
Q2:參數量較大的模型是否一定比較適合本地部署?
不一定。模型大小不等於答案品質,也不會自動符合任務需求。較大的模型可能需要更多記憶體、電力與維運資源;先確認小一級模型能否達到品質門檻,再比較效能和成本。
Q3:什麼情況下多台Mac組成叢集才有評估價值?
當單機記憶體或吞吐量無法滿足需求,而且軟體支援分散執行、團隊也能維護節點時,叢集才值得試跑。評估時須量測節點傳輸和協調成本,並把連線、監控、更新及故障處理列入總成本。
參考來源
- Apple Education Community (2026). *Mac mini and Mac Studio for Education*. Apple Education Community
- Apple (2026). *Apple introduces M6 and M5 Ultra for a big leap in performance and AI compute*. Apple Newsroom
- Apple Developer (2026). *Explore distributed inference and training with MLX*. WWDC26
- DeepSeek-AI (2024). *DeepSeek-V3 Technical Report*. arXiv:2412.19437
- Apple (2026). *Mac Studio Technical Specifications*. Apple
- Woosuk Kwon, et al. (2023). *Efficient Memory Management for Large Language Model Serving with PagedAttention*. arXiv:2309.06180
- Elias Frantar, et al. (2022). *GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers*. arXiv:2210.17323


