
llama.cpp b11095 的重點,落在 Qualcomm Hexagon 裝置的本地推論路徑:新版本加入 HMX 最佳化的 GATED_DELTA_NET(閘控增量網路)與 hex-gdn 支援。這項變化真正關聯的是,使用特定模型與 Qualcomm 硬體的人,是否多了一條可測試的執行路徑,以及這條路徑能否改善實際工作負載。
Pull Request #29199 的作者在特定裝置、模型與設定下報告,這套 GATED_DELTA_NET 的 HMX 實作,prompt processing(提示詞處理)可觀察到約 1.5 至 3 倍差異。測試涵蓋 Galaxy S26、S25、S24、VentunoQ、IQ9 與 X2 Elite,模型則以 Qwen3.5、Qwen3.8 的部分蒸餾版本為主;這是測試條件下的結果,不是所有 Qualcomm 平台的固定倍率。
b11095 仍是預發行版本,是否值得升級,必須回到模型格式、裝置、驅動與工作負載逐項確認。
一、llama.cpp b11095 這次新增了什麼
b11095 新增的是針對 Qualcomm Hexagon 的 HMX 最佳化 GATED_DELTA_NET 路徑,以及名為 hex-gdn 的相關實作。 它屬於特定硬體後端的增量支援;全平台共用的推論加速開關,不能由這項變更直接推得。
HMX 最佳化與 GATED_DELTA_NET 支援
release note 以「new HMX-optimized GATED_DELTA_NET」描述變更,列出的工作包含 HMX 與 DMA 管線化、HVX threading、部分指數函數向量化與對齊讀寫。
hex-gdn 與 Hexagon 執行路徑的角色
這個執行入口的價值,取決於模型、後端與建置版本能否對上。即使同一款裝置都使用 Qualcomm 晶片,韌體、驅動、HTP 設定或編譯選項不同,也可能讓程式退回其他路徑;「支援 hex-gdn」代表可以進入測試流程,不代表每次執行都會自動使用 HMX。
二、GATED_DELTA_NET 為何需要專門的執行路徑
GATED_DELTA_NET 的工作組合包含閘控、狀態更新、增量計算與矩陣乘法,資料依賴和記憶體流動不只是一個規則 GEMM。 因此,直接把它當成傳統 Transformer 的單一矩陣運算處理,可能讓向量單元等待資料,或讓中間結果在不同記憶體層級間反覆搬移。
GATED_DELTA_NET 與傳統推論核心的差異
從這些提交項目可合理理解,GDN 推論有三條互相牽制的線:計算、資料搬移,以及控制各階段啟動與等待的同步。若三者以串行方式執行,運算單元再快,也可能把時間花在等待;這是依實作項目作出的工程解釋,不是 PR 另外宣告的獨立效能結論。
從資料搬移、向量化到管線化的底層優化
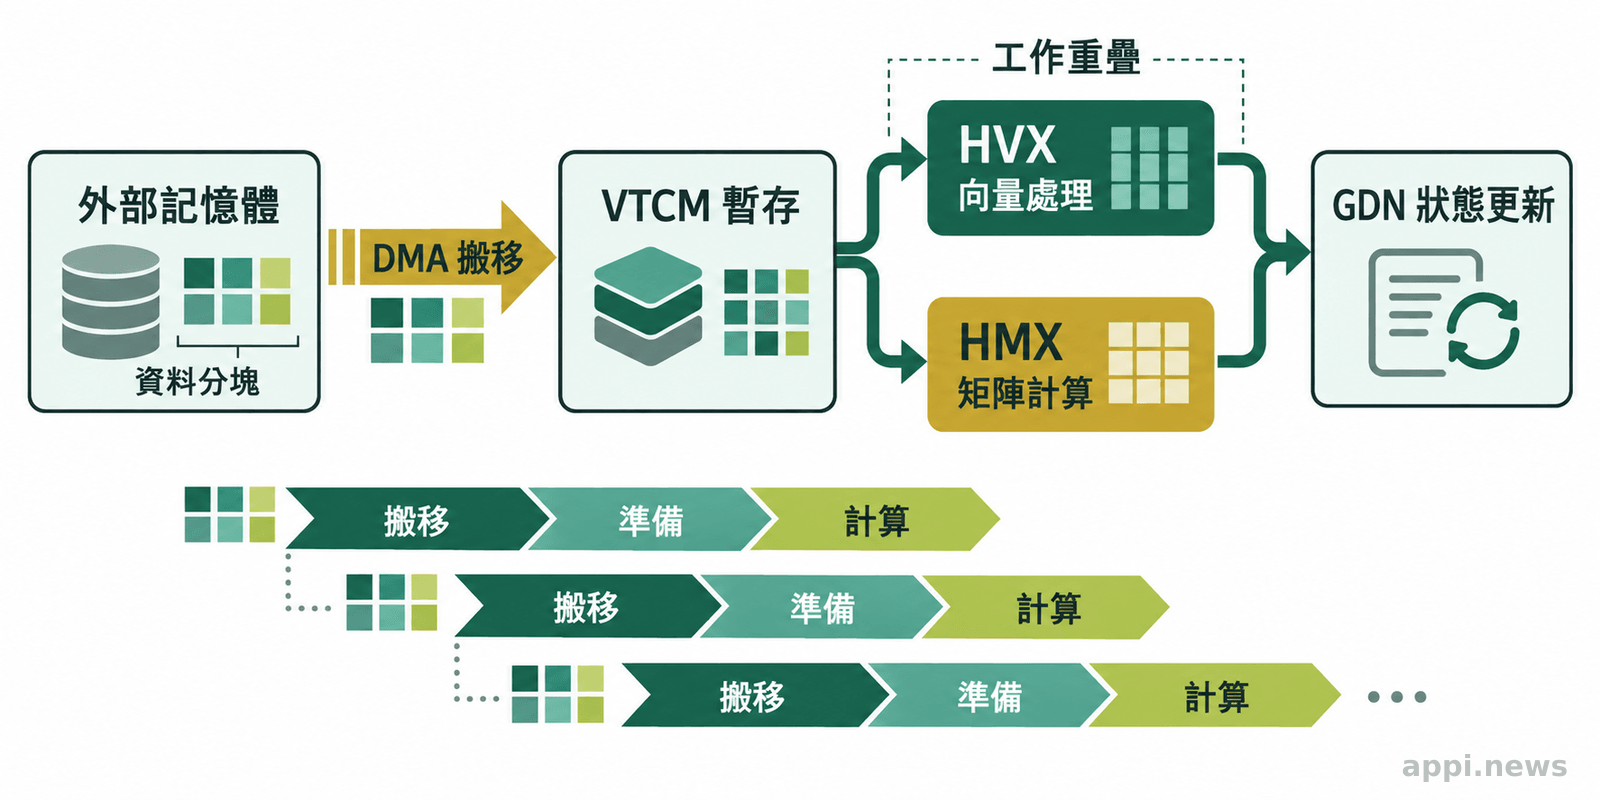
PR 列出的「pipeline HMX and DMAs」、「HVX threading」與「optimize GDN prep stage」,反映的正是這個根因。就該實作的資料流來看,HMX、HVX 與 DMA 分別承擔矩陣處理、向量化整理與資料搬移的協作工作。
前一批資料計算時,下一批資料可同步準備;這種優化要依 GDN 資料形狀與硬體容量調整,無法只靠提高時脈解決。
三、HMX、HVX、DMA 與 VTCM 如何分工
為便於理解,可把 HMX 概括為偏矩陣處理、HVX 概括為寬向量處理,VTCM 視為靠近向量單元的片上暫存空間,DMA 則負責記憶體層級間的資料搬移。 這是針對 hex-gdn 實作資料流的功能性描述,不是完整硬體規格,也不表示四者有固定且互斥的分工。
Qualcomm 的手冊將 HVX 描述為可進行 SIMD(單指令多資料)處理的向量擴充,並說明它與 VTCM 的資料流關係。VTCM 不是容量無限的快取,而是需要軟體安排資料布局的片上空間;b11095 提到重寫 VTCM layout handling、調整 scratchpad 對齊,顯示資料切塊本身也是效能因素。
DMA 也不只是「搬得更快」:資料要切成適合的區塊並安排時機,才能讓搬移、計算與下一階段準備重疊,同時增加同步與邊界處理的複雜度。
四、目前能看到哪些效能訊號
目前最明確的訊號在 prompt processing,token generation 則接近原有結果。 PR #29199 的 Galaxy S26 測試,使用 Qwen3.5、Q4_0 量化格式、GDN 路徑與 HTP0 裝置;這些數據適合用來理解方向,不適合當成所有手機的固定倍率。
prompt processing 與 token generation 要分開看
下表挑出同一份 PR 在 Galaxy S26、Qwen3.5、Q4_0、HTP0 與指定 prompt/generation 條件下的代表數據。pp 是 prompt processing,tg128 是 token generation 測試;左欄為 dma64 基準,右欄為 HMX GDN 實作,數值單位是每秒處理量。
| 模型與測試 | dma64 基準 | HMX GDN 實作 | 讀法 |
|---|---|---|---|
| Qwen3.5 0.8B Q4_0,pp1024 | 1,806.93 t/s | 3,477.30 t/s | prompt 處理約 1.9 倍 |
| Qwen3.5 2B Q4_0,pp1024 | 1,419.74 t/s | 2,427.21 t/s | prompt 處理約 1.7 倍 |
| Qwen3.5 4B Q4_0,pp500 | 614.91 t/s | 1,113.49 t/s | prompt 處理約 1.8 倍 |
| Qwen3.5 4B Q4_0,tg128 | 18.67 t/s | 18.43 t/s | token 生成近似,略低於基準 |
這組結果顯示,輸入長度改變時提升幅度也會變化;0.8B 模型在 pp1024 約 1.9 倍,不代表其他長度或模型都會維持同一比例。
官方測試數據的裝置、模型與工作負載限制
這些數字是 PR 作者在 Galaxy S26、Qwen3.5、Q4_0、HTP0 與指定輸入條件下的觀察,不是 llama.cpp 對所有 Qualcomm 平台的承諾。換模型大小、量化格式、韌體或批次設定,瓶頸就可能改變;即使同樣是 GDN 模型,也要確認運算圖走到相同後端。
PR 的 0.8B、2B 與 4B 測試中,tg128 都接近基準;長文件摘要等大量輸入任務較值得測試,逐 token 回覆的改善可能有限。
- b11095 的 HMX 支援主要對準 Qualcomm Hexagon 與 GATED_DELTA_NET。
- PR #29199 的明顯提升集中在 prompt processing,token generation 不宜直接套用同一倍率。
- 預發行版本應以相同模型、量化格式、輸入長度與裝置建立基準線,再決定是否升級。
「Pull Request #29199 的說明顯示,GATED_DELTA_NET 的 HMX 實作在不同模型與裝置上,prompt processing 可觀察到約 1.5 至 3 倍差異。」— llama.cpp Pull Request #29199
五、哪些本地部署者可能受益
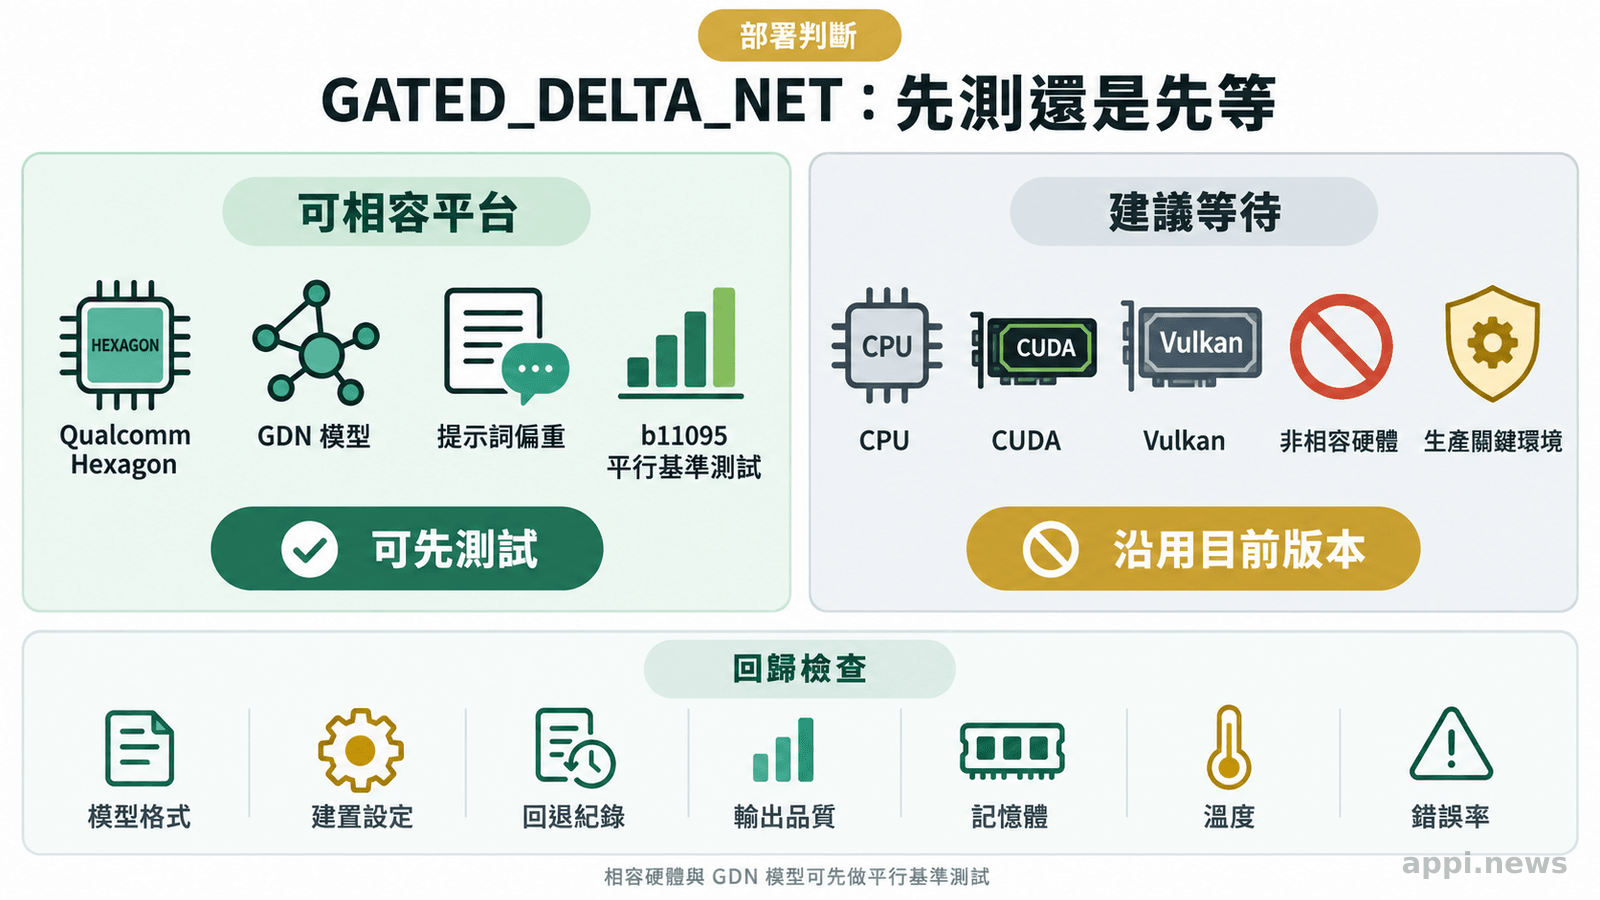
具備相容 Qualcomm Hexagon 裝置、使用 GATED_DELTA_NET 模型,且工作負載包含大量 prompt processing 的部署者,最適合優先測試。 其他平台使用者沒有必要因為版本號更新就改變既有環境。
適合立即測試的 Qualcomm Hexagon 使用者
可以先看三個條件:硬體是否能走相容的 Hexagon 後端,模型是否包含 GDN 結構並符合 GGUF、量化格式與參數配置,以及任務偏長上下文輸入還是逐 token 生成。缺少任何一項,PR 數據都很難直接套用。
相容的行動裝置部署者,若 prompt processing 變快,長文件載入、批次測試或上下文切換的等待時間可能縮短;即使速度沒有改善,測試也能確認模型是否真正使用 HMX GDN 路徑。仍須核對 Hexagon/HTP 編譯選項、驅動與執行記錄中的 fallback,單純替換 llama.cpp 執行檔不會補上缺少的後端能力。
不一定需要升級的一般 CPU、CUDA 或非相容裝置使用者
一般 CPU、CUDA、Vulkan 或非 Qualcomm Hexagon 使用者,不會因這次變更自動取得 HMX;不含 GDN 結構的模型也不會走同一路徑。現行環境若已符合需求,可等待後續版本的相容性與回歸結果。
六、現在該升級還是等待
適合相容硬體與 GDN 模型的測試者先建立平行基準線;生產環境與非相容平台則可等待後續版本。 b11095 是 pre-release,release note 將「pipeline HMX and DMAs」列為工作項目,顯示這部分仍在持續最佳化;它反映實作成熟度,不代表所有工作負載都偏慢。
升級前的相容性與回歸測試清單
- 先確認模型確實使用 GATED_DELTA_NET,並記下 GGUF 版本、量化格式與推論參數。
- 用
llama-bench固定-p的 prompt 長度與-n的生成 token 數,分別測試現行版本與 b11095。 - 至少選一個短 prompt、一個長上下文與一次實際任務,分開比較 pp 與 tg,不把單一 t/s 數字當成結論。
- 檢查結果是否能重複,並確認模型輸出、記憶體使用、溫度與錯誤率沒有出現回歸。
七、結論:底層支援先到位,部署決策仍看成熟度
這次更新的意義,在於 llama.cpp 開始為 GATED_DELTA_NET 調整 Qualcomm Hexagon 的底層執行路徑;是否值得採用,仍由相容性與自身基準測試決定。
判斷時只問三件事:模型是否需要 GDN 路徑、硬體是否能用到 HMX/HVX/VTCM 配合,以及升級差異能否在實際任務中重複。
部署前也要分別查閱 llama.cpp 程式碼與模型權重的授權條款,確認模型來源、量化檔案及再散布條件;能在裝置上跑通,不等於可以任意打包或散布權重。
常見問題
Q1: HMX 是不是所有 llama.cpp 使用者都能用?
不是。這次支援針對 Qualcomm Hexagon 與 GATED_DELTA_NET,能否啟用仍要看硬體、模型與編譯設定;CPU、CUDA 等其他後端不會自動取得 HMX。
Q2: GATED_DELTA_NET 是什麼?
它是一種包含閘控與增量狀態更新的模型結構。推論還涉及狀態、非線性運算與資料搬移,因此需要依硬體安排計算與管線。
Q3: prompt processing 變快,回覆速度也會一樣變快嗎?
不一定。prompt processing 處理輸入上下文,token generation 逐步產生輸出,兩者瓶頸不同;PR #29199 的 Galaxy S26 數據中,前者提升較明顯,後者接近原基準。
Q4: b11095 能直接放進生產環境嗎?
不宜只根據這次測試採用。它是預發行版本,且「pipeline HMX and DMAs」仍在最佳化;應先完成固定條件的回歸測試,再依錯誤率、延遲、溫度與穩定性決定。
參考來源
- ggml-org/llama.cpp (2026). *Release b11095 · ggml-org/llama.cpp · GitHub*. GitHub
- max-krasnyansky, ggml-org/llama.cpp (2026). *hexagon: new HMX-optimized GATED_DELTA_NET by max-krasnyansky · Pull Request #29199 · ggml-org/llama.cpp · GitHub*. GitHub
- Qualcomm Technologies (2022). *Qualcomm Hexagon V69 HVX Programmer's Reference Manual*. Qualcomm Technologies
- Songlin Yang, Jan Kautz, Ali Hatamizadeh (2024). *Gated Delta Networks: Improving Mamba2 with Delta Rule*. arXiv
- Songlin Yang, Bailin Wang, Yu Zhang, Yikang Shen, Yoon Kim (2024). *Parallelizing Linear Transformers with the Delta Rule over Sequence Length*. arXiv


