同一段文字會因 tokenizer(分詞器,將文字切成模型處理單位的規則)不同而得到不同 token 數。估算提示詞能否放進模型上下文,得先對準目標模型。Simon Willison 在 2026 年 10 月 9 日發布 ttok 1.0,將預設 tokenizer 從 GPT-4 切換為 GPT-5 使用的版本。
ttok 適合放進本機流程,快速檢查輸入長度或測試截斷。它提供指定 tokenizer 下的文字估算,不能直接代表完整 API 請求用量。
一、ttok 1.0 改了什麼?預設改用 GPT-5 tokenizer
**ttok 1.0 將預設 tokenizer 從 GPT-4 使用的 cl100k_base 改為 GPT-5 使用的 o200k_base。**既有命令若沒有明確指定模型,計數與截斷結果可能因此改變。
ttok 是 Simon Willison 維護的命令列工具,底層使用 OpenAI 開源的 tiktoken 函式庫。1.0 的重點在預設選擇;沿用舊腳本升級後,數字可能因 tokenizer 改變而不同。
0.4 新增 --list-models 列出可識別的模型。Willison 隔天發現預設仍是 GPT-4 tokenizer,便改用 GPT-5 tokenizer 並升至 1.0。依賴計數結果的流程,應記錄工具版本和模型選項。
「Token counts, truncation results and token IDs can differ between tokenizers.」— ttok 1.0 專案文件(PyPI)
GPT-6 的情況要另作區分。Willison 表示,OpenAI 尚未正式確認 GPT-6 使用與 GPT-5 家族相同的 tokenizer;他引用 William Liu 的測試紀錄,指出測試涵蓋 7 個 GPT-5.5、GPT-5.6 與 GPT-6 模型,以及 31 組測試資料,結果彼此一致。這是作者轉述的有限測試觀察,不能當成 OpenAI 的正式規格,也不能推廣到其他模型家族。
“OpenAI haven’t actually confirmed that GPT-6 uses the same tokenizer yet.” — Simon Willison, ttok 1.0 release note
二、ttok 如何把文字轉成可操作的 token 數?
ttok 可接收命令列文字、標準輸入或檔案,計算指定 tokenizer 下的 token 數,也能按 token 上限截斷文字。因此它可以直接接入既有命令列或文字處理管線,減少手動複製貼上的步驟。
「標準輸入」(stdin)是程式從前一個命令接收文字的管道,可用 producer | ttok 傳入處理結果;檔案則可用 ttok -i prompt.txt 讀取。計數可用於提示草稿檢查、文件清理或批次處理。
可用 -t 或 --truncate 指定 token 上限,也可用 ttok --list-models 查看可用模型。整理長文件時,可先檢查計數與截斷結果,再決定是否送入下一步。截斷宜作用於副本或明確設計的前處理環節,避免丟掉必要脈絡。
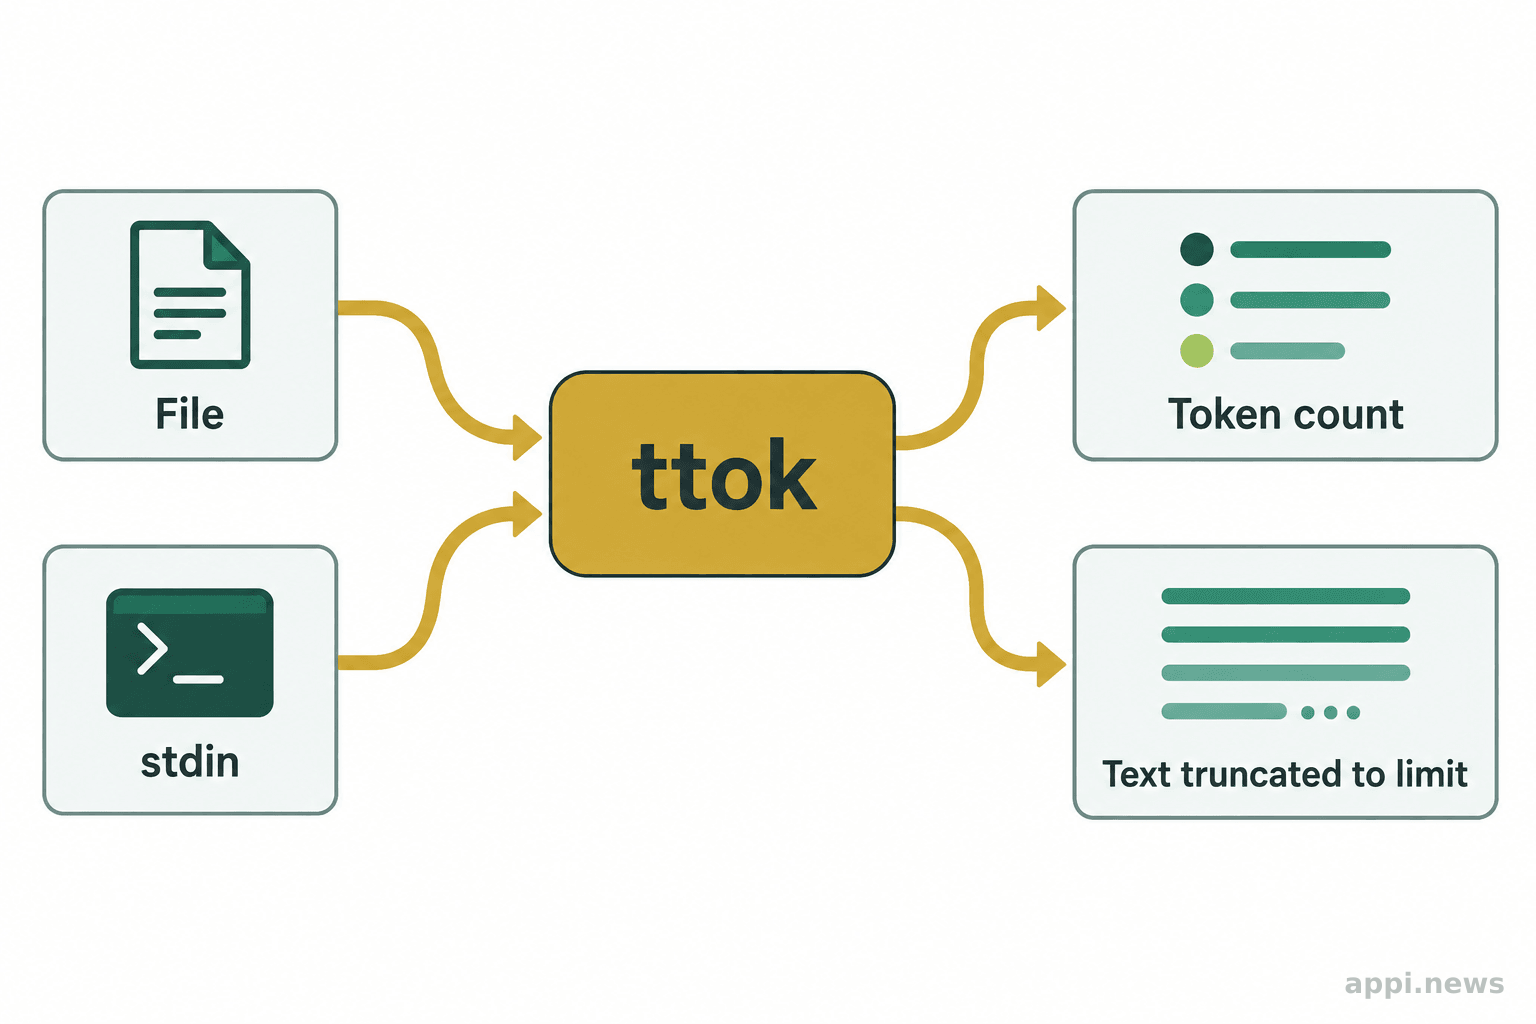
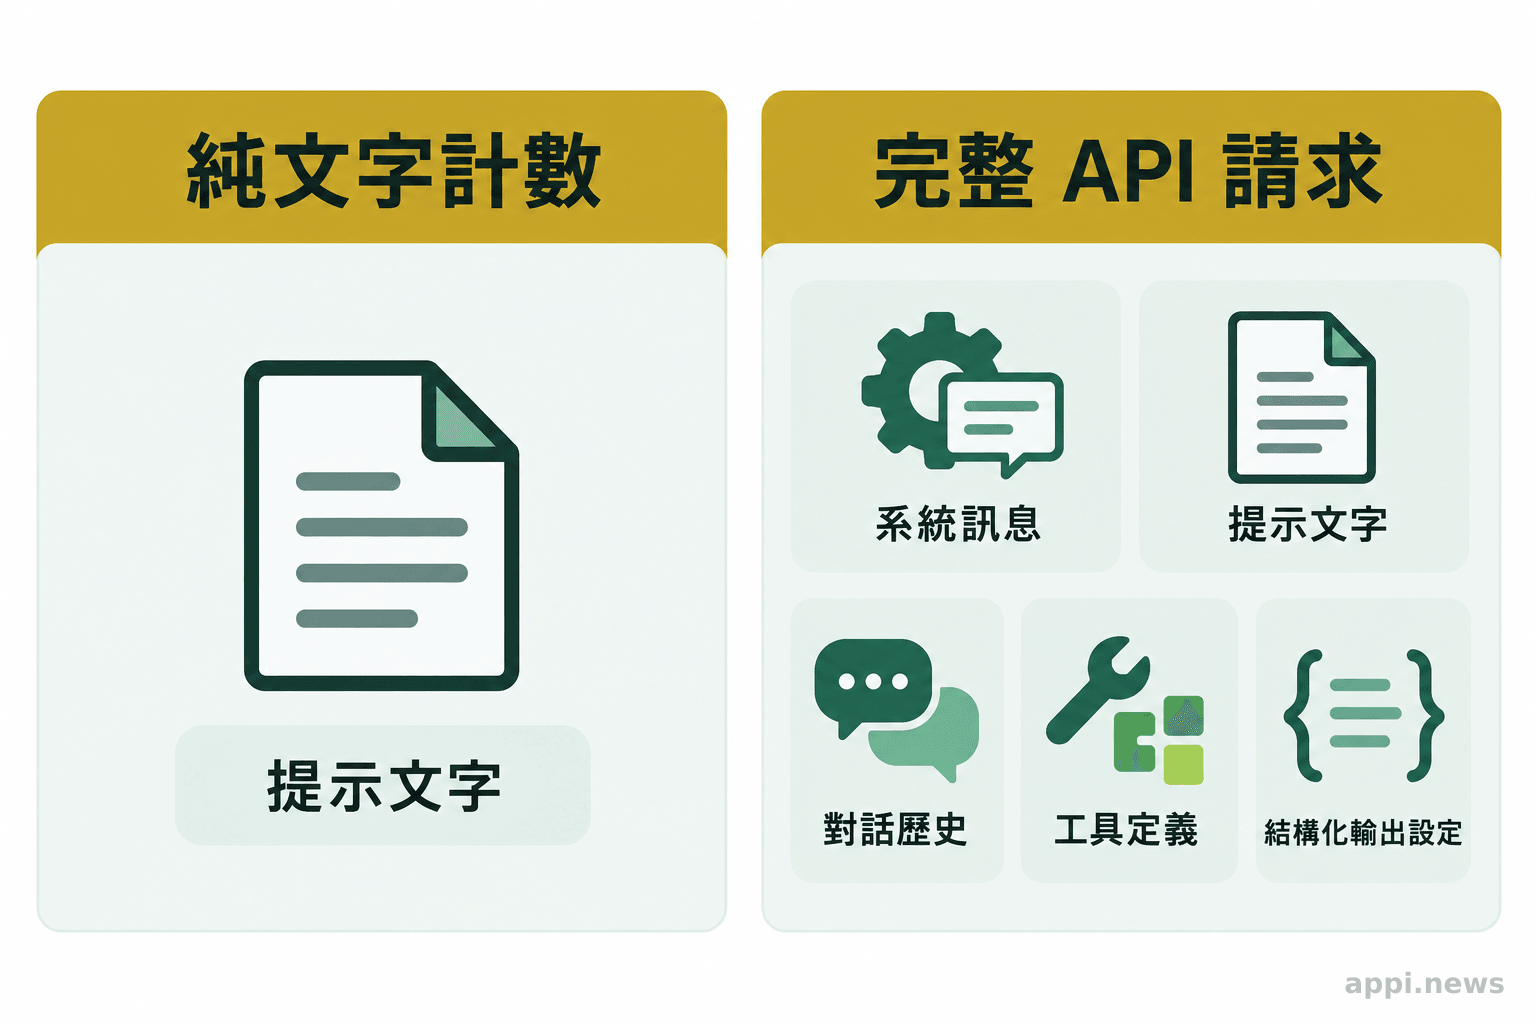
接入流程時要固定「輸入範圍」。若 ttok 只收到提示文字,實際請求中的系統訊息、對話歷史、工具描述或檢索文件便不在計數內。為了重現結果,應一併記錄輸入內容、模型名稱和工具版本。
三、接進開發流程前,先定義模型與估算目的
token 數依 tokenizer 和輸入文字而變,單看字數無法推算所有模型的 token 用量。計數前應確認目標模型、ttok 使用的模型選項,以及送入工具的文字是否和實際請求相同。
tokenizer 依詞彙表和切分規則把文字編成 token。常見詞、罕見字、程式碼或不同語言可能切出不同數量,因此「一個中文字等於幾個 token」沒有跨模型通用答案。ttok 預設使用 o200k_base,也可透過 --model 指定其他模型。
預設值變更會影響舊流程的可比性。需要長期追蹤或自動化判斷時,應明確指定模型並記錄 ttok 版本;升級後用固定測試文字對照輸出,避免把預設差異誤認為內容變動。
純文字計數和完整 API 請求用量不同。請求可能含多則訊息、角色標記、工具定義或結構化輸出設定;若 ttok 只收到提示正文,便不會計入其他欄位。因此,不能單靠它推定費用、剩餘上下文容量或模型實際回報的用量。
四、哪些情境適合用 ttok,哪些情境要再校準?
提示草稿檢查、批次文字初篩和截斷流程試跑,適合先用 ttok 估算;預算控管、上下文上限和正式截斷規則,則要以目標模型文件及實際 API 回應校準。
開發者可在送出請求前檢查提示詞或檢索段落,也可在匯入流程找出特別長的文件,再交由後續邏輯分類或拆段。固定 tokenizer 後,還能比較同一流程的輸入長度或提示模板變化。這類用途把 ttok 當作初篩工具,門檻應配合模型與資料型態設定。
若要自動截斷,需先檢查被刪部分是否含有指令、依據或必要脈絡,並確認文字邊界符合下游需求。token 上限不理解段落語意;應以正式模型測試截斷結果,並保留原始內容。
涉及 API 費用或上下文容量時,應以固定樣本比對估算值與目標模型回報的用量,並確認完整訊息、工具定義和其他參數都納入。若偏差會改變預算或截斷決策,就依服務文件調整估算;模型或 API 格式更新後再校準。
- 確認要使用的模型,並在 ttok 命令中明確指定對應模型。
- 固定輸入範圍與 ttok 版本,使用標準樣本檢查升級前後差異。
- 將估算值和目標模型的實際 API 用量對照,再決定是否用於成本或截斷規則。
若需求是發現提示或文件長度異常,ttok 可作命令列初篩;若要估算正式請求成本、控制上下文或自動截斷,則須以目標模型和實際 API 驗證。導入前先定義模型、輸入範圍與可接受誤差,再決定它在流程中的角色。
- ttok 1.0 預設使用 GPT-5 的
o200k_base,預設變更可能使舊流程的計數結果不同。 - 工具能讀取文字、檔案或標準輸入,並計數或截斷。
- GPT-6 tokenizer 相同的說法來自有限測試觀察,OpenAI 尚未正式確認。
- 文字 token 數不等於完整 API 請求用量;預算和截斷決策須以實際請求校準。
常見問題
Q1: ttok 1.0 和舊版最大的差異是什麼?
1.0 將預設 tokenizer 改為 GPT-5 使用的 o200k_base。若沒有明確指定模型,升級後的計數、token ID 或截斷結果可能和舊版不同。
Q2: ttok 可以直接算出 API 帳單上的實際 token 用量嗎?
不一定。它計算輸入給工具的文字,完整 API 請求還可能包含訊息格式、工具定義及其他欄位,應以目標模型實際回傳的用量為準。
Q3: ttok 1.0 是否證明 GPT-6 和 GPT-5 使用相同 tokenizer?
沒有。作者提到的測試是有限樣本上的觀察;OpenAI 尚未正式確認 GPT-6 的 tokenizer 規格。
Q4: ttok 適合用在正式自動截斷嗎?
可先確認模型選項、文字邊界與刪除內容的影響,再用正式請求測試。token 數不會判斷文字的重要性。
參考來源
- Simon Willison (2026). Release: ttok 1.0. *Simon Willison’s Weblog
- Simon Willison (2026). ttok · PyPI. *Python Package Index (PyPI)
- Simon Willison (2026). simonw/ttok: Count and truncate text based on tokens. *GitHub
- OpenAI (2022). openai/tiktoken: tiktoken is a fast BPE tokeniser for use with OpenAI's models. *GitHub