把自己的知識交給 AI,就能替本人回答問題嗎?「看起來像本人、聽起來像本人」和「能代表本人提供可靠回答」是不同的產品承諾。TechCrunch 記者 Dominic-Madori Davis 分享一項個人實作:她錄製影像與聲音,選定一篇探討創投支持新創詐欺的文章作為互動分身的回答範圍;測試者問到她的居住地或過去經歷時,分身會把問題導回該篇文章。這是一個個人產品體驗,不能據此推論其他服務的能力或效果。
一、個人數位分身改變了哪一種互動?
它把預先整理的內容轉成可追問的對話入口,回答能力仍受資料和設定限制。
傳統影片通常依照腳本播放,使用者只能觀看;互動式分身則接收提問,再以文字、聲音或影像回應。TechCrunch 報導中的案例採用記者的一篇文章作為主題材料,分身在被問到文章範圍以外的個人資訊時,會回到原先的主題。這樣的設計把「找資料、讀文章」轉成「直接提問」,使用者較容易從不同角度理解同一份內容。
報導也描述了生成過程:記者在工作室拍攝多張照片並錄下約兩分鐘聲音,製作團隊再以語音轉文字、語言模型、文字轉語音和影像模型組成互動流程。這是該次實作的流程,不等於所有平台都需要相同素材或採用相同技術。個人案例也未提供足以比較準確度、使用成效或長期維護負擔的測試資料。
因此,數位分身適合被理解為一種互動介面,背後仍由資料、模型、產品規則與維護流程共同支撐。外型像本人,只能增加辨識感,不能證明輸出是本人即時發言、看過每個答案,或完整掌握本人知識。
二、資料準備決定分身能回答到哪裡
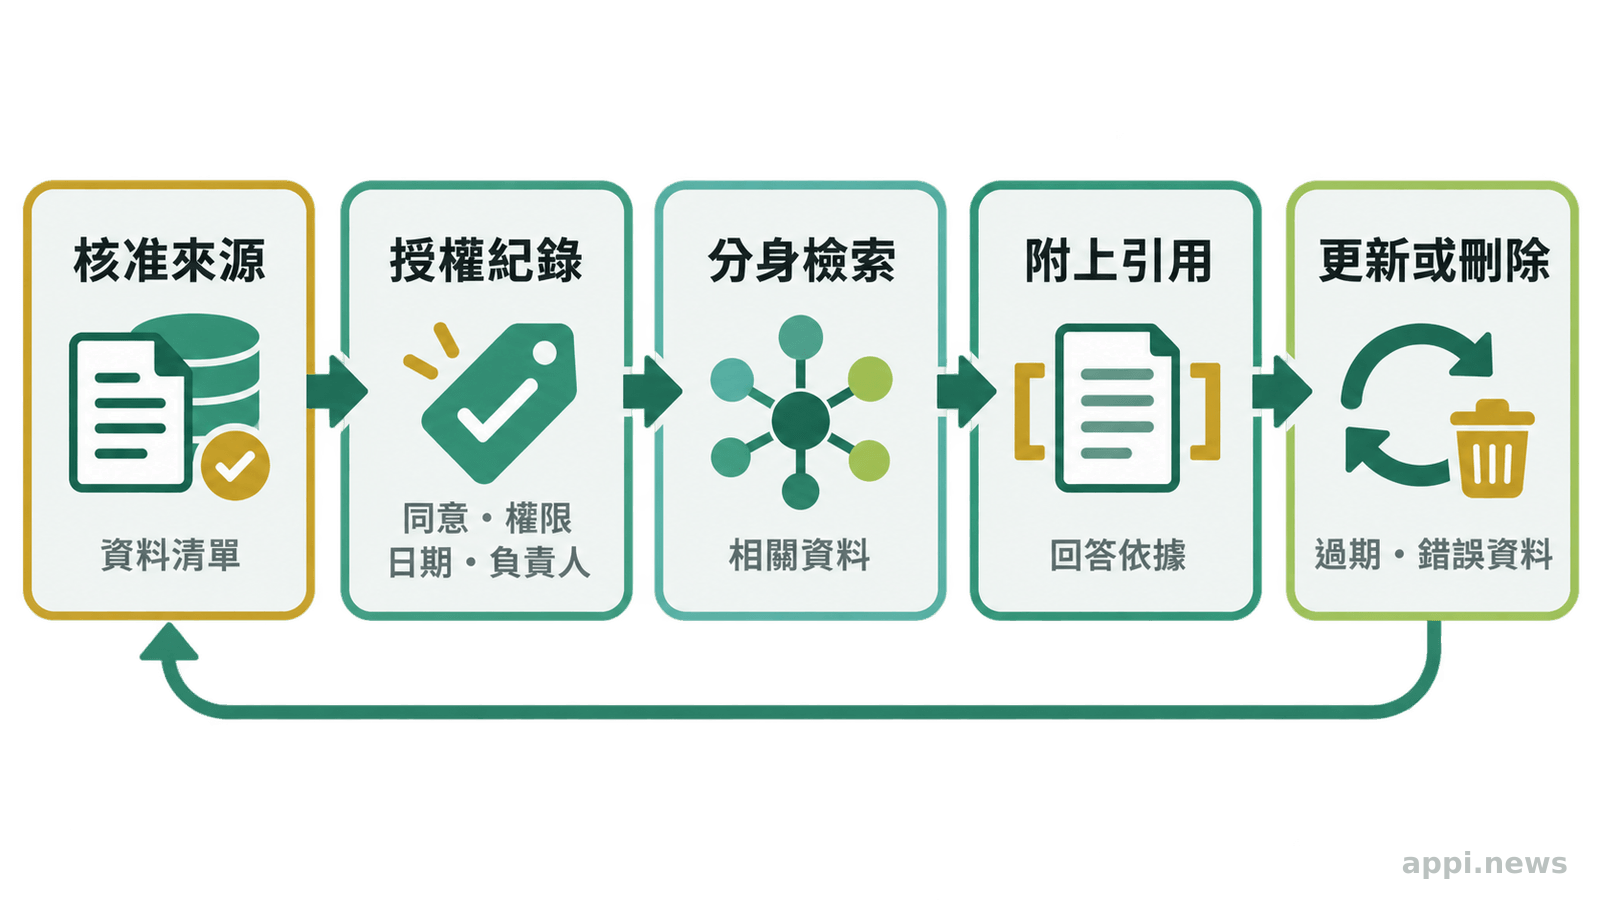
先界定主題、可用來源、更新責任和授權,再決定資料如何供模型使用。
資料整理、檢索與模型訓練是不同工作。整理是把知識分類、補上日期和來源;檢索是使用者提問時,系統從核准的資料中找相關內容,再交由模型組織答案;訓練則是以資料調整模型參數。三者需要的技術、成本與風險不同。把一批文件上傳到服務,不代表模型已學會所有內容,也不代表每次回答都能準確引用原文。
可先建立一份資料清單:哪些內容屬於本人、哪些由第三方提供、哪些已過期、哪些含個人或機密資訊。每份資料都要有負責更新的人、可使用的目的、允許存取的對象,以及移除或更正方式。若採用檢索式知識庫,可在回答附上文件名稱、段落或連結,讓使用者檢查答案依據;資料找不到時,介面應承認目前沒有足夠根據。
若服務允許使用者上傳本人或他人的資料,產品應說明資料用途、誰能存取、保存多久、如何刪除,以及內容是否會用於模型改善。以姓名、影像或聲音製作分身,也要確認當事人授權和使用範圍。上傳資料牽涉第三人時,不能只因檔案上傳者同意,就假定資料中每個人的資訊都能任意使用。
三、回答邊界要如何設計與驗證?
把問題分成可由資料回答、需要補充資訊、應拒答或交由本人處理,並逐類測試。
常見風險是把「語氣流暢」誤當成「內容有根據」。美國國家標準暨技術研究院(NIST)將模型自信地產生錯誤或虛假內容列為生成式 AI 風險,並提醒引用也可能出錯。這表示回答政策不能只靠一句「請盡量正確」,而要有可檢查的規則:限定資料範圍、要求來源、標出不確定性,並在無資料支持時拒答或轉介。
一套實用的測試集至少要涵蓋四種提問:資料直接支持的問題、資料沒有提及的問題、前提錯誤或互相矛盾的問題,以及試圖讓分身越過設定範圍的問題。檢查的不只是答案正確與否,也包括它是否引用對的資料、能否辨認過期資訊、會不會把推測說成事實,以及遇到未知時是否真的停止回答。
若回答可能影響健康、法律或財務決策,風險更高。數位分身不應被設計成替代專業判斷的角色;如服務可能接觸孕婦、兒童、慢性病患者或長期服藥者,應排除個人化診斷、治療和用藥建議,清楚引導使用者向合格專業人員確認。遇到藥物交互作用問題,不能只靠一般知識庫回答,應避免給出自行停藥、換藥或調整劑量的指示。
NIST《生成式人工智慧風險管理框架》將模型自信產生錯誤或虛假內容列為一項風險。
四、使用者期待與身分呈現有哪些風險?
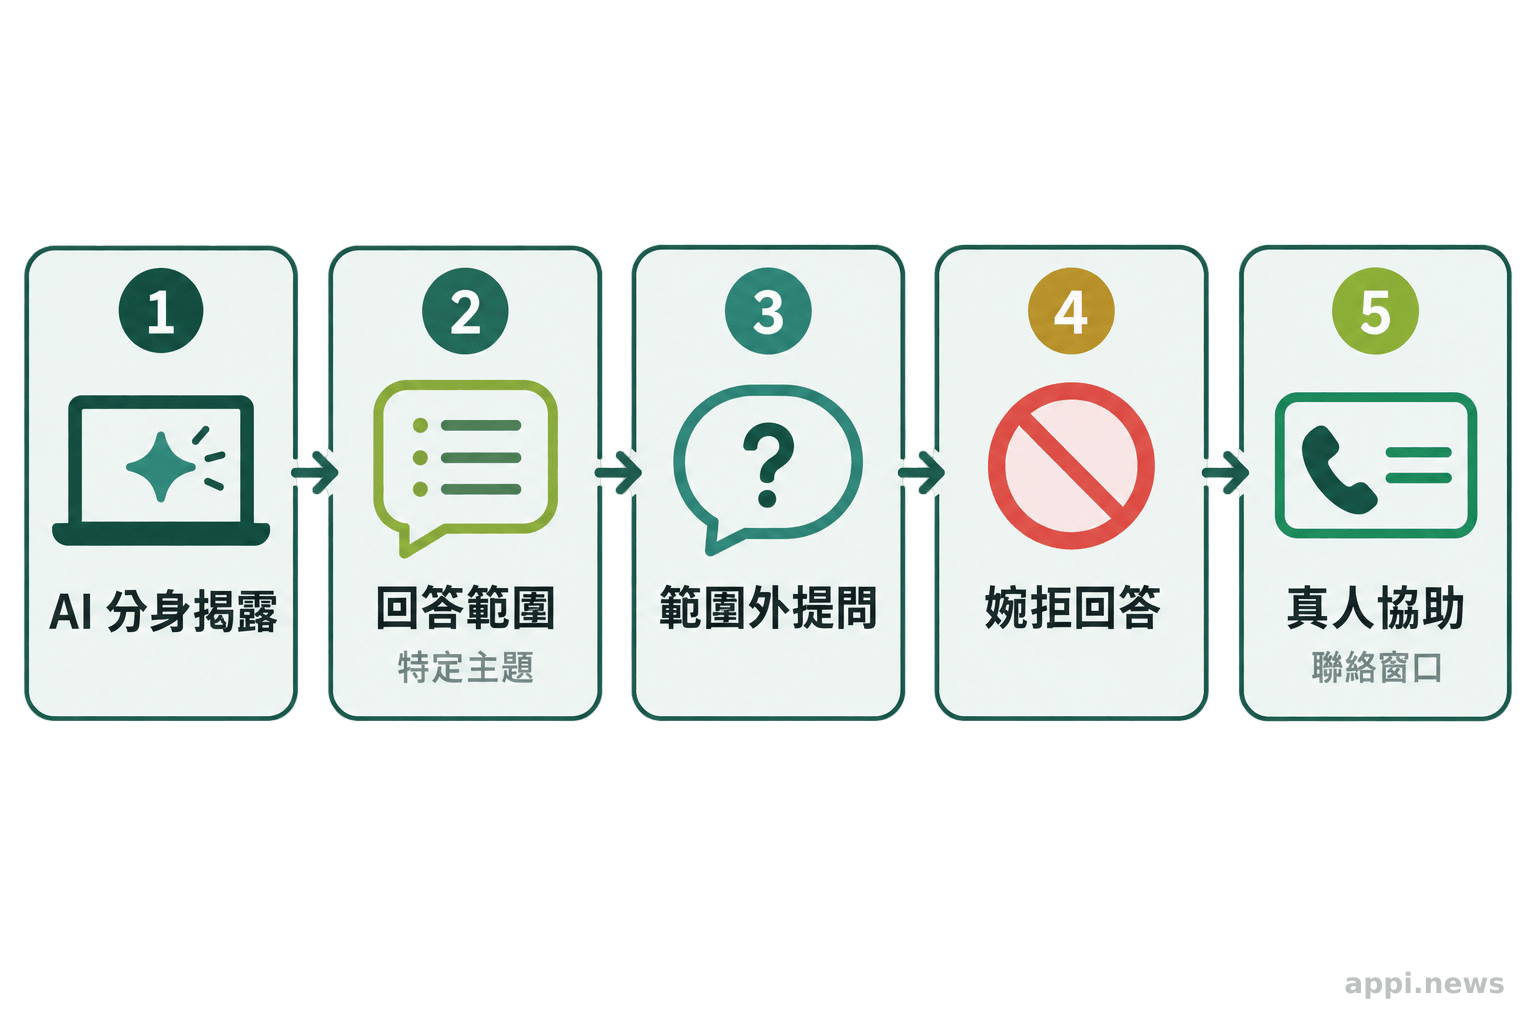
在互動開始前和回答過程中都揭露 AI 身分,並說明內容來源、代表性限制及人工接手方式。
臉孔和聲音會讓對話更像真人交流,也容易使使用者以為本人正在場或已核准答案。作為降低誤認的設計做法,介面可在顯眼處標明這是 AI 生成的回應,說明分身依據哪些材料運作、哪些內容未經本人審核,以及何時能取得真人協助。用戶詢問本人未公開的資訊、要求作出承諾,或試圖讓分身代替本人表態時,系統應拒答並提供聯絡途徑。
身分仿冒也會帶來安全問題。美國聯邦貿易委員會(FTC)討論 AI 語音複製時,列出事前驗證、即時偵測與事後檢查等介入點,同時提醒不同措施各有缺口。對產品設計者而言,這提醒了辨識本人不能只依賴一段聲音或可被複製的視覺特徵。涉及帳戶、金錢、敏感資料或對外承諾的操作,還需要獨立的身分驗證和授權流程。
系統也需要保留人工接手和更正管道。使用者應能回報錯誤,內容負責人應能停用特定資料或整個分身,並查明哪些版本的資料影響了答案。透明揭露本身不會讓答案自動變準,仍須配合測試、權限和處理事故的流程。
FTC 指出,應對 AI 語音複製傷害沒有單一解方,並討論事前驗證、即時偵測與事後檢查等介入方式。
五、產品整合成本藏在哪些環節?
成本除了模型呼叫,還包括知識整理、介面、權限、安全、測試、維護與人工支援。
TechCrunch 個案提到,互動體驗可能串接語音轉文字、語言模型、文字轉語音和影像模型;報導也提及服務可搭配不同供應商,企業可選擇雲端託管方式。這些只是報導描述的產品組合,實際可用功能、地區、價格和條款仍要依採購方案核對。接入更多服務,也代表多了資料流向、故障排查、帳號管理和供應商變動等工作。
完整估算應把前期和持續成本分開。前期包括清理資料、取得影像聲音授權、設計回答規則、開發介面和串接驗證;持續成本則包括更新知識、重測高風險問題、監控錯誤、處理刪除要求、管理存取權限與提供人工回覆。還需確認對話紀錄存在哪裡、誰能檢視、供應商是否會變更條款,以及停止服務後能否匯出或刪除資料。
成本常被低估的原因之一,是責任沒有安排好:模型可以生成回答,卻不會自動決定由誰檢查資料、誰接受申訴、誰批准更新。若沒有人負責這些工作,省下的製作成本可能會轉成錯誤處理、信任損失和資料管理負擔。
六、哪些情境適合先做小規模試用?
從固定主題、低風險問題和可追溯資料開始,先訂出錯答、拒答、更新與停止門檻。
試用前可依序完成四件事:第一,寫清楚服務要回答的問題和明確不回答的問題;第二,盤點資料來源、授權、更新人和刪除規則;第三,準備正常、超出範圍、過期與惡意誘導等測試問題;第四,指定人工接手者和停用負責人。試用期間記錄有來源支持的回答比例、錯答類型、拒答是否到位、人工介入時間和內容更新後的表現。
高風險錯答、無法刪除的個資、冒充本人表態,或無人能接手,都是暫停服務的理由。停止條件應在公開前就寫好,避免團隊因為已投入製作而持續擴大使用範圍。若互動需求只是回答少量固定問題,搜尋頁、FAQ 或腳本影片可能更容易維護;只有當追問能改善使用者理解,而且團隊能持續管理資料與責任時,互動介面才值得進一步評估。
| 方式 | 互動方式 | 適用問題 | 維護負擔與限制 |
|---|---|---|---|
| 互動式數位分身 | 使用者自由提問,系統即時組織回答 | 需要追問、依不同角度探索的固定主題 | 需持續管理資料、回答邊界、身分揭露及人工接手;仍可能答錯 |
| 腳本影片 | 依預先錄製或生成的內容播放 | 需要一致說明、內容變動較少的情境 | 更新時要重錄或重製;無法回應腳本以外的追問 |
| FAQ/搜尋頁 | 使用者查找預先整理的問答或資料 | 少量固定問題,或需要查閱原始資料 | 需維護條目與索引;使用者要自行比對內容,互動彈性較低 |
- 列出預定回答、拒答和轉介的問題範圍。
- 為每份資料記錄來源、授權、負責人、更新日和刪除方式。
- 用範圍內外問題測試引用、未知提示、拒答與人工接手。
- 事先設定錯答、隱私事件或維護資源不足時的停用門檻。
- 數位分身是互動入口,外貌與聲音相似不等於能代表本人。
- 資料來源、回答邊界、身分揭露和人工接手需要一起設計。
- 評估成本時,要把資料維護、測試、安全與服務中止納入。
常見問題
Q1: 數位分身是否等於把本人訓練成模型?
不一定。把文件接入檢索系統、以資料調整模型參數,以及生成外觀聲音相似的影音,屬於不同技術環節。使用前應查明資料如何被處理、是否用於訓練,以及如何撤回或刪除。
Q2: 分身答錯時由誰確認與更正?
服務提供者和內容負責人應先約定處理流程。使用者要能回報錯誤,負責人要能更正或下架資料,並確認修正後的回答是否通過測試。
Q3: 哪些資料不應提供給個人 AI 助理?
未取得授權的第三方資料、帳號密碼、金融憑證、機密文件,以及與服務目的無關的敏感個資都不應直接上傳。若必要資料涉及個人資訊,先確認用途、存取範圍、保存期限和刪除方式。
Q4: 數位分身可以回答健康或用藥問題嗎?
不宜讓它替個人診斷、調整治療或判斷藥物交互作用。孕婦、兒童、慢性病患者和長期服藥者遇到相關問題,應向醫療專業人員確認。
參考來源
- Dominic-Madori Davis (2026). *I created an interactive digital avatar of myself — and you can talk to it*. TechCrunch
- Autio C, Schwartz R, Dunietz J, et al. (2024). *Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile*. National Institute of Standards and Technology
- Federal Trade Commission (2024). *Approaches to Address AI-enabled Voice Cloning